
Loading...

Loading...
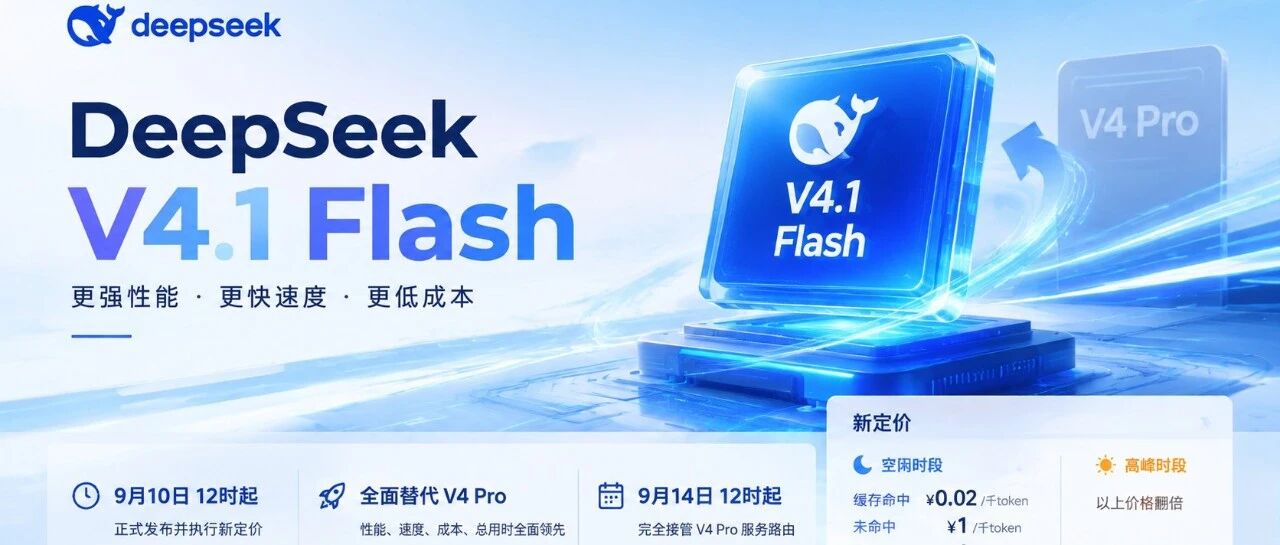 DeepSeek V4.1 Flash来了:比自家Pro更强,还更便宜今天DeepSeek干了件在AI圈相当离谱的事:
正式发布V4.1 Flash,然后宣布——V4 Pro四天后(9月14日12点)下线,所有请求自动路由到新Flash,按Flash的价格计费。
注意这个辈分关系:Flash是轻量款,Pro是旗舰款。小弟上市,大哥退役。
先复盘一下这一个月有多魔幻
8月13日,DeepSeek发布V4 Pro正式版,同时甩出一张涨价单:API价格最高涨了11倍,首次搞峰谷定价,高峰时段翻倍。开发者社区当场炸锅,原话是"没有性价比了"。
8月17日,新价格生效,骂声一片。
9月9日,DeepSeek悄悄宣布Flash系列降价:缓存命中价砍60%,不少价格回到了涨价前。
9月10日,谜底揭晓:哪里是良心发现降价,是新模型把成本真的打下来了。V4.1 Flash发布,性能、速度、费用、总用时四项全面超越V4 Pro——官方原话。
也就是说,V4 Pro正式版在市面上只活了28天,就被自家一个"小尺寸"模型送进了博物馆。
它是怎么做到又便宜又强的?
说两个技术细节,不用懂技术也能听明白。
第一,新模型换了个脑子结构。以前的模型读东西和写东西用同一套参数,V4.1 Flash改成了"不对称":读输入的时候只激活80亿参数,写输出的时候激活160亿。
为什么这么改?因为现在AI干活的模式变了。一个Agent跑任务,要读大量的代码、文档、工具返回结果,真正自己写出来的内容反而不多——典型的"读多写少"。既然读的部分不需要那么聪明,那就用小脑子读、大脑子写,账单自然就下来了。
第二,它把"短期记忆"占的显存压缩到了极致。KV Cache(可以理解成模型读长文时的草稿纸)缩小到每token 890字节,对显存的需求降到上一代的四分之一,比DeepSeek初代模型缩小了437倍。Agent任务反复读上下文,这张草稿纸以前是成本大头,现在基本等于白送。
如图展示了 DeepSeek 在减少上下文存储方面的持续进展。相对于初代模型,KV Cache 已经缩小了 437 倍。
总参数5520亿,MIT协议开源,100万token上下文,还原生带视觉理解——看图、读截图、分析图表不用再单独调模型了。
价格账算一下
闲时每百万token:缓存命中输入2分钱、未命中1块钱、输出4块钱。高峰时段翻倍。
对比8月涨价前的老Flash:输入价回到了从前,输出还是以前的两倍。但对比V4 Pro的价格,Hacker News上有人算了笔美元账——输出token,新Flash闲时0.6美元,Pro是1.98美元,差了三倍多。
所以9月14日之后会出现一个很魔幻的场景:你指着deepseek-v4-pro的接口发请求,后台给你跑的是更强的模型,收的是更便宜的钱。
降级?不,这叫"向下升级"。
更值得琢磨的是后半句话
官方说,V4.1 Flash是"全新模型结构系列中尺寸最小的型号"。
最小的,已经把上一代旗舰打死了。
那大的呢?报告里写得很明白:新结构就是为了"可扩展到更大参数模型"。V4.1 Pro正在暗处憋着。DeepSeek这波相当于先放个小号出来清场,把"旗舰能力"的价格锚直接砸穿,等大号出来,定价和想象空间全是它说了算。
时间点也很微妙。昨天路透社刚曝出DeepSeek请中信证券辅导科创板IPO,估值5000亿;今天就用一场"加量还降价"把全球开发者的好感度拉满——Hacker News上相关帖子冲到近400分,评论区一片"便宜得离谱"。
资本市场讲故事需要想象力,开发者生态需要真金白银的便宜。DeepSeek两天之内,两头都喂了。
再看大洋对面:同一天,OpenAI那边GPT-6 Astra因为需求太猛,放话可能暂停新的Pro订阅注册——一个忙到要关门谢客,一个敞开大门还降价。
AI竞赛打到2026年秋天,画风已经很清楚了:有人在卖奢侈品,有人在卖自来水。
而对国内开发者来说,建议很实在:这几天可以把Agent任务往闲时(晚上和周末)挪挪,能再省一半;9月14日之后如果还在调v4-pro的接口,不用改代码,但记得去后台看看账单——会有惊喜。
 那个最"不缺钱"的AI公司,也要上市了今天路透社丢出一条消息:DeepSeek已经请了中信证券当辅导机构,筹备在科创板IPO,计划年内正式启动上市流程。
DeepSeek和中信证券都没回应。但这事儿的可信度不低——中信证券是券商一哥,上市辅导又是A股的规定动作,请了谁,基本就是板上钉钉在推进了。
有意思的是,这家公司曾经是全行业最"佛系"的一个。
两年前:不融资,不上市
2024年底DeepSeek刚火的时候,梁文锋的做派是这样的:不接受采访,不开发布会,不融资。公司靠幻方量化的自有资金养着,闷头做模型。当时外界想给它送钱,门都摸不到。
结果今年画风突变。
4月启动首轮外部融资,6月交割,510亿元,投后估值3500亿——梁文锋自己掏了200亿,腾讯100亿,宁德时代50亿,网易、京东、IDG各30亿。两个月不到,第二轮又安排上了,投前估值直接喊到5000亿,又是500亿的盘子。两轮加起来,募资超过1000亿。
融资还没完全落袋,IPO辅导已经开始了。
从"不融资不上市"到"两个月融两轮、年内冲刺IPO",DeepSeek用了不到半年。
钱都花哪儿了?烧得比赚得快多了
先看账。据The Information拿到的数据,DeepSeek今年前7个月营收4.75亿元——听着还行,是去年全年的十倍。但同期净亏损7.15亿。而花在AI基础设施上的钱是多少?110亿。
收入不到5亿,基础设施投入110亿。这个缺口,靠卖API是填不上的。
巧的是,今天DeepSeek还官宣了另一件事:flash系列明天起实行峰谷分时定价,高峰时段价格翻倍,空闲时段降价。一边用价格杠杆引导开发者错峰、把算力成本压下去,一边马不停蹄地筹备上市补血——两件事放在同一天,你细品。
还有一个更现实的压力:人被挖走了
路透社在报道里点得很直白:字节和小米最近在高薪挖DeepSeek的人,核心研究员已经走了一批。微博上有消息说,离职的骨干至少5个,覆盖大模型、推理、多模态几条主线。
DeepSeek满打满算300来人。前两天刚放出150个招聘名额,相当于再招"半个DeepSeek"。
光靠理想和情怀留不住人了。上市公司的股票和期权,才是打工人听得懂的语言。梁文锋想拿IPO募来的钱做股权激励,这是阳谋。
为什么是科创板,不是港股?
这波AI上市潮里,同行基本都去了香港:智谱、MiniMax今年已经挂牌,月之暗面也秘密递了表。
DeepSeek偏要走科创板。
这里有个背景:上交所专门为大模型公司开了绿灯——第五套上市标准,允许还没形成收入规模的优质AI企业上市。这套标准原本是给创新药企业用的,现在平移到了大模型身上。科创板要的就是这种硬科技标杆,DeepSeek也需要一个给足政策红利的主场。
再想想它融资时那个著名的架构:外部投资人的钱打进梁文锋管理的有限合伙,五年锁定期,只有国家AI产业投资基金能直接持股。控制权攥得死死的。这种风格,跟科创板的政策导向天然合拍。去港股跟那帮对冲基金掰扯估值?没必要。
说白了,这已经不是一家"实验室"了
2025年的DeepSeek,像个躲在杭州的武林高手,靠一套开源模型震动天下。2026年的DeepSeek,是一家两轮融了上千亿、要扩招到450人、买芯片建数据中心、跟人抢人才的重装备公司。
AGI这张牌桌,门票已经涨到了千亿美元级别。OpenAI、Anthropic在美股门口排队,估值一个喊1万亿、一个喊2万亿美元。这个量级的军备竞赛,靠自有资金和私募融资,迟早不够烧。
上市不是理想主义的退潮,是这场仗打到新阶段的必然。
对普通人来说,这倒也是个机会:智谱MiniMax在港股,多数人买着费劲;等DeepSeek真在科创板敲了钟,一个A股账户就能下注国产大模型了。
当然,辅导备案离正式挂牌还有不短的流程,募资规模、时间表、估值都没敲定。路透社也说了,今年内是"启动流程",真挂牌市场普遍预期要到2027年。
但方向已经定了。那个说"不缺钱"的DeepSeek,终于要走进股市的喧闹里了。中信证券:香港发展虚拟资产的战略决心明确,虚拟资产产业发展迅猛Techub News 消息,中信证券研报表示,中国香港发展虚拟资产的战略决心明确,依托成熟的金融基建与国际化的监管框架,虚拟资产产业发展迅猛。依托粤港澳大湾区创新协同与自由开放的市场优势,香港正加速巩固其全球虚拟资产核心枢纽的地位。在此趋势下,传统金融机构持续强化牌照及业务布局。推荐顺应加密货币纳入金融生态趋势,业务经营能力出众的优质网络经纪商。中信证券:关注获批确定性高的稳定币发行商Techub News 消息,中信证券研报表示,稳定币产业方兴未艾,是链接数字资产和现实世界的桥梁。随着全球范围内各地监管政策的落地,行业有望实现合规发展。未来应用层有望在广度和深度上不断延伸,为稳定币需求提供支撑。建议关注明确提出申请,获批确定性高的稳定币发行商;长期看应用场景决定未来空间,聚焦可能构成发行及应用生态闭环的相关标的及产业参与方。中信证券:中长期内,预计加密货币将受益于逆全球化、去美元化带来的货币化Techub News 消息,据财联社报道,中信证券研报表示,加密货币具有较好的隐私性和抗通胀性,自诞生以来成长迅速,并且正在逐步正规资产化。随着加密货币的刚需扩大,形成类似黄金的刚需托底,投机定价的格局。但短期来看由于货币化不足和边际定价者风险偏好高,加密货币反而投机性更强。中长期内,预计加密货币和黄金都将受益于逆全球化、去美元化带来的货币化。「未来黄金」不必然包含比特币,但大概率有加密货币。短期内加密货币有望受益于特朗普任期内可能的监管放松,但需等待贸易、外交政策的确定性。
今天DeepSeek干了件在AI圈相当离谱的事: 正式发布V4.1 Flash,然后宣布——V4 Pro四天后(9月14日12点)下线,所有请求自动路由到新Flash,按Flash的价格计费。 注意这个辈分关系:Flash是轻量款,Pro是旗舰款。小弟上市,大哥退役。 先复盘一下这一个月有多魔幻 8月13日,DeepSeek发布V4 Pro正式版,同时甩出一张涨价单:API价格最高涨了11倍,首次搞峰谷定价,高峰时段翻倍。开发者社区当场炸锅,原话是"没有性价比了"。 8月17日,新价格生效,骂声一片。 9月9日,DeepSeek悄悄宣布Flash系列降价:缓存命中价砍60%,不少价格回到了涨价前。 9月10日,谜底揭晓:哪里是良心发现降价,是新模型把成本真的打下来了。V4.1 Flash发布,性能、速度、费用、总用时四项全面超越V4 Pro——官方原话。 也就是说,V4 Pro正式版在市面上只活了28天,就被自家一个"小尺寸"模型送进了博物馆。 它是怎么做到又便宜又强的? 说两个技术细节,不用懂技术也能听明白。 第一,新模型换了个脑子结构。以前的模型读东西和写东西用同一套参数,V4.1 Flash改成了"不对称":读输入的时候只激活80亿参数,写输出的时候激活160亿。 为什么这么改?因为现在AI干活的模式变了。一个Agent跑任务,要读大量的代码、文档、工具返回结果,真正自己写出来的内容反而不多——典型的"读多写少"。既然读的部分不需要那么聪明,那就用小脑子读、大脑子写,账单自然就下来了。 第二,它把"短期记忆"占的显存压缩到了极致。KV Cache(可以理解成模型读长文时的草稿纸)缩小到每token 890字节,对显存的需求降到上一代的四分之一,比DeepSeek初代模型缩小了437倍。Agent任务反复读上下文,这张草稿纸以前是成本大头,现在基本等于白送。 如图展示了 DeepSeek 在减少上下文存储方面的持续进展。相对于初代模型,KV Cache 已经缩小了 437 倍。 总参数5520亿,MIT协议开源,100万token上下文,还原生带视觉理解——看图、读截图、分析图表不用再单独调模型了。 价格账算一下 闲时每百万token:缓存命中输入2分钱、未命中1块钱、输出4块钱。高峰时段翻倍。 对比8月涨价前的老Flash:输入价回到了从前,输出还是以前的两倍。但对比V4 Pro的价格,Hacker News上有人算了笔美元账——输出token,新Flash闲时0.6美元,Pro是1.98美元,差了三倍多。 所以9月14日之后会出现一个很魔幻的场景:你指着deepseek-v4-pro的接口发请求,后台给你跑的是更强的模型,收的是更便宜的钱。 降级?不,这叫"向下升级"。 更值得琢磨的是后半句话 官方说,V4.1 Flash是"全新模型结构系列中尺寸最小的型号"。 最小的,已经把上一代旗舰打死了。 那大的呢?报告里写得很明白:新结构就是为了"可扩展到更大参数模型"。V4.1 Pro正在暗处憋着。DeepSeek这波相当于先放个小号出来清场,把"旗舰能力"的价格锚直接砸穿,等大号出来,定价和想象空间全是它说了算。 时间点也很微妙。昨天路透社刚曝出DeepSeek请中信证券辅导科创板IPO,估值5000亿;今天就用一场"加量还降价"把全球开发者的好感度拉满——Hacker News上相关帖子冲到近400分,评论区一片"便宜得离谱"。 资本市场讲故事需要想象力,开发者生态需要真金白银的便宜。DeepSeek两天之内,两头都喂了。 再看大洋对面:同一天,OpenAI那边GPT-6 Astra因为需求太猛,放话可能暂停新的Pro订阅注册——一个忙到要关门谢客,一个敞开大门还降价。 AI竞赛打到2026年秋天,画风已经很清楚了:有人在卖奢侈品,有人在卖自来水。 而对国内开发者来说,建议很实在:这几天可以把Agent任务往闲时(晚上和周末)挪挪,能再省一半;9月14日之后如果还在调v4-pro的接口,不用改代码,但记得去后台看看账单——会有惊喜。
