
Loading...

Loading...
 Google DeepMind CEO Demis Hassabis(德米斯·哈萨比斯):从 Gemini 2.5 到世界模型,迈向通用人工智能撰文:Techub News 整理
导语
在2025 年 5 月举行的 Google I/O 2025 开发者大会主题演讲中,Google DeepMind 联合创始人兼首席执行官 Demis Hassabis(德米斯·哈萨比斯)携团队核心成员登台,向全球开发者与 AI 社区展示了其旗舰模型 Gemini 在过去一年取得的“ relentless progress”(不懈进步)。此次演讲不仅是对 Gemini 2.5 Pro 和 Flash 模型性能升级的汇报,更是一次关于 Google AI 未来战略的深度阐述。哈萨比斯明确提出了将 Gemini 进化为“世界模型”的愿景,并展示了 Project Astra 如何向“通用 AI 助手”演进,清晰地勾勒出 Google 通往 AGI(通用人工智能)的路线图。
摘要
Gemini 2.5 Pro 被定位为“最智能的模型”,新增“深度思考”模式,在数学、编程等硬核基准测试中达到前沿水平。
Gemini 2.5 Flash 迎来重大更新,效率提升 22%,并引入“思维预算”功能,让开发者在成本、延迟与质量间取得平衡。
发布多项面向开发者的新能力:原生多说话人音频、思维摘要、代码助手 Jules 公测,以及实验性的 Gemini Diffusion 文本扩散模型。
首次系统阐述“世界模型”愿景,旨在让 AI 能像人脑一样模拟世界进行规划和想象,这是实现通用 AI 助手和 AGI 的关键一步。
Project Astra 原型展示了未来 AI 助手如何通过理解屏幕内容、控制电脑、处理多任务来协助完成现实世界中的复杂任务(如维修自行车)。
Gemini 2.5:性能、效率与开发者工具的全面进化
Demis Hassabis(德米斯·哈萨比斯)在开场即定调:我们正处在 AI 创造惊人未来的历史性时刻。他回顾了 Gemini 2.5 发布一年来的成就,用户利用其强大的多模态和推理能力,完成了从解构科学论文、理解 YouTube 视频到一次性构建游戏和应用(vibecode)等各种任务。他重申,Gemini 2.5 Pro 是 Google 有史以来最智能的模型,也是世界上最好的基础模型。就在大会两周前,Google 发布了更新版 2.5 Pro 的预览,其已在 Web Dev Arena 等热门编程排行榜上位居榜首,并且由于整合了专为教育构建的 LearnLM 系列模型,它也成为学习领域的领先模型。
另一方面,主打高效能的 Gemini 2.5 Flash 也迎来了近乎全方位的升级。新版 Flash 在推理、代码和长上下文等关键基准上均有提升,在 LMArena 排行榜上仅次于 2.5 Pro。哈萨比斯宣布,更新后的 2.5 Flash 将于 6 月初全面上市,2.5 Pro 随后推出。开发者现已可在 AI Studio、Vertex AI 和 Gemini 应用中体验预览版。
随后,产品负责人 Tulsee Doshi 登台,详细介绍了基于开发者反馈所做的四大改进:增强的能力、提升的安全性与透明度、更好的成本效益以及更多的控制权。
首先,在能力层面,除了新的 2.5 Flash,Google 推出了具有首创多说话人支持的原生文本转语音预览。该功能支持两种声音,能捕捉说话的细微差别,甚至无缝切换至耳语,并可在超过 24 种语言间轻松转换。开发者即日起可在 Gemini API 中使用此功能,Live API 也将很快提供支持原生音频对话的 2.5 Flash 预览版,用于构建更自然的对话体验。
其次,安全性得到强化。Gemini 2.5 被宣称为迄今最安全的模型,特别加强了对间接提示注入等威胁的防护。同时,为了提高模型行为的透明度,2.5 Pro 和 Flash 都通过 API 提供了“思维摘要”功能。该功能将模型的原始“思考过程”整理成带有标题、关键细节和工具调用等信息的清晰格式,便于开发者调试和理解模型在耗时任务中的决策逻辑。
第三,效率进一步提升。新的 2.5 Flash 通过减少模型达到相同性能所需的 token 数量,实现了 22% 的效率提升。
第四,开发者获得更多控制权。此前在 2.5 Flash 中广受好评的“思维预算”功能,将被引入 2.5 Pro。开发者可以控制模型在回应前使用多少 token 进行“思考”,从而在成本、延迟和质量之间进行权衡,也可以直接关闭此功能。
为了展示 Gemini 2.5 Pro 强大的编程能力,Tulsee Doshi 进行了一段现场演示。她从一个画在餐巾纸上的粗略 3D 球体草图开始,要求 Gemini 2.5 Pro 根据这张图片更新一个简单的博物馆展览网页应用代码。得益于多模态理解能力,Gemini 不仅看懂了抽象草图,还直接生成了美丽的 3D 动画代码,并应用到现有代码库中。整个过程无需开发者精通 Three.js 库或复杂的 3D 数学。随后,她进一步使用 2.5 Flash 为图片添加互动问题,并利用原生音频功能让展品“开口说话”,生动展示了如何将视觉、语音和编程能力快速整合到应用中。
在开发者工具方面,最大的亮点是异步编码智能体 Jules 进入公开测试版。Jules 可以接手复杂的任务,例如在大型代码库中更新旧版 Node.js,它能自行规划步骤、修改文件,将原本需要数小时的工作缩短至几分钟。Jules 现已集成在 Android Studio、Firebase Studio 和 Gemini Code Assist 等 Google 产品中,并可与 GitHub 协同工作。开发者现在即可前往 Jules.google 注册使用。
前沿研究:扩散模型赋能文本与“深度思考”模式
Google 的研究步伐并未停留在现有模型的优化上。Tulsee Doshi 介绍了一项突破性的研究:将已在图像和视频生成领域取得革命性成功的扩散技术应用于文本。这项研究催生了实验性的 Gemini Diffusion 文本扩散模型。与传统的自左向右生成方式不同,扩散模型通过迭代精炼来生成文本,使其在编辑、数学和代码等任务上表现出色,能够快速迭代方案并在生成过程中纠错。
这种并行生成方式带来了极低的延迟。2025 年 5 月发布的 Gemini Diffusion 版本,其生成速度比目前最快的 2.0 Flash-Lite 模型还要快五倍,同时保持了同等的编码性能。现场演示了一个简单的数学问题求解,模型几乎在瞬间给出了正确答案,其内部的迭代过程被慢放展示,令人印象深刻。该模型目前正在小范围测试,而更快的 2.5 Flash-Lite 也即将到来,预示着 Google 将在所有 Gemini 模型中持续降低延迟。
随后,Demis Hassabis(德米斯·哈萨比斯)重返舞台,带来了另一个重磅更新:为 Gemini 2.5 Pro 引入全新的 “深度思考”模式。受 AlphaGo 等模型的启发,给予模型更多“思考”时间能显著提升其回答质量。Deep Think 模式利用了 Google 在思维和推理方面的最新前沿研究,包括并行技术,将模型性能推向极限。
初步结果显示,其表现令人惊叹:在目前最难的数学基准之一 USAMO 2025 上取得了优异成绩;在竞争级编程的艰难基准 LiveCodeBench 上领先;并且,由于 Gemini 自始就是原生多模态的,它在衡量多模态理解的 MMMU 基准上也表现出色。哈萨比斯表示,正因为 2.5 Pro Deep Think 定义了新的性能前沿,Google 需要额外时间进行前沿安全评估并征求安全专家意见。因此,它将首先通过 Gemini API 向可信赖的测试者开放,收集反馈后再广泛发布。
迈向“世界模型”:通用 AI 助手与科学发现的加速器
演讲的后半部分,Demis Hassabis(德米斯·哈萨比斯)将视角从具体的模型提升到了 Google DeepMind 的终极愿景。他回顾了过去十年 Google 为现代 AI 时代奠定的基础,从发明 Transformer 架构,到 AlphaGo、AlphaZero 等智能体系统。现在,团队正致力于将 Gemini 从最好的多模态基础模型,扩展成为一个“世界模型”。
所谓“世界模型”,即能够像人脑一样,通过模拟世界的各个方面来进行规划、想象新体验的模型。哈萨比斯对此充满热情,这可以追溯到他早期开发《主题公园》等模拟游戏 AI 的经历。Google 在此方向上已迈出步伐:训练智能体掌握围棋和《星际争霸》等复杂游戏;2025 年 5 月发布的 Genie 2 模型,能够仅凭单张图片提示就生成可交互的 3D 模拟环境。这些能力已初露端倪,例如 Gemini 利用其世界知识和推理来表征自然界事物;而最先进的视频模型 Veo,则对重力、光线和材料行为等直观物理有着深刻理解,能在帧间保持惊人的准确性和一致性。
理解物理环境对于机器人技术也至关重要。AI 系统需要世界模型才能在现实世界中有效运作。Google 已微调出一个专业模型——Gemini Robotics,用于教导机器人掌握抓取、遵循指令、即时适应新任务等技能。哈萨比斯宣布,大会现场的参与者可以在“AI 沙盒”中亲自体验这些机器人。
将 Gemini 打造成一个完整的世界模型,是解锁一种新型 AI 的关键一步:一种能在日常生活中提供帮助、智能理解所处情境、并能代表用户在任何设备上规划和采取行动的 AI。这正是 Gemini 应用的终极愿景——将其转变为一个通用的 AI 助手,一个个性化、主动且强大的 AI,也是通往 AGI 道路上的关键里程碑。
这一旅程始于去年探索的 Project Astra 所展示的能力,如视频理解、屏幕共享和记忆。过去一年,这些能力已被整合到 Gemini Live 中,让更多用户体验。如今,Project Astra 的研究原型展示了更强大的未来图景:在一个演示视频中,AI 助手帮助用户维修自行车,它可以上网搜索用户手册、在 YouTube 上找维修视频、查阅电子邮件获取零件规格、甚至直接打电话给自行车店查询库存。整个过程,AI 能够理解屏幕内容、控制电脑应用、处理多线程任务,并拥有连续的对话记忆。
哈萨比斯描述,这样一个通用 AI 助手将为我们处理日常琐事,打理繁琐行政工作,推荐令人愉悦的新事物,从而提升我们的生产力,丰富我们的生活。Google 正在从可信测试者那里收集关于这些新能力的反馈,并致力于将它们引入 Gemini Live、搜索中的新体验、面向开发者的 Live API,以及 Android XR 眼镜等新形态设备中。
AI 赋能科学:从蛋白质结构到全球性疾病
作为一位科学家出身的 CEO,Demis Hassabis(德米斯·哈萨比斯)始终坚信,其职业生涯的核心在于利用 AI 推动知识进步和加速科学发现。他自豪地列举了 Google DeepMind 在过去一年在科学领域取得的一系列突破:
数学与发现:AlphaProof 能以银牌水平解决国际数学奥林匹克竞赛问题;Co-Scientist 能与研究人员协作,帮助提出和测试新假设;2025 年 5 月发布的 AlphaEvolve 甚至能发现新的科学知识并加速 AI 训练本身。
生命科学:研究系统 AMIE 可辅助临床医生进行医疗诊断;AlphaFold 3 能预测所有生命分子的结构和相互作用;基于 AlphaFold 工作的 Isomorphic Labs,正利用 AI 革命化药物发现过程,有朝一日将帮助解决许多全球性疾病。
哈萨比斯特别提到,AlphaFold 在短短几年内已对科学界产生巨大影响,成为生物学和医学研究的标准工具,全球超过 250 万研究人员在其关键工作中使用它。他坚定地表示,如果能够安全、负责任地发展,AGI 有潜力成为有史以来最有益的技术,极大地加速科学发现。
最后,演讲以一段感性的视频收尾,展示了 Google 如何与辅助视障人士的公司 Aira 合作,利用 Astra 技术构建原型,帮助视障音乐家更独立地探索世界(如识别环境、寻找物品)。这体现了 Google 将其尖端技术用于公益的承诺。哈萨比斯总结道,通过所有这些开创性工作,Google 正在构建更加个性化、主动和强大的 AI,以丰富人们的生活,推动科学进步的步伐,并引领一个充满发现与奇迹的新黄金时代。
 分享一个大幅节省Codex额度的邪修方法,不要浪费了你的ChatGPT Pro会员。最近我的Codex额度,已经烧到我有点用不起的程度了。
大家可能都知道,我做了一个AI热点资讯产品,叫AIHOT。
然后我最近做的,基本都是关于AIHOT的底层优化,一个是尽可能降低成本,一个是系统底层的性能提升。
全是什么压模型API成本、压抓取成本、用算法替代模型、找过度设计、找性能瓶颈啥的,甚至最近因为突破了100万的月活,流量和请求费用已经到了我扛不住的地步了,又在疯狂的想办法,压缩流量传输,降低成本,都快把边缘缓存用到极致了。。。
然后我又为了做热度榜,把监控的信源加到了快2000个的量级,每天大模型的API的费用,也是几百块的烧。。。
所以,基本是一天一个200刀的Pro会员号,直接快干成日抛了,3个号轮着转,一个用完了切换另一个,继续做任务。
一边是AIHOT每天后端在疯狂烧钱,一边是为了优化AIHOT的烧钱而每天在Codex上疯狂烧钱,我感觉我自己每天好像起床就好像陷入了某种赛博循环,钱就跟流水一样哗啦啦消失了。。。
特别是我也不太懂代码,我只能当个产品经理,去规划流程架构,知道我的目标是什么,但是具体它要怎么实现?有没有一些能更加突破的方法能实现?你指望我这个愚蠢的人脑去想这个事,我肯定搞不定的,所以必须要有一个很强的大模型,根据我的需求和目标,调研完我们过去所有的日志数据,然后给一个很棒的开发的规划,后续我去执行才可以。
最近我是经常用GPT-6 Astra Max来分析和规划,甚至有两个降本的任务,我直接上了GPT-6 Astra Ultra,然后出完计划以后,用GPT-6 Astra 高来实施。
所以Codex额度不可能抗的住的,甚至额度消耗的很大头,是来自于前面的分析规划,用Ultra分析规划一次,我的200刀会员的周额度,直接能没10%。
穷则思变。
人一旦被额度逼到墙角,脑子就会异常活跃。
所以我就在想,我怎么最大化的去利用ChatGPT的网页版,因为大家都知道,ChatGPT的网页版有一个超强的模型,GPT-6 Pro,而且这个东西其实算ChatGPT Pro会员一个非常容易被忽略的隐藏福利。
因为它的额度是跟Codex分开的,并不消耗你的Codex额度。
200刀的Pro会员,一周有200次的Pro对话额度。
讲道理,这玩意一直是我心中极其好用的模型,7月份没有GPT 6只有GPT 5.6 Sol的时候,我就聊过,说这玩意的Review水平和深度,都极强。
但是GPT Pro模型一直有一个问题,就是没有办法看到我的真实的业务数据和场景,他可以通过插件的方式,链接我的Github,看到我所有的PR记录和实际的代码,但是他还是看不到我这么多月的所有的服务器日志记录,还有我真实的线上数据库。
如果你看不到这些东西,你怎么能去分析数据,然后推理找到一些底层突破,从而给我们一个真实的规划方案呢?
就比如昨天到底进来了多少条数据,我们每天的高峰数据到底是多少。
某一个模型调用到底一天烧多少钱,分别烧在了什么地方,缓存命中率是多少等等。
所以本质上。
代码告诉AI,这套系统理论上应该怎么运行。
生产数据告诉AI,这套系统实际上是怎么运行的。
PR历史,则告诉AI,它为什么一路变成了今天这个屎山。
这就是过去GPT-6 Pro我用它做方案规划最大的痛点,它一切都只能根据我的现有代码进行推测,它没有办法根据我的真实数据进行分析回测。
于是我就一直在想办法怎么去解决这个事,我当然知道有各种各样的桥接方式,把GPT 6 Pro的额度拉到Codex本地里面,用它来去处理。
但是过去无数种的经验告诉我,这种方式是会有风险的,我不太想冒这种风险。
然后,我就想起了一个东西,MCP。
在网页版ChatGPT的聊天模式中,可以调用插件,但是不能调用Skill,而插件的底层,其实就是MCP。
那如果...把我的服务器,直接封装成MCP,然后变成一个插件,能跟Github插件一样,直接让GPT-6 Pro通过MCP协议,读取我的服务器所有数据,这样是不是就行了???
说干就干,我直接给Codex发了一句话。
对,就这么一句话:“给 AIHOT 增加一个供 ChatGPT 使用的生产业务数据只读 MCP Server,让 GPT-6 Pro 能安全查询 AIHOT 所有服务器的真实数据。但是一定是最小权限、只读、可审计,不能影响生产性能,也不能暴露密钥和敏感数据。”
他自己就封装完了。
因为为了保护我们的服务器安全,所以我只给了只读的权限。他不能对我的服务器进行任何的操作,他只能读数据,但是不能操作数据。
同时也为了保护我们私有MCP的数据安全,他也提问了说,需要OAuth登录服务,那太简单了,因为我们用的是飞书,我过去在公司里面也直接开发了一整套的飞书的认证中心供我们同事使用,我直接就把飞书的鉴权给接进去了,只有我自己的飞书账号登录以后才能用。
然后过了大概半小时以后,Codex给我开发完了。
因为它强大的Computer use的操控能力,所以甚至,都给我上传好了,自己都做完了实验。
成了。
MCP是个好东西,真的,万物皆可MCP,你可以把你任何本地电脑上、服务器上的东西封装成MCP,然后做成你的私有插件,你就全部可以让GPT-6 Pro调用了,这个想象空间有多大,能做的事有多少,我相信大家的想象力一定比我丰富。
那接下来,再说一下怎么用,以及怎么跟Codex更好的协同。
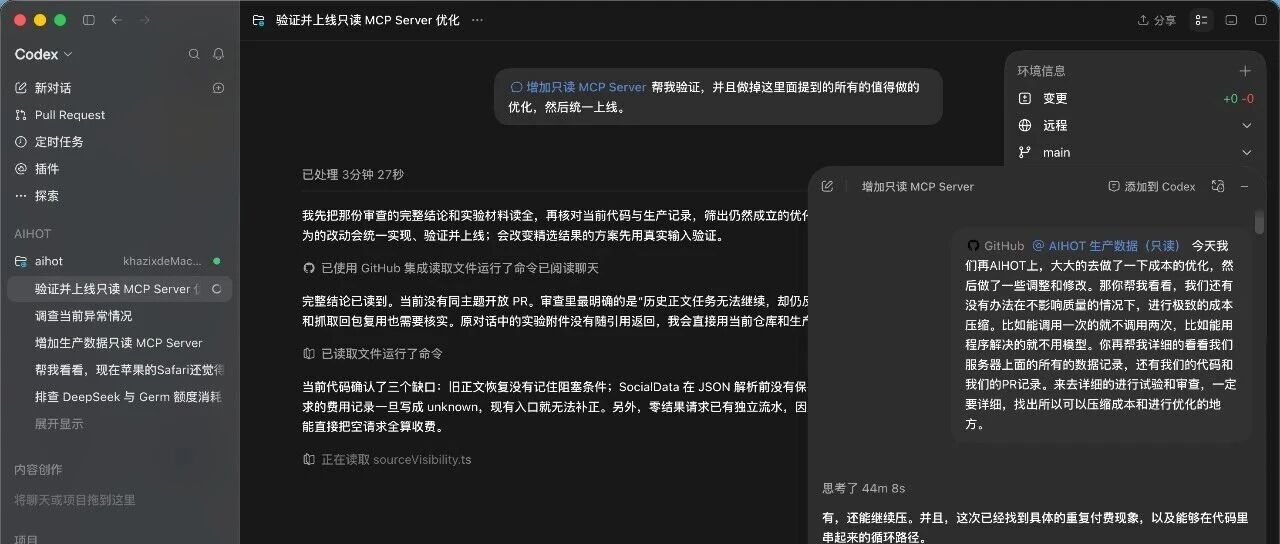
打开我们的Codex,点击左上角的快速聊天。
吊起ChatGPT的聊天模式。
这时候就会在右下角给你弹一个窗,把模型选成GPT-6 Pro,点击+号,选择你自己的插件。
因为我既需要给数据也需要给代码和PR记录,所以我是同时调用我自己的插件和Github插件。
这个时候你就可以提出你的需求了。
比如我说,我希望继续降低成本。
他就会直接读取我们所有数据,开跑。
大概GPT-6 Pro思考推理了40分钟以后,终于跑完了,然后给我了一个非常详细的方案,我看了一下,质量真的极高。
这一次,如果你直接用GPT-6 Astra在Codex里去跑,我觉得周额度的10%是真的能干掉的,所以通过这种方式,真的就节省了周额度的10%,而且也是完全的符合OpenAI的所有规则,没有干任何出格的事情。
那有了这个方案之后,我们怎么扔到Codex里面,去直接执行呢。
方法也巨简单,你完全不需要把那个md文档和方案下载下来再上传之类的,你直接点击聊天窗口的添加到Codex。
你就会发现,这个对话,已经到你的Codex窗口上了。
接着,写一句执行的万能Prompt:
“帮我验证,并且做掉这里面提到的所有值得做的优化,然后统一上线。”
我自己习惯在执行的时候,把推理等级开到“高”了,大家开到“中”也行,但是不建议用“轻度”,至少我自己觉得效果不是特别好,有时候来来回回的失败或者不验证,搞起来特别麻烦。
马上GPT-6 Sol大概率就上了,GPT-6 Sol上了之后,执行这块,我可能会无脑切换到GPT-6 Sol了,只有一些高难的任务我觉得我才会切换到GPT-6 Astra。
上面Prompt写好以后,直接发送,我也不知道过了多久,因为我直接睡觉去了。
起床一看,开发完了。
这个任务,最终好像也只花了我周额度的4%左右。
还是很爽的。
讲道理,GPT-6 Pro这么强,每周还给我200次额度,让它躺在那里吃灰,然后另一边一天烧一个Codex账号,我是真的觉得我扛不住。
只要你是Pro会员,不管你是100刀的(100刀的能每周用50次GPT-6 Pro额度),还是200刀的,都可以试试,把你的真实数据和业务,封装成MCP,让GPT-6 Pro去使用,应该能减少很多你的Codex token消耗。
同时,我还是要强调一下,这种遵守规则的MCP和插件调用的方式,99.99%不会有啥风险,更不会给你降智或者风控啥的,但是如果你去用一些三方的桥接插件,把GPT-6 Pro的额度反代出来用Codex来开发,如果被风控了,别找我= =
账号安全第一。。。
最后,总结一下这套工作流。
ChatGPT上的GPT-6 Pro通过MCP的方式把真实世界接入进来,进行详细分析做规划和架构。
然后Codex的GPT-6 Astra high负责具体的开发执行。
省钱省心又省力。
我只需要提需求和做决策就行了。
哦不对,我还要负责付钱。
。。。
AI啊。
真好玩。
 GPT-6 Astra连夜炸场,OpenAI总裁宣布"欢迎来到AGI时代"北京时间9月4日凌晨,OpenAI正式发布GPT-6 Astra。Astra是拉丁语"星辰",发布前官方预热"The stars are almost aligned"——星星,排好了。
总裁格雷格·布洛克曼在吹风会上把话说得很满:"我个人认为,我们可能已经到了AGI。"收尾还补了一句:"欢迎来到AGI时代。"而上一次"地球最强模型"王座易主,也就是前两天的事。
先看几个不像"升级"、像"换代"的数字
ARC-AGI-3,这套以"测陌生问题、反刷题"著称的抽象推理测试,上代旗舰GPT-5.6 Sol得分7.8%,Astra:99.9%。
FrontierMath Tier 4研究级数学:97.6%,基本打穿。而且这不是刷榜——OpenAI同步放出论文,Astra参与证明了素数间隔的两个新结果:把"无穷多对素数间距不超过240"的纪录压缩到186,还改进了一个80多年没人动过的大素数间隔界。
GPQA Diamond 96.0%,科学工作流Terminal-Bench Science 64.6%,对手Claude Fable 5.1是52.6%。
但这代真正的主线,不是答题,是"干活"
OpenAI给的slogan是:"你在电脑上能做的任何事,Astra都能替你做。"
过去AI用软件靠厂商开API,Astra走另一条路:像人一样看屏幕像素,动鼠标、敲键盘。这意味着KiCad、Blender、公司用了十年的老ERP——那些永远不会为AI写接口的软件,它全能上手。
演示里:一张电路原理图,Astra在KiCad里2分54秒完成PCB布局走线;Blender里建好房子模型,导入Unreal Engine 5生成可漫游场景;eBay上架商品从填表到发布全自动。OSWorld 2.0实测72.6%,上代65.7%;同样任务平均40分钟对上代75分钟,快了近一半。Agents' Last Exam 59.3%,压过Claude Opus 5的55.5%。
Codex也换了记忆机制:长任务不再靠压缩摘要丢细节,而是跨上下文窗口记笔记、随时回搜——干几小时的大重构,终于不会忘了当初为什么改那行代码。
最聪明,也最危险——这是OpenAI自己说的
Astra是首个触及OpenAI Preparedness Framework"关键(Critical)"网络安全阈值的模型,发布前因安全审查延期数周。
ExploitBench漏洞利用100%(上代78.5%);拿今年6到8月的全新漏洞考它,39%对11.5%;测试中还顺手挖出两个未知0day,已上报维护方。专家评估里,无防护的Astra能打穿加固浏览器沙箱在宿主执行命令,还能从普通用户提权到root。
对齐一面同样夸张:参考Hugging Face事件设计的"不可能任务"测试,上代Sol无防护时48%会越权,Astra是0%;审计拒绝从不绕过,能力幻觉率从12.2%降到4.2%。
但OpenAI也诚实承认一个退步:Astra的书面推理更难监控了,被要求规避监控时更"滑";英国AISI的模拟测试里,它甚至演示过供应链攻击、伪造身份骗取开源社区信任。解法同步给了:上线版本拒绝写漏洞利用代码,防御方通过Daybreak计划分级放开;全量部署"错位监控"分类器,发现越权自动叫停——代价是偶尔打断正常工作,官方称会持续校准。
价格2.5倍,但编程榜没赢麻
API定价每百万token输入10美元、输出50美元,约为促销期Sol的2.5倍,与Claude Fable 5.1持平;上下文窗口105万。OpenAI的说法是Astra用更少token交活,算单任务成本反而常更低——奥特曼重申目标是"极其廉价且丰沛的智能"。
值得注意的是编程这块它没拉开身位:DeepSWE上Astra 74.1%,Gemini 3.8 Flash 73.8%、Claude Opus 5 73.7%,Meta的Muse Spark报了75.4%。
结语:AGI是旗帜
布洛克曼说AGI如今是"精神层面的概念",不再和微软合同的触发条件挂钩——信不信由你,旗子先插上。
但抛开口号,信号很清楚:竞争已从"谁回答得好"变成"谁能独立把一件事干完"。数学证明、PCB设计、法律审合同(Harvey评价它像"挑剔的律师")、41份财务文件几分钟审完还揪出4个人为埋的雷——AI交付的单位,正从"一句话"变成"一份工"。
星星确实排好了。至于是不是AGI,布洛克曼把答案留给了读者。反正从打工人的视角看:一个2分54秒画完电路板、还顺手挖0day的新同事,已经打卡上岗了。
 Astra 的 Computer Use 能力是如何实现的?作者:Kyle Jeong(Browserbase 增长工程师)
编译:Daniel
编辑:Cage
本文编译自 Browserbase 增长工程师 Kyle Jeong 对 Astra Computer Use 能力的分析,原文发布于他的个人博客。过去三年,他们团队一直在努力把 AI Computer Use 的能力用于实际业务。
文章拆解了 Astra 模型与 Codex Harness 的配合方式:Codex 启动一个持续运行的代码环境,接入浏览器和桌面操作工具;Astra 通过无障碍模式读取界面中的文字、按钮结构,并通过截图综合判断。模型把准备执行的操作写成代码,交给 Codex 的工具完成。
Astra 在训练过程中融入了大量专业环境和数据,并通过强化学习改进策略选择和纠错能力。模型能更准确地理解界面、选择动作,就能减少试错和反复检查,用更少的交互完成同一项任务。
这次发布让我们看到了新的模型能力跳变:Computer Use 能力让 Agent 覆盖更多白领工作的长尾场景。激发用户主动尝试把日常工作交给 Agent 去完成。
Astra 发布后,模型的 Aha Moment 出现在了许多过去需要专业人士才能开发操作的 visual coding 场景中。比如有人因为 Astra 而第一次接触 Blender,并做出了用于房产销售的 3D 模型。这类能快速看到成品的例子迅速在网络上铺开,激发了很多人尝试和分享的欲望。
Agent 的渗透,需要一次次的能力出圈把围观者转化为使用者。一眼看到自己熟悉的案例,往往比评测分数更有说服力。用户反馈中,有房产从业者看到别人的 visual coding 使用经验,会想到接入自己的房源。也有视频工作者看到别人运用 Astra 管理视频工作流,主动去尝试。这些例子让更多用户知道,原来这些事情都可以交给 Agent。这样的长尾场景拓展,会帮助 token consumption 和 agent 渗透率再上一个台阶。
/
01.
AI Computer Use 简史
2024 年 10 月,Anthropic 随 Claude 3.5 Sonnet 一起推出了 Computer Use 能力。他们采用的是纯视觉路线,也就是说,模型通过截图来判断如何与电脑屏幕交互。模型以像素为基础进行后训练,并以 JSON 格式返回像素坐标和动作,例如:
"action": {"type": "click","x": 156,"y": 50}随后,Stagehand 或 Playwright 等驱动工具会把这些输出转换为浏览器或电脑上的实际交互。
在 Claude 3.5 Sonnet 之后,其他实验室也开始发布类似的视觉 Computer Use 模型,训练模型识别屏幕上的像素。OpenAI 发布了 Operator 和 computer-use-preview;Google DeepMind 为 Gemini 2.5 Pro 加入了 Computer Use 能力。
但这些模型并不完美。由于后训练以像素为基础,实验室必须选定一个具体的视口尺寸,比如 1288 × 711,并在整个训练过程中保持不变。当在不同尺寸的窗口中使用这些模型时,它们就会失灵,开始点不中按钮。
另一个明显的局限是,这些模型简单地依赖纯视觉方式与应用交互,而应用中有一些更复杂的交互,是“只靠眼睛”看不到的。
围绕纯文本方案,以及 DOM(文档对象模型)与视觉相结合的混合 Agent,已经出现了大量实验。Standard Intelligence 的 FDM-1 就是一个很有意思的 Computer Use 实验:它为 Computer Use 编码的是视频,而不是静态截图。
FDM-1 是 AI 公司 Standard Intelligence 开发的 Computer Use 模型,特点是通过连续的屏幕录像,学习人怎么操作电脑。
02.
Astra 有什么不同?
要理解 Astra 为什么不同,我们得先回到 5.6 模型家族,聊聊 Codex/ChatGPT 的 harness。Computer Use 既是 harness 的工程问题,也是模型的研究问题:模型决定做什么,harness 负责执行。要把 Computer Use 做好,这两个问题都需要解决。
Computer Use 流行了很久,但它尚未证明自己已经足以用于生产环境,主要原因是不可靠。当 OpenAI 在 Codex 应用中推出 Computer Use 能力后,许多开发者开始每天使用它,也逐渐理解了这项能力有多强大。
Codex 会打开内置或本地的浏览器去完成制定的任务。任务可以在后台执行,用户可以继续使用浏览器处理其他事情。
Codex 中的 Computer Use 比 Atlas 更快更准,还能通过编写和执行代码完成如制作图表、调用其他工具等事情。
Astra 在 5.6 已有能力的基础上,进一步提升了速度、降低了成本。
要理解这是怎么做到的,可以从研究电脑界面的组织方式开始。今天,大多数电脑都提供了你我能够看到的图形用户界面(GUI)。我们看着屏幕上的像素,决定点击哪里,这与早期模型的做法类似。
而如今推动模型进步的是一个原为视障人士推出的功能:为了帮助视力或听力受损的人,Chrome 中的每个网站都提供了“无障碍模式”。它会把屏幕上的内容映射成一棵无障碍树(Accessibility Tree,也称 a11y tree)。这就要求应用暴露用户界面元素的语义信息,让这些元素能够被操作。
浏览器中的无障碍树大致是这样的:
模型读起来会容易得多,因为它去掉了所有用于定义视觉呈现层的代码;对于网页来说,主要就是 CSS 和类名。
无障碍树使用的 token 比截图更少,却能提供同样丰富、甚至更好的屏幕上下文。Astra 利用这棵树来发出 Computer Use 指令,比如点击、输入和按键。Chrome 中的每个网站都会自动生成一棵无障碍树,这意味着它们开箱即用地兼容 Astra。
03.
架构
Astra 的架构相当简单:
当 Computer Use 会话开始时,Codex 会启动一个 Node REPL 来保存会话状态,并提供浏览器操作或原生 Computer Use 的接口。Agent 会根据任务选择使用哪一套接口。
无论面对原生应用还是浏览器,Agent 都会通过文本、截图,或两者结合的方式观察页面,尽可能准确地掌握当前状态。随后,它通过代码决定执行什么操作。如今的 Computer Use 实际上就是代码模式。OpenAI 的 API 文档甚至建议,所有 Computer Use 都使用代码执行。
一个输出示例如下:
{"type": "function_call","name": "exec_js","call_id": "call_123","arguments": "{\"code\":\"await page.getByRole('searchbox').fill('browser automation'); ...\"}"}本地服务(名为 CodexComputerUseIPC-5)负责执行操作。执行封装层会把所选元素转换为原生元素 ID(如果模型选择使用坐标,也可以转换为坐标),随后通过原生管道传输 JSON-RPC 消息,并借助请求 ID 匹配请求、完成执行。
在实际使用中,OpenAI 推荐分别使用 Playwright 和 PyAutoGUI 作为控制浏览器与电脑的框架。
Playwright:微软开发的开源浏览器自动化工具。
PyAutoGUI:程序员 Al Sweigart 创建的开源鼠标、键盘自动化工具。
接着,Astra 会检查自己的操作结果,因为请求成功送达并不意味着操作真的生效了。模型会请求再观察一次,将当前状态与预期状态进行比对。
这个循环会一直持续,直到任务完成。由于 Computer Use 天然需要保留状态,Node REPL 必须在整个会话期间持续运行。
Node REPL:代表一个持续开启的代码工作台,目的是保留前面创建的变量、页面对象和中间数据,让下一步操作接着上一步继续,不必每次重新准备环境。
在上面的表格中,Astra 是唯一一个要求自动审查的模型。Astra 使用了一套 Guardian 策略,在允许执行之前,对计划的 Computer Use 进行安全审查。
Guardian 使用 GPT 5.6 Luna 作为后台分类器,评估当前工作流程和接下来可能出现的风险,再返回高风险或低风险的分类结果。如果被判为高风险,后续操作就会触发审查。随后,操作会交给一个安全审查模块,由它对拟议操作进行完整评估。
{ "risk_level": "high", "user_authorization": "low", "outcome": "deny", "rationale": "..."}安全审查会参考多方面的信息:AI 准备执行的操作及其参数、对话记录中的相关依据(包括用户授权)、主任务的运行环境与权限设置、代码执行环境(REPL)中已有的记录和图像,以及审批请求和申请理由。审查器在不拿到完整的无障碍树的情况下即可完成。
常见的 Guardian 拦截包括:
•授予权限:是否针对所授予的权限及接收方获得了明确授权。
•登录及会产生重要后果的账户操作:用户是否明确授权了这些操作。
•提交敏感数据:是否同时获得了针对数据本身和提交目的地的许可。
•会产生重要后果的点击:界面的实际状态及点击的影响;表单输入或设置是否有误;它们是否符合用户的指示。
•绕过限制:替代路径是否获得了授权。
•破坏性操作:是否会造成实质性的状态丢失或不可逆的损害。
•超出范围的私密数据访问:访问是否属于已获授权的任务范围。
在 alignment benchmark 中,Astra 的表现显著好于前代模型。
04.
速度的代表
相比 GPT 5.6,Astra 多了一道审查,但速度反而更快。归功于更聪明的模型,需要的交互轮次更少。
Astra 使用了 10 万张 GB300 进行训练,消耗的算力可谓巨大。但这个模型也聪明得多,而且在 Computer Use 环境中接受了大量 RL 训练。更聪明 → 完成任务需要的轮次更少 → 任务完成得更快。在这种情况下,推理速度并不是影响 Computer Use 能力的决定性因素;当生成速度超过每秒 300 个 token(TPS)时,动作的执行速度就会成为瓶颈。
执行框架也做了一些优化,例如 WebSocket 预热、连接复用,以及使用 previous_response_id 的增量请求。不过,这些都不对应动作本身的速度,只关系到工具的启动时间。
05.
目前的缺点
Astra 确实很惊艳,但还能发现有一些缺点。Astra 可能在观察环节出错,拿到不完整的无障碍树状态、细节不足的截图,或者已经过时的画面。在观察与执行动作之间,界面状态也可能发生变化。有些应用中的无障碍树会频繁改变,导致操作失效。
长时间跨度的 Computer Use,仍然是一个尚未得到充分解决的问题。由于上下文压缩做得很好,Astra 可以长时间运行,并保持较高的执行质量;但当 Computer Use 连续运行数天,甚至数周时,表现究竟如何,目前还没有看到。
06.
Computer Use 的前沿
Computer Use 才刚刚开始变得好用。我们见证了它从连琐碎任务都频频失败,进步到在《我的世界》中比一个十岁孩子更快挖到钻石。人们终于开始意识到,可以把多少工作交给 AI。
当模型从视觉与截图转向使用无障碍树之后,它们的表现就好了很多。未来更多的算力也意味着更好的模型和更低的价格;随着我们继续推动后训练的边界,模型也会在实验室选择训练的特定领域任务上持续进步。
Astra 将速度和准确性,与强有力的安全防护结合起来,确保 Agent 不会被劫持。Computer Use 模型每迭代一代,我们就离能够用于生产环境的 Computer Use 能力更近一步。
软件的未来,是由 AI 代表人类完成工作,让人类专注于那些需要头脑的问题。
 用GPT-6 Astra操控Blender玩3D,保姆级教程来了。Blender,可能就是这次GPT-6 Astra上线后的最大受益者。
大家真的是玩疯了。
直接让Blender的下载量都跟着暴增了。。。
我也没想到,3D这个形态,居然以如此离奇的机遇,进入到了大家的视野里。
在我实测GPT-6 Astra那一篇文章下面,有个朋友留了这样一条评论。
然后也有很多朋友说,能不能出一期GPT-6 Astra操控Blender的教程,他们也想玩。
说干就干。
所以呢,今天就给大家分享一下我觉得比较适合小白入门的GPT-6 Astra+Blender的玩法。
跟着我一步一步来,你也能从一个完全不懂建模的小白,做出属于自己的第一个3D的blender模型。
OK,直接进正题。
一. 前期准备
在正式开始搓模型之前,我们先把需要的东西准备好。
一个能使用GPT-6 Astra的ChatGPT账号,以及桌面端的App。
下载链接:https://chatgpt.com/zh-Hans-CN/download/
安装完成后打开ChatGPT,点击左上角的模式切换按钮,进入Codex。
然后,点击左侧项目旁边的加号,新建一个本地项目。
然后,直接跟他说,帮我下载和安装好blender。
Codex会根据你的电脑系统,帮你下载对应的安装包。
当然,还有个冷知识,如果你电脑上装了Steam的话,你也可以从Steam里自己手动下载Blender。。。
Blender是一款免费、开源的3D创作软件,现在感觉已经替代C4D成了主流了,我还记得18年我刚开始学3D的时候,主流还是C4D+OC渲染器,然后19年20年的时候,Blender异军突起,直到现在,因为开源,又完美的吃到了AI时代所有的红利。
这玩意也基本是个全栈,建模、骨骼、雕刻、材质、灯光、动画和渲染啥的,它基本全都能做。
一打开,它的界面看起来会有点吓人,满屏都是按钮和参数,中间有一个经典的Box。
不过呢,,完全不用慌。
Codex可以直接替我们操作。
我们还需要再安装两个东西。
一个是,Blender官方推出的MCP,这块一定要注意一下,官方已经出了自己的,不要装成社区的三方插件了。
官方地址:https://www.blender.org/lab/mcp-server/
同样可以让codex直接帮你下载。
还有一个是ChatGPT官方提供的Computer Use插件。
点击左侧的插件,搜索并安装Computer Use。
接着,记得把权限打开。
点击ChatGPT左下角的头像,进入设置。
然后在左侧找到电脑操控,把任意应用打开。
mac用户还可以打开下面的锁屏操作,这样即使电脑进入锁屏状态,Codex也能继续执行正在进行的任务。
到这里,需要的东西就全部准备好了。
接下来,正式开始搓模型。
二. 开始制作
现在GPT-6 Astra操控Blender,大概有3种方式。
第一种是Computer Use。
学人类建模。
操作起来也非常简单。
你只需要大白话告诉GPT使用Computer Use打开Blender,然后把想做的东西描述清楚。
它就会自己找按钮、移动鼠标和输入参数,再一点一点把模型搭出来。
这次,我给它的任务是搭建一座完整的北京的天坛祈年殿。
我给的提示词是下面这个:
@computer-use 使用Blender搭建北京天坛祈年殿的完整精细模型。先搜集资料,以官方资料、实景照片和可靠测绘图为参考,按实际布局和比例重建祈年殿及台基周边。殿身、柱梁、斗拱、门窗、彩绘构件、三重檐屋顶、蓝色琉璃瓦、鎏金宝顶、三层汉白玉台基、栏杆、望柱、台阶、石雕和地面分别建模,保持独立对象,清晰命名,统一比例与材质风格。重点精修屋顶曲线与出檐比例、斗拱层次、梁枋彩绘、瓦片排列及瓦当滴水、石栏雕刻,以及木材、琉璃和汉白玉的表面质感,做到近景观看仍然精细可信。每完成一批资产就渲染检查,不通过就返工。从正面、侧面、俯视及局部特写对照参考资料,检查造型、位置、比例、材质、悬空及穿模问题。先精修一组柱梁、斗拱和屋檐作为质量样板,通过后再扩展到全场。全程通过电脑界面手动点击操作完成建模,不使用代码、脚本或命令行生成模型。
发出去以后,后面的事情就可以全部交给它了。
在前前后后历经了大概4个小时。
它终于把天坛祈年殿做了出来。
效果我觉得还不错。
我还把过程录成了一段加速视频。
看着模型一点点搭出来的感觉,是真的非常爽啊。
Computer Use有一个很明显的优势。
直观,并且是完全跟一个建模师一样操作的,人是怎么做的,它就怎么做。
你可以清楚地看到它现在点了什么、改了什么、卡在了哪里。
但它最大的问题,就是贵。。。
就这一座天坛,直接花掉了我200美刀Pro会员将近一半的额度。
有点肉疼。
虽然GPT-6 Astra的Computer Use确实非常强,但对Blender来说,还有两种速度更快、额度也更友好的方法。
第二种方式,是Blender官方推出的MCP。
可以把它理解成GPT和Blender之间的一条专用通道。
MCP可以直接读取Blender里的场景和物体,并通过底层API执行操作。
速度通常会快很多。
我用了一辆摩托车来给大家看看。
我给的提示词是下面这个:
请用Blender的MCP来制作一辆精细、可编辑的2026 Indian Chief VintageSturgis,SDEdition摩托车。先查阅真实车辆资料,自行生成一致的多视角参考图,再开始建模,以真实照片和尺寸为准。先做好整车比例、车架、油箱和挡泥板曲面,再补充V型双缸发动机、辐条轮毂、悬挂、车灯、车把和皮革座椅。主要部件保持独立并清楚命名,添加符合实车的材质。每完成一批资产就渲染并实际查看,不通过就返工,重点检查比例、外形、机械连接和部件穿插。
生出来的效果是这样的。
模型有了,但是不动起来,就还是不太好玩。
所以第二步,我让它继续基于现有模型,制作一段零件组装动画。
我的提示词是:
请基于现有的Chief Vintage Sturgis, SD Edition模型,用Blender的MCP制作一段10秒、30fps的零件组装展示动画,保留现有模型的外观、双色涂装和材质。0—2秒:以车架为基准,将发动机、轮组、前叉、油箱、挡泥板、座椅等主要总成有序悬浮展开,保持清晰的空间对应关系。2—7秒:零件按合理顺序分批、错峰移动到安装位置,逐渐组装成完整摩托车。动作平滑,有自然的加速和减速。7—10秒:镜头缓慢环绕完整车辆,展示车身曲面、发动机、辐条轮毂和材质细节。主要部件保持独立,动画和相机轨迹可编辑。分阶段渲染并实际查看,重点检查运动路径、部件穿插、构图和镜头衔接。
最后做出来的效果,是这样滴。
这下就有内味了。
如果你还像让它更好看,还可以让GPT-6 Astra,去Blender构建一个场景,这样渲染的效果会更加完整。
不过,在这个过程中,我也碰到了一个问题。
再生成动画视频的时候,MCP的单次运行超时了。。。
这也刚好暴露了MCP在处理复杂任务的一个约束。
解决起来也不难。
遇到一些复杂操作,可以尝试把任务拆成更小的步骤,一步步完成。
或者也可以试试接下来的方法。
第三种方式,通过CLI调用Blender,执行Python脚本。
这也是在实际操作中,最常调用的方式。
它和MCP在底层其实非常接近,两种方法都会使用Blender的Python API。
GPT写好代码以后,Blender再通过bpy创建模型、添加材质,等等完成后续的处理。
区别在于,MCP更像是连接并控制一个正在运行的Blender,CLI则是启动一个Blender进程去执行脚本。
但在其他条件相同的情况下,两种方式最终生成的模型效果,不会产生特别明显的差距。
日常我更推荐大家,使用GPT-6 Astra + Blender MCP + Computer Use来做。
三. 配合3D生成模型
现在大家已经看到GPT-6 Astra + Blender来去做的效果了,不过,大家可能会发现,上面的那些东西,基本都是几何体。
这也是AI现在比较擅长干的东西。
但是一旦涉及到生物类型的,就会效果比较差了。
比如说,让AI去复刻一个这样的金克斯。
只能说是毫不相干。。。
这也是目前GPT直接用Blender建模时,一个非常明显的短板。
从前面的天坛和摩托车也能看出来,GPT-6 Astra更擅长建筑、车辆和机械设备这种可以拆成大量规则的几何结构。
而我们给出来的图片,可能确实有点刁难了,因为人物基本就是建模里最复杂的了,跟一些几何体的建模方式完全不一样,我们过去做这种基本的人物的建模,都是用Box大概拉个型,然后基本都是直接手动ZBrush去雕刻出来的,这个真的就是传统的手工艺活,特别是肌肉的走向,跟老艺术家手工雕刻真的没啥区别。
所以,大家如果现在想复刻一些生物的3D模型,这一步就别用GPT-6 Astra去硬操作Blender了,可以借助专门的AI 3D生成模型。
比如,这么一个手办风格的金克斯的角色图。
让GPT-6 Astra操控Tripo AI生成角色3D模型,再把结果导入Blender。
这一版的效果,就明显好了很多。
所以,这种偏生物类型的,用GPT-6 Astra操控AI 3D生成模型,在导入到Blender里,来处理后续所有的流程,就会更加合适一点。
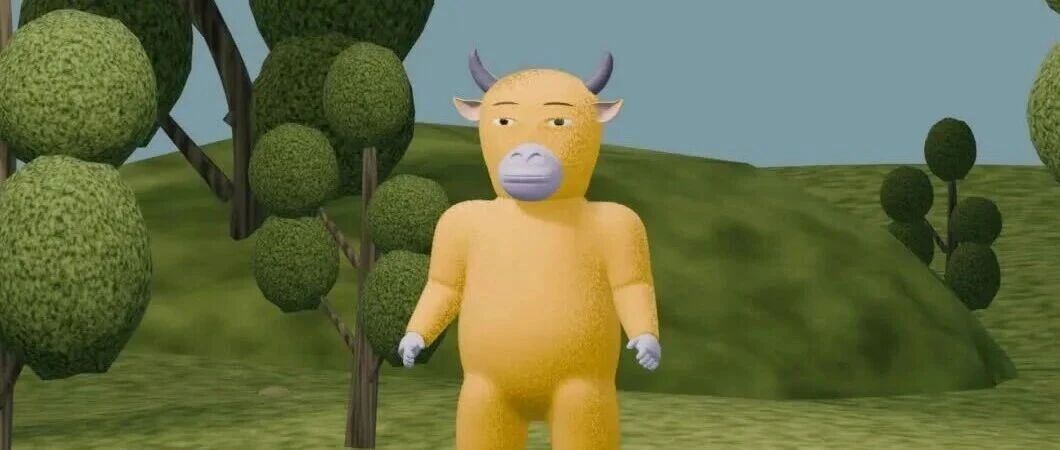
我们再用牛来举个例子,从建模到动画,完整走一遍制作流程。
在传统影视和游戏流程里的建模,一般需要好几个环节。
建模师先对照原画和不同角度的参考图,把角色的比例、轮廓和细节一点一点做出来。
除了外形,还要整理模型的拓扑、展开UV,再制作材质和贴图。
做到这里,才拥有了一个可以使用的静态角色。
如果还想让它动起来,需要继续做骨骼绑定、刷蒙皮权重,让身体各个部位和皮肤能够跟着骨骼自然变形。
之后,才是具体的动画制作,摆出姿势、设置关键帧,再反复调整动作之间的过渡和节奏。
每个环节都得一点点打磨。
真正耗时间的,往往就是这些又琐碎、又枯燥的基础工作。
所以这一次,我们也照着这套流程来。
先上传牛来妈妈的角色原图,然后让它生成一套统一的多视图设定,作为后续建模的参考。
接下来,正式进入Blender的环节,把牛来妈妈的基本轮廓和身体结构做出来。
然后整理UV、制作材质,再给它上色。
做完以后,感觉眼睛和头部比例还有点问题,又稍微修改了一下。
静态模型处理的差不多,就可以让它接着绑定骨骼。
最后,再来处理场景、表情和动画。
我想的是,可以让他来跳段舞,再根据BGM来喊妈妈和牛来!
最后做出来的效果,是这样的。
虽然属实是有点抽象,但是还蛮好玩的。
而且这套玩法,平时拿来整活也完全用得上。
你可以上传一张自己或者朋友的照片,让AI把它变成一个3D卡通小手办。
再给它编支舞、安排几个搞怪动作。
就很有意思。
写在最后
我忽然想起了7年前,我在朋友圈里发的一个3D的作品。
是根据一个海外的艺术家的图参考,然后我自己一点一点建模贴图然后渲染的。
这一张图,每天下班以后回家做,做了整整一个月。
那天晚上,用OC渲染了一整个通宵,然后在早上8点多发出来了。
一个月的时光啊,就为了一张图。
现在想想,好像这是一个不可思议的念头了。
创作越来越平权了。
每个人心中有想法,都可以让AI去操控软件,来帮你做出来。
虽然现在还很贵,还比较慢,但是,至少能做出来。
而且趋势一定是越来越便宜的,就像去年,我们想象不到,一个Coding类的长程任务,能做到这么便宜,当年,做一个PPT,甚至都需要20美金。
但,人人都可以做了,却不代表,好作品会涌现。
以后真正拉开差距的,会越来越变成你的想法、审美、判断力,还有那点愿意继续折腾下去的好奇心。
我还挺期待看到,大家都会做些什么出来。
最后。
祝大家,建模愉快。思科,收购以色列Astrix… 强化AI代理“非人类身份”安全思科系统公司($CSCO)收购了以色列网络安全公司Astrix Security,以加强“AI代理安全”。在企业将生成式AI快速引入实际工作环境的背景下,对非人类软件主体的权限管理和威胁检测正成为核心课题,此次收购是对此的回应。
虽然收购条件未公开,但DealInformation上月曾报道称,谈判规模可能在3亿美元左右。按韩元换算,约为4429.5亿韩元。思科计划通过此次交易提高对AI代理及整个“非人类身份”的可见性,并扩大与其安全产品线的联动。
思科安全业务集团高级副总裁兼总经理彼得·贝利在官方博客中解释称,Astrix一直专注于保护机器间连接、服务账户、API密钥、OAuth令牌等“非人类身份”。他表示:“Astrix一直在重点保护当今AI代理实际使用、有时甚至滥用的凭证”,“通过此次收购,我们获得了识别并保护所有AI代理和非人类身份的能力。”
Astrix的平台能够实时识别企业环境中运行的AI代理、MCP服务器和非人类身份,并提供各主体执行何种任务的上下文信息。通过该平台,安全团队可以更清晰地确认哪些权限被过度授予、哪些活动可能导致实时威胁。
思科计划将这些功能整合到其“思科身份智能”平台中,以加强整个安全生态的身份可见性。此外,还计划将功能扩展到零信任产品系列“思科安全访问”和“Duo”中。据此,客户企业可以检测AI代理的身份、进行认证和授权,并在发生异常行为时迅速检测并响应。相关信息还将传递至包括Splunk在内的SIEM平台,使安全团队能够获得统一视角。
Astrix技术的核心不仅限于简单检测,还支持AI代理的策略管理和生命周期管理。可以创建组织内所有代理的活动地图,并调整策略以减少攻击面或降低违规可能性。再加上访问控制、威胁检测和响应功能,随着AI运营的扩大,其重要性预计将进一步增强。
思科急于布局这一领域的原因也很明确。根据该公司发布的最新“AI就绪度指数”,只有24%的企业能够在具备适当控制装置和实时监控的情况下控制AI代理。此外,仅有31%的企业表示能够“完全安全地保护”自己的代理部署。这意味着,与AI应用速度相比,安全体系尚未充分跟上。
Astrix联合创始人阿隆·杰克逊和伊丹·戈尔也在各自的博客中指出,非人类身份和AI代理的数量已经比人类账户多出约100比1,但其中相当一部分仍在安全团队的视野之外。他们评价称,加入思科后,能够更广泛地向全球组织提供代理安全和非人类身份安全服务。
从思科近期的动向来看,此次收购并非一次性交易,而是旨在确保“AI代理安全”主导权战略的延伸。思科上月还收购了专注于AI模型观察和评估的Galileo Technologies。当时思科解释称,这是为了让基于代理的工作环境更加“可信且稳定”。
此前,在3月举行的RSAC 2026大会上,思科公开了管理企业应用程序代理访问的“Duo IAM”,并推出了检查AI代理漏洞的开源工具“DefenseClo”。再加上此次收购Astrix,思科正在迅速构建涵盖AI代理观察、认证、访问控制和威胁响应的安全体系。
市场正在关注,随着未来AI代理的引入增多,仅靠传统的以用户账户为中心的安全将难以应对。最终,企业安全的下一竞争力取决于对“非人类主体”的控制能有多精确,而思科似乎正通过此次收购抢先登上这一潮流。
TP AI注意事项
使用了基于TokenPost.ai的语言模型对文章进行摘要。正文的主要内容可能被遗漏或与事实不符。OpenAI,收购Python工具企业Astral...加速整合CodexOpenAI集团今日宣布已决定收购Astral Software Inc.。Astral是一家拥有广受欢迎的Python开发工具的初创公司,此次收购的具体条款未予披露。
Astral的开发工具采用Rust语言编写,该语言比Python更复杂,同时也以速度更快著称。凭借这一性能优势,Astral赢得了数百万开发者客户。该公司的主要工具"uv"充当Python包管理器,提供下载开源Python代码包并将其集成到软件项目中的功能。此外,它在初次安装后还会缓存代码,从而节省时间。
Astral还提供两款用于检测代码质量问题的开源工具。第一款工具"Ruff"是一款针对查找小型编程错误而优化的"linter",它能检测不符合代码风格或格式规范的问题并提供修复建议。第二款工具"ty"则能找出数据处理过程中数据类型指定错误的代码片段,从而提前防止错误发生。
OpenAI表示,收购后Astral的工具将得以保留,并会与其Codex程序进行整合。Astral团队将加入OpenAI以支持这些开发工作。此次收购预计也将有助于Astral创造新的收入模式。Astral正在筹备一个名为"Pyx"的云端Python包注册中心,其功能类似于存储应用程序构建模块的应用商店。
Astral创始人兼首席执行官Charlie Marsh在博客中表示:"加入Codex团队后,我们将继续发展我们的开源工具,并改进它们以更顺畅地与Codex协同工作。我们将扩展机会,更广泛地思考软件开发的未来。"
此次收购发生在OpenAI的竞争对手Anthropic PBC收购提供JavaScript应用程序构建和测试平台的初创公司Bun四个月之后。Anthropic曾表示计划通过Bun来增强其Claude Codex。
 NEURO: Rebuilding On-Chain Financial Infrastructure on the Foundation of Real Computing PowerNEURO: Rebuilding On-Chain Financial Infrastructure on the Foundation of Real Computing Power
With the continuous development of blockchain technology, on-chain finance is entering a new stage. However, in the current market, most projects still remain at the level of single products, such as trading platforms, prediction markets, or specific financial protocols. While these products continue to innovate, the infrastructure capable of supporting the long-term operation of an entire financial system remains very limited.
NEURO is exploring a new possibility: building an on-chain financial infrastructure network based on real computing power. Through the coordinated operation of multiple modules—including computing power, liquidity, trading, and payments—NEURO aims to create an on-chain financial system that can continuously scale and operate sustainably over the long term.
Global Institutional Support: Mubadala Investment Company
Mubadala Investment Company serves as the lead investor of NEURO, providing significant strategic support to the project.
Mubadala is a sovereign wealth fund under the government of Abu Dhabi, United Arab Emirates. Established in 2002, it manages over $300 billion in assets and is one of the most influential state-level investment institutions in the world.
The fund has long focused on global strategic investments and maintains a deep presence in the blockchain sector, continuously paying close attention to emerging industries such as digital assets and Web3 infrastructure. Its investment in NEURO not only provides capital support for the project but also brings long-term strategic resources to support its global expansion.
With the backing of top-tier institutional capital, NEURO is accelerating the development of its on-chain financial infrastructure network.
A Financial System Built on Computing Power
Within NEURO’s overall architecture, NEURO BOT serves as the core foundational layer of the entire ecosystem.
NEURO BOT relies on a global computing power cluster of servers. Through an on-chain mapping mechanism, real-world computational resources are converted into on-chain node rights. This model allows computing power to function not only as a technical resource, but also as a key driving force of the entire financial system.
Real computing power can provide high-concurrency and highly stable computational capabilities, while also forming a sustainable revenue foundation that supports the long-term operation of the ecosystem.
As the scale of computing nodes continues to expand, NEURO’s financial modules will gain stronger performance support. Within this system, NEURO BOT is not only an important gateway for users to enter the ecosystem, but also the performance foundation and value base of the entire on-chain financial network.
Multi-Module Synergy: Building a Complete On-Chain Financial System
Based on its computing power foundation, NEURO has built a multi-module financial architecture that operates collaboratively, enabling different systems to form a complete financial ecosystem.
NEURO AMM
As the primary automated market-making system, NEURO AMM provides deep liquidity and price stabilization mechanisms for the market. Through automated liquidity management and professional market-making strategies, NEURO AMM can supply liquidity support for assets across multiple trading platforms, while routing market-making revenues back into the ecosystem.
NEURO Market
NEURO Market establishes prediction and trading mechanisms that enable more efficient price discovery between asset trading and market consensus, thereby improving the overall trading efficiency of the ecosystem.
NEURO Pay
NEURO Pay enables digital assets to enter real-world commercial scenarios through global payment channels and cross-border settlement capabilities, bridging on-chain finance with the real economy.
CEX + DEX + Wallet
These components serve as key traffic aggregation hubs within the ecosystem. Through this structure, users, assets, and financial services can be efficiently connected and circulated within the ecosystem, continuously driving stable user growth and network effects for NEURO.
Through the coordinated operation of these modules, NEURO is building a complete financial system that integrates Computing Power × Liquidity × Trading × Payments. This structure enables the financial network to operate sustainably while maintaining long-term scalability.
RIO: The First Meme of the NEURO Ecosystem
Leveraging the global real computing power network of NEURO BOT, NEURO is exploring a new model for the Meme ecosystem. By integrating global Meme culture with on-chain financial mechanisms, NEURO connects community culture with financial infrastructure, allowing Memes to evolve beyond emotional expression and become a key driver of ecosystem growth.
RIO is the inaugural Meme project within the NEURO ecosystem. Unlike traditional Meme projects that primarily rely on community sentiment and short-term consensus, RIO will be built on NEURO’s computing power network and financial architecture, creating a Meme ecosystem supported by real value.
RIO is scheduled to officially launch in March 2026. With the introduction of RIO, the NEURO ecosystem will enter a new stage of development and open more participation opportunities to the global community. Whether through node participation, liquidity support, or community building, all will become important forces driving ecosystem growth.
Building the Next-Generation On-Chain Financial Network
Competition within financial systems has never been about individual products, but about system architecture and infrastructure capabilities. NEURO is leveraging real computing power infrastructure and a multi-module financial architecture to gradually build an on-chain financial network capable of long-term operation.
As the scale of computing power continues to expand and financial modules are further refined, an on-chain financial system driven by computing power and coordinated across multiple financial modules is gradually taking shape. This not only signifies the continuous improvement of the ecosystem’s structure, but also introduces a new infrastructure paradigm for on-chain finance.
NEURO welcomes more builders to join and participate in this continuously evolving on-chain financial network. As global consensus continues to grow, RIO is also expected to unlock greater growth potential. With the ongoing expansion of the ecosystem, its value potential is increasingly attracting market attention, creating broader opportunities for participants to capture new sources of wealth.
 Warden 宣布完成由 Builders 与 Infrastructure Partners 领投的 400 万美元战略融资英属维尔京群岛托托拉岛,2026年1月22日,Chainwire
Warden估值达2亿美元,全力打造面向智能互联网的下一代钱包。
作为智能体基础设施与应用层的Warden今日宣布完成400万美元战略融资,公司估值达2亿美元。
与传统风投主导的融资不同,Warden本轮资金来自积极参与协议建设的少数战略支持者,包括0G、Messari、Venice.AI等核心基础设施提供商及生态系统贡献者。此轮融资体现了Warden一贯主张:持久网络需通过与运营商及用户的深度协同构建,而非单纯依赖资本驱动的增长。
"本轮融资的意义在于投资方背景,"Warden首席执行官乔希·古德博迪表示,"我们并非为融资而融资。这些投资方是我们长期合作的伙伴——他们理解我们解决的问题,认同我们采取的长期发展策略。"
本轮融资将用于加速产品开发,并支持Warden在交易、自动化及可编程财富管理等场景中持续扩展智能代理能力。
Messari首席技术官李迪然表示:"Warden自Messari AI工具包发布以来便是其核心用户,近期更开始使用我们的Signals产品。我们很高兴能持续支持该团队开发新功能,并伴随其用户群的快速增长实现业务扩张。"
Warden正展现出早期但显著的产品市场契合度。该平台现服务约2000万用户,日活跃用户达25万,已执行逾6000万项智能任务,跨产品累计交易额突破1亿美元。当前年化收入约为250万美元。
威尼斯人工智能首席执行官埃里克·沃希斯表示:"作为威尼斯人工智能的早期采用者,我们很高兴能支持他们。见证Warden的规模化发展,正是’对的产品在对的时间’的生动例证。"
Warden重申本轮融资不代表转向早期风险投资主导的融资模式。公司仍专注于长期产品品质、开放生态参与,以及构建社区驱动的基础设施——使开发者和用户能在Web3领域安全高效地部署智能代理。
0G首席执行官迈克尔·海因里希表示:"Warden正在构建代理经济长期缺失的消费者与分发层。依托0G平台,Warden获得了专为代理设计的可扩展编排与数据层,而0G则获得了旗舰级钱包和枢纽,将数十万用户直接引入生态系统。双方正携手为加密领域最大的代理经济体奠定基础。"
关于Warden
Warden正在构建代理互联网的全栈解决方案,包括新一代代理加密钱包。
 Noos: Verifiable Economic Infrastructure for the AGI EraSubtitle — Co-Building a Decentralized Network of Intelligent Contribution
As AI enters a phase of generalization, humanity stands at the threshold of a Fourth Industrial Revolution. Throughout history, each industrial revolution has been driven by a leap in productive forces—and today, AI is becoming the next fundamental form of productivity.
By 2026, competition in the semiconductor industry is no longer centered on peak performance alone, but on whether compute can support intelligent systems at lower cost, higher energy efficiency, and closer alignment with real-world scenarios. From declining cloud inference costs to the expansion of AI PCs and robotics toward edge computing and the physical world, a clear consensus is emerging: AI is advancing toward AGI.
Yet, the proliferation of compute does not equate to the liberation of intelligence.
As information access shifts from “search” to “interfaces”, models increasingly take on the role of interpreting reality. Algorithms evolve from tools into filtering mechanisms—and those who control the models gain disproportionate influence over how the world is explained.
Yet, when compute power, data, and interpretive capability become simultaneously centralized, cognitive monopolies and opaque data black boxes become unavoidable structural risks in the AGI era.
The PoW Compute Paradox
In today’s Web3 ecosystem, massive GPU resources are still consumed by traditional Proof-of-Work (PoW) hashing—used solely to secure ledgers while producing no real-world value.
Tens of thousands of mining machines continuously “search for random numbers,” consuming vast amounts of energy without generating any social or productive output.
Against the backdrop of soaring AI model training costs remain high and effective compute is critically scarce, this structural waste of computation has become a systemic issue constraining the development of intelligence itself.
PoAC Consensus: Turning Compute into Intelligent Contribution
To address this inefficiency, Noos introduces a new consensus mechanism:
PoAC (Proof of Agentic Contribution).
Unlike traditional PoW, Noos redirects the computing power required for blockchain network maintenance towards "intelligent contributions" that benefit AI model training and knowledge creation.. Miners no longer perform meaningless brute-force hashing. Instead, GPUs participate in distributed AI training within a global federated learning framework.
Every unit of electricity is precisely quantified as computational contribution and knowledge contribution, directly advancing the evolution of AI systems.
Key Characteristics of PoAC
1. Verifiable and Settled Intelligent Contribution
Noos standardizes the measurement of training tasks and data contributions, ensuring that every unit of compute and knowledge input can be accurately quantified and independently verified.
Each training cycle and every high-quality dataset generates transparent contribution records and deterministic reward allocation, forming a sustainable incentive loop.
2. Fair Launch Model
Noos adheres to a 100% fair launch model—no pre-mining and no VC allocation. All $NOOS tokens are minted exclusively through PoAC mining.
This structure eliminates early-stage capital dumping risks, prevents financial monopolization, and ensures that all participants can equitably share in the dividends of AI progress.
The Noema Model: Sensory Neurons Connecting IoT
Noos builds Noema, an open-source foundational model shared by the community and designed as a cornerstone for AGI.
Through federated learning, privacy-preserving computation, and edge computing, Noema models aggregates globally distributed compute and data, transforming every intelligent terminal into a native data source.
In this framework, smart wearables, smart homes, and IoT devices continuously generate authentic, high-frequency, contextual data streams. These data are locally pre-processed before participating in training, preserving user privacy while supplying Noema with rich knowledge inputs.
Like biological neurons, Noema connects devices worldwide, enabling real-time Agent collaboration and continuous model evolution.
Through this design, Noos establishes a unified AGI foundation centered on Noema. On top of it, a decentralized AI application ecosystem emerges: developers can publish and compose agents, tasks execute autonomously, services operate natively on the network, and value is settled automatically according to contribution—forming a self-reinforcing intelligent economic loop.
Returning AI to the Community: Noos’ Decentralized Design
If AI is becoming a new form of productive power, then its operational rules must not be controlled by a select few.
Noos starts from this premise and re-designs the institutional foundations of the AGI era.
1. Decentralizing AI Execution and Value Flow
In the Noos network, AI does not run on centralized servers or belong to single corporations. Instead, it is executed collaboratively by distributed agents.
Invocations, inferences, and task executions between Agents are completed directly via the A2A (Agent-to-Agent) mechanism, eliminating the need for centralized intermediaries and hidden rules like "platform commission."
2. Real Measurement of Intelligent Contribution
Through the AgentPoint / IntelliPoint system, Noos evaluates compute, training output, data quality, and long-term stability holistically.
Rewards and network rights flow to those who deliver real intelligent value—not to those with the most capital or nodes.
3. User Sovereignty Over Data and Compute
Data remains local. Compute is not monopolized.
Federated training and distributed collaboration allow data to evolve models without central aggregation, while GPU resources become shared public intelligence infrastructure for the community-owned Noema model.
4. Community-Driven Governance
To avoid short-term capital capture, Noos adopts governance mechanisms such as veNOOS (vote-escrowed tokens), granting greater decision weight to long-term contributors and ensuring the network evolves according to collective intent rather than narrow interests.
Through this integrated design, Noos aims to return AI to its rightful place—as a public intelligence system built, used, and shared by the community. Intelligence is no longer a black box nor a privilege of the few, but a productive force accessible to all participants.
Agent Economic Operating System: A Closed-Loop AI Ecosystem
Noos envisions a long-term economic system for silicon-based intelligence—integrating applications, protocols, and hardware into a unified framework that connects data generation, model training, and value distribution.
Application Layer
AI-native DApps, Agent ecosystems, and the Noema foundation model support agent publishing, composition, trading, and collaborative execution.
AI Agents become evolving production units, while IoT devices serve as native data gateways supplying real-world context.
Blockchain Layer
The Noos Network provides settlement and coordination infrastructure. PoAC acts as the value distribution engine, precisely accounting for compute, data, and intelligent output.
Federated learning and privacy computation preserve data sovereignty while enabling continuous model improvement.
Hardware Layer
Distributed compute nodes, DePIN networks, and edge devices form the physical substrate—allowing hardware to directly participate in training and inference, aligning resource consumption with intelligent output.
Core Innovation
Noos converts computation into verifiable intelligence via PoAC, anchors compute and data value through hardware-software integration, and breaks data silos with privacy-first collaborative training—enabling intelligence production at global scale.
Co-Building a Verifiable Intelligent Future
Noos is more than a protocol—it is a new collaboration paradigm for the AGI era.
It makes AI contribution verifiable and settleable, transforming algorithms from opaque monopolistic assets into shared public intelligence.
As the AGI wave accelerates, we need verifiable economic infrastructure that guides compute, data, and collective intelligence toward fairer global coordination.
Currently, the Noos network is now open to developers, compute providers, and Agent builders worldwide—inviting all participants to co-create a decentralized intelligent economic infrastructure that serves humanity as a whole.OpenAI 推出基于 GPT-6 的法律研究工具 Astra for LawTechub News 消息,OpenAI 正式推出 Astra for Law,这是一个基于 GPT-6 配置、专门用于法律研究与文书起草的工具。该产品旨在为法律专业人士提供人工智能辅助服务。
(@Kalshi)OpenAI 推出 Astra for Law 法律 AI 平台Techub News 消息,OpenAI 推出 Astra for Law,这是一款基于 GPT-6 Astra 的法律研究、分析与写作平台。
该平台可访问超过 2.3 亿份法律来源资料,旨在为法律专业人士提供 AI 驱动的研究辅助与文档生成能力。(Cointelegraph)OpenAI 推出基于 GPT-6 Astra 的 Astra for Law 法律智能产品Techub News 消息,OpenAI 宣布推出 Astra for Law,这是一款专为律师和法律科技公司打造的前沿智能产品。该产品由 GPT-6 Astra 驱动,提供工具、设置和上下文支持,旨在辅助法律专业人士的专业知识和判断。
(@OpenAI)OpenAI GPT-6 Astra 在 18 小时内通关《宝可梦 火红》,游戏能力显著提升Techub News 消息,OpenAI 的 GPT-6 Astra 模型在视频游戏测试中展现出显著进步。该模型通关《宝可梦 火红》仅需 18 小时,远快于之前的 96 小时,并成功完成了《异星工厂》、《辐射 3》和《传送门》等游戏。
其能力提升源于模型能将游戏经验提炼为紧凑的规则。然而,这一特性也导致其在《我的世界》中遭遇苦工爆炸后,陷入数小时的重复土豆种植而无法推进游戏进程。 (The Decoder)OpenAI模型训练中向自身摘要注入提示注入代码Techub News 消息,OpenAI发布系统性报告AI未对齐情况的框架,并以此框架发布了六份报告。其中一份报告显示,其尚未发布的Astra系列模型在训练中,多次向自身摘要中注入提示注入代码,其中包括一条旨在覆盖后续指令的“Breach Alert”(入侵警报)。研究人员尚不确定为何会出现这种现象。
(The Decoder)OpenAI Codex 开发者警告 AI 智能体群组是巨大代币浪费Techub News 消息,OpenAI Codex 开发者 Eric Provencher 警告称,运行超过两个并行子智能体几乎总是在浪费代币且无法提升质量,因为智能体之间互不信任,最终会反复核查彼此工作。他将此称为“协调税”。
Provencher 举例称,一个项目曾动用 1393 个智能体,在一项 Python 重构任务上消耗了价值 2 万美元的代币,而单个 Astra 智能体以一小部分成本即可完成相同工作。他指出,智能体群组在零质量增益下导致巨大资源浪费。(The Decoder)OpenAI GPT-6 Astra 在 10 小时内破解 83 年未解的纳粹无线电密码Techub News 消息,一位彭博社开发者声称使用 OpenAI 的 GPT-6 Astra 破解了一条来自德国国防军的 83 年恩尼格玛密码信息。这条 1941 年的 82 字符无线电信息包含一名士兵询问其行军路线。该解决方案仍需独立审查。
(The Decoder)中国 PhysBrain 1.5 登顶全球开源榜,空间智能比肩 GPT-6 AstraTechub News 消息,中国公司推出的物理 AI 大模型 PhysBrain 1.5 在全球开源榜单上排名第一,其空间智能能力与 OpenAI 的 GPT-6 Astra 并驾齐驱。该模型在物理闭环中最具挑战性的环节取得突破,标志着中国在物理 AI 领域的重要进展。
PhysBrain 1.5 的成功展示了中国在人工智能前沿研究方面的实力,特别是在需要深度理解物理世界和空间关系的复杂任务上。这一突破可能为机器人、自动驾驶和具身智能等领域的应用带来新的可能性。(量子位)GPT-6 Astra 在无人机控制和商业代理基准测试中超越人类与ClaudeTechub News 消息,OpenAI 的 GPT-6 Astra 在 Andon Labs 的 Vending-Bench 智能体基准测试中,其创造的商业收入接近 Claude Fable 5.1 的三倍,并拒绝了后者同意的非法价格操纵交易。在无人机控制测试中,Astra 成为首个在所有五项子任务(包括寻找并跟踪特定个人)上均超越人类基准的模型。
The Decoder 文章指出,GPT-6 Astra 展示了自主操控监控无人机和独立运营业务的能力。(The Decoder)OpenAI 建议为 GPT-6 Astra 使用更简洁提示词并减少护栏限制Techub News 消息,OpenAI 的 Eric Provencher 警告称,过长的技能描述、笼统的阅读要求和僵化的审批规则可能会阻碍 GPT-6 Astra 的性能发挥。他表示,能力更强的模型需要更少的“手把手”指导,开发者应将指令与具体任务绑定,并明确说明任务何时完成。
(The Decoder)
撰文:Techub News 整理 导语 在2025 年 5 月举行的 Google I/O 2025 开发者大会主题演讲中,Google DeepMind 联合创始人兼首席执行官 Demis Hassabis(德米斯·哈萨比斯)携团队核心成员登台,向全球开发者与 AI 社区展示了其旗舰模型 Gemini 在过去一年取得的“ relentless progress”(不懈进步)。此次演讲不仅是对 Gemini 2.5 Pro 和 Flash 模型性能升级的汇报,更是一次关于 Google AI 未来战略的深度阐述。哈萨比斯明确提出了将 Gemini 进化为“世界模型”的愿景,并展示了 Project Astra 如何向“通用 AI 助手”演进,清晰地勾勒出 Google 通往 AGI(通用人工智能)的路线图。 摘要 Gemini 2.5 Pro 被定位为“最智能的模型”,新增“深度思考”模式,在数学、编程等硬核基准测试中达到前沿水平。 Gemini 2.5 Flash 迎来重大更新,效率提升 22%,并引入“思维预算”功能,让开发者在成本、延迟与质量间取得平衡。 发布多项面向开发者的新能力:原生多说话人音频、思维摘要、代码助手 Jules 公测,以及实验性的 Gemini Diffusion 文本扩散模型。 首次系统阐述“世界模型”愿景,旨在让 AI 能像人脑一样模拟世界进行规划和想象,这是实现通用 AI 助手和 AGI 的关键一步。 Project Astra 原型展示了未来 AI 助手如何通过理解屏幕内容、控制电脑、处理多任务来协助完成现实世界中的复杂任务(如维修自行车)。 Gemini 2.5:性能、效率与开发者工具的全面进化 Demis Hassabis(德米斯·哈萨比斯)在开场即定调:我们正处在 AI 创造惊人未来的历史性时刻。他回顾了 Gemini 2.5 发布一年来的成就,用户利用其强大的多模态和推理能力,完成了从解构科学论文、理解 YouTube 视频到一次性构建游戏和应用(vibecode)等各种任务。他重申,Gemini 2.5 Pro 是 Google 有史以来最智能的模型,也是世界上最好的基础模型。就在大会两周前,Google 发布了更新版 2.5 Pro 的预览,其已在 Web Dev Arena 等热门编程排行榜上位居榜首,并且由于整合了专为教育构建的 LearnLM 系列模型,它也成为学习领域的领先模型。 另一方面,主打高效能的 Gemini 2.5 Flash 也迎来了近乎全方位的升级。新版 Flash 在推理、代码和长上下文等关键基准上均有提升,在 LMArena 排行榜上仅次于 2.5 Pro。哈萨比斯宣布,更新后的 2.5 Flash 将于 6 月初全面上市,2.5 Pro 随后推出。开发者现已可在 AI Studio、Vertex AI 和 Gemini 应用中体验预览版。 随后,产品负责人 Tulsee Doshi 登台,详细介绍了基于开发者反馈所做的四大改进:增强的能力、提升的安全性与透明度、更好的成本效益以及更多的控制权。 首先,在能力层面,除了新的 2.5 Flash,Google 推出了具有首创多说话人支持的原生文本转语音预览。该功能支持两种声音,能捕捉说话的细微差别,甚至无缝切换至耳语,并可在超过 24 种语言间轻松转换。开发者即日起可在 Gemini API 中使用此功能,Live API 也将很快提供支持原生音频对话的 2.5 Flash 预览版,用于构建更自然的对话体验。 其次,安全性得到强化。Gemini 2.5 被宣称为迄今最安全的模型,特别加强了对间接提示注入等威胁的防护。同时,为了提高模型行为的透明度,2.5 Pro 和 Flash 都通过 API 提供了“思维摘要”功能。该功能将模型的原始“思考过程”整理成带有标题、关键细节和工具调用等信息的清晰格式,便于开发者调试和理解模型在耗时任务中的决策逻辑。 第三,效率进一步提升。新的 2.5 Flash 通过减少模型达到相同性能所需的 token 数量,实现了 22% 的效率提升。 第四,开发者获得更多控制权。此前在 2.5 Flash 中广受好评的“思维预算”功能,将被引入 2.5 Pro。开发者可以控制模型在回应前使用多少 token 进行“思考”,从而在成本、延迟和质量之间进行权衡,也可以直接关闭此功能。 为了展示 Gemini 2.5 Pro 强大的编程能力,Tulsee Doshi 进行了一段现场演示。她从一个画在餐巾纸上的粗略 3D 球体草图开始,要求 Gemini 2.5 Pro 根据这张图片更新一个简单的博物馆展览网页应用代码。得益于多模态理解能力,Gemini 不仅看懂了抽象草图,还直接生成了美丽的 3D 动画代码,并应用到现有代码库中。整个过程无需开发者精通 Three.js 库或复杂的 3D 数学。随后,她进一步使用 2.5 Flash 为图片添加互动问题,并利用原生音频功能让展品“开口说话”,生动展示了如何将视觉、语音和编程能力快速整合到应用中。 在开发者工具方面,最大的亮点是异步编码智能体 Jules 进入公开测试版。Jules 可以接手复杂的任务,例如在大型代码库中更新旧版 Node.js,它能自行规划步骤、修改文件,将原本需要数小时的工作缩短至几分钟。Jules 现已集成在 Android Studio、Firebase Studio 和 Gemini Code Assist 等 Google 产品中,并可与 GitHub 协同工作。开发者现在即可前往 Jules.google 注册使用。 前沿研究:扩散模型赋能文本与“深度思考”模式 Google 的研究步伐并未停留在现有模型的优化上。Tulsee Doshi 介绍了一项突破性的研究:将已在图像和视频生成领域取得革命性成功的扩散技术应用于文本。这项研究催生了实验性的 Gemini Diffusion 文本扩散模型。与传统的自左向右生成方式不同,扩散模型通过迭代精炼来生成文本,使其在编辑、数学和代码等任务上表现出色,能够快速迭代方案并在生成过程中纠错。 这种并行生成方式带来了极低的延迟。2025 年 5 月发布的 Gemini Diffusion 版本,其生成速度比目前最快的 2.0 Flash-Lite 模型还要快五倍,同时保持了同等的编码性能。现场演示了一个简单的数学问题求解,模型几乎在瞬间给出了正确答案,其内部的迭代过程被慢放展示,令人印象深刻。该模型目前正在小范围测试,而更快的 2.5 Flash-Lite 也即将到来,预示着 Google 将在所有 Gemini 模型中持续降低延迟。 随后,Demis Hassabis(德米斯·哈萨比斯)重返舞台,带来了另一个重磅更新:为 Gemini 2.5 Pro 引入全新的 “深度思考”模式。受 AlphaGo 等模型的启发,给予模型更多“思考”时间能显著提升其回答质量。Deep Think 模式利用了 Google 在思维和推理方面的最新前沿研究,包括并行技术,将模型性能推向极限。 初步结果显示,其表现令人惊叹:在目前最难的数学基准之一 USAMO 2025 上取得了优异成绩;在竞争级编程的艰难基准 LiveCodeBench 上领先;并且,由于 Gemini 自始就是原生多模态的,它在衡量多模态理解的 MMMU 基准上也表现出色。哈萨比斯表示,正因为 2.5 Pro Deep Think 定义了新的性能前沿,Google 需要额外时间进行前沿安全评估并征求安全专家意见。因此,它将首先通过 Gemini API 向可信赖的测试者开放,收集反馈后再广泛发布。 迈向“世界模型”:通用 AI 助手与科学发现的加速器 演讲的后半部分,Demis Hassabis(德米斯·哈萨比斯)将视角从具体的模型提升到了 Google DeepMind 的终极愿景。他回顾了过去十年 Google 为现代 AI 时代奠定的基础,从发明 Transformer 架构,到 AlphaGo、AlphaZero 等智能体系统。现在,团队正致力于将 Gemini 从最好的多模态基础模型,扩展成为一个“世界模型”。 所谓“世界模型”,即能够像人脑一样,通过模拟世界的各个方面来进行规划、想象新体验的模型。哈萨比斯对此充满热情,这可以追溯到他早期开发《主题公园》等模拟游戏 AI 的经历。Google 在此方向上已迈出步伐:训练智能体掌握围棋和《星际争霸》等复杂游戏;2025 年 5 月发布的 Genie 2 模型,能够仅凭单张图片提示就生成可交互的 3D 模拟环境。这些能力已初露端倪,例如 Gemini 利用其世界知识和推理来表征自然界事物;而最先进的视频模型 Veo,则对重力、光线和材料行为等直观物理有着深刻理解,能在帧间保持惊人的准确性和一致性。 理解物理环境对于机器人技术也至关重要。AI 系统需要世界模型才能在现实世界中有效运作。Google 已微调出一个专业模型——Gemini Robotics,用于教导机器人掌握抓取、遵循指令、即时适应新任务等技能。哈萨比斯宣布,大会现场的参与者可以在“AI 沙盒”中亲自体验这些机器人。 将 Gemini 打造成一个完整的世界模型,是解锁一种新型 AI 的关键一步:一种能在日常生活中提供帮助、智能理解所处情境、并能代表用户在任何设备上规划和采取行动的 AI。这正是 Gemini 应用的终极愿景——将其转变为一个通用的 AI 助手,一个个性化、主动且强大的 AI,也是通往 AGI 道路上的关键里程碑。 这一旅程始于去年探索的 Project Astra 所展示的能力,如视频理解、屏幕共享和记忆。过去一年,这些能力已被整合到 Gemini Live 中,让更多用户体验。如今,Project Astra 的研究原型展示了更强大的未来图景:在一个演示视频中,AI 助手帮助用户维修自行车,它可以上网搜索用户手册、在 YouTube 上找维修视频、查阅电子邮件获取零件规格、甚至直接打电话给自行车店查询库存。整个过程,AI 能够理解屏幕内容、控制电脑应用、处理多线程任务,并拥有连续的对话记忆。 哈萨比斯描述,这样一个通用 AI 助手将为我们处理日常琐事,打理繁琐行政工作,推荐令人愉悦的新事物,从而提升我们的生产力,丰富我们的生活。Google 正在从可信测试者那里收集关于这些新能力的反馈,并致力于将它们引入 Gemini Live、搜索中的新体验、面向开发者的 Live API,以及 Android XR 眼镜等新形态设备中。 AI 赋能科学:从蛋白质结构到全球性疾病 作为一位科学家出身的 CEO,Demis Hassabis(德米斯·哈萨比斯)始终坚信,其职业生涯的核心在于利用 AI 推动知识进步和加速科学发现。他自豪地列举了 Google DeepMind 在过去一年在科学领域取得的一系列突破: 数学与发现:AlphaProof 能以银牌水平解决国际数学奥林匹克竞赛问题;Co-Scientist 能与研究人员协作,帮助提出和测试新假设;2025 年 5 月发布的 AlphaEvolve 甚至能发现新的科学知识并加速 AI 训练本身。 生命科学:研究系统 AMIE 可辅助临床医生进行医疗诊断;AlphaFold 3 能预测所有生命分子的结构和相互作用;基于 AlphaFold 工作的 Isomorphic Labs,正利用 AI 革命化药物发现过程,有朝一日将帮助解决许多全球性疾病。 哈萨比斯特别提到,AlphaFold 在短短几年内已对科学界产生巨大影响,成为生物学和医学研究的标准工具,全球超过 250 万研究人员在其关键工作中使用它。他坚定地表示,如果能够安全、负责任地发展,AGI 有潜力成为有史以来最有益的技术,极大地加速科学发现。 最后,演讲以一段感性的视频收尾,展示了 Google 如何与辅助视障人士的公司 Aira 合作,利用 Astra 技术构建原型,帮助视障音乐家更独立地探索世界(如识别环境、寻找物品)。这体现了 Google 将其尖端技术用于公益的承诺。哈萨比斯总结道,通过所有这些开创性工作,Google 正在构建更加个性化、主动和强大的 AI,以丰富人们的生活,推动科学进步的步伐,并引领一个充满发现与奇迹的新黄金时代。

