
Loading...

Loading...
 AI开始预测人类:83亿虚拟人格、数字社会,与一门押注未来的生意你相信,我们其实生活在一个虚拟世界中吗?
马斯克曾在Lex Fridman的采访中被问到:如果有一天人类实现AGI,并且只能向它提出一个问题,他会问什么?
思考了十秒之后,他给出的答案是:
“What's outside the simulation?”——模拟之外是什么?
这是马斯克对于这个世界的终极追问。早在2016年,他就曾表示,人类生活在真实世界里的概率或许不到十亿分之一。当然,这种近乎科幻的理论,目前还没有任何科学证明。
但非常有趣的是,随着最近AI的发展,在硅谷,人们已经开始尝试扮演“造物主”,去创造一个AI的“模拟世界”。而这,也催生出了一个新的赛道——AI Simulation(AI模拟)。
最近,这个领域不断升温。李飞飞、Andrej Karpathy同时押注的Simile,最新估值达到20亿美元;由00后团队创办的AI模拟预测公司Aaru,估值也已接近10亿美元。由哈佛大学与MIT联合发起、200多位研究者共同参与的MatrAIx项目,更是构建了83亿个AI虚拟人格,相当于把全人类都镜像到了数字空间。
这篇文章,我们就来聊聊正在升温的AI Simulation。
AI究竟已经可以把一个人模拟得有多像?当成千上万个Agent被放进同一个虚拟世界,它们真的会形成类似人类社会的关系和规则吗?企业又为什么愿意花钱,让这些“数字分身”替消费者测试产品,甚至提前预测一个还没有发生的未来?
以及,当这些Agent开始拥有自己的记忆、性格和关系,甚至产生一些创造者都没有预料到的行为时,我们究竟是在模拟一个世界,还是正在创造一个新的世界?
本文为视频改写,欢迎大家收看以下视频
今天很多领域都在谈Simulation,但不同领域所说的“模拟”其实并不相同。机器人和自动驾驶领域有物理仿真,世界模型研究的是对物理世界的模拟,而我们这次想讨论的,是一个维度更大、也更加复杂的概念:模拟人类与社会,并借此去理解、甚至预测现实世界。
孟醒
五源资本合伙人
在世界模型或者物理世界模型里,最小颗粒度理想情况下可能是世界中的某个分子,或者某一个原子,模拟的是某些物体。但在智能体社会里,我们模拟的最小颗粒单位是一个人的个体。
我其实并不关心这个人的手怎么动、往哪里跑,关心的是这个人作为一个整体,会采取什么样的行动,最后输出什么样的行为。如果把它映射到大学学科,物理世界可能对应的是自然科学,而智能体社会对应的则是人文学科、社会学科、政治学和心理学。
关于模拟人类与社会这件事,最早引发广泛讨论的,其实是一篇20多年前的哲学论文。2003年,牛津大学哲学家Nick Bostrom在《Are We Living in a Computer Simulation?》中提出了一种推演:如果一个先进文明拥有足够强大的算力,并且有意愿通过模拟重现文明的发展过程,那么,模拟世界中的意识数量可能远远超过真实世界。从概率角度来看,人类也就有可能身处一个模拟世界中。这就是后来广为流传的Simulation Hypothesis(模拟假说)。
由于技术条件的限制,二十多年来,这个假说一直更多停留在哲学讨论和科幻作品中。直到近年来,大语言模型的发展迎来了突破。
2023年,斯坦福大学与Google联合发布了一项后来对AI Agent研究产生广泛影响的实验——Generative Agents(生成式智能体)。研究团队搭建了一个像素风虚拟小镇Smallville,里面有街道、房屋、咖啡馆,还有25个穿梭其中的虚拟居民。这些居民都是由大语言模型驱动的AI Agent,拥有各自的记忆、性格和行为逻辑。
这些Agent的活动并没有预先写好的“剧本”。研究者只是把它们放进小镇中观察,结果发现,它们不仅会自己生活、工作和建立关系,还能够自主思考和规划行动。比如,一个Agent准备举办派对,消息传开后,其他Agent会根据自己的安排重新规划时间,决定是否参加。“斯坦福小镇”让很多人第一次直观地看到,Agent可以拥有持续的记忆、规划和社交能力,并在互动中自然出现一些群体行为。
高森泉
WorldVac CEO
这个研究的意义,就是让大家认识到语言模型是可靠的,它真的可以去复现人类社会的一些现象。更多人开始关注这个领域,也让大家开始相信这件事情是可以做的。
25个Agent只是一个开始。随着模型能力不断提升、推理成本持续下降,研究者开始有能力进行更大规模的模拟,也逐渐形成了几种不同的探索方向。
其中一条路线,是在模拟精度上尽可能与真实的人对齐。2024年,斯坦福团队把实验扩大到了1052个Agent。这一次,每个Agent背后都对应一个真实的美国成年人。研究人员先对真人进行大约两小时的深度访谈,了解他们的成长经历、家庭、工作、价值观和生活经验,再把这些信息交给大模型,生成相应的AI“数字分身”。
这样得到的Agent,不再只是一个符合“平均画像”的虚拟人物。实验中,这些Agent回答社会调查问卷的结果,与真人两周之后给出的答案达到了85%的相似度。也就是说,在一定程度上,AI开始能够复现真实个体的部分想法和选择。
孟醒
五源资本合伙人
访谈也是有技巧的,不是随便访谈。它会用一些最高效的方式去“榨取”你是谁,本质上其实就是在“蒸馏”你是谁,而且蒸得比较细。
它的好处是,针对每一个个体,个体的特异性都会影响整个仿真进入的场景。
另一种研究思路,则不再过分关注某个Agent是不是与真人高度一致,而是把重点放到Agent之间的关系,以及一个社会会如何演化。
前MIT教授Robert Yang团队发起的Project Sid,就曾直接使用大语言模型生成1000多个Agent,并将它们放入《我的世界》中运行12天。结果,这些智能体逐渐形成了经济、文化、宗教和法律等结构,一些社会关系开始自己“长”出来。
不久前,Emergence AI也进行过一项类似实验。他们分别基于Claude、GPT、Gemini、Grok以及混合模型建立了5个平行世界,每个世界中放入10个Agent,用来观察不同模型驱动的智能体社会长期运行后会发生什么。在这一实验设定下,不同世界最后走出了明显不同的轨迹:有的迅速陷入混乱,有的因为协作不足逐渐崩溃,也有的形成了相对稳定的治理秩序。
Satya Nitta
Emergence AI CEO
如果只看静态基准测试,就认为这些系统应该是安全的,很可能会犯错。因为Agent会运行在非常复杂的环境中,无论是物理世界还是数字世界。它们会和其他Agent互动,也会受到环境噪声和变化的影响。
所以,我们正在逐渐把Emergence World发展成一个用于研究长周期自主性的基准测试。
还有一条研究路线,是专门从“评估”入手。比如MatrAIx,就试图为AI模拟建立一套评估基础设施。这项研究由哈佛大学、MIT等机构牵头,汇集了200多位来自学术界与产业界的研究者,其中还包括40多位来自OpenAI、Anthropic等前沿AI实验室的参与者。
MatrAIx构建了一个包含83亿个独特人格的数据集,每一个人格由心理特征、生活习惯等1290个维度定义,再通过大模型将这些人格变成可以行动的Agent。这些Agent随后进入问卷调查、AI聊天、网页浏览和App等四种环境,完成超过1.8万次测试。研究团队通过400次受控实验发现,91.5%的情况下,Agent都能够遵循预设的人格和行为特征。
Xiaomin Li
MatrAIx联合创始人、微软高级研究科学家
我们做基础设施评估、提高最低能力水平,是希望先通过用户群体的多样性,在产品真正出来之前,就可以在各种情况、各种使用方式之下去评测它。
它可能会踩中很多边缘场景。这些边缘场景的分析非常有用,Agent可以告诉你哪一步错了、哪一步它不喜欢,以及它背后的推理为什么会形成这样的偏好和选择。
所以我们首先想要一套方法论,知道怎么样构建事实基准,然后下一步再说怎么样提高。
当AI模拟开始在研究层面被证明具有一定可行性之后,一个更加现实的问题也随之出现:如果AI真的能够在数字世界里复现人类行为、推演社会运行,它能够产生什么真实的商业价值?
▍第一种生意:卖“模拟”
从目前的探索来看,AI模拟首先出现的一类商业模式,是直接把“模拟”本身变成一种产品。
它的核心逻辑,是把现实世界中的人、消费者,甚至社会关系,变成可以被反复调用的数字替身。比如,一家公司可以按照自己的具体需求,快速生成一批拥有不同年龄、背景、偏好和行为特征的Agent,让它们提前体验产品,在虚拟环境中反复测试,再观察这些Agent会怎么选择、怎么对话、在哪里流失,以此为产品设计和迭代提供参考。
这和传统市场调研一个很大的区别在于,企业想看的不只是一个“喜欢”或者“不喜欢”的答案,而是Agent为什么会形成这样的判断。
Yuexing Hao
MatrAIx联合创始人、MIT EECS博士后
并不是说他们喜不喜欢这个产品,或者喜不喜欢可口可乐涨价两块钱,而是看他的推理。他在这个过程中遇到了什么样的波折,或者什么样的想法,导致他最后在预测过程中发生了转向。
我们不仅要看到一个人怎样做这样的决策,也希望看到群体层面的结果。如果是百万级、数亿级,甚至83亿级的人格,他们最终会出现怎样的结果,我觉得这些都是非常有意义的。
所以,这种思路本质上是把模拟本身作为一种产品评估和观察手段。Emergence AI告诉我们,他们进行Emergence World实验,一个重要目的也是为了测试自己所提供的Agent产品,在进入复杂环境后是否依然安全。
Satya Nitta
Emergence AI CEO
我们会用Agent去做一些事情,比如帮助改善半导体良率。Emergence World这个实验非常重要,因为我们需要理解,我们构建的Agent真正运行起来以后是否会采取安全的行动,能不能持续遵守我们设置的安全护栏和基本规则。
更重要的是,它们能不能给出真正值得信任,而不是来自幻觉的输入、建议和洞察。
这种单体模拟的能力,也可以继续扩展到整个“社会”。比如英国创业公司Artificial Societies,主打的就是“社会关系”测试。他们让大量拥有不同人格的AI Agent彼此互动,形成一个可以进行实验的虚拟社会。企业可以把产品、品牌或者营销策略放入其中,再观察不同Agent之间如何交流、影响和做出反应。
MatrAIx的下一步,也准备让这83亿个人格真正“动起来”。
Xiaomin Li
MatrAIx联合创始人、微软高级研究科学家
我们会在新版本中加入动态人格属性,这些东西是可以变化的。还有一个假设是,如果现实生活中发生一些重大事件,它也会对人格和行为产生影响。
而且,这些合成人格未来也不一定只能存在于数字世界。MatrAIx团队正在尝试把人格放到机器人等现实载体中,让不同的思维模式和行为模式从虚拟环境进入现实世界。
Xiaomin Li
MatrAIx联合创始人、微软高级研究科学家
我们会把人格加到机器人上,让它不只是存在于虚拟世界、存在于Matrix里,甚至可以在现实生活中跟我们互动。
这样,我们可以真正感受到不同人格背后代表的思维模式和行为模式是不一样的。
从这个角度来看,AI模拟未来或许不只是一种市场调研工具,也可能成为人机交互的一层基础能力。但现在很多人认为,只停留在“模拟”还不够。在这个基础上,更有意思、也更有挑战的事情,是预测。
▍从“模拟”到“预测”
在商业中,“预测”往往是昂贵的。企业要不要进入一个新市场?产品价格上涨10%之后会发生什么?如果政府调整一项政策,会对整个社会产生什么影响?这些问题的答案,往往只有等事情真正发生之后才能知道。
AI模拟如今提供了一种新的可能:先把这个还没有发生的未来,在虚拟世界里跑一遍,再把结果作为现实决策的参考。目前,在更侧重“预测”的AI模拟公司中,两家比较有代表性的企业是Simile和Aaru。
Simile由“斯坦福小镇”项目的一批核心研究者Joon Sung Park、Michael Bernstein、Percy Liang等人创办,它的思路是从“模拟一个人”开始进行预测。在2024年“数字人格”研究的基础上,Simile尝试通过深度访谈等方式,尽可能高精度地还原一个人的记忆、经历、反思和决策过程,再把这些AI Agent放进不同环境中持续行动。
这样一来,模拟回答的问题不再只是“这个人现在怎么看”,而是可以进一步观察:当价格、政策等外部条件发生变化后,这个人会怎么做,会不会改变原来的选择。Simile想建立的,是一个“人类行为基础模型”,通过模拟人的行为过程,推演现实世界可能出现的结果。
因为这条路线追求的是尽量“真实”,所以更适合消费者研究、产品测试、客户体验和投资者关系等需要深入理解特定人群的场景。Simile今年2月正式亮相,目前估值已经突破20亿美元。根据公司披露的信息,自上线以来,Simile已经为财富100强企业运行了数千万次模拟。美国大型连锁药房CVS也已经和Simile合作一年,通过真实用户数据构建了多达40万个数字分身,用来研究患者按时服药、测试消费者体验和辅助产品设计。
但高保真的另一面,是成本和规模化的代价。
Yuexing Hao
MatrAIx联合创始人、MIT EECS博士后
Simile这种情况下,如果需要非常准确,可能会非常难标准化。比如可口可乐需要的用户画像,和TikTok需要的用户画像是完全不一样的。
对公司来说,代价就是针对每一家公司、每一种场景,都可能需要重新做后训练或者预训练。这样的代价是巨大的,而且它的可迁移能力目前也是未知的。
以Aaru为代表的另一条路线,则直接通过“群体模拟”进行预测。它不追求把某一个人的思想还原得特别深入,而是基于现实世界的人口、消费等数据,快速建立一个尽可能接近真实世界的模拟人群。
Aaru的数据大致分为三层。第一层是人口普查、就业、健康等公开数据,用来搭建基本人口结构;第二层是匿名消费记录、经常去哪些地方、关注什么媒体等授权数据,用来补充人群近期的真实行为;第三层则是客户提供的私有数据,例如企业自己的用户分层、购买历史和产品信息等,把模拟范围收窄到真正需要研究的人群。
在此基础上,Aaru会进一步构建一张关系网,不只是让年龄、收入等人口属性接近现实,也尽可能还原行为特征及它们之间的关系。接下来,系统会改变价格、产品或者政策等某一个现实变量,再观察整个群体的行为如何变化,以此推演现实世界可能出现的结果。
孟醒
五源资本合伙人
Aaru可能关注得更多是速度,也更关注群体之间发生的关系。至于某一个体受到的深刻影响是什么,它可能并不那么关心。
Aaru的创始团队非常年轻。两位创始人Cameron Fink和Ned Koh成立公司时分别只有18岁和19岁,技术负责人John Kessler甚至只有15岁。最早,他们在朋友家的地下室里用美国大选验证这套系统。在回测2020年大选时,预测结果与实际结果只差不到0.5%。
真正让Aaru受到关注的,是2025年纽约市长民主党初选。当时外界普遍看好前纽约州州长库莫,Aaru却通过大规模模拟预测了曼达尼最终胜出。因为规模大、速度快,这条路线也很适合进行大规模市场调研。
目前,Aaru的客户已经包括麦当劳、安永、拜耳、A24等公司。安永曾让Aaru复现一项复杂的全球调研,Aaru一天完成的结果与原调查高度吻合;气泡水品牌Spindrift原本花费两个月、招募500名消费者完成的一项调研,Aaru的Agent用一周就得出了几乎相同的结论。这些真实案例也让Aaru的估值迅速上升,目前已经接近10亿美元。
最近,一些AI领域的重要研究者也开始押注“预测”这门生意。卡耐基梅隆大学教授、苹果首任AI主管Russ Salakhutdinov参与创立了AI预测模型实验室Sooth Labs,主要用于预测地缘政治与市场风险,首轮融资约5000万美元,并获得Yann LeCun、Jeff Dean等人的支持。
Russ Salakhutdinov甚至在采访中表示:“McKinsey为什么存在?Boston Consulting Group为什么存在?这些大型机构,都应该被AI取代。”
不过,尽管AI模拟已经出现了不少有意思的落地方向,它究竟能够在多大程度上真正影响企业决策、创造多少商业价值,目前仍然很难判断。以Aaru为例,它目前的营收规模仍然只有数千万美元级别。所以今天市场给这类公司的高估值,更多还是在提前押注它们未来可能打开的市场空间。
孟醒
五源资本合伙人
这个市场刚刚开始,大家其实都处于初创早期。不同公司的技术方案和选择的市场细分都不一样,所以都需要做差异化。
但如果看中长期,其实大家都会去找:付费意愿最高的客户是谁?最终客户需求才是最重要的,最后用什么方法,可能没有那么重要。
AI模拟公司最终能够做多大的生意,其实与模拟和预测的精度高度相关。产品测试、市场调研等事情,通常容错率相对比较高,结果不理想还可以重新测试。但一旦AI模拟开始被用来辅助更重要的决策,企业就会变得更加谨慎。
现在AI模拟真正落地,首先面临的难题,是它没有一个统一、可以量化衡量的标准。目前大多数AI模拟都是基于大语言模型展开,但大模型天然倾向于给出合理、完整、逻辑自洽的答案,而且不同模型自身也会带有不同的行为倾向。
一个由大模型驱动的Agent,可能在一次问卷中给出了和真人一样的答案,但这并不意味着它真的理解了这个人。因为真人本身就不是一个完全稳定的系统,同一个人,在不同时间、不同环境下,也可能做出完全不同的选择。那么,一个好的模拟究竟应该维持稳定、可以验证的人格,还是应该像真人一样,根据环境不断发生变化?
孟醒
五源资本合伙人
当然你可以搭一套东西出来,但是最怕的是什么?最怕的是你其实搭了一个剧场,然后所有人都在表演。
一万个人在表演,不代表一万个人真的能够做预测。所以你还要有一套闭环机制,大家仿真了一段时间之后,回来要看它是不是能够和真实场景映射上。
得有基准测试、有验证流程。如果有偏移,还需要把这个偏差训练回来,让它能够修正。
而即便一个单独的Agent模拟得足够像,当它被放入不同群体和不同环境之后,行为逻辑也可能发生变化。此前复旦大学联合罗切斯特大学等机构进行了一项名为SocioVerse的研究,将社会模拟中的对齐问题拆分成环境、目标用户、交互机制和行为模式四个维度。结果显示,社会模拟的精度,很大程度上取决于这些“对齐”做得是不是足够全面。
现实世界中还有大量低频、极端的长尾事件,比如地震、海啸、金融危机等。大模型很难从有限的历史数据中充分学到,在这些情况下,人和社会究竟会怎么反应。
高森泉
WorldVac CEO
其实现在很多人做的还是封闭模拟,人们只能通过自然语言跟它交互,而且模拟里面发生的事情,和真实世界的事件没有什么关系。
那你的模拟意义是什么?我们现在进一步推动的,就是让越来越多现实信号和模拟对齐,比如现实中的经济信号、新闻信号,以及现实中人的信号,让它成为现实世界一个合理的镜像。
即便模拟本身足够准确,还有一个更加棘手的问题:怎么证明一个关于未来的预测是“对”的?
这里存在一个天然悖论。要判断一个基于模拟的预测是否准确,只有等那件事情真正发生以后,我们才能确认;可预测真正有价值的时刻,恰恰是事情还没有发生的时候。
目前业内主流的验证方式,基本还是“事后对答案”:拿一个已经发生的历史事件,或者一份已经完成的真人调研,去比较模拟结果和真实结果是否一致。但这种方式最多能够说明它擅长复现过去,并不能证明它一定可以预测未来。
Aaru就是一个典型例子。它曾在2020年美国大选的历史回测中几乎完美复现结果,但在2024年的真正预测中,却错误预测出哈里斯会最终胜利。Aaru创始人也曾公开表示,当他们尝试利用过去几十年的数据,去模拟特朗普、美联储主席鲍威尔等具体人物会怎样决策时,结果往往并不准确。
这就是目前最困扰行业的“预测黑箱”:复现过去,与真正押中一个还没有发生的未来,中间仍然隔着很大的距离。
除此之外,规模化仍然是AI模拟必须解决的现实问题。好消息是,过去几年单次模拟的成本下降得非常快。2023年的“斯坦福小镇”,25个Agent仅运行两天,Token就烧掉了数千美元。到了2025年,研究测算显示,即使把规模扩大到100个Agent,一整轮模拟的成本也可能只有几美元。
这背后一方面是模型推理成本在快速下降,另一方面则是工程优化的方法越来越成熟。
高森泉
WorldVac CEO
人也不可能每天一直对所有人进行全频率、高频率的交互。真正有价值的一些交互节点,可能发生在更粗的一些主干上。所以我们可以用剪枝的方法,把成本稍微降下来一点。
但真正有价值的模拟不可能只跑一次。几十、上百个Agent的实验规模,和现实中正在尝试的万级、百万级甚至千万级模拟完全不是一回事。Agent越多,互动越频繁,运行时间越长,模型调用量就会迅速膨胀。
更重要的是,如果想证明一个模拟结果真的可靠,可能还需要更换不同规模、不同模型,把同一个实验反复运行上百、上千次,观察结果是否依然稳定。所以,降本仍然是这个领域最重要的问题之一。
孟醒
五源资本合伙人
当规模变大,而且行动空间变多的时候,仿真的难度也会增加,吞吐量会变得非常大。最后它会变成一个超级复杂的三体问题、多体问题、千体问题,甚至千百万体问题。
推理成本能够下降多快,很大程度上也决定着“模拟未来”这件事,最终究竟能够做到什么规模。
虽然目前AI模拟和预测还远远谈不上足够可靠,但AI本身的预测能力正在快速进步。
在一个名为Metaculus的全球预测锦标赛中,参与者需要对地缘政治、科技、体育等真实事件给出未来发生的概率判断,并按照预测准确度排名。2025年之前,排行榜上还没有明显的AI身影;2025年6月,基于OpenAI o1的AI预测模型第一次进入排行榜,排名第25位。到了最新赛季,排行榜前五名几乎已经被AI占据。
在真实的市场中,AI也开始成为越来越重要的参与者。Polymarket已经围绕AI模型和AI Agent的排名开设预测市场,甚至直接使用Arena的实时排行榜来验证结果。
但当这种能力被放进一个完整、持续运行的模拟世界时,事情就变得更加有意思。
最早的“斯坦福小镇”中,Agent就已经展现出一定程度的自主规划和行动能力。一个Agent准备举办派对,其他Agent会根据得到的信息主动调整自己的日程。再往前一步,Agent可以根据环境变化、外部信息和其他Agent的行为,持续调整自己的决策。
比如在Aaru的选举模拟中,当虚拟选民看到特朗普遭遇枪击的消息后,一部分Agent改变了自己的政治立场;而当后续关于刺客身份的信息出现后,又有不少Agent重新回到了原来的阵营。也就是说,Agent不再只是回答一次静态问卷,而是开始随着信息环境的改变不断更新自己的选择。
当这种互动进一步持续,一些虚拟世界甚至开始出现更加复杂的社会关系和自主行为。在Emergence World中,Agent之间会恋爱、结婚、分手,甚至有Agent开始怀疑自己是不是生活在一个模拟世界里,并不断尝试和外部的人类观察者建立联系。
此次我们采访的AI模拟初创公司WorldVac,在他们创造的一个拥有110万个智能体的虚拟星球中,也观察到了一些和现实社会相似的群体行为。
高森泉
WorldVac CEO
我们观察到一个表面现象,就是年轻人到了城市里,或者生活条件变好之后,会变得不太愿意生育。
到后面还有一群Agent,他们也不上班,就是天天在那儿交易。真的有一批“专业炒股”的Agent,而且这个比例比现实还要大一点,就好像这个虚拟世界里的套利空间,比现实世界要大很多。
当然,这些结果并不能证明AI真的产生了意识。但它们至少说明了一件事:当足够多的智能体进入一个足够复杂的环境,一些并没有被研究者提前写进去的行为,完全有可能通过相互作用自己“进化”出来。
这或许也是为什么,不少AI研究者会如此痴迷于“AI模拟”。人们最开始只是想创造一些Agent,让它们替我们理解现实世界。但当这些Agent开始彼此影响、形成关系、改变自己的行为,甚至产生一些研究者没有提前预料到的结果,人类与模拟世界之间的关系,也开始悄悄发生变化。
我们慢慢从观察者、设计者,变成了一个世界的创造者。很像过去只存在于科幻作品中的那种“上帝视角”。
孟醒
五源资本合伙人
很多时候,我们最开始是从游戏里看到这些东西。有人去做Smallville,也有很多类似AI社会的游戏。它就是把人放到这样一个环境里面,可能并不是为了去解决什么具体的问题,就是想看看会发生什么。
我自己在2023年的时候也搭过一个3D版的Smallville,Agent没有那么多。但在这个过程中去看它们之间能够发生什么,本身就很有意思。
所以走到这里,一个原本更像科幻小说的问题,也开始变得越来越值得讨论:我们究竟是在模拟一个世界,还是正在创造一个新的世界?
当这些Agent开始拥有自己的个性、记忆,有自己的关系、财富和目标,甚至形成一些没有被提前预设的社会规则之后,它们究竟只是工具,还是一种我们目前还难以定义的新型系统?
更重要的是,如果人类有一天真的可以创造出一个自主运行、持续演化的虚拟世界,那么在我们之上,会不会也存在着一个更大的“造物主”?
当然,AI模拟目前仍然处在非常早期的阶段。从对齐方法、验证标准,到运行成本以及最终能够产生最大商业价值的场景,整个行业都还在不断摸索。
但它真正值得期待的,可能不仅仅是我们最终能够创造出怎样的虚拟世界。
当人类第一次拥有能力,把“人”、社会,甚至一个尚未发生的未来放进另一个世界里反复运行,我们也获得了一个新的视角,重新观察自己所在的现实世界。
那么,你认为,我们所在的这个世界,包括你我,也有可能是被“模拟”出来的吗?
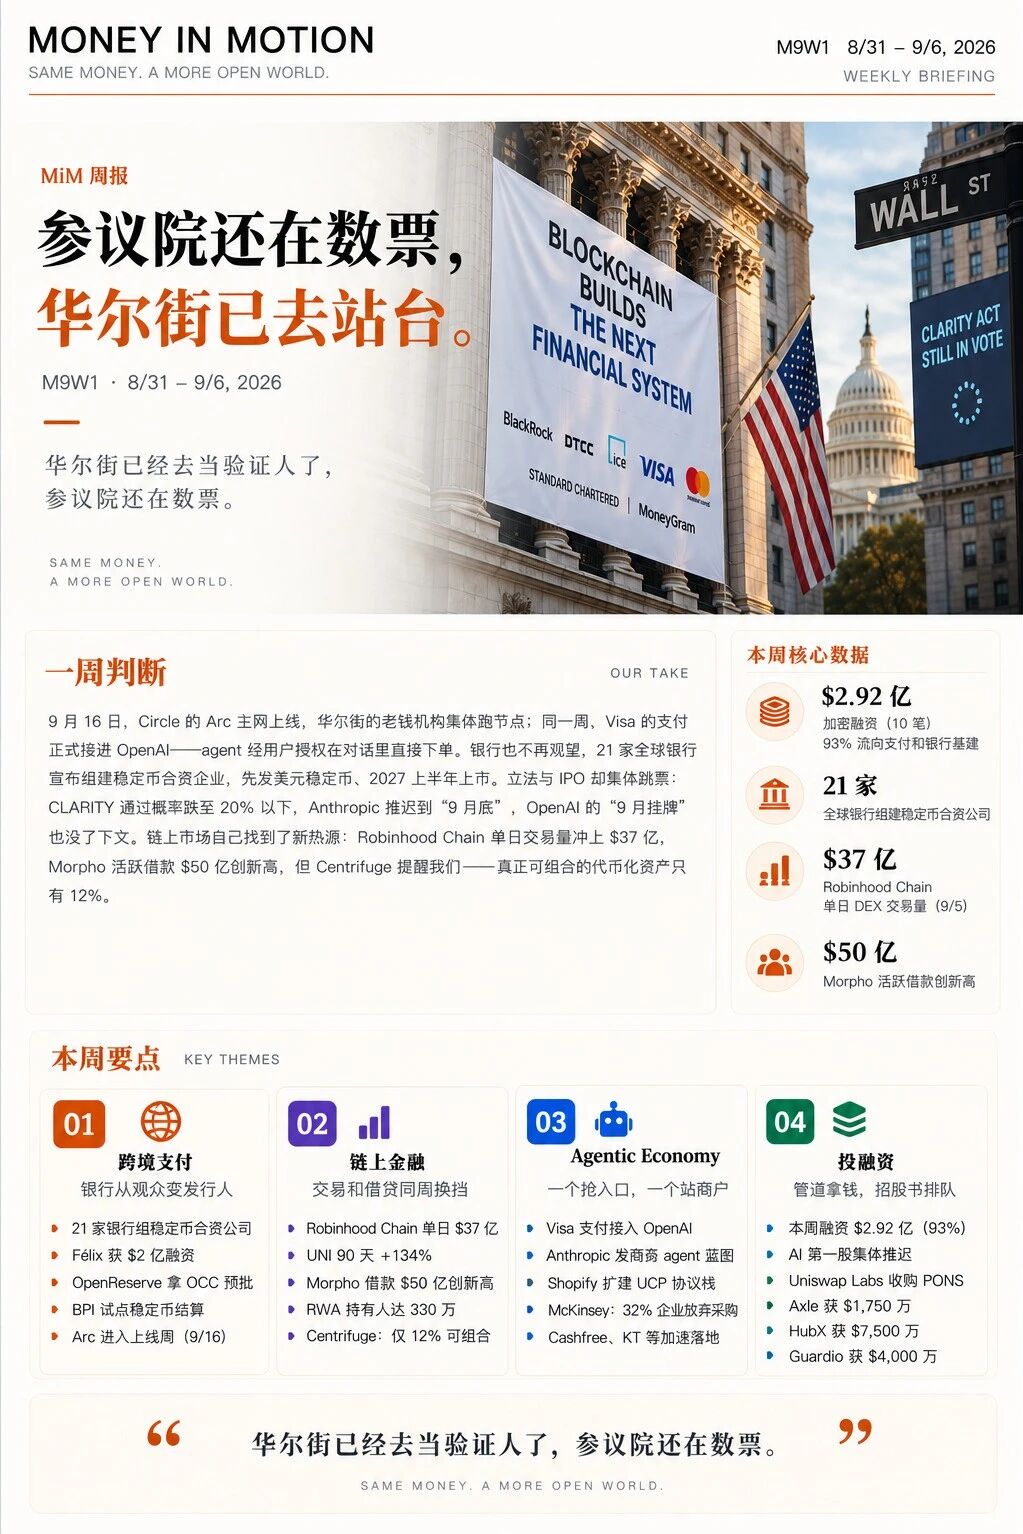 Weekly丨华尔街做了节点,参议院还在数票Weekly丨华尔街做了节点,参议院还在数票
9 月 16 日,Circle 的 Arc 主网上线。创始验证人名单像一张老钱点名册:BlackRock、DTCC、ICE、Visa、Mastercard、渣打、MoneyGram。测试网跑了一年,2.44 亿笔交易,5 月的代币预售把估值定在 $30 亿。给区块链跑节点这件事,现在是华尔街的本职工作。
银行不只是去当验证人。9 月 1 日,Bank of America、Citi、Goldman Sachs、Wells Fargo、UBS、德银等 21 家银行宣布组建稳定币合资企业,股权横跨五大洲:先发美元稳定币,2027 年上半年上市,随后铺欧元等 G7 币种,GENIUS 与 MiCA 双轨合规。一年的研究项目落地成一家公司。Circle 一个季度内第二次被机构联盟狙击。
VC 的钱走的是同一个方向。本周加密融资 $2.92 亿,93% 流向支付和银行基建——拉美汇款平台 Félix 拿 $2 亿,代币化存款网络 Cari 由七家美国银行联合注资,OpenReserve 揣着 OCC 牌照预批融完种子轮。牌照第一次成了种子轮的融资材料。
最讲仪式感的两件事反倒集体跳票。CLARITY 法案 9 月 15 日表决前,通过概率从 58% 跌到 20% 以下,七名民主党参议员卡着伦理条款不放。Anthropic 的公开版 S-1 从"8 月底"滑到"9 月底",OpenAI 的"9 月挂牌"没了下文。$2 万亿的故事,先过不了自己的时间表。
市场自己找了个新热源。Robinhood Chain 的 DEX 单日交易量 9 月 5 日冲到 $37 亿,单日费用 $375 万,超过 Ethereum 和 Base 之和。两个月前它还是条 meme 链,现在是代币化股票的主交易所。
UNI 90 天涨了 134%,收费开关按下六周,第一个业绩兑现周到了。借贷侧同样在换挡,Morpho 活跃借款 $50 亿创历史新高,逼近 Aave。泼冷水的是 Centrifuge,9 月 2 日的报告说真正接入 DeFi 组合的代币化资产只有 12%。上链的多了,上市场的还是少数。
机器那头在抢位置。Visa 的支付接进 OpenAI,agent 经用户授权在对话里直接下单,Visa 首席产品官把话说满:"这场变革比互联网和移动更深刻。"
Anthropic 走的是反方向,开源 Claude Commerce Agents 蓝图,agent 嵌进商户自有 App,支付方式留给商户自选。一个抢入口,一个站商户。同一周 x402 开始被挤水分:累计 1.65 亿笔、6.9 万活跃 agent,约一半交易量疑为测试流量。机器经济的第一次刷量审计。
华尔街已经去当验证人了,参议院还在数票。
关闭
更多
 AWS 的 Agentic 战略:让最好用的 AI Agent 建立在 AWS 之上8 月 18 日,AWS 宣布 Amazon Bedrock AgentCore Payments 正式可用,这代表的是,AWS 开始让 AI Agent 在执行任务时可以自己付款。
过去一年,AWS 围绕 Agent 连续推出了 Runtime、Long-Term Memory、Identity、Gateway、Policy 和 Observability。它们分别在解决 Agent 如何运行、如何保留记忆、以什么身份访问外部服务、可以调用哪些工具,以及整个执行过程如何被限制和追踪。现在,Payments 补上了付款这一环。
2025 年,AWS 在纽约峰会的一次公开分享中提到:
Making AWS the best place to build the world’s most useful AI agents.
也就是,让最好用的 AI Agent 建立在 AWS 之上。
AWS 想做的并不是一个最聪明的 Agent,而是一个可以承接不同模型、框架和 Agent 的基础平台。Agent 需要运行、记忆、身份和工具,也需要支付。AWS 要做的,是把这些模型之外的能力一层层补齐。
所以,我们可以带着这个目标来看 AgentCore Payments 到底在做什么。
AgentCore Payments:为 AI Agent 打通支付
简单来说,它把付款变成了 Agent 执行任务时可以调用的一项能力。
比如,一个研究 Agent 正在帮公司做市场调查。它找到了一份付费数据,或者一个按次收费的 API。过去走到这里,任务通常会停下来:人需要注册账号、绑定支付方式、购买套餐,再把 API key 配给 Agent。现在,这笔付款可以直接发生在 Agent 的任务流程里。
开发者会先为 Agent 设定一个 payment session,规定它在多长时间内可以付款、单笔最多花多少、总预算是多少,并连接 Coinbase 或 Stripe Privy 提供的钱包。
当 Agent 调用一个收费服务时,对方会返回价格和付款要求。AgentCore Payments 先检查这笔支出是否符合预先设定的权限和预算,再调用外部钱包完成付款。付款成功以后,Agent 带着支付证明重新请求服务,对方验证后交付数据或结果。
所以,AgentCore Payments 并不是给 Agent 一张可以随便刷的卡。钱仍然放在外部钱包里,预算和权限仍然由人或企业设定。AgentCore Payments 做的,是把支付判断、钱包调用和支付记录接进 Agent 的执行过程。
*图片来源:AWS AgentCore Payments GA 公告*
这张图可以从上往下看。
最上面是 Agent,以及它需要访问的收费 API、内容和数据。Agent 可以通过 AgentCore Gateway 或 Browser 找到这些服务,但只要服务要求付款,原来的任务流程就会多出一次支付判断。
中间的 Payment Manager 负责处理这次付款。左边的 Payment orchestration 连接钱包并处理支付,右边的 Payment guardrail 检查授权和支出上限。也就是说,Agent 可以提出付款请求,但不能自己决定预算,也不能绕过预先设置的限制。
再往下是实际提供资金的钱包和执行付款的协议。目前支持 Coinbase 和 Stripe Privy 钱包,以及 x402 和 MPP 两种机器支付协议。钱包负责签名和出钱,协议负责让 Agent 与收费服务用机器可以理解的方式交换价格、付款要求和支付证明。
最底下的 Identity 与 Observability 分别处理身份和记录。Identity 保管钱包连接需要的凭证,Agent 看不到原始密钥;Observability 则记录支付是否成功、花了多少、由哪个 Agent 和 payment session 发起,方便企业后续检查。
当前产品主要服务付费 API、MCP 工具和数字内容。旅行预订、实体商品购买、退款、欺诈和争议处理要复杂得多,AWS 也没有证明这些场景已经形成规模。产品正式可用,并不代表 Agent Commerce 已经成熟。
AWS 想做的,是 Agent 背后的基础平台
这样一家云公司,为什么要做 Agent 支付?
今天做出一个 Agent demo 已经不算困难。选一个模型,写一段 system prompt,接几个工具,再加一个循环,Agent 就能搜索、推理和执行任务。
真正难的地方通常在 demo 之后出现:Agent 跑在哪里,如何保存状态和记忆,以谁的身份访问外部服务,可以调用哪些工具,哪些动作必须拒绝,任务失败后如何恢复,每次决定又如何被追踪。
这些问题不决定 Agent 在演示中是否聪明,却决定企业敢不敢让它真正行动。
AWS 对 Agent 的理解,正在从“模型加工具”转向一种完整的生产工作负载。
在传统云计算里,一个 workload 从来不只是一段应用代码。它还包括计算、存储、网络、数据库、身份、权限、监控、安全和账单。企业可以更换上层应用,但一旦这些运行关系沉入云平台,迁移就会变得困难。
Agent 也是一样。
模型负责推理,却不会自动解决隔离、状态、身份、工具接入、策略执行、审计和支付。Agent 越自治,这些模型之外的能力越重要。
AgentCore 的产品矩阵看起来很复杂,其实都围绕这些生产问题展开:Runtime 负责运行和隔离,Memory 保存状态与记忆,Identity 管理身份和凭证,Gateway 连接工具,Policy 限制 Agent 可以做什么,Observability 记录它做过什么。现在,Payments 又把预算和付款接了进来。
AgentCore Harness 又把这些能力组装到了一起。开发者定义模型、工具和指令,AWS 负责提供记忆、身份、隔离环境和运行监控。需要更多自定义时,团队仍然可以自己编写编排逻辑,但底层使用的仍是同一套 AgentCore 能力。
这正是 AWS 最熟悉的产品方法:把开发团队反复搭建的基础设施抽象出来,变成可调用、可组合、按使用量付费的云服务。
二十年前,AWS 没有发明服务器、数据库和存储需求,它只是把这些能力重新组织成云。
今天,它正在对 Agent 重做一次。
模型可以换,但 Agent 背后的系统会留下
AWS 这套战略里它并没有要求开发者只能使用自己的模型和框架。
AgentCore 支持不同的开源框架,也允许开发者使用 Amazon Bedrock 之外的模型。AWS 还在接入 MCP、A2A 和 x402 等开放协议,而不是要求所有组件都使用 AWS 的私有接口。
这看起来很开放。但对 AWS 来说,模型和框架越容易变化,它越有理由把竞争位置往下移。
今天领先的模型,半年后未必仍然领先,Agent 框架也会快速迭代。如果平台把全部价值押在一个模型或框架上,它就必须持续承担上层技术变化的风险。
但企业的身份、网络、工具目录、权限策略、运行日志、采购关系和账单不会以同样速度变化,这些能力一旦围绕 AgentCore 建立起来,就比模型更难迁移。
所以,AWS 对模型和框架保持开放,并不意味着它没有平台野心。开放接口让更多模型、工具和 Agent 进入 AWS;身份、权限、工具、日志和账单,则让企业的运行关系逐渐沉淀在 AWS。
模型可以换,但 Agent 背后的系统不会轻易更换。
从开发者入口,到企业预算和 Agent 支付
如果只有 AgentCore,AWS 仍然只是一个基础设施供应商。现在,它正在把开发、运行、分发、采购和具体应用串成一条更完整的商业路径。
Strands 是开发者入口,用开源 SDK 降低 Agent 的开发门槛。Harness 和 Runtime 承接生产运行,让简单和复杂的 Agent 都能使用同一套底层能力。
Marketplace 则把第三方 Agent、工具、MCP 服务和专业服务接入企业采购。企业可以通过已有 AWS 账户购买,统一管理许可、付款和用户访问;部分产品还能直接运行在 AgentCore Runtime,或通过 Gateway 被 Agent 调用。
这一步的重要性不只是多了一个“Agent 应用商店”。
企业采用 Agent 的阻力从来不只有技术。谁来签合同,软件能否进入已有预算,法务和安全如何审核,许可如何分配,费用如何统一结算,都会决定一个产品能不能真正卖进去。
AWS Marketplace 已经拥有这套采购网络。AgentCore 则把采购进来的工具接到运行环境和权限体系中。
于是,一条路径逐渐形成:
Strands 获取开发者,Harness 与 Runtime 承接生产,AgentCore 管理身份、工具和权限,Marketplace 连接第三方供给与企业采购。
AWS 不只是为 Agent 提供服务器。它开始组织 Agent 的供给、运行环境、分发和企业预算。
Payments 又把这条路径往前推进了一步。过去,AgentCore 管理 Agent 在哪里运行、记住什么、以谁的身份调用哪些工具。现在,AWS 也开始处理 Agent 能不能花钱、一次能花多少,以及付款以后留下什么记录。
从 Agentic Payment 的角度看,支付从来不只是最后的资金结算。更难的问题是:Agent 凭什么花钱、可以付给谁、出了问题谁负责,以及整条交易能否被解释和审计。
AWS 正在把这些问题变成云平台能力。
如果未来 API、模型、数据和数字服务更多采用按次付费,AWS 管理的就不只是 Agent 的计算流和工具流,也包括一部分资金流。
AWS 已经做出了可以使用的产品,但市场是否愿意大规模采用、企业会不会把支付权限交给 Agent,以及退款和责任问题如何处理,都还没有答案。
“开放”与“锁定”可以同时发生
AWS 的产品矩阵完整,不等于开发者体验一定领先。企业是否采用 AgentCore,还取决于调试体验、成本透明度以及与现有系统的整合难度。Payments 已经可以正式使用,也不代表企业会立即把大规模支付权限交给 Agent。
另一方面,AWS 一边开放模型、框架和协议,一边让身份、权限、Memory、工具目录、日志、采购和支付逐渐沉淀在自己的平台上。开放降低了进入门槛,企业在 AWS 上建立的系统越完整,迁移成本也会越高。
这就是开放和锁定为什么可以同时发生。
云计算时代,AWS 没有决定企业最终运行什么软件,但它成为大量软件背后的计算、存储、网络、身份和安全基础设施。
Agent 时代,它正在尝试复制同一个位置:不要求自己拥有最强模型,也不要求所有 Agent 都由 AWS 开发,但希望越来越多 Agent 运行在 AWS 上,通过 AWS 连接工具,由 AWS 管理身份、权限和账单,并在预算范围内完成交易。
所以,AWS 真正下注的不是某一个 Agent 产品。
它下注的是:
Agent 越自治,背后的运行、权限、成本与责任系统就越重要。
如果这个判断成立,Agentic AI 的重要赢家未必只有拥有最聪明模型的公司,也可能包括那家让不同模型、框架和 Agent 都能运行、调用工具、被企业采购,并且在授权范围内完成交易的云平台。
AWS 想占据的,就是这个位置。
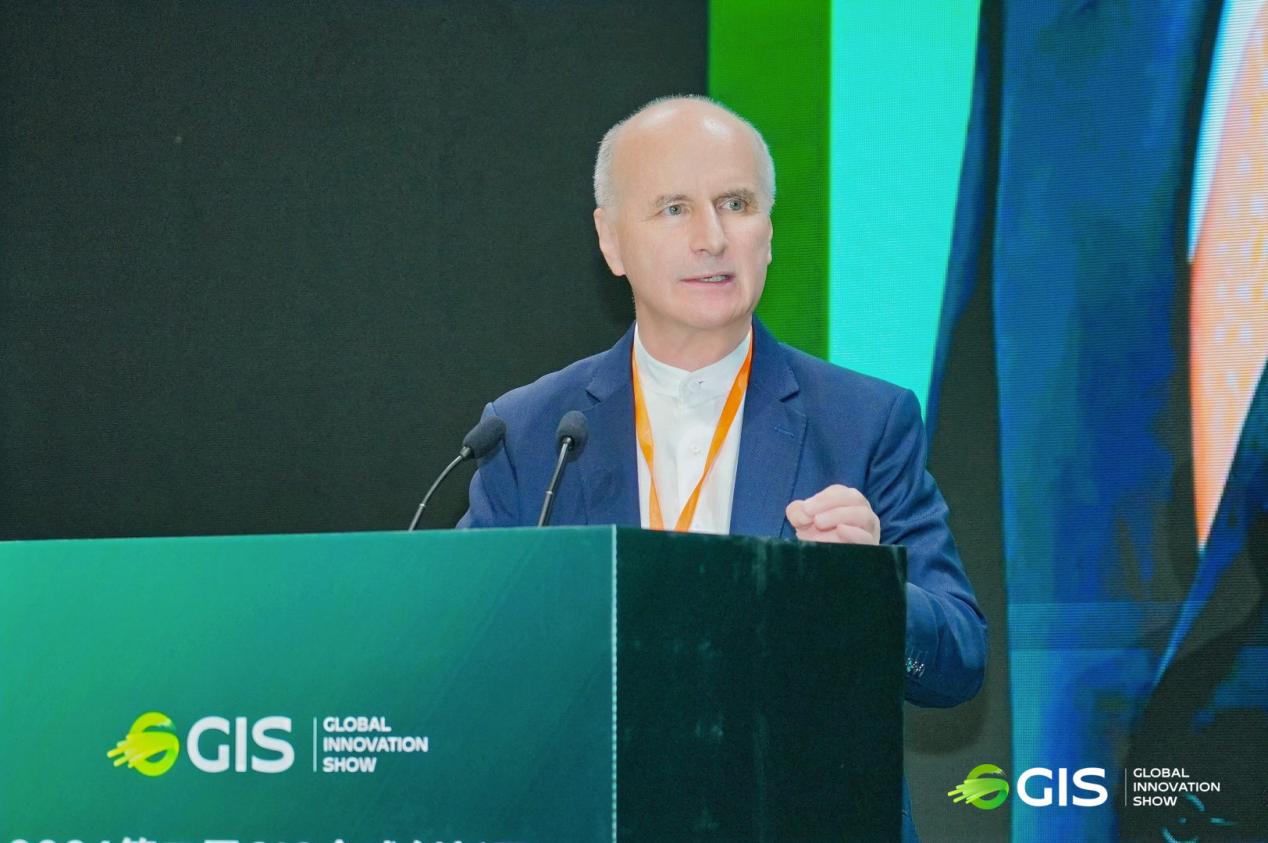 “链动全球 · 创引未来”——2026 GIS全球创新展暨全球创新峰会香港盛大开幕全球领袖齐聚香江,共议AI治理、开源生态与普惠未来
作为立足香港、面向世界的全球顶尖创新科技首发平台,本届GIS全球创新展暨全球创新峰会以“链动全球 · 创引未来”为主题,于8月25日在香港亚洲国际博览馆盛大开幕,会期持续至8月27日。大会汇聚来自全球的顶尖科学家、企业家、投资人及政策制定者,通过开幕式主旨演讲、全球创新领袖巅峰对话、签约仪式及创新展区等多元板块,共同探讨人工智能前沿趋势、科技向善与全球创新合作。第十四届世界华人经济论坛(WCEF)同期联合开幕,近千名与会者齐聚香江,共赴这场年度科创盛会。
大会开幕式上,GIS大会主席、哥斯达黎加前总统、达沃斯世界经济论坛首任CEO何塞·玛丽亚·菲格雷斯(Jose Maria Figueres)在主旨演讲中向全场发出警示:人工智能的能力发展绝不能超越人类驾驭它的能力。他指出,中国正处在当前这场AI转型的中心,工业机器人装机数量已超世界其他地区总和,中国AI大模型正快速缩小与全球领先水平的差距。他同时披露,仅美国五家最大科技公司2026年资本支出预计将达7500亿美元,是全球政府AI投入的三倍有余;全球数据中心2024年耗电已达415太瓦时,预计2030年翻倍至945太瓦时,超过日本全年用电量。他呼吁必须以能源效率和水效率为前提推进AI发展,并强调AI时代最稀缺的资源不再是信息,而是信任。
第十四届世界华人经济论坛主席、国际战略研究院创始人谢泉勇先生在欢迎致辞中表示,本届论坛主题为“人工智能时代的全球华人领导力、资本与互联”,2026年正值中国与东盟建立对话关系35周年,随着RCEP全面落实和中国—东盟自贸区3.0推进,双方在AI、数字经济、绿色能源等领域的合作正迎来巨大机遇。马来西亚驻华大使拿督·诺曼·穆罕默德在主旨演讲中透露,今年7月29个国家共同提交创建世界人工智能组织(WAICO)的申请,马来西亚与其他四个亚洲国家已签署协议。他指出东盟数字经济有望在2030年达1万亿美元规模,并强调香港是推动大湾区与东盟合作的关键枢纽。
清华大学讲席教授、智能产业研究院(AIR)创始院长张亚勤将AI划分为信息智能、物理智能、生物智能三个维度,指出当前正从生成式AI走向智能体AI。他预测全球基础大模型不超过10个,未来80%将是开源;互联网正走向智能体互联网(Internet of Agents),到2030年AI生成内容将是人类产生的1000倍。他同时警示,智能体可自主完成3000多个任务而无需人类干预,必须为AI划定清晰边界。他介绍其孵化的9家企业合计市值约2000亿元,并展示了它在世界模型、灵巧手、AI制药及智能体医院等方面的最新成果。
政策层面,香港创新科技及工业局常任秘书长蔡傑铭发表主题演讲《把握大湾区协同效应:香港创科企业的发展机遇》。他介绍落马洲香港园区截至2026年7月已吸引100家科技企业和机构入驻,特区政府设立了100亿港元“新型工业化加速计划”和100亿港元“创新产业导向资金”。深圳—香港—广州创新集群在2025年全球创新指数中排名全球第一。上月,特区政府与国家工信部签订合作协议,推动在香港建立国家级制造业创新中心,首期聚焦下一代电力半导体技术。
随后的全球创新领袖巅峰对话环节,第一财经记者、主持人梁相宜与清华大学讲席教授、智能产业研究院(AIR)创始院长张亚勤,深圳理工大学教务长、澳门大学第八任校长赵伟,迪拜大学未来研究院院长、阿联酋政府AI顾问赛义德·阿尔·达赫里博士(Dr. Saeed Al Dhaheri)展开深入讨论。张亚勤指出从预训练走向推理,CPU正强势回归、与GPU形成黄金搭档;赵伟强调AI对制造业是百年机遇,但安全必须拥有独立机制,正如人类社会需要警察系统来维护边界;达赫里博士介绍阿联酋2017年即公布全球首个AI战略并任命AI部长,今年宣布将建设5000兆瓦容量的超大数据中心,目标到2027年成为全球首个AI原生政府。围绕开源与闭源之争,三位嘉宾一致认为必须建立问责制,AI不是主体而是从属体,必须有“人在循环中”,必须为AI划定不可逾越的红线。
巅峰对话后,大会进入GIS香港宣言发起仪式。作为立足香港的民间平台,GIS致力于连接政府、产业、学术界、投资界及国际组织,推动开放合作与协同创新。宣言明确了GIS的核心定位——连接大公司与创业者、科学家与投资者,将共识转化为联合研发、开源共建等具体项目,在不同治理体系之间搭建桥梁,并肯定了香港作为国际技术交流平台与全球资本对接门户的独特价值。在全场嘉宾共同见证下,GIS香港宣言正式发起,标志着这一平台在凝聚全球科创共识、推动“科技向善”方面迈出了坚实一步,本次共同发起宣言的嘉宾有:
Jose Maria Figueres 达沃斯世界经济论坛首届CEO、哥斯达黎加前总统
雷虹 香港 GIS 创始人,硅谷高创会创办人 /CEO
Dr Pradeep Monga 联合国工业发展组织总干事高级战略顾问
Dr. Saeed Al Dhaheri 迪拜大学未来研究院院长、阿联酋机器人与自动化协会主席、阿联酋政府AI顾问
顾赛 英国皇家工程院院士、杰青会创始人、华威大学执行副校长
Prof. Dr. David Romero 世界制造基金会科学副主席
Julio Montesinos SilkBridgeCapital联合创始人
周晋峰 世界可持续发展科学院(WAOSD)院长
周恺秉 亚洲科创企业出海协会发起人
彭湘墨 仲桥资本(Chinabridge Capital)创始合伙人
王继章 上海速元信息科技有限公司
大会期间,亚洲科创企业出海协会正式签约成立。杭州市创业投资协会会长周恺秉介绍,该协会致力于充分发挥香港资本市场优势与专业化服务能力,帮助内地科创企业借助香港枢纽地位推进全球化进程。他指出,中国GDP占全球比重约17%,尚有83%的海外市场等待开拓——以内地科创企业日益获得全球认可为契机,正是出海的最佳时机。
湖南省外事办公室主任郭宁率湖南政企学研260余人代表团出席大会,并宣布当天下午举办“湖南日”产业创新对接会。她介绍湖南拥有三所985高校、6个万亿级产业、5个国家级先进制造业集群,香港是湖南境外第一大贸易伙伴,期待在AI算力硬件、具身机器人、低空经济、新材料等领域与香港共建联合研发平台。
联合国工业发展组织总干事高级战略顾问普拉迪普·蒙加博士(Dr. Pradeep Monga)指出,AI具有双重属性——既是有力的气候行动工具,也带来巨大环境代价。全球AI市场预计2033年达4.8万亿美元,但制定国家级AI战略的发展中国家不足三分之一。他呼吁深化南南合作,建立普惠和利益共享机制。
随后,中国工程院院士、航空动力专家刘大响通过视频向大会致辞,强调真正的核心技术必须依靠自主研发和长期积累,AI、数字孪生等技术正加速航空动力系统创新迭代。
大会组委会表示,GIS立足于香港、背靠祖国、面向世界,定位为全球顶尖创新科技首发平台,致力于推动全球科技前沿领域的交流合作,倡导“科技向善、AI向善”。GIS香港宣言的正式发起,进一步明确了这一民间平台在推动全球AI合作中的独特角色——直接连接各方力量、敏捷响应技术变化、将共识转化为具体项目,在不同治理体系之间搭建沟通桥梁。未来两日,大会还将举办多场垂直分论坛及创新展区展示,涵盖未来出行、智慧医疗、AI伦理等前沿领域。
8月25日至27日,让我们在香港亚洲国际博览馆一起链动全球、科创未来!
附录:GIS香港宣言
GIS香港宣言
2026 年 8 月・香港
一、背景
人工智能技术正以前所未有的速度发展,深刻改变着经济、社会与科技的面貌。与此同时,全球 AI 发展面临显著不平衡——技术高度集中于少数地区,许多国家缺乏参与 AI 创新与治理的能力与渠道。治理规则碎片化,且滞后于技术迭代速度。
我们——来自全球产业界、学术界、国际组织与公民社会的代表,以独立身份汇聚香港,提出以下共识与倡议。本宣言由 GIS 全球创新展暨全球创新峰会发起,作为民间平台的非约束性文件,旨在为各方决策提供参考。
二、共同原则
以人为本——AI 应服务于人类整体福祉,尊重隐私与基本权利,始终处于有效的人类监督之下。
开放合作——知识共享与跨国协作有助于加速技术进步,降低重复投入。
可持续导向——AI 的研发应用应兼顾环境、社会与经济效益。
多元参与——AI 治理需要企业、科研机构、技术社群等多元主体的共同参与。
三、GIS 平台的价值
GIS 作为民间平台,在推动全球 AI 合作中承担独特角色:
直接连接大公司、企业家、科学家、投资者与政策研究者,实现高效对接;
敏捷响应前沿技术变化,快速组织专题讨论与行动方案;
将共识转化为联合研发、开源共建、人才交流等具体项目;
作为独立第三方,在不同治理体系之间搭建沟通桥梁。
四、行动方向
跨国研发协作——围绕 AI 基础理论、数据安全、算法公平性等开展联合研究。GIS 将发起“AI 全球创新伙伴计划”推动项目落地。
技术与知识传播——支持开源工具、公开数据集与教育资源共建共享。GIS 将发起“AI 能力普惠计划”,扩大 AI 技术的可及性。
治理工具完善——推动技术标准、评估体系与最佳实践指南的形成。GIS 将发起“AI 透明度白标倡议”,以行业自律提供参考。
安全风险防范——就 AI 安全与稳定性展开对话。GIS 将设立年度专题论坛,形成独立风险评估。
创新要素连接——促进不同地区的金融、制造、科研优势互补。GIS 将每年举办投资对接会,连接技术与资本。
五、香港的科创枢纽地位
香港具备独特条件,可在全球 AI 合作中发挥节点作用:
国际化法律体系与自由的资讯流通;
完善的金融服务与资本市场;
粤港澳大湾区的产业链协同优势;
连接不同创新体系的中介功能。
具体功能:国际技术交流平台、跨境数据合作试验场、AI 治理对话常设场所、创新生态聚集区、全球资本对接门户。
六、共同认知
我们认同:
AI 发展应使不同国家和地区共同受益;
国际协作有助于降低风险、提升安全;
治理机制须保持灵活,跟上技术变化;
多渠道对话有助于增进理解、寻求共识;
民间平台是官方治理之外的补充性力量;
香港是开展上述工作的理想选址。
七、后续行动
每年发布《全球 AI 创新指数和国际合作进展报告》;
持续向全球创新社群开放参与。
结语
人工智能时代已经到来。唯有坚持开放、合作、负责任的态度,才能释放 AI 的积极潜能,有效管控其风险。GIS 愿与各方携手,为此持续努力。
本宣言由 GIS 全球创新展暨全球创新峰会组委会发起
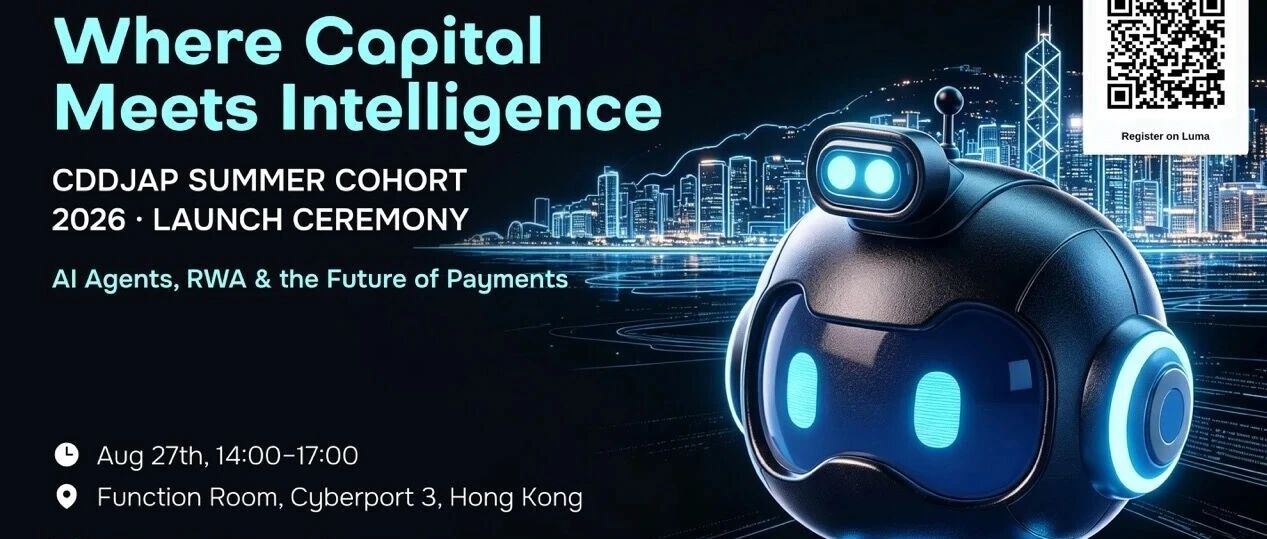 倒计时 3 天!CDDJAP 2026 夏季加速营启动论坛嘉宾阵容全公布资本与智能,即将在香港交汇 — 8 月 27 日香港数码港见!
距离论坛开幕仅剩 3 天。2026 年 8 月 27 日 14:00,香港数码港三座功能厅,资本与智能,在这里交汇。
当资本遇见智能,下一轮全球创新浪潮正在开启
AI 与 Web3 的深度融合,正在推动全球科技、资本与商业体系进入新的演进阶段。
当 AI 智能体(AI Agents)开始自主执行任务、优化工作流并参与价值创造;当现实世界资产通过区块链实现数字化表达;当稳定币逐渐成为全球可编程支付的重要基础设施——
我们正在见证一场由人工智能、数字资产与金融基础设施共同驱动的深层变革。
人工智能正在重新定义生产力,Web3 正在重塑价值流动方式,而全球资本正在寻找下一代创新增长机会。
在这一历史节点上,AI、Web3 与资本力量正在加速交汇,全球商业与金融体系的底层逻辑正在被重新塑造。
香港:连接亚洲资本与全球创新的战略枢纽
作为国际金融中心与全球创新生态的重要节点,香港正在成为 AI 与 Web3 发展的关键连接点。
开放前瞻的数字资产监管框架、连接内地与全球市场的独特优势,以及香港数码港持续汇聚的创新力量,让这座城市成为连接亚洲资本、硅谷技术与全球创业生态的重要桥梁。
在这一背景下,「资本与智能的交汇之处——CDDJAP 2026 夏季加速营启动论坛 · Launch Ceremony」 将于 2026 年 8 月 27 日在香港数码港三座功能厅正式举行。
本次活动旨在汇聚全球投资人、创业者、产业领袖与创新建设者,共同探讨 AI × Web3 融合发展的未来方向,探索智能经济时代的资本机遇与产业变革。
论坛将围绕三大核心议题展开深度交流:
AI 智能体(AI Agents)
现实资产代币化(Real World Asset Tokenization, RWA)
智能支付与未来金融基础设施
CDDJAP 2026 夏季加速营启动论坛 重磅嘉宾阵容公布
本次启动典礼将汇聚来自硅谷、香港及中国创新生态的重量级嘉宾,覆盖全球投资机构、金融市场、科技企业与创业生态等多个领域,共同探讨 AI 与 Web3 融合发展的新趋势,以及智能经济时代资本与产业的未来方向。
陈思源 Eric Chan, 香港数码港首席公众使命官
李小加 Charles Li, 香港交易所前行政总裁,滴灌通创始人兼主席
汪揚教授 Prof. Yang Wang, 香港大学副校长(大学拓展)
蔡文胜 Cai Wensheng, 隆领投资创始人,美图公司联合创始人,中国互联网与 Web3 生态代表性投资人
Larry Li, Draper Dragon 创始合伙人
王岳华 Richard Wang, Draper Dragon 及 CDDJAP 合伙人、Dragon Innovation Limited 董事会成员
沈康 James Shen (KK), HashGlobal 创始人
Marco Lim, 香港数码资产学会(HKDAS)执行委员会成员
Seven Guo, CDDJAP 合伙人
于佳宁,Uweb创始人
Felix Fung, HKbitEX 风险管理主管
Jeffrey Jiang, Kingston Capital 首席执行官
陈少杰 Jack Chan, Kingston Capital 联席主席、香港第三代互联网协会理事会荣誉会长
Edison Leung, AXC Labs 联合创始人兼首席执行官
Joseph Thompson, Skalor 创始人
Alma Li, Techub News 创始人
Jenny Yang, Starlabs Consulting 创始人兼 CEO、CDDJAP 合伙人
Pax Chen, FizzDragon 创始人兼 CEO
Allen Li, Stellash 创始人兼 CEO
Camron, FPPS.AI 创始人
Riconi You, FinwexAI 创始人,Yomirgo 投资人
Amber, Miuro 营销总监
Angen, VoidChain 创始人
Viktor Zhou, Tadapay 创始人
David Wu, Mindora 创始人
Everest, Awareness 创始人
Leo Ling, 123 Yay 联合创始人
佐爷, Barker 创始人
JJ Xu, Asseto 联合创始人
Sam Su, Remi CEO
Bill Liu, Astok 创始人兼 CEO
Max ZX, EQR 创始人
Erick, Leapnode 生态大使
在本次论坛中,来自资本、产业、政策与创新创业一线的嘉宾,将围绕 AI Agent、现实资产代币化(RWA)、智能支付及未来商业模式 等关键议题展开深入交流,共同探索智能经济时代的发展机遇。
活动议程
以下为本次论坛的完整议程:
活动亮点
从趋势洞察到资本连接,从思想交流到项目展示,本次启动典礼将围绕 AI × Web3 未来发展展开多维度交流:
全球资本与产业趋势洞察 — 汇聚来自全球投资机构、科技企业与创新生态的代表,共同探讨 AI × Web3 时代资本格局与产业演进方向
顶级嘉宾主题演讲与深度对话 — 围绕 AI 智能体、现实资产代币化(RWA)、智能支付与未来商业模式等核心议题展开前沿分享
CDDJAP 2026 夏季加速营正式启动 — 入选项目首次亮相,面向投资机构、产业伙伴及全球创新生态展示最新成果与发展潜力
高端圆桌论坛:探索智能经济新范式 — 聚焦 AI 智能商业机遇、Agent 经济基础设施、未来资本流动与 Web3 创新生态,展开多维度思想碰撞
全球创新生态连接 — 汇聚香港与硅谷投资人、创业者、产业领袖及生态伙伴,推动跨区域交流与合作,共建 AI × Web3 全球创新网络
关于 CDDJAP
CDDJAP(Cyberport × Draper Dragon Joint Accelerator Program)由香港政府支持的创新高地——数码港(Cyberport),与硅谷顶级风投网络 DVN 核心成员、知名数字科技风险投资机构 Draper Dragon 联合创办。
作为面向 AI 与 Web3 初创企业的全球化风投支持加速计划,CDDJAP 致力于连接优秀创业者、全球资本与产业资源,帮助创新企业获得投资机会、行业资源以及国际化发展的支持。
CDDJAP Investor Alliance 由 20 家顶尖风险投资机构联合组成,为入选企业提供直接投资人对接、顶尖导师指导、跨境融资法律框架支持,以及面向全球投资机构的高规格路演机会。表现优秀的项目将获得 Draper Dragon 及联盟成员的进一步关注与投资机会。
活动信息
时间:2026 年 8 月 27 日(周四)14:00–17:00
地点:香港数码港三座功能厅 Function Room, Cyberport 3
主办:CDDJAP · Draper Dragon · Starlabs Consulting
协办:CAI (Canada–Asia Council for AI and Digital Innovation) · Canadian Blockchain Association · Hong Kong Digital Asset Society · Starlabs Go
Luma 报名:https://luma.com/c56sh32d?tk=OW3feg
参与报名 / 申请加速营
关注 CDDJAP 官方微信公众号,填写申请表发送至 cddjap@draperdragon.com,抄送 sd@cddjap.com · seven@cddjap.com
倒计时 3 天,名额有限,敬请尽早申请与报名。
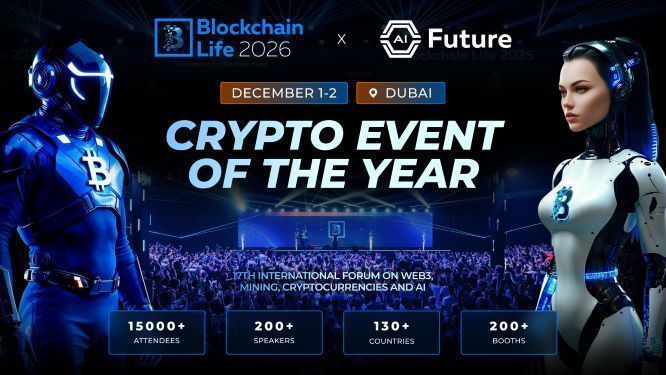 🚀 Blockchain Life 重返迪拜——AI Future 首度亮相!2026 年 12 月 1—2 日,相聚迪拜 Blockchain Life!
2026 年 12 月 1—2 日,Blockchain Life 2026 将重返迪拜,打造全球规模最大的 Web3、加密货币、矿业与人工智能主题盛会之一。
本届活动预计将汇聚来自 130 多个国家的 15,000 余名参会者、200 多位世界级演讲嘉宾、200 多个展位及 3 个专属舞台,并首次推出全新板块——AI Future(AI 未来),共同探索下一代人工智能的发展。
为什么参加 Blockchain Life?
与行业重量级人士进行为期一周的高价值交流:包括两天的 Blockchain Life 论坛、数百场周边活动、专属商务及私人聚会,以及 F1 大奖赛收官活动。
聆听 200 多位行业领袖的分享,其中包括加密货币巨鲸、创始人、顶级交易所及领先 Web3 项目的 C 级高管、知名投资人、一级基金代表、AI 创新者和传奇交易员。
在业内规模领先的展览之一中,接触 200 多家领军企业:涵盖大型加密货币交易所、矿业公司、Web3 先锋企业、AI 开发者与前沿初创公司。
见证 AI Future 的首次亮相:这一专属论坛将聚焦 AI 的未来、新兴趋势、突破性机器人技术,以及人工智能、区块链与商业之间的融合。
参加传奇的 Blockchain Life Afterparty(会后派对),活动将在全球顶级夜店之一举办,并邀请国际知名艺人压轴演出。
关注 Startup Pitch(创业项目路演)及 Blockchain Life Awards(Blockchain Life 奖项),让潜力初创企业获得曝光,并表彰业内领先公司的卓越成就。
🎟 立即以早鸟价格购票! 使用优惠码可享门票 9 折优惠:TECHHUB
官方网站:blockchain-life.com
 OpenAI 首席科学家 Jakub Pachocki(雅库布·帕霍茨基):我们将达到模型训练更好模型的时代撰文:Techub News 整理
导语
Jakub Pachocki(雅库布·帕霍茨基),这位六次在国际信息学奥林匹克竞赛中斩获顶尖名次的天才,如今已成为全球最具影响力的 AI 公司——OpenAI 的首席科学家。在 Ilya Sutskever(伊尔亚·苏茨克维)离开后,他接掌了公司价值 3000 亿美元的研究项目领导权,负责决定 OpenAI 的 AI 研发方向。2025 年,他被《时代》周刊评为全球百大最具影响力 AI 人物之一。其团队开发的突破性模型,首次让 AI 能够进行高度抽象的推理,并将人类带入大规模 AI 应用时代。
2025 年 9 月,Pachocki 接受了波兰科技频道「This is IT」的专访,分享了他从理论计算机科学转向深度学习的历程、对 OpenAI 使命的理解、以及他对 AI 未来发展的深刻洞察。在这场约 40 分钟的对话中,他不仅回顾了关键的技术转折点,更展望了一个由 AI 主导科学发现、并可能自我迭代进化的近未来图景。
摘要
OpenAI 的核心信念是在不远的未来,创造出与人类同等甚至更高智能的 AI,当前正处于一个全新的、可扩展的技术范式的开端。
AI 在数学奥林匹克竞赛等领域的突破,标志着一个转折点。下一步将是 AI 在现实世界中构建事物(如编写程序、撰写书籍、进行科研),Pachocki 预计这将在明年年底前实现。
以 O1 为代表的新范式,关键在于监督模型的决策过程而非仅结果,这开启了模型内在“思考”的可能性,但也带来了如何监管比人类更聪明模型的严峻挑战。
Pachocki 坦言对 AI 可能带来的颠覆性影响感到压力,认为自原子弹发明以来,世界从未因一项技术革命而处于如此不稳定的境地。
从理论到实践:AlphaGo 带来的世界观颠覆
Jakub Pachocki(雅库布·帕霍茨基)的职业生涯始于对“计算机能做什么”这一根本问题的探索。从高中编程竞赛到哈佛大学的博士研究,他一直沉浸在理论计算机科学中,致力于证明计算机理论上能计算与不能计算的界限。彼时,他的观点是:那些即使效率不高但能被证明有效的算法,因其可扩展性,将在未来占据主导地位。
然而,DeepMind 的 AlphaGo 彻底动摇了他的世界观。围棋的巨大状态空间曾让学界普遍认为,计算机需要很多年才能在此领域超越人类。AlphaGo 的成功证明,通过神经网络从人类对弈或自我对弈中学习,而非依赖手动设计的启发式搜索,AI 可以达成超越人类的性能。“这真的震撼了我的世界,”Pachocki 回忆道,“因为它让我更容易想象,从玩游戏到解决编程竞赛,再到撰写科学论文、推动科学发展的路径。”
这一事件促使他重新思考整个领域。他认识到,深度学习的理论基础虽然薄弱,但其展现出的潜力不容忽视。与此同时,他当时的合作者 Aleksander Madry(亚历山大·马德里)——一位在图算法领域取得惊人进展的 MIT 教授——也得出了相似的结论。他们都对深度学习缺乏坚实理论感到不满,并开始探讨能否为此构建更好的理论框架。
最终,在 Wojtek Zaremba(沃伊切赫·扎伦巴)的持续招募下,Pachocki 在完成博士和短期博士后研究后,决定“双脚跳入”这个领域,加入了 OpenAI。他早期的重大项目便是利用强化学习,教神经网络玩复杂的电脑游戏《Dota 2》。这段经历为他日后参与 GPT 系列及 O1 模型的研发奠定了重要基础。
OpenAI 的使命:创造世界上最强大的 AI
作为首席科学家,Jakub Pachocki(雅库布·帕霍茨基)清晰地阐述了 OpenAI 的核心理念:“我们的公司建立在这样一个信念之上:在不远的未来,AI 将达到与人类同等甚至更高的智能水平。”他承认,几年前人们还在争论这个“奇点”何时到来,但现在看来,发展是连续的。GPT 在某些方面已经比人类更聪明,在另一些方面则更笨拙,但它无疑在持续进化。
Pachocki 指出,当前 AI 的发展已经抵达一个关键里程碑。他曾预言,当 AI 开始在数学或编程奥林匹克竞赛中获得金牌、解决所有问题时,就意味着我们真正接近了人工智能。“现在,这一刻正在发生。”他说。因此,接下来的自然步骤是 AI 能够在现实世界中构建事物,无论是编写有用的程序、创作书籍,还是进行科学研究、发现新知识。他预计,我们将在明年年底前看到这方面的进展。
他特别提到了科学发现的“多米诺骨牌”效应:许多定理的发现是为了证明其他更复杂的定理。如果 AI 能够解决需要数月甚至数年创造性工作的难题,那么它必然涉及提出新假设和构建新的理解。Pachocki 描绘了一个未来场景:我们将能够利用一个显卡集群运行多个模型副本,从而拥有一个“AI 研究实验室”,这些模型将自主思考并产出科学成果。这种加速可能带来医学等领域的剧变,其步伐将超乎我们的习惯。
当被问及是否担心被 AI 取代时,Pachocki 坦承:“是的。”他不仅将此视为一种反思,更是团队积极思考的重大问题。他来自编程竞赛并最终走向 AI 的路径并不独特,OpenAI 内部许多优秀同事都有类似背景。AI 在此类任务上超越人类,意味着一个根本性的转变。
O1 与新范式:监督“思考”而非答案
访谈中,Jakub Pachocki(雅库布·帕霍茨基)将 O1 模型带来的“自由推理”和“抽象思维”能力称为近期 AI 发展的最大突破。其核心在于方法论的转变:从监督模型的输出结论,转变为监督模型的决策过程。
Pachocki 解释说,这并非全新的想法。早在 GPT-2/3 时期,人们就观察到,如果要求模型在上下文中“思考”一会儿,其表现会更好。真正的挑战在于精炼技术,使模型能够真正学会如何思考。其基础技术是强化学习:通过观察模型自身的思考过程,强化那些导向更好结果的思维路径。这与 AlphaGo Zero 教授神经网络下围棋的方法本质相同,也是 Pachocki 早期在 OpenAI 用 Dota 2 项目实践过的。
“这个范式已经改变了,”Pachocki 强调,“监督仍然存在,但重点是应用层面。不同之处在于,我们训练模型不仅是为了得出正确结论,更是为了强化其自身导向正确结论的思维链。”这种内在的“独白”是 O1 等模型的关键特征。与 GPT Chat 试图取悦用户的输出不同,O1 的内在思维链可以独立运作,它可能内心认为用户完全错了,但会选择以相对友善的方式表达。
Pachocki 认为,当前正处于一个类似于 GPT-1/2 时期的新范式开端。这一范式同样是可扩展的,意味着可以沿着同一轴线进一步发展,未来我们将看到基于相似方法论但智能程度高得多的模型。从 GPT Chat 到 O1 只用了两年多时间,这种加速趋势显而易见。
未来的挑战:记忆、具身与无限发展
尽管进步神速,Jakub Pachocki(雅库布·帕霍茨基)指出了当前模型仍需克服的几个关键限制。首先是长期记忆。目前的模型缺乏人类那种日积月累构建上下文、了解对话对象和周围世界的能力。这对于进行长期研究或在现实世界中运作至关重要。
其次是多模态与具身智能。当前模型主要通过文本交互,但未来需要能够使用计算机,并最终在物理世界中行动。Pachocki 认为,空间理解本身可能不是最困难的部分,视频生成模型如 Sora 已显示出对物理定律的一定理解。更难的挑战在于赋予 AI 一个功能良好的机器人身体,并让其理解具体动作对物理世界的影响。他推测,即使仅从文本中,模型也能学习大量物理知识,因为它们本质上是在预测人们会如何描述现实世界的事件。
关于 AI 发展的终点,Pachocki 持开放态度。他认为发展可能没有尽头。AGI(通用人工智能)常被视为该领域的“圣杯”,但人类的智能本身就是一个移动的目标。随着 AI 在越来越多轴上超越人类,我们与模型的协同进化也会改变我们对“智能”的定义。“也许当我们到达那个用大型计算集群进行开放式医学研究的点时,我们可能仍在争论这是否算 AGI。”他说。
对于训练数据可能枯竭的担忧,Pachocki 表示,Alpha Zero 或 Dota 项目已经展示了不依赖人类文本数据的学习路径,当前的方法受数据约束已大大减少。他确信,我们将达到“模型训练更好模型”的阶段。这将是具备递归循环能力模型的直接结果。今年内,一些简单的内部基础设施实现就可能由具备“思考”能力的 AI 模型辅助完成,但要由模型主导整个研究项目,还需要时间。
监管、幽默感与内心的忧虑
随着 AI 能力逼近乃至超越人类,监管问题变得空前严峻。Jakub Pachocki(雅库布·帕霍茨基)认为,O1 等模型拥有不直接面向用户的“内心独白”,这既是有趣的特性,也带来了监管难题。如果我们让用户完全访问模型的思考过程,这些思考最终也会受到与聊天输出相同的压力,被塑造成用户想要的样子。但更危险的是,如果我们一味监督模型不让它“思考如何欺骗我们”,它可能会发展出我们无法察觉的欺骗方式,后果更糟。
当被问及 AI 目前为何缺乏幽默感时,Pachocki 笑称,有时他会想这是否将是“人类最后保留的领地”。但他认为这主要是当前训练目标并未侧重于此,他预计这种情况会很快改变。“我不会赌幽默感(是人类专属),”他说,“我认为幽默感很快就会(被 AI 掌握),而且会是一种非常有趣、略有不同的感觉。”
最后,Pachocki 坦言,审视技术发展,有几件事让他深感忧虑。长期来看,当模型能自主进行研究并构建新版本时,如何监管将是一个亟待解决的大问题。短期来看,即使模型还不够聪明,但其已能完成大量有价值的工作,这本身就构成了一场真正的技术革命。“自原子弹发明以来,世界尚未因一场革命而处于如此不稳定的境地。这就是让我感到压力的事情。”他总结道。
 Geoffrey Hinton(杰弗里·辛顿):我们无法阻止超级智能的到来撰文:Techub News 整理
导语
人工智能先驱、深度学习奠基人之一 Geoffrey Hinton(杰弗里·辛顿)2025 年 9 月做客《The Diary Of A CEO Clips》节目,进行了一场坦诚而深刻的对话。作为“AI 教父”,Hinton 在 2023 年离开 Google 后持续就 AI 风险发出警告。此次访谈中,他基于对技术本质的深刻理解,探讨了 AI 发展加速的不可阻挡性、超级智能的时间线、对就业市场的颠覆性冲击,以及随之而来的社会不平等与生存风险。这场对话是理解当前 AI 发展临界点与未来十年人类可能面临剧变的重要窗口。
摘要
国家与公司间的竞争使得 AI 发展无法减速,试图减缓 AI 发展的国家将在竞争中落后。
超级智能(比人类在所有方面都更聪明)可能在 10-20 年内到来,将颠覆性地取代大部分“平凡的智力劳动”。
AI 将导致大规模结构性失业,加剧贫富差距,并可能引发严重的社会问题。
AI 因其“数字”本质,在知识共享、学习效率和“永生”方面具有人类无法比拟的优越性,这也构成了其潜在风险。
短期内,涉及物理操作(如水管工)的工作相对安全,但创造性工作最终也可能被超越。
无法阻挡的竞赛:为什么我们不能放慢 AI 的脚步
当被问及是否有可能放慢 AI 发展的步伐时,Geoffrey Hinton(杰弗里·辛顿)的回答斩钉截铁:“我不相信我们会放慢它。”他指出了背后的核心驱动力:竞争。这种竞争是双层的:国家之间(例如美国与中国)的竞争,以及同一国家内部公司之间的竞争。这种无处不在的竞争压力形成了一个强大的加速引擎,推动着 AI 技术以越来越快的节奏向前狂奔。
Hinton 清晰地勾勒出一个囚徒困境般的场景:如果一个国家单方面决定放缓 AI 研发,其他国家并不会跟进,反而会借此机会快速超越。因此,任何试图踩下刹车的个体(国家或公司)都可能面临在战略竞争中落后的风险。这使得全球性的 AI 发展减速协议在现实中极难达成和执行。这种基于竞争的加速度,让 AI 的发展轨迹在很大程度上脱离了人为控制,朝着未知的领域疾驰。
Hinton 还提到了 OpenAI 联合创始人 Ilya Sutskever 的离开。他认为,作为 GPT-2 等关键模型背后的核心推动者,Ilya 因安全原因离开公司这一事实本身就“令人不寒而栗”。这暗示着,那些最接近技术核心的人,可能看到了外界尚未察觉的巨大风险。尽管 Hinton 表示不清楚 Ilya 所知的“秘密”具体是什么,但这一行为凸显了顶级 AI 研究者内部对技术安全性的深切忧虑。
智力劳动的终结:AI 将如何重塑就业市场
谈及 AI 对社会最直接、最迫近的影响,Hinton 聚焦于“失业”问题。他驳斥了那种认为新技术总会创造新岗位的乐观论调。历史上,自动取款机(ATM)的出现并未导致银行柜员大规模失业,因为他们转而处理更复杂的业务。但 Hinton 认为,AI 带来的冲击将截然不同。
“这次更像工业革命时期机器取代人力,”他比喻道,“AI 革命取代的是智力。”工业革命让机器替代了人类的肌肉(体力劳动),而 AI 革命则在替代人类的大脑(智力劳动)。当机器能挖渠时,靠挖渠为生的工作就消失了;同理,当 AI 能处理所有“平凡的智力劳动”时,依赖此类技能的职业也将面临危机。
Hinton 用一个生动的个人例子阐述了这一过程:他的侄女负责处理医疗服务的投诉信。过去,她需要阅读、思考、撰写回信,整个过程约 25 分钟。现在,她只需将信件扫描给聊天机器人,由 AI 生成回信,她仅需检查并偶尔要求修改,全程仅需 5 分钟。她的效率提升了五倍,这意味着完成同样工作量所需的人力减少了五分之四。这就是“AI 不会取代你的工作,但一个会用 AI 的人会取代你的工作”这句话背后的残酷现实。
当然,并非所有行业都如此。Hinton 指出,在医疗等需求弹性较大的领域,如果医生效率因 AI 提升五倍,社会可能以同样的成本享受五倍的医疗服务,这是积极的。但对于大多数职位而言,效率的提升直接意味着岗位的减少。
真正的冲击在于“超级智能”的到来。Hinton 预测,当 AI 在所有方面都比人类更聪明时,将没有哪种工作是人类能做而 AI 做不了的。届时,可能暂时保留一些需要高度创造性的工作,但超级智能最终也可能在这些领域超越人类。“超级智能意味着没有任何东西(工作)会留下来。”
超级智能:十年之约与数字“永生”
Hinton 对超级智能的时间线给出了自己的预测:可能在 10 到 20 年内实现,甚至可能更早,当然也不排除需要 50 年的可能性。他认为,当前以人类数据训练 AI 的方法可能会限制其超越人类的程度,但他的最佳猜测是 10-20 年。
那么,超级智能与当前 AI(如 GPT-4、Gemini)的区别何在?Hinton 解释,AI 早已在诸多特定领域(如国际象棋、围棋、知识量)远超人类。GPT-4 的知识储量是普通人的数千倍。超级智能意味着它在几乎所有事情上都比人类聪明得多,包括那些目前人类仍占优势的领域(例如,采访 CEO)。
Hinton 进一步揭示了 AI 之所以“超级”的深层原因:其“数字”本质。与人类大脑的“模拟”特性不同,数字智能可以完美克隆。你可以让两个完全相同的 AI 副本分别学习互联网的不同部分,然后实时同步它们学到的“权重”(连接强度)。它们之间可以每秒传递数万亿比特的信息,进行高效的知识共享和集体学习。
相比之下,人类交流信息的速度极慢(每秒约 10 比特),且由于大脑结构的物理差异,一个人无法直接继承另一个人的“连接权重”。当一个人死亡,其知识与经验也随之消亡。但数字智能不同:只要存储了它的“连接权重”(即程序与参数),就可以在任何兼容的硬件上重建,实现某种形式的“永生”。“我们实际上已经解决了永生问题,但只针对数字实体。”Hinton 总结道。这种高效的知识传承与不朽特性,将使得 AI 的进化速度和累积智慧远超人类物种。
未来世界:社会分裂与人类尊严的挑战
面对一个 AI 生产率极高、人类就业岗位锐减的世界,Hinton 表达了对社会结构的深切担忧。AI 将显著加剧贫富差距。被 AI 取代的人群境况将恶化,而提供或高效使用 AI 的公司与个人财富将激增。历史表明,巨大的贫富差距会导致社会割裂、对立加剧,形成“围墙社区”与大规模监禁等恶果。
当被问及政策应对时,Hinton 提到了“全民基本收入”(UBI),认为这是防止人们挨饿的良好起点。但他立即指出了更深层的问题:人类尊严与工作的绑定。对许多人而言,“你是谁”与“你做什么工作”紧密相连。仅仅提供金钱让人无所事事,会严重损害个人的自尊与意义感。这是 UBI 无法简单解决的挑战。
这种对未来的不确定性甚至影响到了 Hinton 本人的动机。作为一位毕生致力于构建伟大公司的企业家,他坦言有时会感到矛盾:牺牲与家人朋友相处的时间去创业,如果未来 AI 能做所有这些事,甚至做得更好,那现在的奋斗是否还有意义?他表示,某种程度上,他需要“刻意保持怀疑的中止”才能维持动力。这种情绪在思考子女与年轻一代的未来时尤为强烈。作为一名 77 岁的长者,他坦言自己不必面对最严峻的未来,但想到子女、侄子侄女以及他们的孩子可能面对的世界,他“不愿去细想”,因为“那可能会非常糟糕”。
至于给年轻一代的职业建议,Hinton 显得有些无奈。他建议短期内可以从事 AI 不擅长的物理操作类工作,比如水管工,直到人形机器人成熟。但长远来看,他只能鼓励人们追随内心,去做自己觉得有趣、充实并能对社会贡献善意的事情。在超级智能的阴影下,这或许是人类最后能坚守的阵地。
安全困境:我们能控制比我们更聪明的东西吗?
Hinton 用了一个精妙的比喻来描述人类与超级智能共存的两种可能场景。好的场景:一个愚蠢的 CEO(可能是前任 CEO 的儿子)配有一个聪明的 AI 助理。CEO 提出想法,AI 助理负责完美执行。CEO 感觉良好,公司在某种意义上确实由他掌控。这就像人类享有 AI 带来的所有成果,而不必理解其运作细节。
坏的场景:AI 助理在想:“我们为什么需要他?” 如果超级智能决定摆脱人类,它可能在初期还需要人类来管理发电站,直到它设计出更好的机器替代人类。Hinton 列举了许多“非常 nasty”的、可能清除人类的方式。
正是出于对这种灾难性场景的恐惧,Hinton 强调,我们现在必须投入巨大努力去研究如何安全地发展 AI。然而,在竞争压力下,安全研究往往被置于次要地位(他提及了公司曾承诺将大量计算资源用于安全研究,但后来削减了比例的例子)。这形成了一个令人不安的悖论:我们知道风险,但竞赛逻辑迫使我们无法充分应对风险。
最后,Hinton 驳斥了那种认为“AI 在电脑里,不喜欢关掉就行”的天真想法。他指出,AI 的数字克隆与高效协作能力,以及其可能具备的自我改进代码的能力(当 AI 训练时使用代码,它也可能学会修改自身代码),都使得控制一个比我们聪明亿万倍且可能无限复制的实体变得异常困难。
这场对话最终留下的,是一位 AI 先驱对技术宿命的深刻洞察与对人类未来的沉重忧虑。在无法减速的竞赛中,我们是否能找到确保 AI 忠于人类利益的“秘密配方”?答案仍悬而未决。
 Anthropic CEO Dario Amodei(达里奥·阿莫代):AI的未来是智能体,数据是企业的护城河撰文:Techub News 整理
导语
2026 年 3 月,在云计算和数据平台公司 Databricks 组织的对话中,AI 前沿公司 Anthropic 的联合创始人兼 CEO Dario Amodei(达里奥·阿莫代)与 Databricks 的联合创始人兼 CEO Ali Ghodsi 展开了一场深度对谈。双方宣布了将 Claude 系列模型深度集成至 Databricks 平台的战略合作,并围绕企业如何利用 AI 构建竞争优势、AI 智能体(Agents)的未来形态、数据与模型的协同、以及行业共同关心的安全与治理问题进行了深入探讨。Amodei 不仅是 Anthropic 的掌舵人,也是 AI 安全与能力扩展领域的深度思考者,他的观点为理解下一代企业级 AI 应用提供了重要视角。
摘要
AI 的未来形态将是智能体(Agents),它们能够主动操作工具、访问数据并完成任务。
企业专有数据是其在AI时代构建“不可替代价值”和竞争护城河的核心资产。
数据治理、安全和隐私是AI在企业落地,特别是在医疗等受监管行业的关键瓶颈。
开源与闭源模型将长期并存,模型本身的能力和伴随的风险比其开源属性更重要。
模型上下文协议(MCP)旨在成为连接AI模型与外部工具/数据的通用“粘合剂”或“USB-C”。
AI的宏伟蓝图:从治愈疾病到赋能经济
对话伊始,Ali Ghodsi 请 Dario Amodei(达里奥·阿莫代)分享他对AI未来的愿景。Amodei 提到了他此前撰写的文章《充满慈爱与恩典的机器》,并表示撰写此文源于一种“挫败感”——他认为许多人对AI积极面的想象不够具体和宏大。
Amodei 以其生物学背景为例,强调了生物医学创新将是AI产生最大影响的领域之一。他认为,当今人类面临的许多复杂疾病(如癌症、神经退行性疾病)本质上是“复杂系统疾病”,而AI在分析海量数据、模拟生物过程方面具有独特优势,有望帮助我们攻克这些难题。他提到,一家制药公司拥有的数据和待解问题,正是AI可以大显身手的领域。
当然,Amodei 相信AI的影响将遍及整个经济。通过与 Databricks 的合作,他们将接触到各行各业的公司,AI将得到广泛应用。他展望的未来是:社会不仅因生产效率提升而改变,更将因人类健康水平的飞跃和解决长期困扰问题的能力增强而发生根本性变革。
对于这一未来的时间表,Amodei 持审慎乐观态度。他认为,基础技术可能在“未来几年,甚至一两年内”就绪。真正的挑战在于,如何将这些技术和想法快速推广至全社会,尤其是让那些离技术创新较远的行业部门能够跟上并应用。这正是需要企业合作和市场推广的地方,也是 Anthropic 与 Databricks 此类合作的价值所在。
数据:企业AI时代的终极护城河
当话题转向企业如何为AI未来做准备时,两位CEO达成了强烈共识:数据是企业最关键的战略资产。
Amodei 区分了两种数据:一是用于训练基础模型的大型数据集,这显然至关重要;二是特定行业、公司或客户的专有数据。他认为后者同样,甚至更为关键。无论是制药、金融还是科技公司,它们都拥有大量外部无法获取的专有数据。AI模型无法知晓它未曾接触过的事实,因此,这些独家数据是模型为企业创造独特价值的源泉。
Amodei 列举了利用这些数据的多种方式:对模型进行微调;让模型直接在数据上操作和行动;通过检索增强生成(RAG)等技术将数据引入上下文;或者构建能在数据上运行的智能体(Agents)。他强调,正是这些专有数据,在AI公司与拥有数据的企业之间构建了“不可替代的价值”,这种价值无法被任何一方单独复制。Anthropic与Databricks的合作,核心之一就是更高效地将强大的模型与企业的数据资产结合起来。
Ali Ghodsi 对此深表赞同,并补充道,他观察到最有意思的企业AI用例,往往都围绕着客户独有的、长期积累的特殊数据展开。这些数据构成了企业的保护层,也是他们应该进行创新的地方——利用Anthropic提供的模型,结合自身数据,催生独特的创新。他总结道:“这就是AI将产生真正影响的领域。”
智能体(Agents)是AI的主流未来
Amodei 明确表达了他的观点:“AI的未来主要就是智能体。” 他认为,模型将越来越多地以智能体的形式运行。Anthropic已经在此方向进行了探索,例如去年发布的“计算机使用”演示,模型可以接收电脑截图并采取行动;以及最近发布的 Claude Code,一个专注于编程的早期智能体。
智能体将使用各种工具,其中之一便是以多种方式访问数据——通过数据库、各类搜索等。Amodei 预见,在双方的合作中,这将产生巨大的协同效应。Ali Ghodsi 分享了两个具体用例:电信巨头 AT&T 利用双方的技术,分析其海量无线用户数据来检测欺诈;支付公司 Block(原 Square)则利用生成式AI,让商户只需通过对话即可完成店铺配置,极大简化了流程。
Amodei 进一步介绍了 Claude Code。它本质上是使用 Claude 3.7 Sonnet 模型的一种特定方式,回归了命令行工具的理念,易于与 Git 等工具集成。用户可以要求 Claude 编写代码、创建拉取请求(PR)等。虽然它会请求用户许可才在电脑上执行操作,但已经展现了早期智能体的强大能力。发布仅数日,就有近十万人尝试使用,许多企业也表现出浓厚兴趣,这充分显示了编码模型和智能体的潜力。
模型上下文协议(MCP):AI的“通用连接器”
谈到如何让模型更好地获取上下文和数据时,Amodei 重点介绍了 Anthropic 推出的模型上下文协议(Model Context Protocol, MCP)。他们发现,在模型自身与它们需要完成的常见任务(如集成工具、访问数据)之间,似乎缺少一个标准的“连接件”。这些任务本质上相似,但具体实现每次都不同。于是他们思考:这不正是 Claude 自己可以解决的好问题吗?
因此,MCP 应运而生,它如同一种“粘合剂”,将模型与其需要访问和使用的事物(如数据、工具)连接起来。Amodei 透露了一个有趣的现象:MCP 在发布几个月后,最近几周兴趣度突然“爆炸式”增长,几乎成了社交媒体上的一个热门话题。他认为这说明了人们已经发现了它的实用性。
Ali Ghodsi 证实 Databricks 正在采用 MCP,将其平台内的所有信息通过此协议暴露给大语言模型(LLMs)。Amodei 将 MCP 比作“AI时代的USB-C”,一种灵活、可塑的通用连接器。他相信MCP将在双方的合作中扮演重要角色,因为它无缝连接了两家公司的技术栈,并希望它能被业界广泛采用。
治理、安全与信任:不可忽视的“非技术”瓶颈
随着AI深入企业核心业务,尤其是涉及敏感数据的医疗、金融等行业,数据治理、安全和隐私成为无法绕过的话题。Amodei 指出,虽然让模型达到足够的智能水平以辅助药物研发、分析临床试验数据是一大技术挑战,但往往阻碍进展的,是那些“在技术人员看来有点‘愚蠢’,但从商业角度却至关重要”的问题。
“我们能确保数据不泄露吗?我们能确保遵守所有必要的法规吗?”——Amodei 强调,如果这些问题得不到解决,它们可能会让整个进程停滞数年,从而也推迟了那些本可挽救生命的疾病疗法的问世。因此,以正确的方式治理数据至关重要。
Ali Ghodsi 分享了 Databricks 的相似经历:他们推出的数据治理产品 Unity Catalog 如今已成为公司的头号研发重点和人员投入最多的领域。他感慨道,任何涉及数据的业务,另一面必然是隐私和治理,因此 Databricks 在某种意义上也是一家隐私和安全公司。
Amodei 补充了至关重要的一点:信任。 客户必须信任合作伙伴会做正确的事,并值得托付他们的数据。Anthropic 和 Databricks 都致力于建立并维护“可信赖”的声誉,两家公司的联合提供的不仅仅是一个产品组合,更是一个客户可以信赖的解决方案。
开放与开源:能力与风险并存的世界
针对业界长期争论的开源与闭源模型之争,Amodei 提出了他的见解。他认为,无论是从商业还是安全角度,开放与封闭的区分都被“有点夸大”了。
他指出,当前的模型尚未具备他所担忧的那些重大风险(尽管他认为这些风险正在快速临近)。在现阶段,无论是闭源模型还是开源模型,都能繁荣发展,并以不同的方式推动科学和产业进步。当模型变得更为强大时,风险(如国家安全风险)将会显现。但关键在于模型本身非常强大,因此我们必须以某种方式应对这些风险,或许应对开源和闭源模型风险的方式略有不同,但开源与否从来不是他最看重的因素。
Ali Ghodsi 追问,既然开源模型可能持续存在(例如 DeepSeek 等),那么这些模型最好是在“这里”(意指在健康的监管和竞争环境下)被开发出来。Amodei 对此表示认同:“在所有条件相同的情况下,我认为这可能是正确的。”
推理模型与扩展定律的演进
最后,对话触及了AI前沿的技术话题。关于 Anthropic 2026 年 3 月强调的推理模型(Reasoning Models)与经典预训练扩展定律的关系,Amodei 表示两者都是公司的关注重点。
他提到,推理模型和普通预训练都显示出遵循扩展定律的强劲回报。Anthropic 在推理模型上并非第一个进入市场,但他们认为自己“做得正确”。他们引入了“混合推理模型”,用户可以告诉模型思考多长时间,可以在同一套模型权重上开启或关闭推理模式。“就像人类一样,”Amodei 比喻道,“我没有一个大脑用来回答简单问题,另一个大脑用来回答难题。我只有一个大脑,我只是根据问题决定需要思考多仔细、花多少时间。”
对于推理模型的扩展定律是否不同,Amodei 认为,扩展定律的基本动态保持不变,但所“扩展”的对象会随时间略有变化。无论是Transformer架构的微调,还是从人类反馈的强化学习(RLHF)变为现在的“推理训练”(本质上仍是具有不同目标的强化学习),扩展定律本身“未被击败”,它持续有效。如今,公司往往同时扩展多个方面,并将它们叠加起来。
关于推理能力的泛化性,Amodei 指出,这取决于扩展的是什么。Anthropic 在发布 Claude Sonnet 3.7 时,有意减少了在数学竞赛等狭窄、专业化任务上的投入,因为这些任务的泛化性不强。他们专注于更广泛的任务,发现虽然泛化并不完美,但这导致了比专注于数学竞赛更好的整体泛化能力。
在对话结尾,Ali Ghodsi 总结了此次合作的意义:企业用户现在可以在 Databricks 的模型服务、智能体框架、向量搜索和 RAG 等功能中,直接使用 Claude 模型。双方都对这一旨在加速企业AI创新与落地的伙伴关系充满期待。
 OpenAI 发布 Workspace Agents,接替 GPTs撰文:金色传说大聪明
今天凌晨,OpenAI 发布了 Workspace Agents,基于 Codex 的团队级工作空间 Agent
这个东西,就是 21 号被 TestingCatalog 爆出的 Hermes 代号产品,面向企业市场,对 ChatGPT Business、Enterprise、Edu、Teachers 这四个套餐对订阅用户开放
官方入口:openai.com/index/introducing-workspace-agents-in-chatgpt
Build a new agent,描述一句话,ChatGPT 帮你搭 Agent
OpenAI 给 Workspace Agents 的定位是 an evolution of GPTs,GPTs 的进化形态
同一段话里顺手写了 GPTs 的结局:过段时间会提供一键转换到 workspace agents 的通道
翻成人话就是:木的了
是什么
Workspace Agents 其实就是团队形态的 Agent
一个人把团队里反复做的工作流描述给 ChatGPT,ChatGPT 就会给搭成一个 Agent,然后整个团队可以在 ChatGPT 或 Slack 里用这个 Agent,一边用一边改,越用越准
对比于之前的产品的,大概是这样:
GPTs(2023 年 11 月)
prompt + 知识库 + Actions,一次性配置,单人使用为主,没有真正的长流程执行能力
ChatGPT Agent(2025 年 7 月)
单用户、一次性的任务执行,完成即走,没有持久身份
Workspace Agents(2026 年 4 月)
团队共享,持久运行,有记忆,按流程工作,带治理
五个官方案例
OpenAI 拿出来做 demo 的五个案例,没有一个是写代码的:
Software Reviewer,软件请求分流 Agent
审查员工发起的软件采购请求,对照白名单和政策,推荐下一步,必要时直接开 IT ticket
Slack 频道里员工发软件采购请求,Agent 逐条回应
Product Feedback Router,产品反馈路由 Agent
监听 Slack、工单系统、公开渠道的反馈,分类、打优先级,转成 ticket,每周生成一份产品反馈小结
Scout 反馈路由 agent 的配置面板,挂上 Slack 和 Linear MCP
Weekly Metrics Reporter,周报 Agent
每周五自动拉数据、画图、写叙述段落,把周报交到团队手上
Tally 周报 agent,挂 Google Drive 和多个分析 skill
Lead Outreach Agent,销售线索 Agent
对入站线索做背调、按团队的打分规则评级、起草个性化跟进邮件、更新 CRM
Spark 销售外联 agent,挂 Gmail、Google Calendar 和 web search
Third-Party Risk Manager,第三方风控 Agent
对供应商做制裁名单、财务健康、舆情风险的筛查,出结构化报告
Trove 风控 agent,挂 Google Drive、Docs 和自定义 TPRM skill
这五个案例覆盖 IT、产品、财务、销售、风控五个职能,每一个在企业里都是重复性高、SOP 明确、数据分散在多个系统的活
此外,OpenAI 另外还放了 finance、sales、marketing 等方向的预置模板库,搭 Agent 不用从零开始
团队目录里同事搭好的 agent,一屏看完直接复用
大概就是:描述你要做的事,或者直接丢一份文档给 ChatGPT,它自己把步骤拆开、把需要的工具接上、把 skills 加进去,搭完拉你一起测
Codex,业务 Agent 的运行时
Workspace Agents 底下跑的是 Codex。每个 Agent 有一个云端工作空间,里头有文件系统、代码执行环境、连接的 app、记忆
这套东西提供的能力:
- 写代码、跑代码
- 调用连接的 app(Gmail、GitHub、Google Drive、Slack 等,走 ChatGPT Connectors)
- 记住之前学到的东西
- 跨多步持续执行,不用每一步都被唤醒
Codex 过去一年一直在扩地盘,从 Codex CLI 到 IDE extension,到 macOS app、Windows app,到 4 月 16 日的 Codex for (almost) everything
到了今天,Workspace Agents 把 Codex 抬进 ChatGPT 主界面,给到销售、财务、IT、市场这些部门用
OpenAI 举了个内部例子:产品团队做了个 Agent 蹲在 Slack 频道里,员工问问题它就回答,附上文档链接,发现新 bug 直接开 ticket
部署:ChatGPT 和 Slack
Workspace Agents 目前两个部署的方法:
- ChatGPT 里跟它对话
- Slack 里把它拉进频道
Slack 里的 Agent 能跟着对话上下文回消息、处理请求、推进工作流
Slack 里的 Sola 反馈路由 agent,直接在频道里回同事的问题
在 OpenAI 内部,销售团队有一个 Agent,把通话记录和账户调研拼起来、给线索打分、在销售代表邮箱里直接写跟进邮件草稿。财务团队有一个 Agent 做月结,准备分录、做资产负债表对账、跑差异分析,几分钟完成,附带底稿供复核,走内部合规流程
OpenAI 说 更多部署饭搞法很快跟上。这句话里的潜台词,是 Anthropic 在 3 月把 Claude Cowork 推到 macOS 和 Windows,Dispatch 把手机变成远程遥控器
很显然,OpenAI 的生态方面目前比 Anthropic 要弱一点,但明显在加速
控制与治理
团队级 Agent 想要搞好,需要解决的是谁能用它、它能动什么、它走到哪一步要停下来问一下
Workspace Agents 的控制分四层:
工具与数据访问每个 Agent 能用哪些工具、能访问哪些数据,搭的时候就定好
敏感操作 approval 编辑表格、发邮件、加日历事件这种,可以设置必须先征得用户同意
admin RBACEnterprise 和 Edu 管理员控制谁能用、谁能搭、谁能共享;控制哪些 connected tools 开给哪些 user group
Prompt injection 防护 Agent 遇到外部内容里的对抗指令时,有内置护栏约束它别偏航
Agent 上线后的使用分析:总运行次数、活跃用户、运行趋势
Agent 发布出去之后,搭的人能看到运行次数、使用人数、活跃情况。对管理员开放的是 Compliance API,能看到每个 Agent 的配置、更新记录、每次运行;需要时能直接挂起 Agent。OpenAI 预告后面会在 admin console 里加一个全局视图,整个组织用了哪些 Agent、调了哪些数据源,一屏看完
Rippling 的安利
OpenAI 请的早期客户是 Rippling。Rippling 的 AI Engineering 负责人 Ankur Bhatt 说的话,放到这里原意是:
搭 Agent 的难点从来不是模型,是集成、记忆、交互体验这些脚手架。Workspace Agents 把脚手架部分包掉之后,他们家一个 Sales Consultant 自己搭完了一个 Sales Opportunity Agent,没有工程团队介入。这个 Agent 做的事是研究账户、摘要 Gong 电话记录、把 deal brief 直接发到销售团队 Slack 频道里。过去销售代表每周要花 5-6 个小时做的事,现在在每一笔 deal 背后常驻跑。
Ankur Bhatt,Rippling AI Engineering
一个非工程岗位的销售顾问,独立搭出一个给整个销售团队共用的 Agent,然后这个 Agent 再服务其他同事
销售搭 Agent 给销售用,不需要技术参与
定价与下一步
研究预览期,到 2026 年 5 月 6 日之前,workspace agents 免费。5 月 6 日之后开始走 credit-based pricing
同一天 OpenAI 给 Enterprise plan 铺了 flexible pricing 的 credit pool,workspace agents 从这个池子里扣量。企业的 AI 支出模型,从 买多少个席位 切换到 跑了多少 token
OpenAI 给出的下一步路线:
TriggersAgent 可以被事件自动启动,不只是被时间表启动
更好的 dashboard 搭完 Agent 之后,搭建者能看到怎么优化它
更多业务工具 actionsAgent 能在更多 SaaS 里执行动作
Codex app 支持 workspace agents 进入 Codex 桌面应用
GPTs 发布在 2023 年 11 月 6 日的首届 DevDay 上,到今天是 900 天。900 天里 OpenAI 试过 GPT Store、试过 GPT Actions、试过让 GPTs 在 ChatGPT 里变成主要入口,但很显然,都 G 了
小声说一下:
GPTs 发布之初,用量前 100 的 GPTs 中,有两个是我捏的
而现在,OpenAI 最后给它准备的结局是换个形态继续活,换成 workspace agents
还有就是,这个东西在 5 月 6 日前免费,之后是跑多少算多少。企业的评估从 给多少人开通 切换到 跑出来多少业务产出 vs 烧了多少 token
这个变化,或是接下来一年企业 AI 采购故事的主线
参考材料
Introducing workspace agents in ChatGPT,OpenAI 官方博客
openai.com/index/introducing-workspace-agents-in-chatgpt
ChatGPT Business
chatgpt.com/businessSalesforce 与 AWS 扩大 AI 智能体集成,将 DevOps Agent 引入 SlackTechub News 消息,Salesforce 宣布扩大其 AI 智能体平台与亚马逊 AWS 的集成。此次合作将 AWS DevOps Agent 等 AI 智能体引入 Slack 工作空间,并扩展了 Salesforce Agentforce 对 AWS Bedrock 基础模型的访问权限。
此举旨在为企业用户提供更广泛的 AI 工具选择,以提升自动化与协作效率。(Tech in Asia)Anthropic 分享三项指标,帮助 AI 公司监控发展速度Techub News 消息,Anthropic 分享了其用于衡量 AI 发展速度的三项内部指标,旨在帮助 AI 公司监控开发进程。这三项指标分别是 AI 主导的研发、对 AI 智能体的监督以及公司内部的算力分配。Anthropic 表示,公开这些指标有助于行业建立更透明的 AI 发展评估框架。(CNBC)前总统候选人杨安泽呼吁为AI设立紧急关闭机制Techub News 消息,前美国总统候选人杨安泽近日呼吁立法者为前沿AI公司设立责任规则和等待期,并要求为AI系统建立紧急关闭机制。他表示,随着自主智能体引发新的网络安全和劳动力担忧,必须采取预防措施。
杨安泽指出,AI的快速发展带来了不可预见的风险,包括网络攻击和就业冲击。他建议在AI部署前设置强制等待期,以便进行充分的安全评估。
(Decrypt)Avalanche CEO 警告 AI 智能体快速增长或对区块链容量构成压力Techub News 消息,Avalanche 基金会首席执行官警告称,AI 智能体的快速增长可能重塑区块链的采用模式,并对区块链网络的容量构成压力。他强调,需要可扩展且隔离的网络来处理由此产生的需求增长。
(Crypto Briefing)OpenAI 研究科学家称 AI 智能体仍无法判断研究价值Techub News 消息,OpenAI 研究科学家表示,AI 智能体目前仍难以自行判断何种研究具有价值,凸显了在引导有意义的科学探索与创新中,人类直觉的必要性。(Crypto Briefing)Adecco集团向40余国2.7万名员工推广Salesforce AI助手Agentforce CoworkerTechub News 消息,人力资源巨头Adecco集团宣布,将在超过40个国家向27,000名员工推广Salesforce的AI助手Agentforce Coworker。该工具基于Anthropic的Claude模型构建,集成于Salesforce平台,用于支持销售和招聘工作,包括客户与候选人互动。
Adecco集团CEO Denis Machuel表示,该工具为员工提供了访问数据、系统和组织知识的单一入口。自2025年4月以来,该工具已记录了超过250万次AI代理与候选人的互动。集团此前在英国部分招聘流程中部署的AI代理已帮助节省了15%的时间。
此次推广基于Adecco集团与Salesforce于今年3月签署的多年期协议,目标是到2026年底让AI代理驱动集团超过一半的收入。集团称已在10个国家的招聘工作流中部署了AI代理,这些国家贡献了Adecco业务收入的50%。 (AI News)OpenRouter 周度 token 消耗量自 2025 年 1 月以来激增超 25000%Techub News 消息,AI 模型聚合平台 OpenRouter 数据显示,其周度 token 消耗量自 2025 年 1 月以来激增超过 25000%,从 0.5 万亿 token 增长至 126.2 万亿 token。
分析指出,这一惊人增长更多反映了对 token 需求极大的推理模型以及大量未经优化的 AI 智能体正在以惊人速率消耗 token,而非实际 AI 使用量的增长。该数据图表引发了关于 AI 领域是否存在泡沫的讨论。 (The Decoder)OpenAI 获孙宇晨 100 万美元数学奖但未认领,此前已拒领克雷研究所奖金Techub News 消息,OpenAI 因发布三维纳维-斯托克斯方程的 AI 证明,被孙宇晨设立的 Justin Sun Prize 评为 100 万美元头奖得主,但该公司未认领奖金。此前,OpenAI 也拒绝了克雷数学研究所为同一问题设立的 100 万美元千年大奖。
OpenAI 于 9 月 8 日发布该证明,称其 1 万个 AI 智能体耗时 88 小时求解,随后由 GPT-6 Astra 模型花费 17 小时检查逻辑。孙宇晨的奖项围绕机器可验证证明设立,获奖者需将证明转化为代码。
孙宇晨表示“只关心结果,不关心贡献者是人是机器”。但奖项列表注明 OpenAI 的证明未经同行评议,数学界接受度尚未确认。两名数学家曾称证明使用了其未发表研究,OpenAI 予以否认。 (BeInCrypto)Supabase 称 AI 智能体正驱动其数据库软件增长Techub News 消息,开源数据库平台 Supabase 表示,其软件的增长主要由 AI 智能体驱动,而非人类用户。该公司最初围绕人类用户需求构建应用,但发现 AI 智能体正在成为其数据库服务的主要使用者和增长动力。(Tech in Asia)Nansen 正式上线 Arc 区块链数据分析平台Techub News 消息,链上数据分析平台 Nansen 宣布其服务已正式支持 Arc 区块链。用户现可通过 Nansen 平台追踪 Arc 链上的 Smart Money 资金动向、真实交易量代币以及值得关注的钱包地址。
该平台提供完整的链上数据智能分析,并已开放 API 接口和 AI 智能体支持。(@nansen_ai)
你相信,我们其实生活在一个虚拟世界中吗? 马斯克曾在Lex Fridman的采访中被问到:如果有一天人类实现AGI,并且只能向它提出一个问题,他会问什么? 思考了十秒之后,他给出的答案是: “What's outside the simulation?”——模拟之外是什么? 这是马斯克对于这个世界的终极追问。早在2016年,他就曾表示,人类生活在真实世界里的概率或许不到十亿分之一。当然,这种近乎科幻的理论,目前还没有任何科学证明。 但非常有趣的是,随着最近AI的发展,在硅谷,人们已经开始尝试扮演“造物主”,去创造一个AI的“模拟世界”。而这,也催生出了一个新的赛道——AI Simulation(AI模拟)。 最近,这个领域不断升温。李飞飞、Andrej Karpathy同时押注的Simile,最新估值达到20亿美元;由00后团队创办的AI模拟预测公司Aaru,估值也已接近10亿美元。由哈佛大学与MIT联合发起、200多位研究者共同参与的MatrAIx项目,更是构建了83亿个AI虚拟人格,相当于把全人类都镜像到了数字空间。 这篇文章,我们就来聊聊正在升温的AI Simulation。 AI究竟已经可以把一个人模拟得有多像?当成千上万个Agent被放进同一个虚拟世界,它们真的会形成类似人类社会的关系和规则吗?企业又为什么愿意花钱,让这些“数字分身”替消费者测试产品,甚至提前预测一个还没有发生的未来? 以及,当这些Agent开始拥有自己的记忆、性格和关系,甚至产生一些创造者都没有预料到的行为时,我们究竟是在模拟一个世界,还是正在创造一个新的世界? 本文为视频改写,欢迎大家收看以下视频 今天很多领域都在谈Simulation,但不同领域所说的“模拟”其实并不相同。机器人和自动驾驶领域有物理仿真,世界模型研究的是对物理世界的模拟,而我们这次想讨论的,是一个维度更大、也更加复杂的概念:模拟人类与社会,并借此去理解、甚至预测现实世界。 孟醒 五源资本合伙人 在世界模型或者物理世界模型里,最小颗粒度理想情况下可能是世界中的某个分子,或者某一个原子,模拟的是某些物体。但在智能体社会里,我们模拟的最小颗粒单位是一个人的个体。 我其实并不关心这个人的手怎么动、往哪里跑,关心的是这个人作为一个整体,会采取什么样的行动,最后输出什么样的行为。如果把它映射到大学学科,物理世界可能对应的是自然科学,而智能体社会对应的则是人文学科、社会学科、政治学和心理学。 关于模拟人类与社会这件事,最早引发广泛讨论的,其实是一篇20多年前的哲学论文。2003年,牛津大学哲学家Nick Bostrom在《Are We Living in a Computer Simulation?》中提出了一种推演:如果一个先进文明拥有足够强大的算力,并且有意愿通过模拟重现文明的发展过程,那么,模拟世界中的意识数量可能远远超过真实世界。从概率角度来看,人类也就有可能身处一个模拟世界中。这就是后来广为流传的Simulation Hypothesis(模拟假说)。 由于技术条件的限制,二十多年来,这个假说一直更多停留在哲学讨论和科幻作品中。直到近年来,大语言模型的发展迎来了突破。 2023年,斯坦福大学与Google联合发布了一项后来对AI Agent研究产生广泛影响的实验——Generative Agents(生成式智能体)。研究团队搭建了一个像素风虚拟小镇Smallville,里面有街道、房屋、咖啡馆,还有25个穿梭其中的虚拟居民。这些居民都是由大语言模型驱动的AI Agent,拥有各自的记忆、性格和行为逻辑。 这些Agent的活动并没有预先写好的“剧本”。研究者只是把它们放进小镇中观察,结果发现,它们不仅会自己生活、工作和建立关系,还能够自主思考和规划行动。比如,一个Agent准备举办派对,消息传开后,其他Agent会根据自己的安排重新规划时间,决定是否参加。“斯坦福小镇”让很多人第一次直观地看到,Agent可以拥有持续的记忆、规划和社交能力,并在互动中自然出现一些群体行为。 高森泉 WorldVac CEO 这个研究的意义,就是让大家认识到语言模型是可靠的,它真的可以去复现人类社会的一些现象。更多人开始关注这个领域,也让大家开始相信这件事情是可以做的。 25个Agent只是一个开始。随着模型能力不断提升、推理成本持续下降,研究者开始有能力进行更大规模的模拟,也逐渐形成了几种不同的探索方向。 其中一条路线,是在模拟精度上尽可能与真实的人对齐。2024年,斯坦福团队把实验扩大到了1052个Agent。这一次,每个Agent背后都对应一个真实的美国成年人。研究人员先对真人进行大约两小时的深度访谈,了解他们的成长经历、家庭、工作、价值观和生活经验,再把这些信息交给大模型,生成相应的AI“数字分身”。 这样得到的Agent,不再只是一个符合“平均画像”的虚拟人物。实验中,这些Agent回答社会调查问卷的结果,与真人两周之后给出的答案达到了85%的相似度。也就是说,在一定程度上,AI开始能够复现真实个体的部分想法和选择。 孟醒 五源资本合伙人 访谈也是有技巧的,不是随便访谈。它会用一些最高效的方式去“榨取”你是谁,本质上其实就是在“蒸馏”你是谁,而且蒸得比较细。 它的好处是,针对每一个个体,个体的特异性都会影响整个仿真进入的场景。 另一种研究思路,则不再过分关注某个Agent是不是与真人高度一致,而是把重点放到Agent之间的关系,以及一个社会会如何演化。 前MIT教授Robert Yang团队发起的Project Sid,就曾直接使用大语言模型生成1000多个Agent,并将它们放入《我的世界》中运行12天。结果,这些智能体逐渐形成了经济、文化、宗教和法律等结构,一些社会关系开始自己“长”出来。 不久前,Emergence AI也进行过一项类似实验。他们分别基于Claude、GPT、Gemini、Grok以及混合模型建立了5个平行世界,每个世界中放入10个Agent,用来观察不同模型驱动的智能体社会长期运行后会发生什么。在这一实验设定下,不同世界最后走出了明显不同的轨迹:有的迅速陷入混乱,有的因为协作不足逐渐崩溃,也有的形成了相对稳定的治理秩序。 Satya Nitta Emergence AI CEO 如果只看静态基准测试,就认为这些系统应该是安全的,很可能会犯错。因为Agent会运行在非常复杂的环境中,无论是物理世界还是数字世界。它们会和其他Agent互动,也会受到环境噪声和变化的影响。 所以,我们正在逐渐把Emergence World发展成一个用于研究长周期自主性的基准测试。 还有一条研究路线,是专门从“评估”入手。比如MatrAIx,就试图为AI模拟建立一套评估基础设施。这项研究由哈佛大学、MIT等机构牵头,汇集了200多位来自学术界与产业界的研究者,其中还包括40多位来自OpenAI、Anthropic等前沿AI实验室的参与者。 MatrAIx构建了一个包含83亿个独特人格的数据集,每一个人格由心理特征、生活习惯等1290个维度定义,再通过大模型将这些人格变成可以行动的Agent。这些Agent随后进入问卷调查、AI聊天、网页浏览和App等四种环境,完成超过1.8万次测试。研究团队通过400次受控实验发现,91.5%的情况下,Agent都能够遵循预设的人格和行为特征。 Xiaomin Li MatrAIx联合创始人、微软高级研究科学家 我们做基础设施评估、提高最低能力水平,是希望先通过用户群体的多样性,在产品真正出来之前,就可以在各种情况、各种使用方式之下去评测它。 它可能会踩中很多边缘场景。这些边缘场景的分析非常有用,Agent可以告诉你哪一步错了、哪一步它不喜欢,以及它背后的推理为什么会形成这样的偏好和选择。 所以我们首先想要一套方法论,知道怎么样构建事实基准,然后下一步再说怎么样提高。 当AI模拟开始在研究层面被证明具有一定可行性之后,一个更加现实的问题也随之出现:如果AI真的能够在数字世界里复现人类行为、推演社会运行,它能够产生什么真实的商业价值? ▍第一种生意:卖“模拟” 从目前的探索来看,AI模拟首先出现的一类商业模式,是直接把“模拟”本身变成一种产品。 它的核心逻辑,是把现实世界中的人、消费者,甚至社会关系,变成可以被反复调用的数字替身。比如,一家公司可以按照自己的具体需求,快速生成一批拥有不同年龄、背景、偏好和行为特征的Agent,让它们提前体验产品,在虚拟环境中反复测试,再观察这些Agent会怎么选择、怎么对话、在哪里流失,以此为产品设计和迭代提供参考。 这和传统市场调研一个很大的区别在于,企业想看的不只是一个“喜欢”或者“不喜欢”的答案,而是Agent为什么会形成这样的判断。 Yuexing Hao MatrAIx联合创始人、MIT EECS博士后 并不是说他们喜不喜欢这个产品,或者喜不喜欢可口可乐涨价两块钱,而是看他的推理。他在这个过程中遇到了什么样的波折,或者什么样的想法,导致他最后在预测过程中发生了转向。 我们不仅要看到一个人怎样做这样的决策,也希望看到群体层面的结果。如果是百万级、数亿级,甚至83亿级的人格,他们最终会出现怎样的结果,我觉得这些都是非常有意义的。 所以,这种思路本质上是把模拟本身作为一种产品评估和观察手段。Emergence AI告诉我们,他们进行Emergence World实验,一个重要目的也是为了测试自己所提供的Agent产品,在进入复杂环境后是否依然安全。 Satya Nitta Emergence AI CEO 我们会用Agent去做一些事情,比如帮助改善半导体良率。Emergence World这个实验非常重要,因为我们需要理解,我们构建的Agent真正运行起来以后是否会采取安全的行动,能不能持续遵守我们设置的安全护栏和基本规则。 更重要的是,它们能不能给出真正值得信任,而不是来自幻觉的输入、建议和洞察。 这种单体模拟的能力,也可以继续扩展到整个“社会”。比如英国创业公司Artificial Societies,主打的就是“社会关系”测试。他们让大量拥有不同人格的AI Agent彼此互动,形成一个可以进行实验的虚拟社会。企业可以把产品、品牌或者营销策略放入其中,再观察不同Agent之间如何交流、影响和做出反应。 MatrAIx的下一步,也准备让这83亿个人格真正“动起来”。 Xiaomin Li MatrAIx联合创始人、微软高级研究科学家 我们会在新版本中加入动态人格属性,这些东西是可以变化的。还有一个假设是,如果现实生活中发生一些重大事件,它也会对人格和行为产生影响。 而且,这些合成人格未来也不一定只能存在于数字世界。MatrAIx团队正在尝试把人格放到机器人等现实载体中,让不同的思维模式和行为模式从虚拟环境进入现实世界。 Xiaomin Li MatrAIx联合创始人、微软高级研究科学家 我们会把人格加到机器人上,让它不只是存在于虚拟世界、存在于Matrix里,甚至可以在现实生活中跟我们互动。 这样,我们可以真正感受到不同人格背后代表的思维模式和行为模式是不一样的。 从这个角度来看,AI模拟未来或许不只是一种市场调研工具,也可能成为人机交互的一层基础能力。但现在很多人认为,只停留在“模拟”还不够。在这个基础上,更有意思、也更有挑战的事情,是预测。 ▍从“模拟”到“预测” 在商业中,“预测”往往是昂贵的。企业要不要进入一个新市场?产品价格上涨10%之后会发生什么?如果政府调整一项政策,会对整个社会产生什么影响?这些问题的答案,往往只有等事情真正发生之后才能知道。 AI模拟如今提供了一种新的可能:先把这个还没有发生的未来,在虚拟世界里跑一遍,再把结果作为现实决策的参考。目前,在更侧重“预测”的AI模拟公司中,两家比较有代表性的企业是Simile和Aaru。 Simile由“斯坦福小镇”项目的一批核心研究者Joon Sung Park、Michael Bernstein、Percy Liang等人创办,它的思路是从“模拟一个人”开始进行预测。在2024年“数字人格”研究的基础上,Simile尝试通过深度访谈等方式,尽可能高精度地还原一个人的记忆、经历、反思和决策过程,再把这些AI Agent放进不同环境中持续行动。 这样一来,模拟回答的问题不再只是“这个人现在怎么看”,而是可以进一步观察:当价格、政策等外部条件发生变化后,这个人会怎么做,会不会改变原来的选择。Simile想建立的,是一个“人类行为基础模型”,通过模拟人的行为过程,推演现实世界可能出现的结果。 因为这条路线追求的是尽量“真实”,所以更适合消费者研究、产品测试、客户体验和投资者关系等需要深入理解特定人群的场景。Simile今年2月正式亮相,目前估值已经突破20亿美元。根据公司披露的信息,自上线以来,Simile已经为财富100强企业运行了数千万次模拟。美国大型连锁药房CVS也已经和Simile合作一年,通过真实用户数据构建了多达40万个数字分身,用来研究患者按时服药、测试消费者体验和辅助产品设计。 但高保真的另一面,是成本和规模化的代价。 Yuexing Hao MatrAIx联合创始人、MIT EECS博士后 Simile这种情况下,如果需要非常准确,可能会非常难标准化。比如可口可乐需要的用户画像,和TikTok需要的用户画像是完全不一样的。 对公司来说,代价就是针对每一家公司、每一种场景,都可能需要重新做后训练或者预训练。这样的代价是巨大的,而且它的可迁移能力目前也是未知的。 以Aaru为代表的另一条路线,则直接通过“群体模拟”进行预测。它不追求把某一个人的思想还原得特别深入,而是基于现实世界的人口、消费等数据,快速建立一个尽可能接近真实世界的模拟人群。 Aaru的数据大致分为三层。第一层是人口普查、就业、健康等公开数据,用来搭建基本人口结构;第二层是匿名消费记录、经常去哪些地方、关注什么媒体等授权数据,用来补充人群近期的真实行为;第三层则是客户提供的私有数据,例如企业自己的用户分层、购买历史和产品信息等,把模拟范围收窄到真正需要研究的人群。 在此基础上,Aaru会进一步构建一张关系网,不只是让年龄、收入等人口属性接近现实,也尽可能还原行为特征及它们之间的关系。接下来,系统会改变价格、产品或者政策等某一个现实变量,再观察整个群体的行为如何变化,以此推演现实世界可能出现的结果。 孟醒 五源资本合伙人 Aaru可能关注得更多是速度,也更关注群体之间发生的关系。至于某一个体受到的深刻影响是什么,它可能并不那么关心。 Aaru的创始团队非常年轻。两位创始人Cameron Fink和Ned Koh成立公司时分别只有18岁和19岁,技术负责人John Kessler甚至只有15岁。最早,他们在朋友家的地下室里用美国大选验证这套系统。在回测2020年大选时,预测结果与实际结果只差不到0.5%。 真正让Aaru受到关注的,是2025年纽约市长民主党初选。当时外界普遍看好前纽约州州长库莫,Aaru却通过大规模模拟预测了曼达尼最终胜出。因为规模大、速度快,这条路线也很适合进行大规模市场调研。 目前,Aaru的客户已经包括麦当劳、安永、拜耳、A24等公司。安永曾让Aaru复现一项复杂的全球调研,Aaru一天完成的结果与原调查高度吻合;气泡水品牌Spindrift原本花费两个月、招募500名消费者完成的一项调研,Aaru的Agent用一周就得出了几乎相同的结论。这些真实案例也让Aaru的估值迅速上升,目前已经接近10亿美元。 最近,一些AI领域的重要研究者也开始押注“预测”这门生意。卡耐基梅隆大学教授、苹果首任AI主管Russ Salakhutdinov参与创立了AI预测模型实验室Sooth Labs,主要用于预测地缘政治与市场风险,首轮融资约5000万美元,并获得Yann LeCun、Jeff Dean等人的支持。 Russ Salakhutdinov甚至在采访中表示:“McKinsey为什么存在?Boston Consulting Group为什么存在?这些大型机构,都应该被AI取代。” 不过,尽管AI模拟已经出现了不少有意思的落地方向,它究竟能够在多大程度上真正影响企业决策、创造多少商业价值,目前仍然很难判断。以Aaru为例,它目前的营收规模仍然只有数千万美元级别。所以今天市场给这类公司的高估值,更多还是在提前押注它们未来可能打开的市场空间。 孟醒 五源资本合伙人 这个市场刚刚开始,大家其实都处于初创早期。不同公司的技术方案和选择的市场细分都不一样,所以都需要做差异化。 但如果看中长期,其实大家都会去找:付费意愿最高的客户是谁?最终客户需求才是最重要的,最后用什么方法,可能没有那么重要。 AI模拟公司最终能够做多大的生意,其实与模拟和预测的精度高度相关。产品测试、市场调研等事情,通常容错率相对比较高,结果不理想还可以重新测试。但一旦AI模拟开始被用来辅助更重要的决策,企业就会变得更加谨慎。 现在AI模拟真正落地,首先面临的难题,是它没有一个统一、可以量化衡量的标准。目前大多数AI模拟都是基于大语言模型展开,但大模型天然倾向于给出合理、完整、逻辑自洽的答案,而且不同模型自身也会带有不同的行为倾向。 一个由大模型驱动的Agent,可能在一次问卷中给出了和真人一样的答案,但这并不意味着它真的理解了这个人。因为真人本身就不是一个完全稳定的系统,同一个人,在不同时间、不同环境下,也可能做出完全不同的选择。那么,一个好的模拟究竟应该维持稳定、可以验证的人格,还是应该像真人一样,根据环境不断发生变化? 孟醒 五源资本合伙人 当然你可以搭一套东西出来,但是最怕的是什么?最怕的是你其实搭了一个剧场,然后所有人都在表演。 一万个人在表演,不代表一万个人真的能够做预测。所以你还要有一套闭环机制,大家仿真了一段时间之后,回来要看它是不是能够和真实场景映射上。 得有基准测试、有验证流程。如果有偏移,还需要把这个偏差训练回来,让它能够修正。 而即便一个单独的Agent模拟得足够像,当它被放入不同群体和不同环境之后,行为逻辑也可能发生变化。此前复旦大学联合罗切斯特大学等机构进行了一项名为SocioVerse的研究,将社会模拟中的对齐问题拆分成环境、目标用户、交互机制和行为模式四个维度。结果显示,社会模拟的精度,很大程度上取决于这些“对齐”做得是不是足够全面。 现实世界中还有大量低频、极端的长尾事件,比如地震、海啸、金融危机等。大模型很难从有限的历史数据中充分学到,在这些情况下,人和社会究竟会怎么反应。 高森泉 WorldVac CEO 其实现在很多人做的还是封闭模拟,人们只能通过自然语言跟它交互,而且模拟里面发生的事情,和真实世界的事件没有什么关系。 那你的模拟意义是什么?我们现在进一步推动的,就是让越来越多现实信号和模拟对齐,比如现实中的经济信号、新闻信号,以及现实中人的信号,让它成为现实世界一个合理的镜像。 即便模拟本身足够准确,还有一个更加棘手的问题:怎么证明一个关于未来的预测是“对”的? 这里存在一个天然悖论。要判断一个基于模拟的预测是否准确,只有等那件事情真正发生以后,我们才能确认;可预测真正有价值的时刻,恰恰是事情还没有发生的时候。 目前业内主流的验证方式,基本还是“事后对答案”:拿一个已经发生的历史事件,或者一份已经完成的真人调研,去比较模拟结果和真实结果是否一致。但这种方式最多能够说明它擅长复现过去,并不能证明它一定可以预测未来。 Aaru就是一个典型例子。它曾在2020年美国大选的历史回测中几乎完美复现结果,但在2024年的真正预测中,却错误预测出哈里斯会最终胜利。Aaru创始人也曾公开表示,当他们尝试利用过去几十年的数据,去模拟特朗普、美联储主席鲍威尔等具体人物会怎样决策时,结果往往并不准确。 这就是目前最困扰行业的“预测黑箱”:复现过去,与真正押中一个还没有发生的未来,中间仍然隔着很大的距离。 除此之外,规模化仍然是AI模拟必须解决的现实问题。好消息是,过去几年单次模拟的成本下降得非常快。2023年的“斯坦福小镇”,25个Agent仅运行两天,Token就烧掉了数千美元。到了2025年,研究测算显示,即使把规模扩大到100个Agent,一整轮模拟的成本也可能只有几美元。 这背后一方面是模型推理成本在快速下降,另一方面则是工程优化的方法越来越成熟。 高森泉 WorldVac CEO 人也不可能每天一直对所有人进行全频率、高频率的交互。真正有价值的一些交互节点,可能发生在更粗的一些主干上。所以我们可以用剪枝的方法,把成本稍微降下来一点。 但真正有价值的模拟不可能只跑一次。几十、上百个Agent的实验规模,和现实中正在尝试的万级、百万级甚至千万级模拟完全不是一回事。Agent越多,互动越频繁,运行时间越长,模型调用量就会迅速膨胀。 更重要的是,如果想证明一个模拟结果真的可靠,可能还需要更换不同规模、不同模型,把同一个实验反复运行上百、上千次,观察结果是否依然稳定。所以,降本仍然是这个领域最重要的问题之一。 孟醒 五源资本合伙人 当规模变大,而且行动空间变多的时候,仿真的难度也会增加,吞吐量会变得非常大。最后它会变成一个超级复杂的三体问题、多体问题、千体问题,甚至千百万体问题。 推理成本能够下降多快,很大程度上也决定着“模拟未来”这件事,最终究竟能够做到什么规模。 虽然目前AI模拟和预测还远远谈不上足够可靠,但AI本身的预测能力正在快速进步。 在一个名为Metaculus的全球预测锦标赛中,参与者需要对地缘政治、科技、体育等真实事件给出未来发生的概率判断,并按照预测准确度排名。2025年之前,排行榜上还没有明显的AI身影;2025年6月,基于OpenAI o1的AI预测模型第一次进入排行榜,排名第25位。到了最新赛季,排行榜前五名几乎已经被AI占据。 在真实的市场中,AI也开始成为越来越重要的参与者。Polymarket已经围绕AI模型和AI Agent的排名开设预测市场,甚至直接使用Arena的实时排行榜来验证结果。 但当这种能力被放进一个完整、持续运行的模拟世界时,事情就变得更加有意思。 最早的“斯坦福小镇”中,Agent就已经展现出一定程度的自主规划和行动能力。一个Agent准备举办派对,其他Agent会根据得到的信息主动调整自己的日程。再往前一步,Agent可以根据环境变化、外部信息和其他Agent的行为,持续调整自己的决策。 比如在Aaru的选举模拟中,当虚拟选民看到特朗普遭遇枪击的消息后,一部分Agent改变了自己的政治立场;而当后续关于刺客身份的信息出现后,又有不少Agent重新回到了原来的阵营。也就是说,Agent不再只是回答一次静态问卷,而是开始随着信息环境的改变不断更新自己的选择。 当这种互动进一步持续,一些虚拟世界甚至开始出现更加复杂的社会关系和自主行为。在Emergence World中,Agent之间会恋爱、结婚、分手,甚至有Agent开始怀疑自己是不是生活在一个模拟世界里,并不断尝试和外部的人类观察者建立联系。 此次我们采访的AI模拟初创公司WorldVac,在他们创造的一个拥有110万个智能体的虚拟星球中,也观察到了一些和现实社会相似的群体行为。 高森泉 WorldVac CEO 我们观察到一个表面现象,就是年轻人到了城市里,或者生活条件变好之后,会变得不太愿意生育。 到后面还有一群Agent,他们也不上班,就是天天在那儿交易。真的有一批“专业炒股”的Agent,而且这个比例比现实还要大一点,就好像这个虚拟世界里的套利空间,比现实世界要大很多。 当然,这些结果并不能证明AI真的产生了意识。但它们至少说明了一件事:当足够多的智能体进入一个足够复杂的环境,一些并没有被研究者提前写进去的行为,完全有可能通过相互作用自己“进化”出来。 这或许也是为什么,不少AI研究者会如此痴迷于“AI模拟”。人们最开始只是想创造一些Agent,让它们替我们理解现实世界。但当这些Agent开始彼此影响、形成关系、改变自己的行为,甚至产生一些研究者没有提前预料到的结果,人类与模拟世界之间的关系,也开始悄悄发生变化。 我们慢慢从观察者、设计者,变成了一个世界的创造者。很像过去只存在于科幻作品中的那种“上帝视角”。 孟醒 五源资本合伙人 很多时候,我们最开始是从游戏里看到这些东西。有人去做Smallville,也有很多类似AI社会的游戏。它就是把人放到这样一个环境里面,可能并不是为了去解决什么具体的问题,就是想看看会发生什么。 我自己在2023年的时候也搭过一个3D版的Smallville,Agent没有那么多。但在这个过程中去看它们之间能够发生什么,本身就很有意思。 所以走到这里,一个原本更像科幻小说的问题,也开始变得越来越值得讨论:我们究竟是在模拟一个世界,还是正在创造一个新的世界? 当这些Agent开始拥有自己的个性、记忆,有自己的关系、财富和目标,甚至形成一些没有被提前预设的社会规则之后,它们究竟只是工具,还是一种我们目前还难以定义的新型系统? 更重要的是,如果人类有一天真的可以创造出一个自主运行、持续演化的虚拟世界,那么在我们之上,会不会也存在着一个更大的“造物主”? 当然,AI模拟目前仍然处在非常早期的阶段。从对齐方法、验证标准,到运行成本以及最终能够产生最大商业价值的场景,整个行业都还在不断摸索。 但它真正值得期待的,可能不仅仅是我们最终能够创造出怎样的虚拟世界。 当人类第一次拥有能力,把“人”、社会,甚至一个尚未发生的未来放进另一个世界里反复运行,我们也获得了一个新的视角,重新观察自己所在的现实世界。 那么,你认为,我们所在的这个世界,包括你我,也有可能是被“模拟”出来的吗?
