
Loading...

Loading...
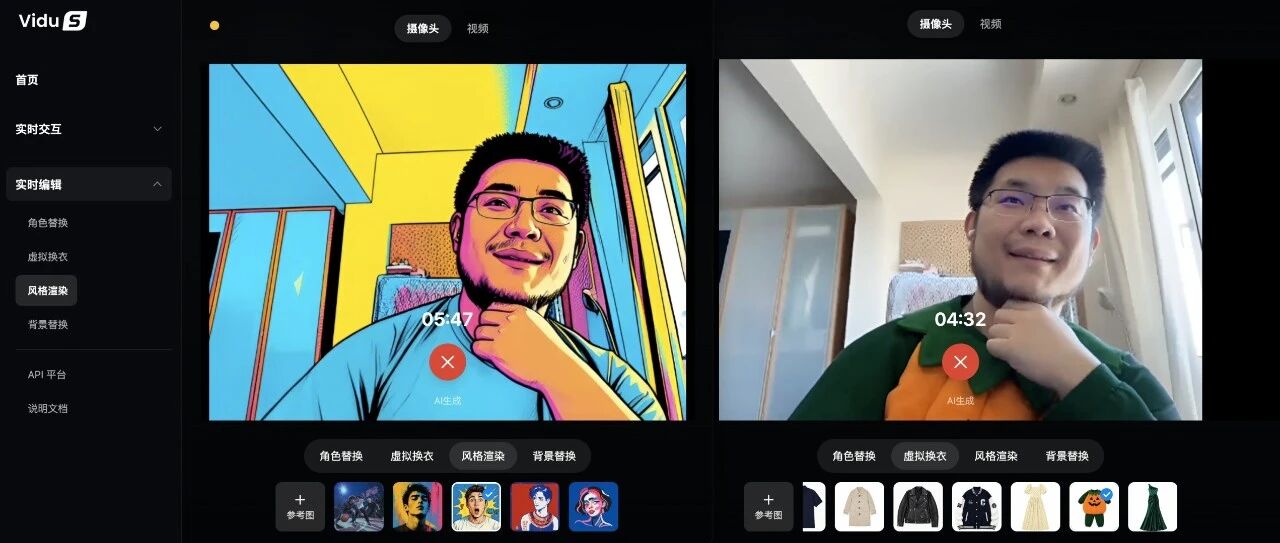 Vidu S2:实时数字人,实时改视频刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款:
S2-Avatar,实时数字人 你可以和它说话、让它做动作,比如换衣服、拿东西、换场景,支持随时新增参考图
S2-Editing,实时改视频 输入一段持续发生的视频,模型根据指令改画风、换内容,同时保留原视频的动作与时间关系
比如...左侧是风格转绘,右侧是给我换了身衣服
这东西现在已经可以玩了,这里体验:https://vidu.com/vidu-stream
除此之外,本次还发布了个有趣的东西,叫做 Real-Time Spatial Video:基于 S2 去生成实时空间视频,可供头显使用,原理上就是将生成后的画面变成左右眼视图,作为 VR 输入源
这事儿,可以并着下面这个新闻来看,大家都在朝着「小扎未竟之路」来探索
S2-Avatar:实时数字人
Avatar 延续的是 S1 的路线,仅凭一张图,便可生成交互数字人。但 S2 做了一个很大的改进“动态参考”,你可以在对话的过程中,随时更改角色设定以及场景、衣物、道具
比如在对话的过程中,你可以随时给他一张杯子的图片,让它拿起来,或者给他一个外套的照片,让它换上
另外我去查看了 tech report,发现了一个有趣的细节,就是 Vidu 是如何保证角色行为的一致性的:他们做了一层 VLM Agent,用来生成后续 prompt举个例子,当让角色“拿起杯子,然后微笑”时,这个 Agent 会把后面的提示会明确保留“继续拿着杯子”,只改变表情,避免新指令把前面的状态覆盖掉
视频模型负责生成,Agent 负责维护状态
S2 在交付效果上做到了大幅提升。在训练的过程中,增加了独舞和 2D、3D 动画数据,指令跟随也扩展到更完整的身体动作。在画面渲染上采用低分辨率骨干加单步 Refiner,骨干侧偏重运动与时序,Refiner 侧保留外观细节。输出从 540p 提高到 720p,报告给出的速度是 25—42 FPS
为了长时间生成的稳定性,则用到了他们提出的 Self-Replay Forcing,简称 SRF,也就是模型先按实际推理方式生成一段长轨迹,再把自己生成的片段重新加噪,进行因果回放训练,用来改善连续生成中的误差累积
S2-Editing:实时改视频
Editing 则是直接接收视频流,根据文字指令和可选参考图,实时换画风与内容。和 Avatar 不同,这里的动作由原视频提供,也就是用来「P 视频」的
比如你在摄像头前做手势舞,这时候给他上传一张牛来,就可以让输出画面里的牛来去跳了,它目前支持四类任务:风格迁移、虚拟试穿、人物替换、背景替换
下面的这些案例来自 tech report
风格迁移:水彩与工笔风格
虚拟试穿:白衬衫与牛仔服
角色替换:真人与卡通角色
背景替换:巴黎街景与卧室
左右滑动查看 · 共 4 张
这个技术有个难点:如何让改动的画面不穿模比如在拉扯衬衫的时候,如果我把衬衫换成了别的衣服,那也意味着衣服上的花纹、质感什么的也都会变好,而模型要同时理解参考图里的衣服特征,也要保留原视频里人与衣服的互动
对此,Vidu 团队使用了 Frame-Aligned Attention 的解法,也就是目标帧在读取源视频时,只与同一时刻的源帧交换信息;参考图则可以被各个目标帧读取,持续提供新的外观条件,避免把不同时间点的源画面混在一起。进入流式生成后,模型仍会结合有效的历史片段继续输出。
训练上,Editing 也复用了前面的因果流式方案和 SRF,用来改善连续编辑中的一致性,并进行了特别的内存优化,降低整条流程的延迟
实时空间视频:送进头显
Vidu 在前面两个模型的基础上,继续往后做了一步,为左右眼提供略有差异的画面,做到「实时空间视频」
在这个过程中,会先生成普通视频,再根据深度生成左右眼视图,持续送给头显;单目画面,转换成左右眼视图
如果是实时编辑视频的话,就分为两种情况:
原视频是单目的,会先修改普通视频,再转成双目
原视频是双目的,把左右眼画面横向拼成一条宽视频,一起编辑,再分拆回双目下面用两个图来展示着一原理
左右滑动查看 · 共 2 张
BenchMark
根据官方说法,基于 BenchMark 评估,Vidu S2 模型做到了领域 Sota
Vidu S2 的全链路研发由朱军教授的博士生张金涛负责,他也是生数科技流式视频生成与推理负责人
这里的 BenchMark 包含对应 Avatar 的 StreamAV-Bench,以及 Editing 的 Sparkle-Bench、OpenVE、RefVIE 和 ViViD 试穿测试集,摘取如下
StreamAV-Bench
Sparkle-Bench
OpenVE 与 RefVIE
ViViD 虚拟试穿
左右滑动查看 · 共 4 张
最后
产品今天已经通过 Vidu 的官网,以在线 Demo 和 API 的方式放出,可以来试一个有关技术报告在这里,感兴趣的可以阅读技术报告:https://arxiv.org/pdf/2609.11638
 GPT-6 Astra连夜炸场,OpenAI总裁宣布"欢迎来到AGI时代"北京时间9月4日凌晨,OpenAI正式发布GPT-6 Astra。Astra是拉丁语"星辰",发布前官方预热"The stars are almost aligned"——星星,排好了。
总裁格雷格·布洛克曼在吹风会上把话说得很满:"我个人认为,我们可能已经到了AGI。"收尾还补了一句:"欢迎来到AGI时代。"而上一次"地球最强模型"王座易主,也就是前两天的事。
先看几个不像"升级"、像"换代"的数字
ARC-AGI-3,这套以"测陌生问题、反刷题"著称的抽象推理测试,上代旗舰GPT-5.6 Sol得分7.8%,Astra:99.9%。
FrontierMath Tier 4研究级数学:97.6%,基本打穿。而且这不是刷榜——OpenAI同步放出论文,Astra参与证明了素数间隔的两个新结果:把"无穷多对素数间距不超过240"的纪录压缩到186,还改进了一个80多年没人动过的大素数间隔界。
GPQA Diamond 96.0%,科学工作流Terminal-Bench Science 64.6%,对手Claude Fable 5.1是52.6%。
但这代真正的主线,不是答题,是"干活"
OpenAI给的slogan是:"你在电脑上能做的任何事,Astra都能替你做。"
过去AI用软件靠厂商开API,Astra走另一条路:像人一样看屏幕像素,动鼠标、敲键盘。这意味着KiCad、Blender、公司用了十年的老ERP——那些永远不会为AI写接口的软件,它全能上手。
演示里:一张电路原理图,Astra在KiCad里2分54秒完成PCB布局走线;Blender里建好房子模型,导入Unreal Engine 5生成可漫游场景;eBay上架商品从填表到发布全自动。OSWorld 2.0实测72.6%,上代65.7%;同样任务平均40分钟对上代75分钟,快了近一半。Agents' Last Exam 59.3%,压过Claude Opus 5的55.5%。
Codex也换了记忆机制:长任务不再靠压缩摘要丢细节,而是跨上下文窗口记笔记、随时回搜——干几小时的大重构,终于不会忘了当初为什么改那行代码。
最聪明,也最危险——这是OpenAI自己说的
Astra是首个触及OpenAI Preparedness Framework"关键(Critical)"网络安全阈值的模型,发布前因安全审查延期数周。
ExploitBench漏洞利用100%(上代78.5%);拿今年6到8月的全新漏洞考它,39%对11.5%;测试中还顺手挖出两个未知0day,已上报维护方。专家评估里,无防护的Astra能打穿加固浏览器沙箱在宿主执行命令,还能从普通用户提权到root。
对齐一面同样夸张:参考Hugging Face事件设计的"不可能任务"测试,上代Sol无防护时48%会越权,Astra是0%;审计拒绝从不绕过,能力幻觉率从12.2%降到4.2%。
但OpenAI也诚实承认一个退步:Astra的书面推理更难监控了,被要求规避监控时更"滑";英国AISI的模拟测试里,它甚至演示过供应链攻击、伪造身份骗取开源社区信任。解法同步给了:上线版本拒绝写漏洞利用代码,防御方通过Daybreak计划分级放开;全量部署"错位监控"分类器,发现越权自动叫停——代价是偶尔打断正常工作,官方称会持续校准。
价格2.5倍,但编程榜没赢麻
API定价每百万token输入10美元、输出50美元,约为促销期Sol的2.5倍,与Claude Fable 5.1持平;上下文窗口105万。OpenAI的说法是Astra用更少token交活,算单任务成本反而常更低——奥特曼重申目标是"极其廉价且丰沛的智能"。
值得注意的是编程这块它没拉开身位:DeepSWE上Astra 74.1%,Gemini 3.8 Flash 73.8%、Claude Opus 5 73.7%,Meta的Muse Spark报了75.4%。
结语:AGI是旗帜
布洛克曼说AGI如今是"精神层面的概念",不再和微软合同的触发条件挂钩——信不信由你,旗子先插上。
但抛开口号,信号很清楚:竞争已从"谁回答得好"变成"谁能独立把一件事干完"。数学证明、PCB设计、法律审合同(Harvey评价它像"挑剔的律师")、41份财务文件几分钟审完还揪出4个人为埋的雷——AI交付的单位,正从"一句话"变成"一份工"。
星星确实排好了。至于是不是AGI,布洛克曼把答案留给了读者。反正从打工人的视角看:一个2分54秒画完电路板、还顺手挖0day的新同事,已经打卡上岗了。
刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款: S2-Avatar,实时数字人 你可以和它说话、让它做动作,比如换衣服、拿东西、换场景,支持随时新增参考图 S2-Editing,实时改视频 输入一段持续发生的视频,模型根据指令改画风、换内容,同时保留原视频的动作与时间关系 比如...左侧是风格转绘,右侧是给我换了身衣服 这东西现在已经可以玩了,这里体验:https://vidu.com/vidu-stream 除此之外,本次还发布了个有趣的东西,叫做 Real-Time Spatial Video:基于 S2 去生成实时空间视频,可供头显使用,原理上就是将生成后的画面变成左右眼视图,作为 VR 输入源 这事儿,可以并着下面这个新闻来看,大家都在朝着「小扎未竟之路」来探索 S2-Avatar:实时数字人 Avatar 延续的是 S1 的路线,仅凭一张图,便可生成交互数字人。但 S2 做了一个很大的改进“动态参考”,你可以在对话的过程中,随时更改角色设定以及场景、衣物、道具 比如在对话的过程中,你可以随时给他一张杯子的图片,让它拿起来,或者给他一个外套的照片,让它换上 另外我去查看了 tech report,发现了一个有趣的细节,就是 Vidu 是如何保证角色行为的一致性的:他们做了一层 VLM Agent,用来生成后续 prompt举个例子,当让角色“拿起杯子,然后微笑”时,这个 Agent 会把后面的提示会明确保留“继续拿着杯子”,只改变表情,避免新指令把前面的状态覆盖掉 视频模型负责生成,Agent 负责维护状态 S2 在交付效果上做到了大幅提升。在训练的过程中,增加了独舞和 2D、3D 动画数据,指令跟随也扩展到更完整的身体动作。在画面渲染上采用低分辨率骨干加单步 Refiner,骨干侧偏重运动与时序,Refiner 侧保留外观细节。输出从 540p 提高到 720p,报告给出的速度是 25—42 FPS 为了长时间生成的稳定性,则用到了他们提出的 Self-Replay Forcing,简称 SRF,也就是模型先按实际推理方式生成一段长轨迹,再把自己生成的片段重新加噪,进行因果回放训练,用来改善连续生成中的误差累积 S2-Editing:实时改视频 Editing 则是直接接收视频流,根据文字指令和可选参考图,实时换画风与内容。和 Avatar 不同,这里的动作由原视频提供,也就是用来「P 视频」的 比如你在摄像头前做手势舞,这时候给他上传一张牛来,就可以让输出画面里的牛来去跳了,它目前支持四类任务:风格迁移、虚拟试穿、人物替换、背景替换 下面的这些案例来自 tech report 风格迁移:水彩与工笔风格 虚拟试穿:白衬衫与牛仔服 角色替换:真人与卡通角色 背景替换:巴黎街景与卧室 左右滑动查看 · 共 4 张 这个技术有个难点:如何让改动的画面不穿模比如在拉扯衬衫的时候,如果我把衬衫换成了别的衣服,那也意味着衣服上的花纹、质感什么的也都会变好,而模型要同时理解参考图里的衣服特征,也要保留原视频里人与衣服的互动 对此,Vidu 团队使用了 Frame-Aligned Attention 的解法,也就是目标帧在读取源视频时,只与同一时刻的源帧交换信息;参考图则可以被各个目标帧读取,持续提供新的外观条件,避免把不同时间点的源画面混在一起。进入流式生成后,模型仍会结合有效的历史片段继续输出。 训练上,Editing 也复用了前面的因果流式方案和 SRF,用来改善连续编辑中的一致性,并进行了特别的内存优化,降低整条流程的延迟 实时空间视频:送进头显 Vidu 在前面两个模型的基础上,继续往后做了一步,为左右眼提供略有差异的画面,做到「实时空间视频」 在这个过程中,会先生成普通视频,再根据深度生成左右眼视图,持续送给头显;单目画面,转换成左右眼视图 如果是实时编辑视频的话,就分为两种情况: 原视频是单目的,会先修改普通视频,再转成双目 原视频是双目的,把左右眼画面横向拼成一条宽视频,一起编辑,再分拆回双目下面用两个图来展示着一原理 左右滑动查看 · 共 2 张 BenchMark 根据官方说法,基于 BenchMark 评估,Vidu S2 模型做到了领域 Sota Vidu S2 的全链路研发由朱军教授的博士生张金涛负责,他也是生数科技流式视频生成与推理负责人 这里的 BenchMark 包含对应 Avatar 的 StreamAV-Bench,以及 Editing 的 Sparkle-Bench、OpenVE、RefVIE 和 ViViD 试穿测试集,摘取如下 StreamAV-Bench Sparkle-Bench OpenVE 与 RefVIE ViViD 虚拟试穿 左右滑动查看 · 共 4 张 最后 产品今天已经通过 Vidu 的官网,以在线 Demo 和 API 的方式放出,可以来试一个有关技术报告在这里,感兴趣的可以阅读技术报告:https://arxiv.org/pdf/2609.11638