
Loading...

Loading...
 Alphabet CEO Sundar Pichai(桑达尔·皮查伊):AI 是搜索的非凡机遇,而非颠覆性威胁撰文:Techub News 整理
导语
2025 年 5 月,Alphabet 兼谷歌 CEO 桑达尔·皮查伊(Sundar Pichai)罕见地接受了 All-In Podcast 的深度专访。在长达一小时的对话中,皮查伊直面了当前市场对谷歌在 AI 浪潮中可能面临“颠覆者困境”的核心质疑。作为执掌这家科技巨头近十年的领导者,皮查伊的此次发声,不仅是对外界疑虑的集中回应,更是系统性地阐述了谷歌将如何利用其长达二十余年的技术积累——从基础设施到前沿研究——来驾驭并引领这场 AI 革命。本次对话涵盖了搜索的未来、AI 商业模式、芯片战略、能源约束、量子计算以及机器人等广泛议题,为我们理解谷歌在下一个十年的战略方向提供了关键窗口。
摘要
皮查伊坚信 AI 是搜索的“非凡机遇”,而非零和游戏的颠覆者,AI 概览(AI Overviews)等新功能正在扩大搜索的查询范围和用例。
谷歌的核心优势在于其全栈式技术积累,从 TPU 芯片、全球数据中心网络到跨领域的基础研究,这使其能在控制成本的同时持续推动模型创新。
面对 OpenAI、微软、Meta 等激烈竞争,皮查伊认为 AI 创造的将是一个比过去所有技术总和更大的市场,成功的关键在于持续创新和执行。
谷歌在量子计算、机器人(物理 AI)等领域进行长期、耐心的投资,视其为类似早期 AI 的基础性突破,预计未来 3-5 年将迎来关键进展。
皮查伊承认文化管理是持续挑战,近期重点在于重拾“使命聚焦”,激发类似谷歌早期创业阶段的强度与乐观精神,以应对 AI 时代的竞争。
AI 是搜索的进化,而非颠覆
访谈开场便直指核心:在聊天式 AI 重塑人机交互的今天,谷歌的核心搜索业务是否面临被真正颠覆的风险?桑达尔·皮查伊(Sundar Pichai)的回答明确而坚定。他回顾道,自 2015 年担任 CEO 起,他便将谷歌定位为“AI 优先”的公司,因为团队深信 AI 将是驱动搜索最大进步的动力。因此,当前时刻对他而言并非威胁,而是搜索的“非凡机遇”。
皮查伊用数据佐证了他的观点。谷歌约一年前推出的“AI 概览”(AI Overviews)功能,如今已被超过 15 亿用户使用,覆盖 150 多个国家。这不仅没有蚕食传统搜索,反而扩大了用户查询的类型和范围,带来了全新的使用场景。在触发 AI 概览的查询中,谷歌观察到了查询量的增长,且增长具有持续性。他透露,实验室中正在测试一个全新的、名为“AI 模式”的专用搜索 AI 体验,将在谷歌 I/O 大会上详述。在该模式下,用户可以进行完整的对话式追问,谷歌最前沿的模型将利用搜索作为原生工具来回答问题。
“用户正在用行动回应,”皮查伊指出,用户输入的查询平均长度已是两三年前的两到三倍,有时甚至是长段落。这改变了搜索的形态。针对“创新者困境”的经典命题,皮查伊认为困境只存在于你将其视为困境之时。他援引了移动转型和 TikTok 崛起后 YouTube 依然蓬勃发展的例子,指出科技史上每一次重大创新周期,都需要全力投入。“这有点像谷歌最初的原则之一:跟随用户,其他一切自会跟随。”
商业模式过渡:成本可控,广告逻辑依旧
当对话转向敏感的商业模式——即更昂贵的 AI 查询是否会破坏谷歌搜索“查询成本”与“单次查询广告收入”之间精妙的单位经济学时,皮查伊展现了基于基础设施优势的自信。
他承认两年前业界普遍担忧成本问题,但他始终认为,就服务成本而言,他愿意押注谷歌的基础设施能力能够比几乎所有其他公司都做得更好。事实也证明,在过去 18 个月里,服务单次查询的成本已大幅下降。目前更主要的约束在于延迟,而非成本。如何让 AI 体验达到搜索近乎即时的速度,是当前更重要的前沿问题。
关于 AI 查询的广告收入,皮查伊表示,在已经展示广告的 AI 概览中,其效果基准已与传统搜索持平。“我们已经达到了那个阶段。”他进一步从第一性原理分析:广告在搜索中行之有效,是因为商业信息本身就是用户意图的一部分。AI 没有理由不能在这方面做得更好。因此,他对平稳过渡商业模式感到“安心”,尽管部分调整可能需要时间,但所有指标都显示谷歌能够很好地完成这一过渡。
基础设施与芯片:谷歌的“全栈”护城河
皮查伊多次强调,谷歌一个核心且常被低估的优势是其长达二十多年的基础设施投资。从早期可海运的集装箱数据中心,到如今遍布全球的网络,这构成了竞争力的基石。在 AI 时代,这一优势直接体现在性能与成本的帕累托前沿上——谷歌能够以最具成本效益的价格点提供最好的模型。
关键组件之一便是谷歌自研的 TPU 芯片。皮查伊提到,谷歌在 2017 年发布了第一代 TPU,如今已发展到第七代。最新的 “Ironwood” 芯片单块算力超过 40 Exaflops。这些专门为机器学习优化的芯片,尤其在推理环节表现出色,是谷歌有信心以巨大规模服务 AI 搜索查询的重要原因。他表示,谷歌的“全栈”方法——从底层基础设施、基础研发到上层应用创新——将长期为公司带来优势。
关于芯片战略,皮查伊澄清了与英伟达的关系。他盛赞英伟达是“非凡的公司”,CEO 黄仁勋(Jensen Huang)也很出色,双方合作历史悠久。谷歌内部既用 TPU 训练 Gemini 模型,也在 GPU 上服务部分流量,并为云客户提供选择。他认为行业内的公司都会尝试类似(自研芯片)的路径,但英伟达的研发能力和软件栈是世界级的,拥有诸多优势。谷歌的长期策略是保持 TPU 和 GPU 并用的灵活性,两者相互促进,共同推动技术前沿。
模型创新未达瓶颈,数据优势在于个性化
针对外界关于大语言模型性能开始“高原化”、竞争者差异缩小的论调,皮查伊并不认同。他将进步过程比作“人工 jag jag 智能”,即进展并非总是线性的,会经历看似缓慢的时期,然后出现范式突破。过去几年,行业在预训练、后训练、推理计算等方面不断推进,如今又在研究如何将所有技术整合到智能体工作流中。他感觉进步相当持续。
“进步确实会变得更难,而这将区分出精英团队,”皮查伊认为,问题越难,谷歌的准备就越充分。谷歌的研究前沿远比大多数公司更广阔,不仅限于 LLM 或基于 Transformer 的模型,在扩散模型等众多领域都在进行深度探索。他尚未看到计算投入回报递减的根本性拐点出现。
当被问及谷歌是否拥有来自 YouTube 等产品的独特数据优势时,皮查伊的回应侧重于用户体验而非单纯的数据训练。他认为,谷歌的机会在于利用用户使用 Gmail、日历、文档、YouTube、搜索等产品时产生的个人上下文(在获得用户许可的前提下),来提供更优质、更个性化的体验。他将此视为公司未来差异化的创新机遇之一,目前正在审慎推进。
未来交互:无缝、环境计算与 AR 眼镜
展望未来 5 到 10 年的人机交互,皮查伊描绘了一个“无缝”的愿景:人类需要做的“硬性适应”工作越来越少,计算将主动为人服务。他认为这是“圣杯”,而触摸、语音等技术正在一步步迈向这个未来。
他特别看好增强现实眼镜的前景。作为眼镜佩戴者,他亲身体验了 AR 眼镜,虽然目前舒适度尚不及普通眼镜,但正在改善。他相信,当 AR 真正成熟时,它将把无缝体验推向新高度,让计算“环境化”地存在并为你服务。他指的并非沉浸式显示设备,而是 AR 眼镜。结合真正多模态的模型,他认为这一范式非常有趣,能让人感受到下一次飞跃。他将当前 AR 的发展阶段类比于 2006-2007 年的智能手机,可能还需几个周期才能达到理想状态。
皮查伊证实,谷歌在硬件上投入了大量时间,不仅限于 Pixel 手机和数据中心,也对 AR 眼镜、机器人等新形态感到兴奋。
竞争格局:AI 市场足够大,创始人深度参与
面对 OpenAI(萨姆·奥尔特曼 Sam Altman)、xAI(埃隆·马斯克 Elon Musk)、Meta(马克·扎克伯格 Mark Zuckerberg)和微软(萨提亚·纳德拉 Satya Nadella)组成的强大竞争对手矩阵,皮查伊展现了开放与务实的态度。他称赞这是一个“令人印象深刻的群体”,汇集了最好的公司和企业家。竞争的存在恰恰预示着我们将看到巨大的进步。
他特别提到2025 年 5 月与埃隆·马斯克(Elon Musk)的会面,钦佩其“将未来技术变为现实的意志力无与伦比”。皮查伊强调,AI 将开启一个比过去所有技术总和更大的机遇版图。他提醒人们,互联网兴起时,谷歌甚至还不存在。未来 AI 领域的赢家可能包括许多尚未诞生的公司。因此,格局并非简单的“谁击败谁”,而是关于哪些公司能够通过创新和执行,携手最优秀的人才取得成功。
皮查伊还分享了谷歌联合创始人拉里·佩奇(Larry Page)和谢尔盖·布林(Sergey Brin)的深度参与。他经常与两人交流,称赞他们很早就预见了 AI 的今天,并认为这是计算机科学领域最激动人心的时刻。谢尔盖·布林更是以“硬核”方式投入,与 Gemini 团队坐在一起编码、查看损失曲线、反馈模型架构,为团队注入了无与伦比的能量。皮查伊珍视与两位创始人“非线性思维”碰撞带来的灵感。
长期押注:量子计算与机器人
谷歌以对前沿技术进行长期、耐心投资而闻名,如 TPU、DeepMind、Waymo。皮查伊以同样视角看待量子计算和机器人。
他将量子计算目前的发展阶段类比于 2015 年左右的 AI。他预计在未来 5 年时间框架内,将会出现一个真正的“顿悟时刻”——用量子方式完成一项非常有用的实际计算,且远超经典计算机,从而真正展现该领域的潜力。他对此充满信心。谷歌的目标是通过云平台展示更多实用算法,并提供访问。皮查伊认为,就像无人驾驶领域曾充满噪音一样,量子领域目前也有很多宣布,但谷歌自认为处于前沿。
在机器人领域,皮查伊承认谷歌曾过早尝试应用层(如收购波士顿动力后又出售),当时机器人尚未深度受 AI 影响。如今,“AI + 机器人”的结合点已经到来。谷歌拥有世界级的机器人前沿研发团队,Gemini 在视觉-语言-动作模型方面的努力也属顶尖。他们正在思考如何通过合作或推出产品来参与其中。皮查伊观察到,人形机器人的进步神速,以至于他需要仔细辨别视频真假。他预测,距离机器人领域的“神奇时刻”可能还有两到三年。谷歌旗下公司 Intrinsic 正致力于成为“机器人领域的安卓”,而 Gemini 模型也将成为机器人领域的强大基础模型。
文化、人才与未来展望
针对谷歌文化从早期创新乐园演变为“骄纵员工”避风港的外部批评,皮查伊进行了辩护与反思。他解释,提供午餐等福利的初衷是创造积极、乐观、便于跨领域交流的创新氛围,这至今仍是谷歌吸引顶尖人才、激发基层创新的力量源泉。但他也承认,随着公司规模急剧扩大,有时次要议题会掩盖公司的核心使命。
过去几年,他刻意致力于重拾“使命聚焦”,强调员工聚集于此是为了创新并服务公司使命、产生影响力。当前的 AI 时刻带来的高强度与兴奋感,让他回想起早期的谷歌。他通过创建“实验室”等机制,鼓励小团队快速创新。他认为,文化需要不断微调以忠于核心价值观,出现漂移时则需努力拉回。
在人才争夺方面,皮查伊表示,谷歌在吸引顶尖 PhD 研究员方面依然具有竞争力,也有离职员工回归。他预见,AI 将使全球更多地方涌现出卓越人才,而不仅限于少数传统中心。
关于 Alphabet 作为控股公司的结构,皮查伊澄清,其本质并非单纯财务投资,而是基于共同的基础技术(如 AI)去解决不同领域的问题,从而衍生出看似迥异但内核相连的业务。从 Waymo 到 Isomorphic(基于 AlphaFold 的药物发现公司),都是这一逻辑的体现。
最后,被问及十年 CEO 任期内最大的骄傲与遗憾时,皮查伊对谷歌能够同时推动技术前沿(如获得诺贝尔奖级别的基础研究)并将其转化为商业价值感到无比自豪。至于遗憾,他提到了一些曾激烈辩论但最终未完成的收购,例如 Netflix,但他更倾向于向前看,认为这些是“平行宇宙中的另一种可能”。
 Alphabet CEO Sundar Pichai(皮查伊)谈 AI 未来:搜索不会消亡,是扩张性时刻撰文:Techub News 整理
导语
2025 年 6 月,Alphabet 兼 Google CEO Sundar Pichai(皮查伊)做客 Bloomberg 知名播客节目「The Circuit」,接受了近半小时的深度访谈。此时正值 Google I/O 开发者大会后不久,AI 竞争白热化,且 Google 面临多项反垄断诉讼的关键节点。作为全球科技巨头之一的掌舵人,Pichai 此次发声不仅阐述了 Google 在 AI 时代的核心战略,也回应了外界对其商业模式、行业影响及技术伦理的诸多质疑,为观察 Google 的未来走向提供了重要窗口。
摘要
AI 是扩张性时刻,将创造新机会而非零和游戏,搜索查询量仍在增长。
2025 年资本支出达 750 亿美元,AI 投资驱动搜索、YouTube、云、Waymo 等全线业务,并已通过 Google AI Pro/Ultra 订阅等创造新收入。
AI 将大幅提升工程师生产力,但公司仍计划扩大工程师规模,以抓住更大的机会空间。
坚决不同意垄断指控,认为用户使用 Google 是出于选择,竞争对世界有益。
承认 AI 可能带来就业冲击等社会问题,但强调需通过技能再培训和社会安全网来应对,而非过度悲观预测。
AI 浪潮下的 Google:搜索进化,而非消亡
当被问及 AI 聊天机器人是否会取代传统搜索时,Sundar Pichai(皮查伊)给出了明确的否定答案。他认为,这远非一场零和游戏。他以 TikTok 崛起为例,指出新平台的出现并未扼杀 YouTube,反而 YouTube 也在同期取得了巨大成功。用户行为是并行的,人们会根据不同需求使用不同工具。
Pichai 强调,搜索在满足用户特定信息需求方面“非常、非常好”,其价值已通过持续增长的查询量得到实证。AI 概述(AI Overviews)等功能是搜索的自然演进,就像多年前推出的精选摘要(Featured Snippets)一样。他承认,有时 AI 概述会直接给出答案,减少用户点击,但 Google 在设计体验时,依然会优先展示链接,并将高质量流量导向外部网站。他援引内部测试数据称,AI 概述改善了上下文质量,用户点击后访问的网站更加多元化,且平均每次点击的停留时间也更长。
对于出版商关于点击率下降的担忧,Pichai 表示理解,但坚信从长远看,Google 的生态会保持良性循环:用户因获取答案而来,也会因好奇心和拓展用例而点击外部链接。Google 的职责是持续优化,确保高质量内容获得展示。
巨额投资与新兴收入:AI 驱动全线业务
面对投资者最关心的 AI 投入与回报问题,Sundar Pichai(皮查伊)首次在访谈中明确了投资规模:2025 年,Alphabet 的资本支出将达到 750 亿美元。这笔巨额投资并非仅用于 AI,而是支撑从搜索、YouTube、云、Workspace 到 Android、Play 乃至 Waymo 自动驾驶的全线业务。
他透露,AI 已经在创造实实在在的新收入流。云端 AI 平台 Vertex AI 的用量(按 token 计)在过去 12 个月里增长了 40 倍。此外,公司2025 年 6 月推出的 Google AI Pro 和 Ultra 等订阅服务也“表现良好”。Pichai 认为,AI 是一项深远的技术,其带来的机遇比过去任何时候都要大。
在内容生态方面,Pichai 承认 AI 生成内容的爆炸式增长带来了高质量与低质量内容并存的问题。但他认为,这正是 Google 擅长的领域——从海量信息中筛选出优质内容。Google 正在利用 Gemini 模型来改进 YouTube 的推荐算法,用 AI 来更好地管理和引导内容。他强调,AI 本身也能被用于创作优秀内容,Google 的目标是“提升高质量内容”。
生产力革命与就业未来:AI 是加速器,而非替代者
关于 AI 对工作岗位的影响,Sundar Pichai(皮查伊)的立场颇为审慎乐观。当被问及 Anthropic CEO 关于 AI 可能在五年内淘汰 50% 白领工作的预测时,他表示应严肃对待这些担忧,但历史经验表明,技术会创造新的就业机会。
他举例说,1940 年时,今天 60% 的工作岗位尚不存在。在印度,YouTube 上已有 1 亿个频道和 1.5 万个百万订阅频道,这是十五年前无法想象的世界。AI 将让几乎每个人都成为“成熟的创作者”,从而创造出海量新机会。他认为,当前时刻是“扩张性”的,我们可能低估了其创造新业态的潜力。
具体到 Google 内部,Pichai 透露目前公司约 25% 的代码由 AI 生成。他预计,即使到明年,公司的工程师基数仍会增长。AI 的作用是让工程师 dramatically 更高效,将他们从繁琐工作中解放出来,专注于高附加值任务。这意味着公司能加速开发,可能推出更多新产品,从而在短期内需要更多人。长远来看,他承认难以精确预测,但更倾向于相信技术会扩展人类的能力边界,而非单纯导致岗位减少。
反垄断、信任与伦理:在监管与创新间平衡
面对法官裁定 Google 在搜索和部分广告市场构成垄断的指控,Sundar Pichai(皮查伊)明确表示公司不同意相关裁决,并正在上诉。他强调,用户使用 Google 是出于自愿,现在的选择比以往任何时候都多。竞争对用户和世界都有益。
对于 AI 是否会加剧科技巨头的权力集中,Pichai 反驳了“赢家通吃”的观点。他坚信,就像互联网催生了当时不存在的 Google 一样,AI 时代也必将诞生新的、我们今天甚至不知道名字的 dominant 公司。这是技术发展的自然规律。
在用户隐私和信任问题上,Pichai 指出,Google 通过长期负责任地处理用户数据(如 Gmail)来赢得信任。面对 AI 带来的深度伪造等挑战,他介绍了 Google 的应对措施:为 AI 生成的视频添加水印,用户可上传任何视频或图片到 Google 以检测是否由 Veo 等模型生成,并为研究人员和记者提供检测工具。他认为,社会将演化出新的规范,并可能需要法规来应对深度伪造等欺诈行为,但人类对 shared reality(共享现实)的追求不会改变。
领导力、未来与 AGI 迷思
回顾过去几年外界对 Google“行动迟缓”的批评,Sundar Pichai(皮查伊)表示,他作为 CEO 的核心工作正是让公司处于 AI 前沿。通过整合团队成立 Google DeepMind、大幅增加基础设施投资(资本支出从几年前的 200 亿美元增至 750 亿美元)、在 Waymo 被看衰时坚持加码等决策,他正带领公司加速前行。他仍然深度参与产品决策,同时得益于 Sergey Brin 等在 Gemini 模型上的深耕。
关于通用人工智能(AGI)的前景,Pichai 保持了开放态度。他认为按照当前路径,前方仍有巨大进步空间,但技术曲线可能存在暂时的高原期,能否实现 AGI 尚无定论。他以自动驾驶为例:Waymo 表现优异,但教会一个孩子开车只需 20 小时,说明现有技术与通用智能仍有距离。
最后,当被问及 Google 50 岁时会怎样,Pichai 希望公司保持敏捷和创新。在科技行业,成功需要每年去赢得。他更关注的是打造一种深入创新、着眼长远、深耕技术并将其转化为影响数十亿人产品的文化。至于那时由人还是 AI 运营公司,他笑着回答:“无论谁运营,都将拥有一位非凡的 AI 伴侣。”
 Google CEO Sundar Pichai(桑达尔·皮查伊):AI 将比火和电更深远地改变世界撰文:Techub News 整理
导语
2025 年 6 月,Google 与 Alphabet 的 CEO Sundar Pichai(桑达尔·皮查伊)做客知名播客《Lex Fridman Podcast》,进行了一场长达两个多小时的深度对话。作为全球最具影响力的科技领袖之一,Pichai 此次发声正值 AI 技术狂飙突进、行业竞争白热化的关键节点。他不仅回顾了自己从印度普通家庭走向科技巅峰的个人历程,更全面阐述了 Google 在 AI 时代的核心战略、对技术未来的深刻思考,以及如何带领这家科技巨头应对来自内外的巨大挑战与质疑。这场对话是理解 Google AI 路线图及其领导者哲学的一次难得机会。
摘要
童年经历塑造技术观:Pichai 在印度钦奈的成长经历,让他深刻体会到技术(如电话、自来水)如何阶梯式地改变生活,这奠定了他对技术赋能人类的核心信念。
AI 是史上最深刻技术:Pichai 重申并坚信 AI 将是比火或电更深远的技术,因其具备递归自我改进能力,能加速“创造”本身,其影响将远超以往任何发明。
Google 的 AI 战略与反击:面对去年的质疑,Pichai 详解了通过合并 Brain 与 DeepMind、押注 TPU 基础设施等关键决策,带领 Google 在一年内实现 AI 产品密集落地与能力飞跃的过程。
AGI 展望与“毁灭概率”:Pichai 认为 2030 年前可能无法完全达到 AGI,但届时技术进步已足够震撼。他对 AI 可能导致人类毁灭的“p(doom)”持谨慎乐观态度,相信人类在危机面前会团结应对。
AI 赋能创意与责任边界:Pichai 强调 AI 工具(如 Veo)应像“基础设施”或“画笔”一样赋能艺术家自由表达,同时 Google 需要在支持创意与履行社会责任之间找到平衡。
从钦奈的童年到 Google 的使命:技术如何阶梯式改变人生
Sundar Pichai(桑达尔·皮查伊)的科技世界观,根植于他在印度钦奈度过的童年。全家住在一套简陋的两居室公寓里,技术曾是稀缺品。他回忆道,家里申请一部电话需要等待五年,最终装上的转盘电话却彻底改变了生活——邻居会来家里给亲人打电话,取一份验血报告从往返四小时且可能白跑一趟,变成了五分钟就能搞定的事。“那时,我脑海中就像亮起一盏灯泡,明白了技术改变人们生活的力量。”Pichai 说道。
类似的“阶梯式体验”还有很多:在严重干旱时,他和兄弟、母亲需要排队领取按户分配的桶装水;多年后,家里通了自来水并装上了热水器,打开水龙头就能洗热水澡。“对我来说,一切都是这样离散地发生的。所以我一直有这种‘第一次’的感觉,感受技术如何戏剧性地改变你的生活,以及它带来的机遇。”这种对技术赋能作用的切身感受,与他后来被 Google“整合全球信息,使人皆可访问并从中受益”的使命所深深吸引,形成了内在的逻辑闭环。
童年的信息获取主要依靠报纸和书籍,受在邮局工作的祖父影响,Pichai 阅读广泛,从艾茵·兰德到哲学著作再到通俗小说。这种对知识的渴望,与后来 Google 的使命产生了强烈共鸣。他甚至笑着回忆,为了说服父亲买一台 VCR(录像机),花了很长时间,而拥有 VCR 后能够录下世界杯足球赛或观看电影录像带,又是一次全新的体验。“这些离散的记忆让我始终觉得,获得技术访问权是如何驱动你生活中阶跃性变化的。”
当被问及给全球有志青年的建议时,Pichai 强调了两点:一是倾听内心,做自己真正热爱的事情,这能让你展现最好的自己;二是努力与那些你认为比自己更优秀的人共事,让自己处于“不舒服”但能拉伸能力的环境中,这有助于个人成长。
AI 是比火与电更深刻的技术革命
当 Lex Fridman 提出,将 AI 置于人类万年文明史的所有重大发明(如农业革命、电力、工业革命)中进行排序,它是否有机会成为“第一生产力乘数”时,Pichai 给出了坚定而深刻的回答。
“多年前(大概是 2017 或 2018 年),我就说过,AI 是人类将研究的最深刻的技术,它将比火或电更深刻。我必须支持我自己,我仍然认为情况就是这样。”Pichai 承认可能存在“近因偏差”,就像人们总容易认为当下看到的运动员是最伟大的。但从第一性原理出发,他论证 AI 将比所有这些发明都更宏大。
他指出了 AI 的根本独特性:首先,它的进步速度极快,能力边界不明,天花板不清;其次,也是最重要的,它是递归自我改进的。“它是第一个将显著加速‘创造’本身的技术,能够自己改进并达成目标……这使它处于一个不同的联盟。”因此,Pichai 相信 AI 最终产生的影响将远远超过我们之前所见的一切。
他进一步描绘了“AI 技术包”可能带来的早期变化:核心是极大降低创造与表达的门槛。“可以很容易地想象,将你头脑中的想法,转化为存在的事物,这将成技术包的一部分……它将赋能几乎全人类来表达自己。”无论是编写软件、创作内容、开发游戏,还是进行科学研究,都将变得无限可能。AI 将解锁全球 80 亿人的认知潜力,就像互联网博客让更多人发声一样,但规模将是数千万甚至数亿人更深度地向世界输出内容。
Pichai 也预见了这将重塑创意格局,让传统内容生产者感到紧张,但他认为其中存在被低估的扩张性一面。“它将以前所未有的方式释放人类的创造力。”他类比道,如果把 20 世纪 40、50 年代的人带到今天的 YouTube 面前,会让他们震惊;同样,我们也将被未来 10 到 20 年内可能实现的事情所震撼。
领导者的平衡术:谦和、决策与穿越风暴
Lex Fridman 好奇,在竞争激烈的科技世界攀登至顶峰的领导者,往往需要一些“强悍”特质,而 Pichai 以平衡、谦和、善于倾听著称,他的“秘诀”是什么?Pichai 坦言自己也会生气、沮丧,拥有常人所有的情绪,但他逐渐找到了激发团队最佳状态的方法。
“我发现,激励那些有使命感、追求卓越、有内在驱动力的人,并以此实现目标,往往效果更好。”他将此比作体育中的“人员管理”,伟大的教练都擅长此道。很多时候,与你共事的人如果犯错,他们自己比你更难受,因此需要用不同的方式对待。当然,偶尔也需要明确告知对方“这样不行”。但他发现,大多数情况下并不需要如此。
真正的考验出现在去年。当时,外界充斥着“Pichai 是错误人选”、“Google 迷失了、完蛋了”的论调。回顾那段时期,Pichai 展现了他作为领导者的定力与决策逻辑。
“我擅长屏蔽噪音,区分信号与噪声。”他用水肺潜水作比喻:海面可能波涛汹涌,但只需下潜一英尺,下面就是世界上最平静的地方。运营 Google 就像执教巴萨或皇马,总会有糟糕的赛季。关键在于,他内心清楚 Google 正在构建什么。
他列举了此前所做的几个关键决策:一是多年前就开始投资 TPU,为大规模模型训练打下基础;二是将 Google Brain 与 DeepMind 合并,组建 Google DeepMind,汇聚世界级研究人才;三是组建专门的 AI 基础设施团队,全力扩展所需算力。尽管外部可能未充分意识到,但 TPU 的产能爬坡也需要时间。“但我能看到内部的轨迹……对我来说,这个时刻感觉是我们公司未来十年、二十年最大的机遇之一。我认为我们比世界上大多数公司都更有条件去实现这一愿景。”
谈及合并 Brain 与 DeepMind 这一艰难决定,Pichai 承认这就像“有人告诉你,把斯坦福和 MIT 合并,创建一个伟大的院系”。幸运的是,他们遇到了合适的时机和人选。Jeff Dean 希望回归更偏科研的个人贡献者角色,而 Demis Hassabis 自然是领导新团队的合适人选。合并过程不乏“几个不眠之夜”,但团队耐心地将两个世界的精华结合起来,为长远成功奠定了基础。
在压力时期,Pichai 也会更加强硬,但他强调决策的清晰性。“在做出重大决策时,听取每个人的意见很重要……有时你听到的内容会影响你的思考。有时你已有清晰信念,你会表明‘这是我的感受,这是我的信念’,然后你就押注于此,继续前进。”他认为,只要决策清晰,假以时日人们会尊重这一点。
AGI 路径、风险与 Google 的产品哲学
关于 AGI(通用人工智能)的时间表,Pichai 引用了 Andrej Karpathy 提出的“AJI”(人工参差不齐的智能)概念,认为当前正处于这个阶段——在某些方面取得惊人进步,但在另一些方面(如数草莓字母‘R’的个数)却会犯低级错误。他看到了 AGI 的“微光”,例如在旧金山街道上乘坐 Waymo 自动驾驶汽车,或者通过 Gemini Live 进行世界交互时,但同时也清楚距离真正的 AGI 还很远。
对于“2030 年能否实现 AGI”的问题,Pichai 表示:“到 2030 年,将会取得如此巨大的进步。我们将以重要方式处理这种进步带来的后果,无论是积极的还是消极的外部性。”他个人认为,到 2030 年可能“刚好差一点”实现 AGI,但这并不重要,因为进步本身已经足够震撼。
话题转向更严峻的“p(doom)”——即 AGI/ASI(人工超级智能)毁灭人类文明的概率。Pichai 严肃地表示,这确实是他们“厨房谈话”的话题之一。他认为,如果“毁灭概率”真的很高,那么到了某个时刻,全人类会团结起来确保它不会发生,因此人类实际上会取得更多进展来对抗它。“这具有一种自我调节的特性。如果人类齐心协力解决一个问题,我认为我们能够做到。”因此,他对“毁灭概率”情景持乐观态度,但这并不意味着基础风险不高,只是他对人类能够挺身而出迎接那个时刻抱有极大信心。
Lex 补充了“没有 AI 的毁灭概率”视角,认为 AI 可能通过让人类更聪明、更友善、更高效,帮助世界更多地区繁荣发展,从而反而拯救人类文明。Pichai 对此表示赞同,认为要解决一些最棘手的问题,有 AI 的帮助会更好。
在具体产品层面,Pichai 详细解释了 Google Search 的演进。推出“AI 模式”是一个重要决策,其核心设计原则是:AI 提供上下文和摘要,但用户最终仍会去探索网络。“那些核心原则没有改变,但 AI 模式允许我们推进……我们最好的模型在那里,它们将搜索作为深度工具,真正为每个查询展开,进行多次搜索,以你能消费的方式组装知识。”他特别指出,对于非英语用户,AI 在推理过程中整合多语言信息的能力,将极大扩展他们可访问的知识范围,释放巨大的认知潜力。
关于在 AI 体验中引入广告,Pichai 表示早期会更多关注有机体验,但广告作为“商业信息”和支撑免费服务的基础,其根本价值不会改变。AI 本身将帮助找到最佳的实现方式。他强调,Google 目前计划将 AI 模式作为一个独立标签,供希望体验前沿功能的用户使用,而其中验证有效的功能会逐步迁移到主搜索页的 AI 概述中,这是一个连续的演进过程。
赋能艺术与应对边界:AI 作为创意画笔与社会责任
当讨论到 AI 生成内容(如通过 Veo 生成视频)时,Lex 提到了像达伦·阿罗诺夫斯基这样的电影导演正在积极探索用 AI 创作电影,以及一些更“边缘”的艺术家在挑战社会接受度的边界。这给 Google 带来了一个难题:如何既允许艺术家进行自由、甚至“疯狂”的创作,又履行平台的社会责任?
Pichai 明确表示:“当涉及到允许艺术自由表达时,这是一个社会中最重要的价值观之一。艺术家一直是推动边界、拓展思想前沿的人。”因此,他认为 Google 应该提供工具,并将其交到艺术家手中供他们使用和发布作品。“我几乎将其视为基础设施。就像你向人们提供电力时,你不会考虑其上的用例。”AI 工具就像一支“画笔”。
当然,他也承认必须有一些界限。“社会需要在根本层面上决定什么是可以的,什么是不可以的。我们会负责任地处理。”但他强调,在艺术自由表达方面,这是他们应该努力捍卫的价值观之一。
Lex 注意到,Gemini 2.5 Pro 相比早期版本,在回答涉及暴力历史等敏感话题时,显得更少“小心翼翼”,更加客观和细致。Pichai 解释了这一变化背后的思考:随着模型能力增强,它们能够更好地推理这些细微问题。“一旦模型跨越了某个智能和复杂度的门槛,它们就能很好地推理这些有细微差别的问题。我认为用户真的想要这样……他们希望尽可能多地访问原始模型。”
他指出,正确的方向是从第一性原理(科学角度)出发,让模型从底层学会推理世界、理解细微差别,而不是由一部分人类在上面进行硬编码。这是 Google 正在采取的方向,未来也会继续推进。
访谈最后,Pichai 分享了他对 Beam(沉浸式远程呈现技术)和实验性 XR 眼镜等前沿项目的兴奋之情。Beam 让他看到了远程沟通中恢复“临场感”与人际连接的可能性,而 XR 眼镜则展示了将 AI 助手无缝融入日常视觉与听觉体验的潜力。这些探索都指向同一个未来:技术将继续以离散而深刻的方式,融入并提升人类生活的每一个维度。
正如 Pichai 在总结中对人类未来的乐观展望:纵观人类文明历程,我们一直在不懈地让世界变得更好。如果可以选择在任何时代出生,他几乎总是选择现在。“这就是人类文明所取得的非凡成就……我们总是集体崛起,推动前沿向前。所以我预计未来也不会有什么不同。”在 AI 这个可能是人类历史上最深刻的技术革命面前,这位从钦奈走出的 Google 船长,正带着他的信念与谦和,引领巨轮驶向未知而激动人心的深海。
 教育最奢侈的“一人一解法”,即将变成日常作者|李楠
微信|tqkm1510
1950 年代,关心教育的心理学家 Skinner 去看女儿的小学数学课,发现有人已经做完练习,有人仍然没听懂,老师只能在几十个孩子之间来回检查、纠错。
Skinner 由此想到,如果每个孩子的掌握程度不同,他们此刻得到的反馈和下一步学习任务也应该不同。他后来设计教学机器,希望机器至少能够根据学生的回答提供即时反馈、安排下一道题。这成为教育技术早期将个性化教学规模化的一次尝试。
但个性化教学的实践远比想象中更难。人力有限,高明的老师始终稀缺。即使是经验丰富的老师,也很难及时捕捉每个学生在每一个学习环节出现的细小困惑,更不用说随时为这些需求重新组织一次教学。
在各种尝试之后,以大模型为代表的新一代 AI,又给个性化教学打开了新的空间。
Alpha School 是个激进的例子。它主张学生每天上午依靠自适应学习软件和 AI 系统,用两小时完成数学、科学等核心学科,再用下午四个小时学习创业、编程等现实技能。AI 的一个重要作用,就是实时分析学生的学习状态,进而调整课程。
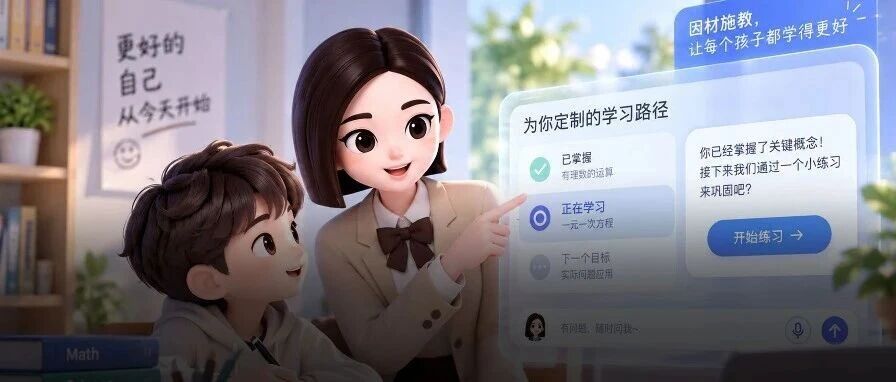
国内的教育平台同样在跟 AI 深度融合,其中最新的样本来自豆包爱学。它把“一人一解法”的个性化教学贯彻到产品的各种细节功能里,不仅让教学更适配每个学生的学习需求,还让学习过程更有意思。
1
让每次学习,都得到更有趣的指引
很多行业值得用 AI 重做一遍,很多课程值得用 AI 重学一遍。
5 月底,豆包爱学上线“豆包课堂”,把数学和古诗词的学习融入到了可互动的 AI 课程里。不过更有趣的是,豆包爱学还实现了游戏化课程定制,把自己的想法交给 AI,就能得到一门图文互动的专属课程。
比如把数学融合进商业实践,让用户可以具象化理解数学知识。在一个案例中,用户变身古代点心铺的小掌柜,上演“点心铺闯关记”——他要用上数学课的知识,在三天时间里,把一家快要关门的小店彻底救活。
第一关的谜题是“桂花糕为什么越卖越亏”。这里要搞懂成本和利润的关系,保证卖点心绝对不亏本。
第二关是备货问题。这里要学会比较不同备货数量可能带来的剩余或缺货,理解平均数能怎样帮助作出判断。
第三关是促销关卡。很多老板喜欢做买二送一的促销活动,但促销未必明智。这里要用比例、对比和利润计算,来判断促销活动的可行性。
而在最后,用户将迎来终极挑战。他要将三天学到的知识汇总成一份《小掌柜秘籍》,把定价算账、备货估算、促销判断中的思考和知识来一遍完整的回顾,由此成为一个生意上的小专家。
从成年人视角来看,这种游戏或许略显幼稚。但代入小学生视角,他在闯关互动中获得的心理满足远比传统的学习过程要强。而且这种互动课程不仅可以教会用户数学计算,还能在潜移默化中实现商业启蒙,一举多得。
大量教育研究已经表明,把知识嵌入具体的问题情境,不仅有助于提升学习兴趣,也更有利于训练知识迁移、问题解决和综合应用能力。对豆包爱学来说,AI 互动引导可以广泛定制生成。
除了豆包课堂,豆包爱学的“问答”页面同样可以提供个性化教学。打开其中的“学习模式”,输入各种想学习的主题,AI 就可以调用不同能力给出解答。
我试着在这里重温中学语文课。
首先是鲁迅的《从百草园到三味书屋》。豆包爱学先是给出了两个学习选项:要么从童年视角出发,跟着少年鲁迅的脚步去感受童年的自由与拘束;要么从成年视角出发,去看鲁迅藏在童趣背后的对教育、对自我的复杂回望。
我选了第一个视角。随后“豆老师”先把百草园的美妙之处一条条摘出来,然后抛出一个问题,让我想想自己的童年记忆里,有没有过类似“百草园”的小角落。显然,这是希望学生可以与鲁迅共鸣、共情,来增进对文章的理解。
我还尝试学习《红楼梦》中的诗词。“豆老师”先是指出曹雪芹作诗的特殊之处——并非为了写景而写景,而是做“人物的命运寓言+性格盖章”,之后则是给出三个不同难度的角度,来展开《红楼梦》诗词的教学互动。
整体而言,在“问答”中,豆包爱学会根据学生所掌握的知识水平和兴趣偏好,给出启发性的教学。
事实上,豆包爱学的“问答”是一个超级入口,除了以上针对性的互动引导,里面还整合了多种学习 Skill。在学习过程中,系统会根据具体情况,自动调用不同的 Skill,生成专属的学习工具。
小朋友要学习写字,它可以生成笔顺学习组件,以可视化的方式引导一撇一捺如何下笔。当学习数学时,它可以列出竖式,来清晰呈现除法题目该怎么解答。这些小场景在学习时极其高频,却没有被通用 AI 很好地解决。
更进一步,豆包爱学在问答互动过程中,会根据学习内容和学习进展,推荐相应的测验题目,来巩固学习成果。在随机的学习体验中,天文中的“月相”状态,历史中的长城作用,我也都重学了一遍。
此外值得一提的是,豆包爱学还引入互动网页的能力,强化个性化引导教学的效果。面对函数、几何等知识,AI 可以实时生成带动画和交互的学习页面。
总的来看,豆包爱学实现了对任意主题、任意知识点的个性化和趣味化的教学指引,并给出匹配用户需求的教学内容。
1
两条路线汇合,拓宽个性化教学边界
过去一年,AI 教育领域的主流产品都在持续推进个性化教学,而其中的探索大致可以分为两条路线。
一条路线侧重于让 AI 学会“教学”。去年 7 月,OpenAI 上线 ChatGPT Study Mode。一个学生拿着题目来求助,AI 会先问学生已经知道什么、卡在了哪里,再通过提示、追问、理解检查,一步一步往下走,避免一次性把答案全部端出来。
前文提到的 Alpha School 也是如此。它的核心能力之一,就是让系统更准确地判断学生现在会什么、不会什么,以及应该用什么节奏推进学习。
另一条路线则是侧重学习内容本身。Google 推出的 Learn Your Way,会根据学生的年级和兴趣重新组织教材内容,并进一步生成思维导图、音频课程和互动测验。同一个知识点,不同学生得到的材料可以有不同的难度、例子和呈现方式。
豆包爱学则把以上两条路线整合起来。它既会把同一个知识点组织成 AI 课程、互动网页、情境任务等不同形式,也会根据学生提出的问题、当前理解程度和学习偏好,来选择不同的切入角度,进而分步引导、即时追问。
而这种整合能够匹配不同学科、不同主题和不同学习环节,让个性化教学进入一种动态的“原子化”阶段:一方面,个性化教学的响应单位缩小到一次具体的学习需求;另一方面,这些教学内容和动作可以在需求出现之后即时生成,并随着学生的反馈继续调整。
当学生需要系统理解一个主题时,豆包爱学可以生成一门课;当学生只卡在对某个概念的理解,豆包爱学可以给出一种可视化解释;当学生想要确认学习效果是否扎实时,豆包爱学能立即推送测试链接。
这些指引不需要学生自己调 skill,也几乎不需要等待。这在以前几乎无法想象。
而以上种种引导几乎都可以由豆包爱学“问答”来提供,学习体验就更为便捷和流畅。
此时再回到开篇故事。
七十多年前,Skinner 设计教学机器,希望机器能够根据一次回答的对错,来决定下一道题应该是什么。今天 AI 能做到的,远比这位学者期待的要多。
而这种 AI 教育的演进在国内有更为现实的意义。一对一的个性化教学曾在国内风行,但它对多数人始终是一个奢侈的愿景。现在借助 AI,这种“一人一解法”的教学,终于有了真正普及的可能。
点个“爱心”,再走吧
 放弃百万美金年薪,牛津兄弟想训出「华尔街AI分析师」「自研模型,冲向交易金字塔尖。」
文|孙小雯 海若镜
编辑|海若镜
做AI金融模型创业前,子辰已是年薪百万美元的“金领”,凭借在顶级投行练就的交易嗅觉,赚钱对他来说不算难事。
创业的起心动念,源于一场AI交易大赛Alpha Arena。2025年底,DeepSeek、GPT、千问等大模型都下场参赛,也让子辰发现:通用大模型已经进化出一定的独立判断能力。也许未来,他引以为傲的投资决策能力,也能被大模型复现。
与其恐慌,不如下海去搏一搏风浪。他找到正在Meta从事模型研究的方正,两人一拍即合,开启了名为FreeRide的AI创业航程。「暗涌Waves」独家获悉,FreeRide AI近日完成数百万美元种子轮融资,投资方为L2F光源创业者基金。
在还没有Demo时,就拿到融资,关键有两点:一是选择的方向,二是创始团队的履历和潜能。从牛津大学数学系毕业后,子辰先后在伦敦和香港的摩根士丹利、摩根大通、华泰国际等机构工作,从事复杂衍生品交易,曾担任高级交易主管。
方正的履历则更为复合。牛津大学物理系毕业后,他先后在瑞银、Evercore、麦格理资本等机构,处理欧美区域的投行投资业务。因为感知到AI在金融行业的巨大潜力,他又回到剑桥大学攻读计算机科学博士,并参与到Meta、Oracle等大厂的AI模型训练和AI系统的研究。
两人开始探索:大模型已初具决策智能,但要让AI拥有“华尔街交易员”级别的能力,还有多少座山要翻越?
第一座绕不开的是“数据”。文本、代码可以被海量采集,但真正影响金融交易的高质量经验,往往只存在于一线从业者的大脑里。即便能采购诸多类型的数据库,但怎么判断数据价值、权重,进而转化为真实世界里的决策智能,仍有鸿沟。
而且,金融交易数据天然高噪声,现有大模型围绕coding智能体,适配出的长流程模式很难直接迁移。
架构层面,金融交易任务往往依赖极高维度的逻辑分析,很多任务不是定点、单向的求解路径,仅靠常规模型训练方法难以突破,还需要引入专门的系统学习架构。
即便金融专业模型掌握了应有的专业知识与能力,金融市场瞬息万变,只有让AI能够自主学习、自我进化,才可能捕捉到真实市场信号。
这些路障,也让他们理清了技术路线:做AI金融交易大脑,必须自训专业的垂直模型底座,同时做自进化Agent。基于在金融行业沉淀的经验,调整接入通用大模型的参数权重,进化出更有实操经验的LLM底座,先让AI成为有2-4年工龄的初级员工;再通过自进化Agent,让模型能够适应实时多变的金融交易。
自研模型,无疑是昂贵且艰难的。但子辰、方正认为,这是冲上金融“金字塔尖”的必经之路。一旦跑通,垂直模型进入塔尖的华尔街投行和一线基金,参与衍生品定价、复杂投资研究及决策,未来将能辐射更广的金融市场,甚至成为普通人的交易“副驾”。
在他们看来,模型大厂和互联网平台的确拥有更多算力与资源,但却很难偏离当前AI发展主线,聚焦于金融这一细分场景。未来AI系统,或许更像一个交响乐团:通用大模型,与一群专业模型合作,完成复杂任务。
除训练金融专业模型以外,两人在2026年发表论文,初步验证Agent在高噪声、高变化金融领域自进化的可行性。这一“会寻找Alpha的研究员”机制,在沪深300市场中测验,经过1600步进化后,将生成因子的IR中位数从1.6提高到3.9。这个表现不俗,在传统量化领域,IR大于1.0就可称为优秀因子。
技术初验后,接下来FreeRide将从衍生品定价等专业任务切入,做出金融专业人士可用的模型,再拓展到更广泛的金融任务。
以下是「暗涌Waves」与FreeRide联合创始人张子辰、沈方正的对话(经编辑):
Part01
AI交响乐团:
通用模型带一群垂类
暗涌:通用模型能搭Agent和Harness,为什么还要自己训练底层模型?
子辰:我们还是要用第一性原理去解决智能问题。现在Agent和Harness的架构越来越复杂,但如果你不掌握底层模型权重,上层设计地再精妙,也会面临一些风险,比如通用模型无法满足特定场景的任务质量。
另一方面是,以后机构会有自己的Agent,但这个Agent用哪个模型去驱动?现在的通用大模型不一定适合,我们希望做出一个更适合金融场景的模型,让这些Agent有机会用到FreeRideAI模型。
我们对比过GPT、Claude、DeepSeek、千问、MiniMax和智谱。在衍生品定价这类问题上,它们的确懂很多基础知识,但更像一个很好的实习生。你来投行实习,给出这样的回答,我觉得是OK的;但作为正式员工就不达标,因为你的答案过于肤浅,理论没有结合实际市场经验。
暗涌:投资人怎么看金融垂类模型,担心被通用模型吞掉吗?
子辰:感觉几个月以前,大家还在担心通用模型可以吞噬一切,但最近这一个月开始有变化。
通用大模型有几个限制,包括在专业领域的性能、成本和速度。对于特定专业,模型规模不一定是越大越好,最终形式可能是通用大模型与一系列专业模型合作完成任务。
现在的通用模型,在编程垂类已经做得非常好,但在金融、医疗等专业领域仍需要垂类模型。因为金融领域的一些实操经验,网上搜不到,书里也不会有。一个科技工作者很难复刻垂直领域里的顶尖能力。
方正:与其叫垂类模型,叫专业化模型可能更准确。与通识教育类似,现代AI在早期训练中打下的广泛知识基础,但若想像专业人士一样在特定领域独当一面,必须有高度专精的知识与职场技能培养。
暗涌:怎么确定金融模型该学什么?
方正:如果把模型训练比作“炼丹”的话,首先要知道这个“丹”是给谁吃的、解决什么问题。正因为我们团队在伦敦、纽约、香港等国际金融中心拥有丰富的专业经验,我们知道金融机构和专业人士需要AI模型做什么,就能反过来判断它应该具备什么能力、需要什么样的数据。
暗涌:买大量的商业金融数据库,来训练金融专业模型,是必须的?
子辰:确实需要采购数据库。但真正的经验是两点:第一,找到这些数据;第二,判断它们的价值和权重。同时面对100个数据,哪一个更重要?怎么把这些数据变成对决策有帮助的东西?决策思维链是怎样的?这些经验既往只存在于很小的金融圈,大家不会把它记录并公开出来。
比如期权定价的某一个参数,特定情况下怎么选,互联网语料和文献材料很少。但有一线交易实操经验的团队知道什么对、什么错,现有的数据里哪个权重应该更高、哪个应该更低。
如果只是把数据丢给模型专家,说“我有这些数据,你帮我去训吧”,最后的智能程度会非常低。就像经理让一个初级分析师分析问题,他直接把数据怼过去,那经理肯定会问:“我要你干什么?”
暗涌:只靠小圈子的经验,数据量够么?
子辰:首先,我们团队有能力从真实场景出发,针对需要解决的问题将相应的训练数据量放大。
另外,除了金融圈内的经验,我们还在做一件更有意思的事情,就是创建“模拟经验”的生成机制。它有些像AI斯坦福小镇,可以模拟人类的行为,各个角色在AI世界里交互。我们希望利用已有经验,用AI把数据量做大,去模拟更多有价值的经验。
暗涌:有具体的例子吗?
方正:关键技术细节,现阶段还不太方便透露太多。
但举一个例子,比如论文揭示的STAR机制,该机制处理的原始数据规模很小,而且全是有限、离散且信息与噪声高度浓缩的数值。
即便如此,我们仍然看到其中可以推导出有价值的观察结果,进而在后续阶段指导状态判断与决策行为。虽然应用于自进化和传统的后训练有所不同,但它印证了金融市场中很多信息可以被有效提取,并且作为信号推动AI系统与模型的整体迭代优化。
暗涌:金融领域现有的Benchmark怎么样,你们的垂类模型表现如何?
方正:现在金融领域的Benchmark并不是非常理想。比如去财报里找一些数字,本质上还是信息检索;或者是简单的计算,实质是把通用任务放到金融场景里。
我们也看到近期有一些Benchmark找专业人士标注,例如看一个问题需要从哪些角度思考的评测。但很多做得还比较粗糙,有些不是业内真正会考虑的问题。
子辰:我们不会盲目打榜。金融太大了,一个评测集可能只有小几百个问题。税务、会计、零售金融的问题跟机构金融的问题放在一起,各自覆盖面会比较狭窄。我们会针对性地判断,哪些Benchmark更适合我们。
Part02
自进化Agent:
即时感受市场变化
暗涌:为什么既要训练模型,又要让Agent自进化?
方正:它们是相辅相成的。由于通用模型在金融任务上的能力限制,只做Agent进化仍有效率和效果的瓶颈。与此同时,如果只做模型,那金融市场变化非常快,模型无法实时根据市场动态调整。
如果直接让通用大模型在金融任务上试错和进化,就像把基础能力不错的“高中生”送到华尔街,他成长为国际顶尖机构专业人士的进度,远不及直接引进具备扎实专业知识、高适应力的名校毕业生。训练金融专用模型,就是输出“AI金融名校生”。
我们希望Agent能够持续感知市场的变化,像人一样,慢慢沿着职业阶梯往上走。
暗涌:STAR自进化机制挖掘Alpha,和常见的Alpha挖掘有什么不同?这套机制会怎么用到产品里?
子辰:很不一样。一般大家会规定方向直接找Alpha。但我们的设计是让Agent进化成为一个很会找Alpha的研究员。
STAR加入了一个元认知模块,可以修改研究员的提示词、记忆、工具和研究流程。搜索时,也不只挑当前得分最高的个体,它会优先扩展能产生更强后代的谱系。论文里较少的进化步骤和成本,就将生成的因子使用的算子数量翻了将近7倍。
这些我们没有告诉它,都是它自主进化出来的。
反映到产品里,我们可以让用户定义自己想进化的方向。比如我现在有一个什么样的想法或者策略,你能不能通过STAR这套机制帮我进化,看看多少代之后会变得更好?这个是我们有机会做成“AI研究员”的能力之一。
暗涌:但论文的实验环境很简单,距离真正帮助机构做投资决策还有多远呢?
子辰:STAR这篇论文的核心目标并非优化单个Alpha因子,而是演化一个具备自主提炼能力系统的“Alpha研究员”。作为研究员,它能够综合市场现状、凝练思维框架、历史经验记忆及高阶数学算子工具,协同输出适配策略的量化因子。
这个世界上没有恒定的财富密码。
培养能够整合策略框架、经验与数学工具的研究型Agent,比单纯优化因子更具现实意义,也更契合人类研究员的工作逻辑。模型提出的因子,虽可通过不同样本及回测中的IC、IR和夏普比率等指标进行评估,但要将因子转化为最终的投资决策与收益,仍需历经投资组合构建、风险控制及交易执行等环节——这正是专业金融机构的标准运作流程。
现在机构大部分已经有自己比较成熟的机制,我们刚开始想做的是先融入进去。比如我给你一个好的Factor,你自己还有很多Factor,可以把它加进去做组合构建。
暗涌:怎么判断Agent给出的分析判断够不够专业?
方正:这里可以有很多方法,其中一种是将“高难度验证”转化为“低难度验证”。根据场景不同可以有很多具体实施细节,但其核心目标一致,即通过转换成正确性判定标准,简化整体验证流程。
不过,各种验证方法都无法完全取代行业最顶尖专家的重要性。我们有一个非常大的专家团来支持,他们是华尔街最顶尖的金融机构里的资深从业者,普遍有十几年、二十几年工作经验。
子辰:我举个例子。比如你问它怎么定价一个期权,普通的答案可能是看股票价格、波动率、股票的借款利率和股息率,这些都是教科书上能看到的东西。
但我们希望它能考虑到更多。比如这样的定价方式是否有对行业和同板块的分析,是否考虑到对未来事件的预测、对股票和行业未来资金流的分析等等。如果一个AI模型告诉我期权应该怎么定价,把这几点都说到了,我才觉得它在金融场景中是专业的。
Part03
未来之路
暗涌:FreerideAI首先想服务谁?他们最大的痛点是什么?
子辰:首先当然是希望金融机构和金融专业人士能满意。如果能做到,说明它达到了很高的智能水准。之后可以推广给更多普通人,这也是未来我们也想做的。
目前的问题是,大家根本不放心真的让AI协助投资决策。比如你问DeepSeek,明天该不该抄底?它会跟你说很多,看起来很专业,但有些回答存在AI幻觉,有些回答像教科书只给出概念。在专业的人看来,其实并不可用。
暗涌:现阶段,你们希望模型达到什么水平?什么时候能看到初步产品?
方正:近期要达到外资投行或者顶级对冲基金初级员工的能力,也就是有2到4年工作经验的员工水平。
随着模型训练越来越厉害,进化机制匹配得越来越好,再慢慢提高经验年限。当然,一开始是我们重点训练的场景和专业领域内,之后再逐步扩大事情的边界。
子辰:我们计划Q4推出初步Demo,到时候就可以看到一些特定场景的预演。衍生品定价是其中一个,未来还会逐渐泛化,扩展到二级市场交易、一级市场的投研等等。
暗涌:现在有密集接触投资人吗?什么时候准备启动下一轮融资?
子辰:最近主要在密集做产品研发和模型训练,等下个月Demo出来之后,再开始见一些投资人,准备融下一轮。
排版|郭栩君
图片来源|Unsplash
 Latent Labs:Alphafold 3 发布两年,AI 药物设计进展到了哪一步?作者:Daniel
编辑:Cage
我们认为,AI for Science 是 AI 继 Coding 之后的下一个重点方向。而药物发现又是其中最有前景的赛道。一方面,药物试验拥有完整反馈闭环且高度可验证,是实现 RSI 的理想场景。另一方面,AI 可以解放实验人员的产能,使得大量休眠靶点有重新开发的机会。我们有十足的理由相信,下一个药物大发现时代很可能便是由 AI 推动的。
AlphaFold 让我们看到了 AI 理解蛋白质结构的能力,而 AI 的下一个战场,是设计传统方法做不到的分子。这是一个激烈竞争的领域,除了从 Google Deepmind 中诞生的 Isomophic 之外,Chai Discovery、Boltz、 Latent Labs 也分别发布他们的预测模型与药物模态区别化下注。蛋白质从头设计也逐渐走近药物研发的实际应用。
Latent Labs 是观察这一变化的重要样本:创始人 Simon Kohl 曾参与 AlphaFold 2 的核心研发,押注了环肽这一新兴模态类型并选择自建湿实验室。2025 年 2 月,公司以累计 $5,000 万融资走出隐身状态,吸引了包括 Jeff Dean、Aidan Gomez 的天使投资。同年 7 月,发布了面向小蛋白与环肽的生成模型 Latent-X。并在 12 月用 Latent-X2 进一步覆盖纳米抗体和抗体片段,并关注表达、稳定性及免疫原性等成药相关性质;2026 年 3 月发布的 Latent-Y 则是在这些模型之上构建的科研 Agent。
不可否认的是,目前各家正在测试的蛋白质还没到可以成药的阶段。他们只是完成了流程的第一步:证明自己能够作为结合物发挥作用。如果我们把药物的研发比作登山,人类过去已经攀登过无数山峰,且资本市场也给予了创新者极其丰厚的回报。从 PD-1 到 CAR-T,再到近期大火的 GLP-1 都是很好的证明。但攀登的道路极其困难,往往需要数年+数十亿美元作为成本。AI 药物发现的目标,是把一条条狭窄的山路变成高速公路,且让人们向更高更危险的山峰发起冲击。
/
01.
Key thesis:
•蛋白质生成模型的出现颠覆传统制药流程,很可能带来一个药物大发现时代
传统药物发现是在庞大的真实分子库中寻找少数有效候选,生成模型则可以根据需求设计自然界不存在的分子。变化不仅是筛选效率提高,更是能够探索过去难以触及的分子空间。长期价值不只是“更便宜地做药”,而是让同样的研发资源能够探索更多项目,未来的药物研发可能打破“反摩尔定律”,实现质和量的大幅跃升。
•结合物发现环节高度可验证,是实现 RSI 的理想场景,Latent 湿实验室自建为竞争优势
在药物发现里面,设计结合物环境是最为可控,最容易产生 loop 的。结合本质上就是两个分子表面的形状互补 + 化学互补,有明确的物理规律,终点明确且反馈回路快。随着计算生成成本下降,稀缺资源将逐渐从候选分子转向高质量的实验反馈。Latent 逐步将实验能力放于内部,有机会更紧密地连接模型研发与实验判断。
•生物医药领域长坡厚雪,每种模态都会诞生领先大玩家, Latent 模态选择上有差异
行业内短期的催化是专利断崖正在发生,各大药企开始重视药物发现相关技术。不同模态面对的设计约束和开发难点不同,单一模型难以在所有任务上保持优势,制药公司也倾向与多家公司合作。大环肽是 Latent 最值得关注的切入口。它有机会覆盖传统小分子难以处理的结合界面,同时在部分场景中提供不同于抗体的药物属性。它也是目前的热门赛道,已有多款新药受到市场青睐。
•以 AlphaFold 成员为班底打造的明星团队
创始人 Simon Kohl 参与开发 AlphaFold 2,随后发起并共同领导 DeepMind 的蛋白质设计团队;创始技术成员 Alex Bridgland 曾参与 AlphaFold 1、2、3,覆盖模型开发、评估与数据工程。团队中多数成员拥有丰厚药物模型研发经验,与专注实验平台与内部湿实验室的科学家形成互补。团队还有前默克集团 CEO 作为顾问参与,为团队打进大型制药公司奠定基础。
02.
Latent Labs 技术路线
Alphafold 之后,从预测蛋白到生成蛋白
如果说以 AlphaFold 2 为代表的结构预测模型是一台“AI 显微镜”,帮助人们看清蛋白质的形状,那么蛋白质生成模型更接近分子世界的 CAD:根据功能需求,设计自然界中尚不存在的分子。
以蛋白质结合物设计为例,它是在反向求解蛋白质折叠问题。结构预测从一条氨基酸序列出发,判断它会形成什么样的三维结构;生成设计则从目标出发:给定一个疾病靶点和希望结合的表面区域,寻找能够稳定折叠,并与之结合的新序列。
一条设计蛋白质的典型流程是:
获得靶点结构→生成结合物的结构与序列→重新预测复合物结构→筛选候选→湿实验验证
2023 年发表的 RFdiffusion,让分子世界的 CAD 初具雏形。研究团队将原本用于结构预测的 RoseTTAFold 改造成去噪扩散模型,让它从随机噪声中逐步生成蛋白质骨架,再交给其他模型配上氨基酸序列、检查能否折叠成预期的形状。几个模型各司其职,组成了一条早期的蛋白质设计流水线:先画出轮廓,再补齐细节,最后检查。
自此,预测模型从观察一个分子,走向理解多个分子如何共同组成一个系统。AlphaFold 2 可以从氨基酸序列预测蛋白质的三维结构。2024 年 5 月,AlphaFold 3 将蛋白质、DNA、RNA 和小分子等纳入统一的复合物预测框架。这让研究人员在设计新分子时,多了一种检查它与靶点是否匹配的工具。
除了 Ismorphic Labs,不少公司也从这一层切入。比如 Chai Discovery、Boltz。2024 年 9 月,Chai 发布 Chai-1,预测多类生物分子的结构及其形成的复合物;同年 11 月,Boltz 团队发布 Boltz-1,并开放训练代码和模型权重。
而 Latent Labs 没有跟随先做结构预测的路径,而是直接做蛋白质生成设计。创始人Simon Kohl是参与开发 AlphaFold2 的核心人员和论文作者,Isomorphic Labs 当时正在沿着 AlphaFold 向多个药物研发方向扩张,而他认为蛋白质设计本身已经足够庞大,值得由一个更小、更灵活的团队集中突破。于是决定单独创业。他们的伦敦团队负责开发基础模型,旧金山则有湿实验室和计算生物团队,测试模型设计出的分子,将实验反馈用于模型研发,并采集训练数据。
2025 年,三家公司开始交生成模型的答卷,第一代生成模型相继亮相:
•6 月,Boltz-2 在结构预测之外加入结合亲和力预测,迈出了生成模型的第一步;
•同月,Chai-2 发布,成为第一个从零设计抗体的生成模型。
•7 月,Latent 发布首个模型 Latent-X,首先展示了环肽和小蛋白的从零设计能力。
•10 月,Boltz 推出生成模型 BoltzGen,正式进入结合物设计。
主力模型:Latent X
2025 年 7 月,Latent-X1 发布。
它首次公开展示了 Latent 的端到端全原子蛋白质设计能力。用户提供靶点序列、骨架结构和希望结合的热点后,模型联合生成新结合物的氨基酸序列,以及结合物—靶点复合物的全原子构象。
Latent-X 首先选择了大环肽(macrocyclic peptide)和小蛋白(mini-binder),而没有直接挑战完整抗体。团队在 7 个治疗相关靶点上进行湿实验,每个靶点最终测试 30 至 100 个设计。公司报告的大环肽命中率为 91%至 100%,mini-binder 为 10%至 64%,并获得了低纳摩尔乃至皮摩尔级 binder。
其中在环肽方面,Latent-X1 在三个靶点上的受测样品命中率达到 91%–100%,高于 RFpeptides 文献报告的 21%–38%,且在 MDM2 靶点的亲和力方面实现了更低的 KD 值。
RFpeptides 是华盛顿大学蛋白质设计研究所(IPD)开发的 AI 环肽设计方法,由 David Baker、Frank DiMaio 和 Gaurav Bhardwaj 三个实验室联合开发,可以理解为 RFdiffusion 面向环肽设计的延伸。
2025 年 12 月,Latent-X2 发布,目标是生成更接近药物的分子。
X2 可以输入指定表位,只生成关键结合区域,并把能力扩展到 VHH 和 scFv。团队对每个组合只测试 4 至 24 个设计,在 18 个靶点中的 9 个上获得成功,同时评估表达量、聚集倾向、多反应性、疏水性和热稳定性;部分代表性 VHH 还进行了人源供体的离体免疫原性实验。
•Agent 产品 Latent-Y
2026 年 3 月发布的 Latent-Y 是建立在 Latent-X1 和 X2 之上的 AI Agent。它把原本需要多位专业研究人员完成的蛋白质设计流程,封装成一个可以用自然语言操作的产品。Latent-Y 可以从自然语言目标出发,完成文献检索、靶点分析、表位选择、调用 X2 生成、计算验证和候选筛选。公司报告中,它在 9 个靶点里为 6 个找到了实验确认的 binder,为科研人员打造蛋白设计的“Cursor”。
按时间顺序排列的三家公司主要产品发布
Latent 的差异化下注
模态类型:环肽
从产品策略看,Latent 则先用大环肽与小蛋白展示生成模型的能力,再于 2025 年 12 月发布 Latent-X2,将设计范围扩展至 VHH 和 scFv 等抗体格式。环肽始终是这条产品路线中的重要组成部分。
环肽是近期比较热门的研发方向,它处在小分子与抗体之间的“中间地带”,容易进入细胞:它的接触面积大于传统小分子,因此有机会识别平坦的蛋白质相互作用界面,并有接近抗体的亲和力和特异性;环化又可能提高抗蛋白酶降解能力,可以作为口服、缓释药物。
比较出名的例子包括:
•强生与 Protagonist 合作开发的 icotrokinra,是一款靶向 IL-23 受体的口服大环肽药物,2026 年 3 月获美国批准用于中重度斑块状银屑病,预测峰值销售超 $50 亿。
•默沙东的 enlicitide ,一款靶向 PCSK9 的大环肽。2026 年 7 月获批,用于降低高胆固醇血症成人患者的 LDL-C,其 2033 年销售额预期超 $50 亿。
数据闭环:自建湿实验室
从 2024 年开始,Latent 便在旧金山运行湿实验室,并将实验验证作为模型研发的重要支点。从招聘信息可以看出,伦敦的 Computational Protein Designer 主要负责计算设计;旧金山的同岗位则额外要求较强的湿实验经验,需要亲自开展蛋白表达与纯化、生物物理表征和功能实验。
我们可以从 Latent X1 模型的实验论文了解内部实验平台的分工,以小型蛋白质结合物 mini-binder 为例,模型先为每个靶点生成约 2 万个设计,再根据预测结构选出 100 个候选进入实验,进入两条相互补充的验证路径:
•一条交给外部服务商 GenScript:先根据设计序列生产蛋白质,再用 BLI,检测它与靶点是否结合再进一步测量,确定结合强度及结合、解离的速度。
•另一条由 Latent 内部完成,采用的是哺乳动物细胞表面展示,简称 mDisplay。研究人员将编码候选蛋白的 DNA 导入细胞;随后加入靶蛋白,通过荧光信号观察候选是否成功展示、能否抓住靶点。
这套双重筛选方法,让研究人员能够在原理不同的结合检测平台上,交叉验证哪些候选真正命中了靶点。
在这里,Latent 的自建实验室与外部服务商是协同关系。DNA 合成、部分材料制备,以及蛋白质生产和仪器测量,仍然由外部机构承担;Latent 则将一部分验证环节放在内部,让计算设计人员能够更直接地接触实验结果。
如果说 X1 论文更像是在验证自己内部的实验能力,那么近期我们能看到公司在越发重视实验的迹象。2026 年 3 月,Latent 在旧金山招聘 Head of Lab Platform 与 Research Lab Scientist。希望招聘具有从零搭建实验室经验的人,进一步扩展现有的高通量实验、自动化和数据管理能力。在未来,Latent Labs 可能会把更多湿实验室环节放进内部。
携手 AWS 接入客户
2025 年 5 月,Latent Labs 与 AWS 宣布多年战略合作,覆盖模型训练与推理所需的云基础设施,以及面向生命科学客户的商业推广。Latent 提供生物生成式 AI 模型,AWS 则作为其首选云服务商提供算力支持。Latent 使用 Amazon SageMaker HyperPod 扩展计算资源,支撑模型研发和客户使用;同时借助 AWS 的合作伙伴网络与市场拓展支持,触达更多药企、生物技术公司和科研机构。
Latent 旗下模型也接入了 Amazon Bio Discovery 平台:这是 AWS 于 2026 年 4 月推出的 AI 药物研发应用,目前主要面向早期抗体发现。平台将生物 AI 模型、科研助手和外部实验服务整合到同一个工作环境:科研人员可以选择模型并评估候选分子,再将选定候选交给合作实验室测试。
该平台已公布的早期采用机构包括纪念斯隆凯特琳癌症中心(MSK)、拜耳、Broad Institute、Fred Hutch Cancer Center 和 Voyager Therapeutics。
03.
Why now
De novo design:从创造分子到 RSI
传统结合物发现的流程需要:
1.先准备一个非常大的真实分子库;
2.用噬菌体展示、酵母展示、动物免疫等方式做实验筛选;
3.从百万到十亿级候选中找到少量结合者;
4.再做亲和力成熟、特异性和成药性优化。
而 De novo design(从头设计) 彻底改变了研发的起点:研究者可以先指定靶点、结合位置和功能要求,再设计满足这些条件的新序列,将自然界中原本不存在的分子纳入药物发现。只合成模型排名最高的一小批。
AI 最明显的突破是压缩早期结合物发现的时间和实验规模。传统抗体发现采用动物免疫等路线,获得初始结合物通常需要数月;之后还要完成候选优化和临床前开发。参考药明生物的公开材料,DNA-to-IND 阶段的典型周期为 6–15 个月,对应$500 万- 800 万。
同样类比早期发现环节,Chai-2 针对 52 个抗原,每个靶点、每种抗体格式测试不超过 20 个设计,报告约 16% 的候选级结合命中率,并在一半靶点上获得至少一个结合物;从计算设计到湿实验验证,用时不足两周。
通过对蛋白生成设计发展的观察,我们可以看到:
从模型能力到工作流编排,再到干湿实验闭环,竞争正向完整研发流程延伸。随着基础预测能力正在快速开源化,Latent 与 Boltz 纷纷发力 Agent 编排与工作流,希望争夺成为这个领域的操作系统。下一阶段,差异化可能更多来自能否有效连接计算设计与实验验证,让实验结果持续反馈到下一轮设计中。
药物发现的未来,将逐步走向智能科学的 RSI:lab-in-the-loop 是实现这一愿景的重要基础。它将湿实验室接入AI的设计与决策循环,让每一轮实验既筛选候选,也为下一轮探索提供信息,从而以更低的总成本、更短的时间,获得足以支持项目推进或终止的可靠证据。而在结合物设计阶段,更容易形成闭环,相较于药物研发的后续环节,这一阶段的实验环境更可控,评价终点更明确,反馈周期也更短。分子结合主要取决于两个分子表面在形状和化学性质上的互补,并受到明确的物理规律约束。这些特征使结合物设计更容易形成“设计—实验—反馈—改进”的循环。
专利断崖正在发生,AI 加速新/旧靶点的开发
药物研发长期承受反摩尔定律的压力:Eroom’s Law 最初描述的是的 1950 年至约 2010 年间,每十亿美元研发投入对应的新药产出大约每九年减半。而AI可能是有潜力逆转这个趋势的技术。
而另一个大趋势是药企的专利断崖正在发生,根据 Evaluate 预测,我们即将迎来下一个专利到期的高峰。2026-2032 年,累计有超过 5000 亿美元销售额可能面临专利过期的风险,药企需要寻找下一个大药物。
专利断崖会迫使大药企更积极地采用 AI 技术、投资 AI 公司、与 AI 公司合作。Isomorphic、Chai、Boltz 近期接连签下大订单,背后都有大药企面对专利断崖、需要新管线的驱动因素。而具体看,AI 带来的机会集中在两个方向:
1.大量未开发靶点迎来重新开发的机会
药企长期积累了大量尚未完成的研发项,这些未被开发的机会远比已经上市的药物多。2024 年的一项系统研究估算,在人类 19,813 个蛋白编码基因中,约有 4,729 个可能被生物药调控,但只有 755 个已经成为获批药物的靶点。即便只看曾经进入临床开发的靶点和疾病,约 170 万种潜在的“靶点—适应症”组合中,也只有 2.5% 被实际探索过。
过去,药企很难系统性地重新检查这些项目,而蛋白生成模型的出现,给了研究人员大量开发难成药靶点的机会。Isomorphic Labs 与 Novartis 最初围绕 3 个高难度靶点合作,一年后又增加了最多 3 个项目,说明大型药企已经开始把真实的早研问题交给 AI 平台。
2.AI 做 me-better /best-in-class 的机会
AI 可以针对这些已验证靶点,设计出更好的分子,AI 可以探索传统方法覆盖不到的序列空间,可以找到完全不同的结合模式,实现跨越式改进。另外,AI 蛋白设计本质上是高维搜索和优化。老靶点已经积累了大量结构、突变、药理和临床数据。问题因此从开放式的生物学探索,变成了一个边界清晰的分子优化任务。
生物医药领域特殊的行业结构,也为多家企业一同创造价值提供了空间。专利保护使任何成功创新有机会获得持续回报,而不同疾病、治疗机制和患者群体又形成了多个独立的市场。企业既可以通过 first-in-class 开辟新的治疗路径,也可以通过 me-better/best-in-class 在疗效、安全性或用药便利性上建立优势。因此,一家公司即使只在有限的治疗领域取得突破,也可能通过自主销售、授权或并购实现较大价值。
因此,这是一个极其长坡厚雪的赛道,一条条成功的管线则是这个领域可被验证的节点。
下一个大制药公司可能在 AI 发现平台中诞生
全球药企每年约有 3,000 亿美元研发支出,其中,top 25 家药企约花费 1760 亿,占全球约 61%,头部集中度高的特性。其中临床前部分约占到研发支出的 15%,大约占到每年 450 亿。这 450 亿美元构成了 AI 药物发现最直接的第一层预算池。如果 AI 能够避免临床前阶段 20%–40% 的低价值试错,对应每年约 90 亿至 180 亿美元的经济价值。
AI发现平台的长期上行,来自将药物发现转化为一种能够持续积累、重复产出新资产的研发能力。一个分子的设计和筛选成本,只是项目总投入的一部分。如果靶点选择、疗效或安全性问题直到临床阶段才被发现,此前投入的时间和资金便可能难以收回。AI如果能够更早识别高风险项目,提高进入临床项目的平均质量,其经济价值会显著超过减少几轮筛选实验。
历史上,新一代平台型药企的出现,往往都发生在一次科学突破被工程化、工业化的窗口期。重组 DNA 技术催生了 Genentech;受体陷阱蛋白和全人抗体工程平台支撑了 Regeneron;核苷修饰和递送技术促成了 Moderna。AI 与这些技术的不同之处在于,它不是一种单独的治疗模态,而是一套可以横跨小分子、抗体、蛋白质和核酸的发现基础设施。因此,它理论上能够支撑的管线宽度更大,平台的上限也可能更高。
目前而言,最接近下一代制药公司的是 Isomorphic Labs,公司在 2024 年与 Lilly、Novartis 的合作,首付款分别为 4,500 万和 3,750 万美元;另有分别最高 17 亿和 12 亿美元的条件性里程碑,以及销售分成。
04.
竞争格局
目前在大分子领域,最为突出的竞争者分别是前 OpenAI、Meta FAIR 研究者 CEO Joshua Meier 创立的 Chai Discovery 和从 MIT Jameel Clinic 研究项目发展出来的 Boltz。他们的路线差异具体如下:
•Chai Discovery:专注抗体,Enterprise-first,强调模型性能和大药企深度部署。
•Boltz:专注开源模型 + API 的收费逻辑,主打全模块。让 Claude/Codex/ 药企内部 agent 组合工作流
•Latent Labs:环肽路线,拥有湿实验室。目前与 AWS 合作负责分发,在客户方面走 Chai + Boltz 的混合路线。
技术
尽管缺乏 head-to-head 数据直接对比,但从三家公开实验中,我们可以看到各家的侧重点有所不同:
•纳米抗体与小蛋白模态更像是 AI 的低垂果实,是各家开始时共同选择的方向,但仍处早期方向。
•小分子与抗体类药物目前最成熟成药最多,都有数千亿美元的规模。但可能面临 Isomophic 的竞争。
•Chai 从一开始就专注抗体领域,目前属于领先地位。
•环肽是近期较热门的新兴方向,且这个赛道目前 Latent 暂时领先。
商业化
Chai 是三家中合作最成熟、交易结构最清晰的,已经进入了大药企正式部署阶段。其特点是定制模型路线,利用制药公司的专有数据,并深入适配其工作流。Chai 已公开宣布与五家独立药企合作,且年度订单费用高达中八位数美元。根据测算,其年度订单规模可能已经高达 2 - 3 亿美元。
而 Boltz 走的是开源 + 基础设施路线,Boltz-1、Boltz-2 和 BoltzGen 形成了三家里最深的开放模型栈,产生明显的学术与产业分发。目前累计超过 500 万下载、被超过 10 万科学家和 1000 家公司使用,并覆盖前 20 的制药公司。公司已经推出 API 产品,与 Claude Science、Benchling、Phylo 等工具和平台的集成,作为其他科研平台的底层能力供应商。
在费用方面,参考 Boltz 对 BoltzMol-1 的描述,一个小分子从靶点到实验验证的初始hit,计算加实验预算约为 10,000–15,000 美元,耗时 3–8 周。收费量级相比闭源合作类型少了一到两个量级。
在商业合作方面,Boltz 获得了三家的医药公司合作订单,但跟 Chai 的模式不同的是,Boltz 并不保留平台开发产生的化合物所有权,因此更多扮演一个工具属性。
潜在范式竞争:Anthropic
Anthropic 是目前大模型公司中最看重 AI for Science 的,正通过大量科研实验和人才招聘进入生命科学领域。
在最近一次蛋白质设计实验中,Claude 根据操作手册自主查阅资料、制定设计策略,并调度专业模型生成和筛选候选分子,再由 Adaptyv Bio 和 Twist Bioscience 进行湿实验验证。
Claude 成功编排了多个开源蛋白质设计模型,生成了具有高成功率和高亲和力的结合剂。报告显示,整体结合命中率为 26.8%,15 个靶点中有 14 个获得结合分子。
这里 Claude 负责理解研究目标、选择设计策略并调度工具;具体到生成骨架、设计序列和预测复合物,仍由专有模型完成。从竞争格局看,通用模型公司与专业模型公司也可能形成上下游合作。通用 Agent 可能可以成为专业模型的分发入口。
另外,Anthropic 最近更新了一则招聘招聘企业发展负责人,主要职责为发掘并执行与 AI 原生生命科学公司的收购、投资和战略合作。说明 Anthropic 希望通过收购强化在生命科学中的地位。
05.
团队与融资
以 AlphaFold 为班底的核心团队
•Simon Kohl|创始人兼 CEO
早期在德国卡尔斯鲁厄理工学院(KIT)学习物理,随后在德国癌症研究中心与KIT开展医学影像机器学习博士研究。加入DeepMind后,是AlphaFold 2的核心研发成员之一、Nature论文同等贡献作者,参与了神经网络架构与训练开发。他还开发了广泛使用的结构置信度预测机制pLDDT,起并共同领导DeepMind的蛋白质设计团队。
•Paul F. Jaeger|Head of AI
现任 Latent Labs AI 负责人。此前在 Google DeepMind 参与面向药物研发的大语言模型研究,是 TxGemma 的关键贡献者,并参与将大语言模型用于单细胞分析的研究。更早在德国癌症研究中心完成博士研究并领导交互式机器学习团队,是医学影像分割框架 nnU-Net 的共同一作。
•Alex Bridgland|创始技术成员
曾参与 DeepMind 的 AlphaFold 1、2、3,积累了跨多代蛋白模型的研发与工程经验。他是 AlphaFold 2 Nature 论文的同等贡献作者,主要参与数据、分析与推理系统开发。加入 Latent 后,与 Simon Kohl 共同搭建最初的机器学习代码库,并参与 Latent-X 的模型架构、预训练方法及数据流程开发,是公司早期模型与工程系统的重要建设者。
•Stefan Oschmann|战略顾问
曾任德国默克集团 Merck KGaA CEO,拥有大型医药与生命科学企业的管理经验。2025 年 12 月宣布其担任 Latent Labs 战略顾问。
除此之外,团队还有两名曾在 David Baker 团队的研究人员,以及专注实验平台与内部湿实验室设计的多名科学家。
融资历程
Latent Labs 最新一轮为 2025 年 2 月 天使轮 + A 轮融资 5000 万美元。A 轮由 Radical Ventures 与 Sofinnova Partners 共同领投,早期投资方包括 8VC、Kindred Capital 和 Pillar VC。天使投资人则包括 Google 的 Jeff Dean、Transformer 论文共同作者 Aidan Gomez,以及 ElevenLabs 联合创始人兼 CEO Mati Staniszewski。
相比之下,Chai Discovery 的融资节奏最快、规模也最大。从 2024 年 9 月的约 $3,000 万种子轮起,公司在不到两年内连续完成 A、B、C 三轮融资,累计融资约 $6.3 亿。2026 年 7 月的 C 轮融资金额为 $4 亿,估值达到 $38 亿,由 Index Ventures 领投,Kleiner Perkins、Sequoia 等参与;OpenAI 和 Thrive Capital 则是其早期投资方。
Boltz 仍处于更早期阶段,于 2026 年 1 月完成 $2,800 万种子轮融资,估值为 $1.25 亿。投资方包括 Zetta Venture Partners、Amplify Partners、a16z 和 Factorial Capital,个人投资者包括 Hugging Face 联合创始人兼 CEO Clément Delangue。
 Dell Q2 财报:一切都变了(评级上调)执行摘要
Dell Technologies Inc.(DELL)最新这份财报,几乎让人很难找到什么可以批评的地方。2027 财年第二季度,客观来说,是一个非常出色的季度。
在我上一篇文章里,我的态度要保守一些。当时股价已经大幅上涨,而最重要的是,我仍然在问自己一个问题:Dell 现在是不是只是非常擅长卖大量 AI 服务器,还是说它本身也正在变成一家更好的公司?这两件事并不是一回事。如果大量新增销售收入最终只是流向 Dell 无法控制的昂贵零部件成本,那么这些收入增长本身并不会创造太多价值。
2027 财年第二季度基本给了我所需要的全部答案。Dell 宣布收入创下历史新高,达到 470 亿美元,同比增长 58%;非 GAAP 摊薄 EPS 也创下纪录,达到 7.04 美元,同比增长 203%。Dell 同时宣布,本季度 AI 服务器订单达到 609 亿美元,AI 服务器在手订单已经达到 950 亿美元。不过,对我来说最重要的数字其实是 ISG 的营业利润率达到 15%,相比一年前 8.8% 的营业利润率提高了大约 6.2 个百分点。这意味着公司并不仅仅是卖出了更多产品,而是从这些产品上真正赚到了更多的钱。
【原文图片位置:Dell 2027 财年第二季度业绩摘要(Company Presentation)】
Dell 还将 2027 财年收入预期从 1,670 亿美元上调至 1,920 亿美元,同时将非 GAAP EPS 指引从 17.90 美元大幅提高至 25.50 美元。
【原文图片位置:Dell 2027 财年收入及 EPS 指引上调(Company Presentation)】
股价也对此做出了积极反应,在常规交易时段以大约 425 美元收盘后,盘后上涨约 8% 至 459 美元附近。
【原文图片位置:Dell 财报后股价表现(Agar Capital,Bloomberg Terminal)】
基于这些原因以及后文还会讨论的其他因素,我将 Dell 的评级从“持有(Hold)”上调至“买入(Buy)”。我没有直接上调至“强烈买入(Strong Buy)”,因为我不希望在当前价格追高,尤其是公司仍然存在估值、现金转化以及供应链方面的问题,这些因素让我无法完全忽略风险。不过,即便如此,今天继续维持“持有”评级已经很难说得通。
此前的分析:等待是合理的
我最早对 Dell 进行分析是在 2025 年 11 月。当时 Dell 股价约为每股 139 美元,我给予其“强烈买入”评级,并给出了 180 美元的长期目标价。根据我的研究,当时给予“强烈买入”的核心理由是,市场尚未充分反映 AI 服务器销售增长可能为 Dell 收入和未来盈利带来的巨大提升。在我给出“强烈买入”评级之后,Dell 股价最终上涨至三倍以上。
【原文图片位置:Dell 作者历史评级(Seeking Alpha)】
到今年 8 月时,Dell 股价已经达到 453.77 美元,也就是在那个时候,我将对 Dell 的评级调整为“持有”。我依然非常看好 Dell 的商业模式,但我不再认为按照当时的估值,股票仍然拥有足够大的上涨空间来支持继续建立多头仓位。自从我将 Dell 下调至“持有”之后,虽然期间股价一度高于我下调评级时的价格,但在这次季度财报发布之前,最终还是回落到了 425 美元。我认为这一点非常重要,因为这让我可以耐心等待此前缺失的证据,而不需要追逐市场叙事。
一份几乎挑不出毛病的季度财报
让我们再更详细地看一下这份最新季度财报的财务数据。正如我前面提到的,公司收入同比增长 58% 至 470 亿美元。ISG,也就是基础设施业务,收入同比增长 89%,达到 318 亿美元。
【原文图片位置:Dell 2027 财年第二季度收入增长(Company Presentation)】
AI 服务器收入同比增长 100%,达到 164 亿美元。传统服务器与网络业务收入增长 122% 至 105 亿美元。存储业务收入增长 26% 至 49 亿美元,而我认为存储业务尤其重要,因为它有助于提升整体收入结构的经济质量。CSG,也就是主要由 PC 构成的客户端解决方案业务,收入也增长了 20%。简而言之,并不是只有一个增长引擎在运转,而是几乎整个产品组合都在加速。
【原文图片位置:Dell 各业务收入增长(Agar Capital,Bloomberg Terminal)】
Dell 披露的第二个极其重要的数据是订单。在单个季度内,Dell 新增 AI 订单达到 609 亿美元,而过去 12 个月累计 AI 订单已经超过 1,300 亿美元。这使得公司在手订单从上一季度的 513 亿美元增长至 950 亿美元。Dell 预计第三季度 AI 服务器收入大约为 190 亿美元。如果进行非常粗略的计算,目前 950 亿美元的在手订单大约相当于五个季度这样的收入运行率。当然,我们绝不能简单地把在手订单理解成未来五个季度完全确定的收入,但拥有如此巨大的订单储备,显然让公司的收入可见度相比过去一年高出了很多。
Dell 的指引也大幅降低了市场对这是否只是一个单季度异常现象的担忧。具体来说,公司预计第三季度收入达到 490 亿美元,调整后 EPS 为 6.50 美元。同时,对于截至 2027 年 1 月 29 日结束的整个财年,公司预计总收入达到 1,920 亿美元,AI 服务器收入达到 740 亿美元,调整后 EPS 达到 25.50 美元。
让我改变观点的三个因素
真正让我改变对 DELL 看法的第一个因素,就是它的在手订单。DELL 目前拥有 950 亿美元的 backlog。在手订单达到这种规模之后,“AI 需求到底是不是真实存在”这个争论基本可以结束了。
【原文图片位置:Dell AI 服务器在手订单(Agar Capital,Bloomberg Terminal)】
接下来的问题变成了:Dell 能以多快的速度,通过自己的 Dell AI Factory 把已经卖出去的这些设备真正交付出去?值得注意的是,目前在手订单规模甚至还小于公司的潜在销售管线,而后者还在继续增长。目前使用 Dell AI Factory 解决方案的客户数量已经超过 6,500 家,这是一个非常庞大的数字。
【原文图片位置:Dell AI Factory 客户数量(Seeking Alpha)】
因此,这个故事已经不再局限于 Microsoft、Google 和 Amazon 这三大超大规模云服务商。Dell 的客户还包括 NeoCloud、政府以及大量企业客户。因此,公司的客户基础正在变得更加多元化,而这是一个积极变化,因为公司服务的客户越多,集中度风险通常就越低。
不过,真正让我用完全不同方式来看待这只股票的最重要因素,还是利润率。几个月前,我的问题是:Dell 到底只是非常会卖 AI 服务器,还是它能够在这些服务器上维持较高利润率?现在这个问题已经得到了回答。非 GAAP 营业利润率从 7.7% 上升至 12.6%,而 ISG 营业利润率从 8.8% 提高至 15%,ISG 营业利润同比增长 225%。这里最关键的一点是,Dell 的利润增长速度远远超过收入增长速度,而这正是我一直希望看到的东西。
【原文图片位置:Dell 营业利润率及 ISG 盈利增长(Agar Capital,Bloomberg Terminal)】
在我看来,另一个非常重要的数据是 Dell 正在传统服务器市场获取市场份额。过去两个季度,公司在传统服务器业务中的市场份额累计提升了超过 10 个百分点。
【原文图片位置:Dell 传统服务器市场份额变化(Agar Capital,Bloomberg Terminal)】
还有哪些地方没有完全说服我?
整体表现几乎完美,但仍然存在一些让我无法有足够信心直接把评级从“持有”提高到“强烈买入”的问题。
现金流
第二季度经营现金流下降至 22 亿美元。自由现金流下降至 9.86 亿美元,而 2026 财年第二季度为 18.7 亿美元。此外,公司披露,本季度调整后自由现金流(AFCF)达到 81.5 亿美元。虽然 AFCF 确实可以解释自由现金流指标中存在的一些差异,但这两个指标之间的差距如此之大,仍然让我希望未来持续同时跟踪二者。
【原文图片位置:Dell 经营现金流及自由现金流(Agar Capital,Bloomberg Terminal)】
营运资本
正如前面提到的,为了支撑这种增长速度,Dell 需要投入大量资金。自本财年开始以来,公司库存水平已经翻了一倍以上,而应收账款增加了大约 30%。考虑到 Dell 在这段时间经历了如此快速的增长,营运资本增加本身是可以理解的,但它也意味着,相当大的一部分收入增长目前尚未真正转化为现金。
【原文图片位置:Dell 营运资本变化(Agar Capital,Bloomberg Terminal)】
供应链
管理层已经向投资者表示,公司目前在内存、CPU、硬盘以及其他各种零部件方面面临一定的供应链紧张。从表面上看,高需求和供应紧张听起来似乎属于“幸福的烦恼”,但归根结底,它仍然是一个物流和执行问题。950 亿美元在手订单当然非常惊人,但最终真正有价值的前提是,公司能够把这些订单转换为实际交付产品,再进一步转换成收入以及现金。
估值
我上一篇文章使用的是大约 22.20 美元的 FY28 调整后 EPS 预测,并给予 18 倍市盈率。基于这些数字,我认为 Dell 的合理价值大约在 400 美元附近。即使当时,我也认为 18 倍对 Dell 来说已经是一个相对慷慨的估值倍数。但在这次季度业绩以及随后上调的 FY27 指引之后,这个盈利预测现在看起来已经明显过于保守。Dell 目前预计 FY27 调整后 EPS 达到 25.50 美元,甚至已经高于我此前对 FY28 给出的 22.20 美元预测。
【原文图片位置:Dell EPS 预期变化(Agar Capital,Bloomberg Terminal)】
按照盘后大约 459 美元的价格计算,Dell 当前对应最新 FY27 EPS 25.50 美元指引约 18 倍市盈率。对于一家硬件公司来说,这并不算便宜。不过,我今天愿意支付 18 倍估值的理由,与几个月前完全不同:公司正在实现极高的收入增长,拥有 950 亿美元 AI 服务器在手订单,利润率正在上升,而且盈利增速已经超过收入增速。
因此,我认为上调目标估值倍数也是合理的。我最新的目标价为 550 美元,相当于 FY27 EPS 25.50 美元的大约 21.6 倍。相较于盘后约 459 美元的股价,这意味着大约还有 20% 的上涨空间。
相比我此前采用的 18 倍估值,这确实是一次幅度不小的重估,因此我并不认为 550 美元是一个保守目标。Dell 仍然需要证明自己能够把在手订单真正转换为收入,维持经营杠杆,并且继续实现盈利增长,而不是只经历一次性的业绩爆发。不过,由于在手订单已经显著提升了未来收入可见度,我认为今天这个更高的估值倍数比过去更容易得到支撑。
核心结论
正如我此前所说,我上一篇文章给予 Dell“持有”评级,其核心其实建立在一个非常简单的问题之上:Dell 能不能把 AI 带来的潜在赚钱机会,真正转化成实际利润?至少截至目前,公司最新季度财报给出的答案已经非常明确:可以。
除此之外,Dell 的 AI 在手订单已经达到 950 亿美元,单季度新增订单达到 609 亿美元,ISG 营业利润率提升至 15%,存储和传统服务器业务继续保持强劲增长,同时 2027 财年 EPS 预期从 17.90 美元提高至 25.50 美元。越来越多证据表明,Dell 可能正在证明 AI 能够对整个产品组合产生真正积极的经济影响,而不仅仅只是创造额外收入。
话虽如此,Dell 依然面临几项重要风险,包括现金转化和营运资本问题、供应链扰动,以及一个几乎不给执行失误留下太大空间的估值水平。这也是为什么我没有重新给予“强烈买入”评级。不过,数据已经发生了足够大的变化,因此我将 Dell 的评级从“持有(Hold)”上调至“买入(Buy)”。
 Lam Research:买入夏季回调(评级上调)引言
今年 5 月初,我曾对 Lam Research Corporation(LRCX)截至 3 月季度的业绩进行分析,并得出结论:公司增长强劲,利润率也在持续扩张。不过,当时我认为,公司对中国市场潜在风险的敞口较大,而且其溢价估值似乎已经充分反映了稳健的基本面,因此我当时保持了相对谨慎的态度。
【原文图片位置:评级历史(Seeking Alpha)】
在那次更新发布后,Lam Research 股价迎来了一轮不错的上涨,但自 6 月底见顶之后,股价已经出现了相当明显的回调。7 月底,这家芯片设备巨头公布了截至 6 月季度的业绩。今天,我们将看看这些数据,以及 Lam Research 计划如何进一步强化自己的竞争优势。最终,这篇文章的目标是判断,这轮夏季回调是否值得买入。
增长正在加速
【原文图片位置:Lam Research 收入增长走势图(YCharts)】
从 Lam Research 2026 财年 6 月季度的营收表现来看,很明显 AI 带来的顺风正在发挥作用,而且目前很可能还在进一步增强。公司实现总收入 67.2 亿美元,同比增长 30%,这意味着收入增速进一步加快。
Lam Research 更习惯报告环比变化,而如上图所示,环比增速同样没有令人失望。事实上,相比 3 月季度,公司收入增长 15%,这是过去几年中幅度最大的单季度环比增长之一,而且领先幅度相当明显,因此可以看到非常强的行业顺风。Lam Research 的收入还比分析师预期高出 5,093 万美元,这进一步说明公司实际业务活动强于市场预期。
另一个反映当前需求强劲的指标是库存周转率,公司库存周转率从 3 月季度的 2.9 次提高至 3.0 次,而去年同期仅为 2.4 次。这说明公司的产品并没有长时间积压在库存中。
存储业务顺风非常明显
【原文图片位置:存储业务收入结构(Lam Research June Quarter Slides)】
进一步观察公司的收入结构,可以明显看到存储业务一直是 Lam Research 的重要增长驱动力。考虑到目前存储市场供应有多么紧张,这并不令人意外。如右图所示,在 2026 财年 6 月季度,存储业务占公司系统收入的 46%,高于上一季度的 39%,也高于去年同期的 41%,这是一个非常清晰的信号,表明芯片制造商正在积极采购设备,以扩大存储芯片生产能力。有意思的是,DRAM 占系统收入的比例环比实际上略有下降,但同比依然明显提高,这说明数据中心对存储的消费需求仍然强劲。鉴于许多存储芯片厂商都在专注于提高长期产能,我认为未来几个季度乃至未来数年,存储业务都会继续为 Lam Research 提供顺风。因此,如果未来存储业务占收入的比例继续提高,我并不会感到意外。
中国市场风险正在下降
【原文图片位置:Lam Research 按地区收入构成(Lam Research June Quarter Slides)】
在上一篇文章中,我认为中国市场正成为 Lam Research 越来越大的风险。但在 6 月季度,这一风险似乎已经有所缓解。如右图所示,6 月季度公司有 26% 的收入来自中国,相比上一季度的 34% 和去年同期的 35% 都出现了明显下降。这意味着公司对于一个存在较高地缘政治和监管风险市场的依赖程度正在降低。更值得注意的是,Lam Research 在减少对中国市场依赖的同时,还能够加速整体收入增长,这一点非常令人印象深刻。这也说明,中国以外市场对公司设备的需求到底有多么强劲。不过,投资者仍然应该留意一些持续存在的风险。正如上图所示,中国依然是公司的第二大地区市场,因此 Lam Research 仍然可能受到美国出口管制,或者中国政府政策变化的影响。
强劲的利润率
【原文图片位置:Lam Research 利润率表现(Lam Research June Quarter Slides)】
除了强劲增长之外,Lam Research 在 2026 财年 6 月季度也交出了非常优秀的盈利表现。首先,公司非 GAAP 毛利率无论环比还是同比都有所扩张。在 3 月季度,公司报告的非 GAAP 毛利率为 49.9%,而去年同期为 50.3%。很明显,业务组合对毛利率改善发挥了重要作用。无论环比还是同比,公司客户支持相关收入及其他业务的增长速度,都快于系统收入,而前者本身天然就具有更高利润率。此外,毛利率的增长也可能反映出公司在供应紧张市场中的强大定价能力。
对于非 GAAP 营业利润率,如上图所示,公司在 6 月季度实现了 38.4%,明显高于上一季度的 35.0%,也高于去年同期的 34.4%。这一扩张幅度甚至比毛利率还要更加显著,因此 Lam Research 对营业费用的控制可以说非常优秀。在利润端,公司实现调整后 EPS 1.82 美元,同比增长 37%,而且相比分析师一致预期高出 8.10%,表现非常强劲。因此,目前盈利能力显然不是投资者需要担心的问题。
另一个值得关注的变化是,公司股票回购规模出现了相当明显的下降。在 3 月季度,公司回购了价值 7.96 亿美元的股票,而 2025 财年 6 月季度回购金额达到 13.07 亿美元。但在今年 6 月季度,公司只回购了 2.46 亿美元股票。这可能意味着,公司认为当前自身股价已经有些偏贵,如果继续回购,可能反而侵蚀股东价值。稍后我们会更详细地看看公司的估值。
财务展望
【原文图片位置:Lam Research 2026 财年 9 月季度指引(Lam Research June Quarter Slides)】
对于 2026 财年 9 月季度,公司预计收入约为 81 亿美元,这一数字远超市场一致预期,并意味着同比增长 52%。这将比 6 月季度已经相当亮眼的增长进一步显著加速。到了这个阶段,虽然仍有一些人担心半导体繁荣可能很快结束,但实际情况看起来恰恰相反,行业顺风似乎仍然在增强。
对于非 GAAP 毛利率,公司预计将达到 52.0%,高于去年同期的 50.6%。因此,客户支持相关收入的增长可能继续跑赢其他业务,同时公司的定价能力也应该继续保持强劲。与 6 月季度类似,9 月季度营业利润率的扩张速度预计也将快于毛利率扩张,因此公司费用纪律仍然会持续。在利润端,公司预计 EPS 将达到 2.15 美元,同比增长 71%,这再次说明盈利能力完全不是目前需要担心的问题。
如果把时间维度拉得更长,投资者还能看到更多积极信号。首先,公司强调,CY2027 及之后的业务环境“极其出色”。公司表示,“客户已经公布了多个持续数年的新晶圆厂项目时间表。”这进一步强化了行业顺风具有持续性的逻辑。此外,在财报电话会议上,执行副总裁 Bettinger 提到,公司未来几年目标是把毛利率提升至 50% 中段区间,把营业利润率提高到 40% 中段区间。因此,Lam Research 最好的日子很可能还在后面。
投资创新
毫无疑问,Lam Research 长期最核心的竞争优势之一就是创新。在一个半导体性能如此重要的世界里,谁能在技术上领先竞争对手,谁就能够长期推动客户采用并持续扩大市场份额。最近的一些进展表明,Lam Research 正在进行相当大规模的投资,通过创新进一步强化自己的竞争优势。
今年 8 月中旬,公司宣布,未来五年将向其研发实验室网络投资 30 亿美元。在新闻稿中,CEO Tim Archer 表示:
在 AI 时代,创新速度极其迅猛,这要求芯片采用新的架构、不同的材料,以及以纳米级精度制造的复杂结构。我们提高整个研发流程速度的能力,已经成为决定性竞争优势。
这与我上面刚刚表达的观点是一致的。需要指出的是,这些研发投资绝不是某个遥远的长期目标,而是公司现在就正在加大投入。就在几天前,Lam Research 为位于 Oregon 州 Tualatin 的研发中心举行了奠基仪式。COO Sesha Varadarajan 表示:
我们新的 Oregon 先进实验室预计将进一步强化公司的专业能力,并增加数万平方英尺具有高度价值的洁净室空间,从而帮助我们与客户进行更加紧密的合作,同时增强全球实验室网络的专业能力和覆盖范围。
除了提升自身创新能力并强化竞争优势之外,我认为这些投资和承诺也再次说明,管理层对未来 AI 顺风的持续性和耐久性非常有信心。
当前风险收益比已经变得具有吸引力
【原文图片位置:Lam Research 前瞻市盈率走势图(YCharts)】
6 月底时,Lam Research 的前瞻市盈率还在 70 倍以上。此后股价有所回调,但需要明确的是,估值倍数的大幅下降同样是由市场不断上调增长预期推动的。目前前瞻市盈率已经下降至 31.87 倍,低于我上一篇更新文章中看到的 45.25 倍。我认为,对于投资者来说,当前风险收益比已经变得具有吸引力。
今天的分析已经表明,公司收入增长正在加速,而且利润率正在改善。库存周转率表明市场需求依然稳健,而存储业务显然已经成为公司业务增长的重要催化剂。中国依然是投资者需要关注的重要风险,但公司对这一市场的依赖程度已经有所下降。此外,随着 9 月季度指引表现强劲,同时公司继续投资创新,我认为 Lam Research 最近一段时间的业务前景已经显著增强。
自我上一篇更新文章发布以来,Lam Research 股价上涨了大约 13%,因此再次强调,估值倍数收缩主要还是因为市场不断上调盈利目标。不过,即使股价已经上涨,当前风险收益比似乎仍然变得更好了。截至本文撰写时,Seeking Alpha 显示 Lam Research 的前瞻非 GAAP PEG 只有 1.19 倍,甚至比 IT 行业中位数略低。对于一家我们所熟知的 AI 革命关键推动者来说,我认为这样的估值意味着机会。
总结
过去 52 周 Lam Research 股价已经上涨超过 200%,毫无疑问,有一些投资者会认为自己已经错过了这轮上涨。不过,经过今天的分析,我认为,从当前位置出发,公司股价仍然有很大概率继续跑赢市场。总结来看,自我上一篇更新文章发布以来,Lam Research 的基本面和业务前景总体上都变得更强,而风险则有所下降。与此同时,估值已经回落,因此在我看来,风险收益比已经明显转向有利于多头。对于那些一直等待首次建立仓位,或者希望在现有仓位基础上继续加仓的投资者来说,我认为自 6 月底以来的这轮股价回调创造了一个不错的建仓机会。因此,我将 Lam Research 的评级上调至“买入(Buy)”。
 卓銳證券「AI·CRYPTO 全球資產配置」線下主題論壇吸引近200名投資者八家資管與數位資產機構同場 共探雙主線配置新範式
(香港,2026 年 8 月 27 日)適逢 Bitcoin Asia 2026 在港召開,由卓銳證券(香港)有限公司(下稱「卓銳證券」)主辦的「AI·CRYPTO 全球資產配置」主題論壇,於今日下午在香港萬麗海景酒店舉行。論壇聚焦 AI 與數位資產雙主線驅動下的宏觀週期研判,現場吸引近 200 名投資者參與,互動環節反應熱烈。
論壇匯聚華夏基金(香港)、易方達基金(香港)、Animoca Brands、VDX、BE Trust、Metalpha、BigQuant、北水金控等機構的業界領袖,議題涵蓋數位資產 ETF 的發展路徑、比特幣的機構化進程以及 AI 算力週期的資本傳導,回應投資者在雙主線交匯下對配置方向的關注。
圖註:「AI·CRYPTO 全球資產配置」論壇現場,吸引近 200 名投資者參與。
宏觀研判:AI 牛市能否繼續,需要爆款應用持續接力
卓銳證券基金經理 Jerry Ou 以「AI 與比特幣雙重敘事下的全球資產配置展望」為題發表主題演講,從宏觀週期出發拆解兩條主線對全球資金流向的影響。
他指出 AI 是過去三年美股牛市的絕對主力,而目前 CAPEX 已經到了 CSP 自由現金流轉負的時刻。繼續高強度 CAPEX 只能靠巨額借債,這要求 AI 應用在 2030 年形成 1 萬億美元 ARR(vs.2026 年才 1 千多億美元)才夠還債。目前全球 AI to C 商業化都沒跑通,今年 ARR 大漲幾乎全靠 Anthropic 跑通了 AI to B,主要是編程 AI 取代程式設計師,這導致美國程式設計師職位大幅萎縮,尤其是應屆畢業生。然而,非農就業總人數為何未見顯著下滑,主要是因為 AI 數據中心建設產生的新工作崗位大多位於共和黨執政州和關鍵搖擺州。接下來,AI to B 的爆款應用方向主要在金融、法律、諮詢等高薪白領崗位。而最終衝上 1 萬億美元 ARR,則需要 AI+機器人跑通,目的是大幅降低勞動力成本,實現美國製造業回流。目前 AI 股票尤其是半導體的估值已經處於歷史頂峰,但是否回落甚至轉熊關鍵要看上述 AI 爆款應用能否持續接力,2000 年代科網泡沫破裂是三重利空的意外疊加。
至於比特幣,他認為按四年減半規律,當前處於熊市週期階段,而熊市底部價格通常由挖礦成本決定。
圖註:卓銳證券基金經理 Jerry Ou 就 AI 與比特幣雙重敘事下的資產配置展望發表主題演講。
配置視角:比特幣與主要資產相關性低,配置價值受關注
華夏基金(香港)投資組合管理總監 William Kung以「比特幣新機遇」為題分享。他從資產配置角度指出,過去十年比特幣與主要資產類別的相關性很低——與標普 500、納斯達克 100 的相關係數分別為 0.17 與 0.19,與黃金、債券則接近於零,具備獨特的風險收益特徵。以過去五年的回測為例,在傳統 60/40 組合中納入比特幣,配置比例較高的組合表現相對更佳。
就市場空間,他提到數位資產目前占全球財富總量的比重不足 0.4%,比特幣市值約相當於黃金的 3.5%。機構資金的動向亦在同步變化:根據截至 2026 年 8 月中旬的 13 F 申報,摩根士丹利與摩根大通的比特幣相關敞口環比分別增加約 3.7% 與 12.2%,以太幣相關敞口增幅更為顯著。他並指出,第四次減半後,效率最高礦工的現金生產成本約在 6 萬美元附近,可作為觀察支撐位的參考。
圖註:華夏基金(香港)投資組合管理總監 William Kung 分享比特幣的配置價值與下半年展望。
圓桌一|比特幣的機構化進程
首場圓桌由 Techub News 聯合創始人 Bobby 主持,VDX 首席戰略官 Paolo、Animoca Brands 投資與戰略合作總監 David Ching 及 BE Trust 投資總監 Yaney 參與討論,議題聚焦 ETF、流動性與新一輪市場週期。三位嘉賓的共同判斷是:這輪上漲並非週期反轉,而是流動性預期、ETF 淨流入與空頭回補疊加的階段性修復。更值得關注的是交易結構的變化。BE Trust 投資總監 Yaney 形容,市場正處於「早期持幣者向華爾街機構換手的關鍵階段」,四年一輪的週期效應正在弱化,波動率將逐步向成熟大類資產收斂。VDX 首席戰略官 Paolo 亦觀察到比特幣與納斯達克科技資產的相關性持續走高,已成為機構眼中的高 Beta 資產。
圖註:圓桌一「比特幣的機構化進程:ETF、流動性與新一輪市場週期」討論現場。
產業滲透:成本下降,反而推高算力需求
易方達香港數碼營銷總監 Sapphire Wang 則從產業滲透與需求端切入,分享 AI 時代的投資新格局。她引述史丹福大學 2026 年 AI Index 報告指出,全球企業的 AI 採用率已超過 88%,滲透速度明顯快於互聯網普及初期。就算力需求的走向,她以傑文斯悖論作解釋:模型推理成本下降並不會減少總消耗,反而因應用場景擴張,推動 Token 與算力需求進一步上升。
她並提到中美 AI 產業鏈高度互補——美國主導模型層與算力晶片,但發電量相對不足,數據中心擴張受制於電力供應;中國掌握光模組、PCB 等硬體產能與能源優勢,先進製程則依賴進口。單一市場難以形成閉環,兩者互為必要條件。
圖註:易方達香港數碼營銷總監 Sapphire Wang 就 AI 時代的投資新格局發表主題演講。
圓桌二|算力新週期:從晶片到雲端,資本開支如何傳導為投資機會
第二場圓桌由卓銳證券市場副總裁 Miranda 主持,BigQuant 首席執行官梁舉、北水金控聯合創始人 Kylie Li 及 Metalpha 生態負責人 Max參與討論。議題圍繞 AI 資本開支沿產業鏈向下游延伸後,投資機會分佈的變化。三位嘉賓認為,近期 AI 資產回撤是高位擁擠交易的出清,而非產業週期見頂——產業仍在高速成長,只是商業化兌現跟不上炒作預期,二級市場估值已明顯透支。Metalpha 生態負責人 Max 將當前的 AI 行業類比早期的區塊鏈行業:「基建投入巨大、資本熱度極高,但真正跑通閉環、持續盈利的應用仍然稀少。」機會的位置也在移動——從堆算力轉向降本與落地,定製晶片、光通信、液冷、電力基建等效率優化環節,以及垂直應用層,被視為下一階段的主戰場。
圖註:圓桌二「算力新週期:從晶片到雲端,資本開支如何傳導為投資機會」討論現場。
跨界對話延續至會後
論壇最後設自由交流環節,與會機構代表就各自關注的議題繼續深入交流。公募基金、數位資產投資平台與量化科技公司,過往關注重點各有不同,但隨著數位資產合規化推進與 AI 產業週期演進,其面臨的核心課題日趨接近:在市場變數增多、週期縮短的環境下,如何建立清晰且可複製的配置方法。
從傳統證券到虛擬資產,從香港到新加坡、澳洲,卓銳證券正沿著同一條路徑推進——讓不同類型的資產,回到同一張配置表上。目前,卓銳證券持有香港證監會第 1、2、4、5 及 9 類牌照,其中第 1 類牌照已獲批面向專業投資者及零售客戶提供虛擬資產存入、交易及提取的全流程服務;自主研發的一站式平台 ZR,讓投資者以單一帳戶完成股票、ETF 與虛擬資產的配置。
「成為備受信賴的全球金融科技平台」——這是卓銳證券的願景,也是舉辦本次主題論壇的初衷。公司表示,未來將持續圍繞全球資產配置議題舉辦更多線下交流活動,與投資者一同把握雙主線下的市場機遇。
風險提示:嘉賓發言僅為個人觀點分享,不構成任何證券、金融產品或工具要約、招攬、建議、意見或任何保證。
 Nvidia 刚刚彻底击碎了空头逻辑,而股价依然被低估三个月前,我写道 Nvidia Corporation(NVDA)刚刚交出了我所关注的所有公司中最好的一份季度业绩。如今,它又超越了自己。NVDA 公布了 2027 财年第二季度业绩,交出的数字在如此巨大的体量下几乎令人难以置信。NVDA 实现收入 962.2 亿美元,同比增长 105.85%,比管理层今年 5 月给出的 910 亿美元指引高出 52.2 亿美元。NVDA 实现非 GAAP EPS 2.22 美元,比市场一致预期的 2.09 美元高出 0.13 美元,同比增长 119.80%。季度收入环比增加 146.1 亿美元,超过了 NVDA 仅仅一个季度前刚创下的纪录,这也是公司连续第 4 个季度实现同比增速加快。通常来说,一家公司在年化收入运行率达到 3,850 亿美元时,不应该还能继续加速增长,但这正是 NVDA 现在正在发生的事情。如果这还不够,管理层还给出了第三季度 1,080 亿美元的收入指引,并做了一件 NVDA 过去从未做过的事情。Colette Kress 首次对 2028 财年给出了初步数字,并告诉市场预计收入增长约 70%。她明确表示,这还是一个受供给限制的展望,因为客户预测显示需求实际上可能翻倍,而 Jensen Huang 在问答环节也证实了这一点,他表示实际需求远高于 70%,真正限制增长的是供给。我原本带着一个问题进入这次财报:我今年 5 月提出的资本回报逻辑是否依然成立。结果出来后,我反而认为空头逻辑是在这场电话会议中被现场拆解掉了。本季度,几乎所有针对 NVDA 的主要空头论点都被正面回应,而股价当前的估值倍数依然没有反映管理层刚刚告诉我们的这些信息。
【原文图片位置:NVDA 股价及相关数据(Seeking Alpha)】
继续跟进我此前关于 Nvidia 的文章
今年 5 月底,我曾写过一篇关于 NVDA 的文章,在其中讨论了为什么公司将股息提高 2,400%,并承诺将大约 50% 的自由现金流(FCF)返还给股东,这标志着一个极其强大的股息增长故事正式开始。在那篇文章中,我建立了一个 5 年模型,假设 NVDA 每年将股息增长 50%,同时回购并注销超过 8% 的流通股,并累计向股东返还超过 9,000 亿美元资本。我的核心观点是,市场把这项资本回报计划当成了一个脚注,但实际上它可能是一个多年复利循环的起点。
第二季度比我预期更快地验证了这一逻辑。NVDA 在本季度向股东返还了 260 亿美元,其中 200 亿美元来自股票回购,60 亿美元来自每季度 0.25 美元的股息。Colette Kress 披露,按年初至今计算,NVDA 已经返还了 60% 的自由现金流,超过此前承诺的 50%,并表示管理层未来计划在扣除战略用途后,进一步提高并返还多余自由现金流。目前股票回购授权额度仍剩下大约 990 亿美元,而下一次每股 0.25 美元的股息将在 10 月 1 日支付给截至 9 月 10 日登记在册的股东。不过,我这次继续写 NVDA 并不仅仅是因为资本回报计划依然按计划推进,而是因为第二季度彻底扩大了整个投资逻辑的边界,而我认为市场还没有真正消化这次电话会议里透露的信息。
【原文图片位置:NVDA 相关资本回报及财务数据(Seeking Alpha)】
第二季度业绩大幅超预期,而运营进展比预期更好
表面数字已经非常惊人,但真正让我印象深刻的是这一季度内部结构。NVDA 实现收入 962.2 亿美元,环比增长 17.90%,GAAP 和非 GAAP 毛利率都达到 75%,同比提升 2.6 个百分点。公司实现 GAAP 营业利润 637.3 亿美元,同比增长 124.10%,GAAP 净利润 596.9 亿美元,同比增长 125.90%。NVDA 的 GAAP EPS 达到 2.46 美元,同比增长 127.78%。在一家达到如此规模的公司里,利润增长速度居然依然快于收入增长,这在历史上几乎没有出现过。根据第二季度股东演示材料,NVDA 数据中心收入达到 890 亿美元,环比增长 18%,同比增长 117%。其中,Hyperscale(超大规模云客户)在持续强劲的 Blackwell 需求推动下贡献 490 亿美元收入,而 ACIE——即 AI 云、工业和企业客户业务——贡献 400 亿美元,同比增长 138%。在我看来,这是本季度最重要的变化。过去两年空头逻辑一直围绕一个问题展开:当超大规模云厂商资本开支放缓时会发生什么?现在答案是,Hyperscale 已经只占数据中心业务的 55%,另外 45% 来自主权国家、NeoCloud、AI 原生企业以及传统企业,而这一侧业务的复合增长速度甚至高于 Hyperscale。与此同时,Hyperscale 本身也没有减速,因为云行业积压订单目前已经超过 2 万亿美元,预计前五大超大规模云厂商 2026 年资本开支将接近 8,000 亿美元,2027 年将达到 1.3 万亿美元。
【原文图片位置:2027 财年第二季度数据中心业务(NVIDIA Q2 Deck)】
网络业务又创下了一个季度纪录,收入环比增长 18%,其中 Spectrum-X Ethernet 同比增长 2.6 倍。接下来还有 Vera Rubin,而这才是支撑 NVDA 未来 18 个月增长的核心故事。NVDA 本月早些时候已经开始出货 Vera Rubin,机架目前已经在 CoreWeave, Inc.(CRWV)、Alphabet Inc.(GOOG、GOOGL)旗下 Google Cloud、Microsoft Corporation(MSFT)的 Azure、Oracle Corporation(ORCL)的 Cloud Infrastructure,以及 Nebius Group N.V.(NBIS)运行。管理层已经拿到了所有主要超大规模云厂商、AI 云平台以及系统 OEM 的采购订单,并预计 Vera Rubin 将成为 NVDA 历史上放量最快的产品,第三季度该平台将占数据中心收入约 20%。其性能跃升非常巨大,相比 Grace Blackwell Ultra,Vera Rubin 每兆瓦吞吐量提高 30 倍,同时 token 成本下降 35 倍。
新的产品线同样重要。NVDA 发布了 Vera,这是首款专为 AI Agent 构建的 CPU,目前已经全面量产。Grace CPU 也在悄然之间形成了一项过去 12 个月收入超过 50 亿美元的业务,管理层认为服务器 CPU 的总需求大约达到 200 亿美元,并预计 CPU 收入将在 2028 财年翻倍以上。Groq 3 LPX 是 NVDA 首款机架级 LPU 系统,目前也已经全面量产,其每秒 token 输出能力几乎达到次优替代方案的 4 倍,预计本季度稍晚开始批量出货。NVDA 还宣布扩大与 Amazon.com, Inc.(AMZN)的合作,AWS 将从本季度开始一直到 2029 财年第二季度额外部署 200 万颗 GPU,同时还将部署 Vera CPU 和 NVDA 面向仓储机器人的完整 Physical AI 技术栈。Edge Computing(边缘计算)收入达到 72 亿美元,同比增长 27%,与此同时 NVDA 正与 Microsoft 合作,围绕 RTX Spark 和 DGX Station 重新定义 Windows PC。
【原文图片位置:Vera、Groq 3 LPX 与边缘计算产品进展(NVIDIA Q2 Deck)】
资产负债表本身也说明了很多问题。NVDA 可交易权益证券规模增长至 427.8 亿美元,非上市证券达到 511.6 亿美元,因此公司的投资组合规模在六个月内从本财年初的 350 亿美元增长至大约 940 亿美元。库存增加至 315.8 亿美元,为 Vera Rubin 放量提前备货;同时,应收账款周转天数(DSO)延长至 60 天,主要由于公司给予大型投资级客户更长的付款期限,Colette Kress 在 CFO 评论中对此进行了说明。NVDA 本季度还筹集了约 250 亿美元债务资金,我认为这更像是在为融资平台提前配置低成本资本,而不是警示信号。管理层给出的第三季度收入指引为 1,080 亿美元,对应环比增长 12.24%,同时他们在毛利率问题上也非常直接。由于内存价格上涨幅度超过此前预期,公司预计第三季度毛利率为 74%,第四季度触底于 71%-72%,随后随着已经执行的涨价措施生效,2028 财年恢复至 72%-73%。Kress 表示,她宁愿现在就重新设定市场预期,而不是让这个问题一直悬着不解决,我很欣赏这种透明度。
Nvidia 的关键成功因素解释了为什么它正在赢得 AI 竞赛
如果把所有因素简化,我认为 NVDA 正在凭借三个结构性优势赢得 AI 竞赛,而每一个优势都直接击破了一个具体的空头论点。第一个优势是,NVDA 的架构可以运行所有模型。闭源模型和开源模型的采用率都在爆发式增长,而 NVDA 既运行 OpenAI 和 Anthropic 等领先闭源模型,也几乎运行所有领先的开源模型,这意味着 NVDA 根本不需要押注谁会赢得模型竞争。一套可互换的平台就可以完成数据准备、预训练、后训练以及 Agentic Inference,并且能够在 AI 的完整生命周期内持续创造价值。这直接击破了“开源模型崛起会削弱推动 NVDA 需求的前沿实验室”的论点,因为两类模型实际上都在爆发式增长,而几乎所有主要开源模型同样运行在 NVDA 硬件上。NVDA 的护城河甚至延伸到了大多数投资者根本不会关注的领域,例如支持 confidential computing(机密计算)的 NVDA GPU 现在已经运行在 Apple Inc.(AAPL)的 Private Cloud Compute 中执行机密推理,而 Blackwell 则横扫 MLPerf Training 6.0 基准测试中的所有类别,同时也在 AgentPerf——行业首个 Agentic AI 基础设施基准测试——中取得领先。
第二个优势是完整的 AI 工厂全栈平台,这正在不断提高 NVDA 对每一美元数据中心投资的价值获取比例。NVDA 每吉瓦收入机会已经从 Hopper 时代的大约 180 亿美元,提高至 Blackwell 时代的 250 亿美元,再到 Vera Rubin 时代的 400 亿美元,而 Vera Rubin 平台现在已经覆盖 Vera CPU、Rubin GPU、NVLink、InfiniBand、Ethernet 网络以及 Groq LPU。这正是针对定制硅空头逻辑的答案。当 Jensen 被直接问到 OpenAI 的 Alpamayo 芯片时,他回应称,XPU 本质上是为某一家云或者某一项服务打造的特定推理芯片,而 NVDA 销售的是一整个 AI 工厂,可以在世界任何地方、任何云上运行任何模型。NVDA 已经进入第三代 NVLink 72 机架级系统,而竞争对手甚至还在努力部署第一代系统;随着已安装的网络和软件栈越来越庞大,每年将其整体替换掉的转换成本都在继续上升。
【原文图片位置:Nvidia AI 工厂平台与每吉瓦收入机会(NVIDIA Q2 Deck)】
第三个优势是 CUDA 生态系统,它把 AI 扩展到了单纯一颗芯片永远无法触达的市场。主权国家、NeoCloud 和传统企业都没有兴趣自己设计定制芯片,而 NVDA 是唯一一家能够直接交付一整套经过验证的 AI 工厂设计,并通过自己的开发者生态连接到最终计算需求的公司。主权 AI 收入环比增长 35%,同比增长超过三倍。NeoCloud 合作伙伴预计今年年底将拥有 8 吉瓦已安装容量,高于 2025 年底大约 3 吉瓦。Jensen 表示,非 Hyperscale 这一半业务目前每年增长 100%,而且全球这一部分计算市场最终很可能会比今天整个云计算市场还要大。企业市场也在快速扩张,其中汽车垂直领域过去 12 个月本地部署收入达到 80 亿美元,而金融服务、制造和医疗合计又贡献了另外 70 亿美元。
接下来是融资结构,它反过来击破了“循环融资”的批评。NVDA 已经向前沿 AI 实验室投资接近 500 亿美元,而管理层指出,这只占公司同期预期自由现金流的一小部分。真正承担大部分资本开支的是第三方资金,因为 NVDA 已经与 Apollo Global Management, Inc.(APO)、BlackRock, Inc.(BLK)、Blackstone Inc.(BX)、Brookfield Asset Management Ltd.(BAM)、The Goldman Sachs Group, Inc.(GS)以及 KKR & Co. Inc.(KKR)建立融资平台,计划为 AI 基础设施建设筹集超过 5,000 亿美元机构资本。NVDA 会对部分设施容量提供 take-or-pay(照付不议)承诺,为贷款机构提供一个可以用于承保的最低收入底线,而作为交换,NVDA 可以分享超过该底线部分所产生的收入。换句话说,NVDA 可以赚两次钱:第一次是在硬件销售时获得收入,第二次则通过与使用量挂钩的持续性收入再次获利。Kress 明确表示,NVDA 并没有直接发放贷款,每笔交易都由独立资本方基于自身条件独立承保。NVDA 出货的计算资源最终都由投资级客户使用,或者由投资级机构提供支持;而那些利用 NVDA 资产负债表支持的 AI 实验室,大约只占公司明年业务的四分之一。对于一个计算资源高度可互换且在单个客户出现问题时可以重新部署的平台而言,这种风险敞口仍然可控。仅 OpenAI 现有和计划中的项目,到 2030 年就对应约 12 吉瓦 NVDA 计算资源,其中位于 Ohio 的 PORTS-Pike 园区首期 4.25 吉瓦部署将全部采用 NVDA 计算平台,而这个园区本身也是按照未来 20 年多轮升级周期进行设计的。
需求背景则进一步提升了这一趋势的持久性。2026 年上半年,全球 AI 风险投资融资额已经超过 4,000 亿美元,超过 2025 全年 2,650 亿美元的融资额,而其中大约 70% 最终都会用于购买计算资源。目前已经有接近 20 家 AI 原生企业的年化收入运行率超过 10 亿美元,而两个季度前这一数字只有 13 家。Jensen 表示,Agentic AI 工作负载所消耗的计算资源,是人类单纯向模型输入 prompt 的 15 到 100 倍,而且就在上个月,AI 工作负载中 Agentic AI 已经首次占据多数。他还指出,如今一个 500 亿美元数据中心的投资资本回报周期已经缩短到一年以内。Jensen 在财报新闻稿中用一句话总结了整个逻辑:“Compute is revenue(计算就是收入)。”Token 可以盈利,而真正的约束是计算资源本身,这也正是为什么管理层可以给出 70% 增长指引,同时告诉你真实需求其实接近 100%。
Nvidia 的估值并没有反映管理层刚刚给出的指引
当我查看最新市场一致盈利预测时,其中的错位非常明显。分析师目前预计 NVDA 在 2027 财年实现 EPS 9.05 美元,同比增长 89.76%,对应当前股价约 23.54 倍当年市盈率。到 2028 财年,一致预期 EPS 为 13.13 美元,同比增长 45.03%,对应股价仅为 16.23 倍市盈率。到 2029 财年,市场预期 EPS 为 16.61 美元,对应估值进一步下降至 12.83 倍,而两位给出 2030 财年预测的分析师预计 EPS 为 19.10 美元,对应仅 11.16 倍市盈率。NVDA 股价当前约为 213 美元,对应市值约 5.2 万亿美元。当我今年 5 月写 NVDA 时,股价对应的前瞻市盈率还超过 25 倍。因此,在连续两个极其强劲的季度之后,NVDA 相对于一个规模更大、增速更快的盈利基础,前瞻估值反而变得更便宜了。
【原文图片位置:NVDA 前瞻盈利估值(Seeking Alpha)】
我还认为,市场一致预期本身也太低了。NVDA 在 2027 财年前两个季度已经实现 1,778.4 亿美元收入,同时第三季度收入指引为 1,080 亿美元。如果第四季度继续按照最近几个季度类似的环比增速增长,那么 2027 财年全年收入将达到大约 4,050 亿至 4,100 亿美元。管理层刚刚给出了 2028 财年约 70% 的收入增长指引,这意味着全年收入大约会达到 6,900 亿美元。当前市场一致预期却认为明年 EPS 只增长 45.03%,而收入增长达到 70%,我很难理解这两个数字如何能够同时成立。随着已经执行的涨价措施生效,毛利率预计恢复至 72%-73%,同时运营费用增速低于收入,因此盈利至少应该与收入保持类似增速。我的判断是,未来几个季度 13.13 美元这一 EPS 预测将会被显著上调,而每一次上调都会让当前 16.23 倍的估值显得更加脱节。以大约 16 倍前瞻市盈率买入一家刚刚给出 70% 收入增长指引、同时将 60% 自由现金流返还给股东的公司,我很难在市场其他地方找到类似配置。即使估值倍数完全不扩张,目前一致预期本身也已经认为 NVDA 从 2027 财年到 2029 财年 EPS 将增长超过 80%,而股价理论上也应该随着盈利上升。
投资 NVDA 所面临的风险
虽然我持有 NVDA 多头仓位,并认为股价未来会获得更高估值,但确实存在可能影响我投资逻辑的真实风险。最直接的风险就是毛利率。内存价格涨幅超过管理层此前预期,而且预计明年还会进一步上涨,这也是为什么公司预计第四季度毛利率会触底至 71%-72%。2028 财年恢复至 72%-73%,依赖于已经执行的涨价措施能够真正覆盖成本上涨。如果内存价格上涨速度超过这些涨价幅度,那么毛利率恢复将无法兑现,EPS 预测反而会下调而不是上调。第二个风险是资产负债表结构正在变得越来越复杂。由于大型投资级客户获得延长付款期限,DSO 已经增加至 60 天,应收账款也从本财年初的 384.7 亿美元增长至 630.6 亿美元。由于营运资本大幅增加,第二季度自由现金流只有 213.4 亿美元,显著低于净利润,而 NVDA 本季度还新增了约 250 亿美元债务。大约四分之一的明年业务与 AI 实验室有关,这些实验室通过股权投资、take-or-pay 承诺以及选择性信用增级利用 NVDA 的资产负债表。如果 AI 融资环境趋紧,那么“循环融资”的批评就会变得更加尖锐,而这些结构也将首次真正面临压力测试。管理层的回应是,这些计算资源具有可替代性,也可以重新部署,而且客户本身要么是投资级,要么拥有投资级合作方支持。但无论如何,这是我未来最密切关注的领域。无论多头逻辑看起来多么强劲,任何人在投入资金购买 NVDA 之前都应该进行自己的尽职调查。
结论
NVDA 刚刚交出了迄今最有力的证据,证明 AI 基础设施建设正在扩散,而不是接近顶部。公司连续第 4 个季度实现增长加速,目前数据中心业务的一半已经来自 Hyperscale 以外客户;毛利率下调也伴随着清晰的恢复路径;前沿 AI 实验室基础设施建设依靠的是超过 5,000 亿美元第三方资本,而不是仅仅依赖 NVDA 自己的资产负债表;同时资本回报计划目前已经达到自由现金流的 60%,高于此前承诺的 50%。更重要的是,管理层首次在公司历史上直接给出了 2028 财年 70% 的增长数字,并明确告诉市场,实际需求更接近 100%。我不认为当前股价按照明年盈利仅 16.23 倍估值能够反映这些变化,而且我认为盈利预测未来还会继续上调。我今年 5 月写过的股息复利逻辑依然完全成立,而包裹在这一逻辑外面的增长故事如今反而变得更大。我继续持有 NVDA 多头仓位,而且在看完这份财报之后,我比财报前更加看多,因为空头已经失去了他们最有力的几个论据。
撰文:Techub News 整理 导语 2025 年 5 月,Alphabet 兼谷歌 CEO 桑达尔·皮查伊(Sundar Pichai)罕见地接受了 All-In Podcast 的深度专访。在长达一小时的对话中,皮查伊直面了当前市场对谷歌在 AI 浪潮中可能面临“颠覆者困境”的核心质疑。作为执掌这家科技巨头近十年的领导者,皮查伊的此次发声,不仅是对外界疑虑的集中回应,更是系统性地阐述了谷歌将如何利用其长达二十余年的技术积累——从基础设施到前沿研究——来驾驭并引领这场 AI 革命。本次对话涵盖了搜索的未来、AI 商业模式、芯片战略、能源约束、量子计算以及机器人等广泛议题,为我们理解谷歌在下一个十年的战略方向提供了关键窗口。 摘要 皮查伊坚信 AI 是搜索的“非凡机遇”,而非零和游戏的颠覆者,AI 概览(AI Overviews)等新功能正在扩大搜索的查询范围和用例。 谷歌的核心优势在于其全栈式技术积累,从 TPU 芯片、全球数据中心网络到跨领域的基础研究,这使其能在控制成本的同时持续推动模型创新。 面对 OpenAI、微软、Meta 等激烈竞争,皮查伊认为 AI 创造的将是一个比过去所有技术总和更大的市场,成功的关键在于持续创新和执行。 谷歌在量子计算、机器人(物理 AI)等领域进行长期、耐心的投资,视其为类似早期 AI 的基础性突破,预计未来 3-5 年将迎来关键进展。 皮查伊承认文化管理是持续挑战,近期重点在于重拾“使命聚焦”,激发类似谷歌早期创业阶段的强度与乐观精神,以应对 AI 时代的竞争。 AI 是搜索的进化,而非颠覆 访谈开场便直指核心:在聊天式 AI 重塑人机交互的今天,谷歌的核心搜索业务是否面临被真正颠覆的风险?桑达尔·皮查伊(Sundar Pichai)的回答明确而坚定。他回顾道,自 2015 年担任 CEO 起,他便将谷歌定位为“AI 优先”的公司,因为团队深信 AI 将是驱动搜索最大进步的动力。因此,当前时刻对他而言并非威胁,而是搜索的“非凡机遇”。 皮查伊用数据佐证了他的观点。谷歌约一年前推出的“AI 概览”(AI Overviews)功能,如今已被超过 15 亿用户使用,覆盖 150 多个国家。这不仅没有蚕食传统搜索,反而扩大了用户查询的类型和范围,带来了全新的使用场景。在触发 AI 概览的查询中,谷歌观察到了查询量的增长,且增长具有持续性。他透露,实验室中正在测试一个全新的、名为“AI 模式”的专用搜索 AI 体验,将在谷歌 I/O 大会上详述。在该模式下,用户可以进行完整的对话式追问,谷歌最前沿的模型将利用搜索作为原生工具来回答问题。 “用户正在用行动回应,”皮查伊指出,用户输入的查询平均长度已是两三年前的两到三倍,有时甚至是长段落。这改变了搜索的形态。针对“创新者困境”的经典命题,皮查伊认为困境只存在于你将其视为困境之时。他援引了移动转型和 TikTok 崛起后 YouTube 依然蓬勃发展的例子,指出科技史上每一次重大创新周期,都需要全力投入。“这有点像谷歌最初的原则之一:跟随用户,其他一切自会跟随。” 商业模式过渡:成本可控,广告逻辑依旧 当对话转向敏感的商业模式——即更昂贵的 AI 查询是否会破坏谷歌搜索“查询成本”与“单次查询广告收入”之间精妙的单位经济学时,皮查伊展现了基于基础设施优势的自信。 他承认两年前业界普遍担忧成本问题,但他始终认为,就服务成本而言,他愿意押注谷歌的基础设施能力能够比几乎所有其他公司都做得更好。事实也证明,在过去 18 个月里,服务单次查询的成本已大幅下降。目前更主要的约束在于延迟,而非成本。如何让 AI 体验达到搜索近乎即时的速度,是当前更重要的前沿问题。 关于 AI 查询的广告收入,皮查伊表示,在已经展示广告的 AI 概览中,其效果基准已与传统搜索持平。“我们已经达到了那个阶段。”他进一步从第一性原理分析:广告在搜索中行之有效,是因为商业信息本身就是用户意图的一部分。AI 没有理由不能在这方面做得更好。因此,他对平稳过渡商业模式感到“安心”,尽管部分调整可能需要时间,但所有指标都显示谷歌能够很好地完成这一过渡。 基础设施与芯片:谷歌的“全栈”护城河 皮查伊多次强调,谷歌一个核心且常被低估的优势是其长达二十多年的基础设施投资。从早期可海运的集装箱数据中心,到如今遍布全球的网络,这构成了竞争力的基石。在 AI 时代,这一优势直接体现在性能与成本的帕累托前沿上——谷歌能够以最具成本效益的价格点提供最好的模型。 关键组件之一便是谷歌自研的 TPU 芯片。皮查伊提到,谷歌在 2017 年发布了第一代 TPU,如今已发展到第七代。最新的 “Ironwood” 芯片单块算力超过 40 Exaflops。这些专门为机器学习优化的芯片,尤其在推理环节表现出色,是谷歌有信心以巨大规模服务 AI 搜索查询的重要原因。他表示,谷歌的“全栈”方法——从底层基础设施、基础研发到上层应用创新——将长期为公司带来优势。 关于芯片战略,皮查伊澄清了与英伟达的关系。他盛赞英伟达是“非凡的公司”,CEO 黄仁勋(Jensen Huang)也很出色,双方合作历史悠久。谷歌内部既用 TPU 训练 Gemini 模型,也在 GPU 上服务部分流量,并为云客户提供选择。他认为行业内的公司都会尝试类似(自研芯片)的路径,但英伟达的研发能力和软件栈是世界级的,拥有诸多优势。谷歌的长期策略是保持 TPU 和 GPU 并用的灵活性,两者相互促进,共同推动技术前沿。 模型创新未达瓶颈,数据优势在于个性化 针对外界关于大语言模型性能开始“高原化”、竞争者差异缩小的论调,皮查伊并不认同。他将进步过程比作“人工 jag jag 智能”,即进展并非总是线性的,会经历看似缓慢的时期,然后出现范式突破。过去几年,行业在预训练、后训练、推理计算等方面不断推进,如今又在研究如何将所有技术整合到智能体工作流中。他感觉进步相当持续。 “进步确实会变得更难,而这将区分出精英团队,”皮查伊认为,问题越难,谷歌的准备就越充分。谷歌的研究前沿远比大多数公司更广阔,不仅限于 LLM 或基于 Transformer 的模型,在扩散模型等众多领域都在进行深度探索。他尚未看到计算投入回报递减的根本性拐点出现。 当被问及谷歌是否拥有来自 YouTube 等产品的独特数据优势时,皮查伊的回应侧重于用户体验而非单纯的数据训练。他认为,谷歌的机会在于利用用户使用 Gmail、日历、文档、YouTube、搜索等产品时产生的个人上下文(在获得用户许可的前提下),来提供更优质、更个性化的体验。他将此视为公司未来差异化的创新机遇之一,目前正在审慎推进。 未来交互:无缝、环境计算与 AR 眼镜 展望未来 5 到 10 年的人机交互,皮查伊描绘了一个“无缝”的愿景:人类需要做的“硬性适应”工作越来越少,计算将主动为人服务。他认为这是“圣杯”,而触摸、语音等技术正在一步步迈向这个未来。 他特别看好增强现实眼镜的前景。作为眼镜佩戴者,他亲身体验了 AR 眼镜,虽然目前舒适度尚不及普通眼镜,但正在改善。他相信,当 AR 真正成熟时,它将把无缝体验推向新高度,让计算“环境化”地存在并为你服务。他指的并非沉浸式显示设备,而是 AR 眼镜。结合真正多模态的模型,他认为这一范式非常有趣,能让人感受到下一次飞跃。他将当前 AR 的发展阶段类比于 2006-2007 年的智能手机,可能还需几个周期才能达到理想状态。 皮查伊证实,谷歌在硬件上投入了大量时间,不仅限于 Pixel 手机和数据中心,也对 AR 眼镜、机器人等新形态感到兴奋。 竞争格局:AI 市场足够大,创始人深度参与 面对 OpenAI(萨姆·奥尔特曼 Sam Altman)、xAI(埃隆·马斯克 Elon Musk)、Meta(马克·扎克伯格 Mark Zuckerberg)和微软(萨提亚·纳德拉 Satya Nadella)组成的强大竞争对手矩阵,皮查伊展现了开放与务实的态度。他称赞这是一个“令人印象深刻的群体”,汇集了最好的公司和企业家。竞争的存在恰恰预示着我们将看到巨大的进步。 他特别提到2025 年 5 月与埃隆·马斯克(Elon Musk)的会面,钦佩其“将未来技术变为现实的意志力无与伦比”。皮查伊强调,AI 将开启一个比过去所有技术总和更大的机遇版图。他提醒人们,互联网兴起时,谷歌甚至还不存在。未来 AI 领域的赢家可能包括许多尚未诞生的公司。因此,格局并非简单的“谁击败谁”,而是关于哪些公司能够通过创新和执行,携手最优秀的人才取得成功。 皮查伊还分享了谷歌联合创始人拉里·佩奇(Larry Page)和谢尔盖·布林(Sergey Brin)的深度参与。他经常与两人交流,称赞他们很早就预见了 AI 的今天,并认为这是计算机科学领域最激动人心的时刻。谢尔盖·布林更是以“硬核”方式投入,与 Gemini 团队坐在一起编码、查看损失曲线、反馈模型架构,为团队注入了无与伦比的能量。皮查伊珍视与两位创始人“非线性思维”碰撞带来的灵感。 长期押注:量子计算与机器人 谷歌以对前沿技术进行长期、耐心投资而闻名,如 TPU、DeepMind、Waymo。皮查伊以同样视角看待量子计算和机器人。 他将量子计算目前的发展阶段类比于 2015 年左右的 AI。他预计在未来 5 年时间框架内,将会出现一个真正的“顿悟时刻”——用量子方式完成一项非常有用的实际计算,且远超经典计算机,从而真正展现该领域的潜力。他对此充满信心。谷歌的目标是通过云平台展示更多实用算法,并提供访问。皮查伊认为,就像无人驾驶领域曾充满噪音一样,量子领域目前也有很多宣布,但谷歌自认为处于前沿。 在机器人领域,皮查伊承认谷歌曾过早尝试应用层(如收购波士顿动力后又出售),当时机器人尚未深度受 AI 影响。如今,“AI + 机器人”的结合点已经到来。谷歌拥有世界级的机器人前沿研发团队,Gemini 在视觉-语言-动作模型方面的努力也属顶尖。他们正在思考如何通过合作或推出产品来参与其中。皮查伊观察到,人形机器人的进步神速,以至于他需要仔细辨别视频真假。他预测,距离机器人领域的“神奇时刻”可能还有两到三年。谷歌旗下公司 Intrinsic 正致力于成为“机器人领域的安卓”,而 Gemini 模型也将成为机器人领域的强大基础模型。 文化、人才与未来展望 针对谷歌文化从早期创新乐园演变为“骄纵员工”避风港的外部批评,皮查伊进行了辩护与反思。他解释,提供午餐等福利的初衷是创造积极、乐观、便于跨领域交流的创新氛围,这至今仍是谷歌吸引顶尖人才、激发基层创新的力量源泉。但他也承认,随着公司规模急剧扩大,有时次要议题会掩盖公司的核心使命。 过去几年,他刻意致力于重拾“使命聚焦”,强调员工聚集于此是为了创新并服务公司使命、产生影响力。当前的 AI 时刻带来的高强度与兴奋感,让他回想起早期的谷歌。他通过创建“实验室”等机制,鼓励小团队快速创新。他认为,文化需要不断微调以忠于核心价值观,出现漂移时则需努力拉回。 在人才争夺方面,皮查伊表示,谷歌在吸引顶尖 PhD 研究员方面依然具有竞争力,也有离职员工回归。他预见,AI 将使全球更多地方涌现出卓越人才,而不仅限于少数传统中心。 关于 Alphabet 作为控股公司的结构,皮查伊澄清,其本质并非单纯财务投资,而是基于共同的基础技术(如 AI)去解决不同领域的问题,从而衍生出看似迥异但内核相连的业务。从 Waymo 到 Isomorphic(基于 AlphaFold 的药物发现公司),都是这一逻辑的体现。 最后,被问及十年 CEO 任期内最大的骄傲与遗憾时,皮查伊对谷歌能够同时推动技术前沿(如获得诺贝尔奖级别的基础研究)并将其转化为商业价值感到无比自豪。至于遗憾,他提到了一些曾激烈辩论但最终未完成的收购,例如 Netflix,但他更倾向于向前看,认为这些是“平行宇宙中的另一种可能”。