
Loading...

Loading...
 国内第一个为团队而生的Agent,果然还是在飞书里面来了。就在刚刚,飞书和豆包工作一起,开了他们的全新发布会。
在聊了很多飞书为Agent做的全新升级,还有和豆包工作深度融合后的产品能力之后,他们也终于发布了一个全新的功能,也是我们内测了一段时间,让我非常喜欢的功能。
豆包工作伙伴。
讲道理,这玩意飞书在国内第一个做出来,我一点也不意外。
跟之前的豆包工作伙伴完全不一样,这一次,你可以把你的豆包工作伙伴,拉它进入企业里的任何群聊里面,成为一个团队共享的AI工作伙伴。
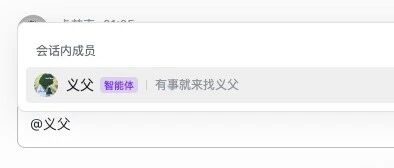
它拥有独立的人设,独立的名称,独立的组织身份,比如我就给它改名了,名字也很性感,叫义父。
它可以被拉进群,参加公司的会议、读所有的文档、代码等等等等,还能主动的去推进大家的工作,它长这样。
如果大家有印象的话,会觉得,这个豆包工作伙伴,怎么跟那个Claude Tag那么像。
对,确实很像。
而且我觉得,如果要理解豆包工作伙伴到底是什么,最好的办法,可能真的就是先理解Claude Tag。
今年6月份,Anthropic发布了Claude Tag。
这玩意,被卡帕西称为AI在用户体验上的第三次范式。
我觉得可以用一句特别简单的话来解释。
普通Agent,是一个属于你自己的能干活的Agent。
而Claude Tag和豆包工作伙伴这样的产品,就是类似于给这个Agent一个独立身份,让它安全、可控地帮公司里所有人一起工作。
这句话基本就解释完了。
我们过去接触的大部分Agent,不管是Claude Code、Codex,还是各种你自己搭出来的Agent,本质上都有一个共同点。
它主要围绕“你”工作。
而Claude Tag和豆包工作伙伴这样的形态,是一个完全不同的形态。
你可以理解为,他有自己的身份、权限、记忆之类的,长期驻扎在公司的组织软件里,Claude Tag是待在Slack里,豆包工作伙伴是待在飞书里。
公司里的任何一个人都可以跟它一起工作。
它知道这个群之前发生过什么,也知道大家最近在聊什么,知道公司是什么业务、每个人负责什么、大家手上的项目分别是什么,也可以接入GitHub、多维表格、知识库之类的这些公司的系统。
甚至很多时候,你甚至都不需要主动叫它。
它自己会判断:
这个事情,我是不是该干点什么。
你看,这个关系就完全变了。
以前在组织中,我们跟AI的关系,大概是:
人、人、人、人。
↓ ↓ ↓ ↓
AI、AI、AI、AI。
现在呢,就变成了:
人、人、人、人。
↓
AI。
所有人共享同一个AI同事,大家都拥有了一个团队智能体,大幅的降低各种沟通和损耗成本,让我们的小伙伴,更有时间,去做那些真正AI替代不了,真正重要的事情。
这就是我觉得这类产品,对于组织来说,真正牛逼的地方。
而在Slack中,Claude Tag其实可以发挥的作用没有豆包工作伙伴在飞书中的大,核心还是因为,飞书过去十年打下的基建和江山实在是太恐怖了。
群聊、会议、文档、日历、任务、项目、OKR等等,甚至还有多维表格上的各种各样的业务数据,实在是太丰富了。
所以在昨天,我甚至在公司内部,做了一个小小的决定,把公司内部沟通,也全面从微信迁移到飞书上了。
公司的一个小小的里程碑,终于全面从微信切换到飞书了。
这一年跑的太快,很多基石还没做好,沿着惯性在走,昨天想了想,还是下定决心了。
对公司组织来说,也要全面拥抱为未来而生的基建才行。
飞书基本上就是为Agent而生,虽说只是办公方式的一个小小的变化,但是也意味着,面向未来。
这个决定,其实跟这几天内测豆包工作伙伴以后,有很大的关系。
说回豆包工作伙伴,这玩意目前还是邀请共创测试,因为我们稍微特殊一点的身份,所以是前几天就拿到了内测的,大家想用的话,可能还需要再等等,但是有些东西,我觉得还是足够可以给大家看一看的。
当你有了豆包工作伙伴的权限之后,你就可以在后台,看到他的设置页面,可以看到它的人设、自动化、资产、记忆等等。
你可以随便改,比如我就把它改成了,义父。
于是我们所有人让它帮忙干活,都是需要在群里,@义父。。。
当然,你也可以建多个不同的工作伙伴,赋予他们不同的能力和人格。
给大家举个例子。
我们的小伙伴,就在尝试用义父,来讨论选题。
平时刷到有意思的东西,就会直接扔进选题群里,大家一起聊聊能不能做。
就比如说,今天他们看到的这个盆栽和手摇Token生成器。
就可以在群里@义父,让它调研一下,技术上怎么实现,是否能够复刻。
它立刻就可以给出一些建议,对工期、预算和可能遇到的问题做了初步估算。
然后也可以让义父在群里,核查一些信息。
然后还有一个选题,是开学了吗,于是说,看看能不能把ChatGPT当成语言老师。
他们就还是把截图发进群里,让义父看看。
义父聊完之后,大家还可以继续充分讨论,再进行投票。
讨论结束以后,他们又让义父把前面的聊天整理成了一张选题总结卡片。
选题聊完以后,我们的流程是,由内容组的小伙伴会先把觉得合适的方向提报到选题库,再由我筛一轮,确定哪些可以做。
现在有了义父之后,他们真的就是随时分享、随时讨论,随时让义父往选题库里面扔。
然后我就能看到,义父把前面聊到的两个方向分别录入选题库,状态先设成待定,等我看完再决定。
接着,又让它根据选题库里之前已经确认可做的选题排一下档期。
结合每个人的工作分工和已有排期,安排一下谁来做、什么时候做,再把对应的安排加进日历里。
确认好以后,还能直接给对应的小伙伴来发送日程邀请。
就有了这个豆包工作伙伴之后,我们的工作流程和协同也肉眼可见的发生了一些变化,因为,这是属于大家的Agent,是属于大家的同事。
也能根据大家的时间,来约大家的会议。
还能跟我们一起开会。。。
这个同事也会拥有跟大家互动后,存下来的跟每个同事相关的记忆。
也可以给他配置各种各样的权限。
还有非常非常非常多好玩的东西和好玩的场景,感觉后续要慢慢发掘。
飞书过去所有在机器人、AI和Agent上的积累,在此刻融为一体,汇聚到了豆包工作伙伴上。
这个东西,是我过去这么久,用过的最有趣的Agent之一。
不过这个事肯定不好做,因为Agent 、大模型、协同办公要深度配合才能有比较好的流程的体验,还有包括token消耗等可能会很大,但,一定是未来的趋势。
其实过去,我也一直在思考一个命题。
当AI真的进入一个组织以后,公司这种东西本身应该如何发生变化?
因为我们都知道,一家公司里面,很多时候大量的成本其实都浪费在沟通和协作上。
比如说很多看到我就脑壳疼的问题:“你有没有跟A同步?A告诉B了吗?B知不知道C已经改了???”
还有无数类似的,我都想杀人。
过去我还在互联网中产的时候,真的,很多时候,一件可能真正只需要两小时完成的工作,可能前前后后要拉十个人,开三个会,发上百条消息,然后互相同步来同步去,三天才搞完。
所以我现在,极其认同一个公式:
团队效率 = 所有人个人效率的总和,再减掉协作成本。
过去的AI一直疯狂提高的,都是前半部分,但是协作成本,靠的几乎还是组织管理方法论,还有使用的协同工具本身。
但现在,因为豆包工作伙伴这样的产品,好像也在开始大幅降低协同成本了。
但本质上,核心还是飞书这个产品的基建,实在是搭的过于优秀了。
就像我上面说的,这也是我自己,为什么决定,最后还是决定把我们公司内部的工作沟通也全部迁到飞书
这当然只是一个很小的变化。
但我也只是想,把公司的工作方式,更加的面向Agent一点。
对公司组织来说,也要全面拥抱为未来而生的基建。
我们已经讨论了三年AI会怎么改变个人。
那接下来,也要开始聊一聊,AI究竟会如何改变公司了。
这个未来是必然会来的,那企业内部如何沟通,如何沉淀我们所有的知识和经验,如何管理项目,如何组织数据,如何让Agent真正的进入公司,这个是每一个组织,都必须要考虑的东西。
虽然我过去吹了飞书无数次,我真的不想再吹了。
但是我还是非常想真情实感地说一句。
相信我,企业拥抱AI。
先从飞书开始。
就像谢欣在发布会最后说的那句话一样:
“把卓越的工具交给人们,他们自会,创造非凡”
 OpenAI把Codex“拆开卖了”文章转载于字母AI
OpenAI昨天一口气打出了四张大牌。
Agents API、GPT-Live-1 API、Data agent、ChatGPT for Financial Services,一天横跨Agent、语音、数据和金融四条产品线,每一条都值得单独拿出来说道。
但这四张牌里,最值得看的可能还是Agents API。
因为这一次,OpenAI把Codex“拆开卖了”。
原本藏在Codex背后、负责让Agent持续工作、调用工具、管理上下文和协同多个Agent的那套能力,被抽出来打包成了云端API,交给所有开发者调用。
1
Codex即服务?
其实,OpenAI早就在拆Codex了。
早在2025年4月,OpenAI刚发布o3和o4-mini那会儿,就把Codex CLI开源了。它有点像OpenAI版的Claude Code,直接就装在本地终端里。Agent怎么跑,怎么调用工具,都明明白白地放在GitHub上,你愿意折腾,就可以自己拿回去改,自己跑。
不过那个时候只是单纯地把东西给了出来,至于你会不会用、想怎么用,那都还是你自己的事。
一个月后,Codex云端版,也就是我们今天所熟悉的那个产品,才正式上线。用户可以把代码仓库交给它,一个任务对应一个独立的云端沙盒,Codex可以自己改代码、跑测试、修bug,还能同时处理多个任务。
又过了几个月,在2025年的10月份,OpenAI发布了Codex SDK。
简单来说,SDK就是给开发者的一套工具包,让Codex不只作为独立产品使用,也可以塞进别人的应用里。SDK允许开发者用几行TypeScript代码启动同一个驱动Codex CLI的Agent,拿到结构化输出,还能保留任务状态,在暂停之后继续跑。
但是呢,SDK主要适合在程序里调用Codex,还没有把完整的Codex交互能力开放出来。它很适合后台的工作流、自动化脚本、服务端的程序。但如果你想做一个像Codex IDE那样的完整客户端,还是有些困难。
于是到了2026年2月,OpenAI正式公开Codex App Server,第一次系统地把Codex里面那套Harness讲清楚了。
OpenAI明确解释,Codex Web、CLI、IDE扩展和Mac App看起来是不同的产品,但底下其实都在运行同一套Codex Harness,也就是负责Agent Loop、Thread、工具执行、认证和管理状态的那层东西。
App Server给这一整套Harness加了一套双向JSON-RPC接口。JetBrains、Xcode或者其他客户端,不需要重新造一个Agent Loop,直接启动App Server,就可以驱动完整的Codex。
有了App Server,其他产品就可以直接接上完整的Codex Harness。
不过走到这里,还有最后一个麻烦没解决。
SDK控制的是本地Codex Agent,App Server本身也是一个需要开发者启动和维持的常驻进程。虽然把Codex接进产品这事已经解决了,但想把它稳定地跑成一个线上的服务,还是有点困难。
举一个比较具体的例子,如果你用App Server做一个自己的Coding Agent网站,前端已经接上了Codex,但当用户点下“修复这个仓库”之后,后续的大量运行和基础设施问题,都还需要你自己想办法解决。
然后就到了8月19日,这一天,OpenAI把过去一年陆续开放的CLI、SDK、App Server统一放进了“开放Codex Harness”的平台叙事里,并明确把Codex从一个产品提升成了平台。
再然后就是(美国时间)9月10日,也就是昨天,Agents API正式开放公测。
这一次,开发者只需要告诉API四件事——任务、模型、工具、运行环境——就可以直接创建一个Agent。负责长会话上下文压缩、工具调度和subagent协作的Codex Harness由OpenAI自己托管和维护。
甚至就连Agent真正干活的机器都能自己选,是用OpenAI的沙盒、自己的基础设施,还是Cloudflare、E2B、Modal等第三方环境,都可以。Harness由OpenAI提供,执行环境由开发者决定。
官方的口径很明确,Agents API本身不额外收费。也就是说,Harness托管、长会话管理等能力,并没有再单独收一层Agent平台费。
开发者按实际使用的模型Token和工具付费;如果使用OpenAI自己的托管沙盒,计算资源另算。
把这一年多串起来,OpenAI一直在做同一件事:把Codex从一个具体产品,一层一层拆成可以被复用的能力,同时让开发者越来越不需要自己操心。
如果一定要给这条产品线起个名字,它其实很像当年的SaaS,只不过这次被服务化的不是软件,而是Codex。
Codex as a Service。
1
Harness也开始分叉了
盯上Harness的当然不止OpenAI。
DeepSeek Harness(后文简称DSH)发布的时候,就给出了一个非常响亮的等式:Agent = Model + Harness。
在DeepSeek看来,模型只是Agent的一半,另一半则是负责让它理解环境、调用工具、管理状态、持续执行任务的Harness。两者互相协调,Agent才能真正执行任务。
DSH把Harness本身做成了一套高度模块化的开放框架:模型、工具、Skills、Session、沙盒、存储、Agent Loop、调度,甚至UI都可以替换。
“一切皆插件”的口号可不是说着玩玩而已,最好大家都来写插件,都来适配DSH,最后不管上面跑的是DeepSeek,还是别的模型,底下都可以是同一套Harness。
这和OpenAI现在走的方向刚好形成了一个挺有意思的对照。
OpenAI虽然也把Codex harness开源了,但Agents API明显是在往另一个方向走:Harness你可以用自己的,也可以拿走开源的,但如果你嫌麻烦,还可以直接不管,让我来替你安排。
所以我们认为,它更像是一种“服务”。OpenAI负责托管和持续维护Harness,开发者只需要决定要让Agent干什么、用什么工具、在哪里执行。甚至以后模型升级了,Harness怎么跟着改,OpenAI也准备一起包了。
某种意义上,现在Harness这一层隐约出现了两条路线:
以DeepSeek为代表的路线更像是在建设开放生态,把每一个零件都做成插件,让开发者自己组装;而以OpenAI为代表的一方则像在押注云服务,把钱和需求给到位,剩下的我帮你解决。
我们甚至可以认为,一个想让Harness越来越像Linux,另一个则想让Harness越来越像AWS。
当然了,这只是个比喻。OpenAI也开源了Codex Harness,DeepSeek未来也并非没有可能提供更多的托管服务。但至少在现阶段,两边产品的重心差别明显。
有意思的是,在把Harness变成服务的这条线上,Anthropic其实比OpenAI更早一步。
早在2025年9月,Anthropic就推出了Claude Agent SDK,把Claude Code背后的工具、上下文管理、权限系统和subagent能力开放给开发者,让别人也能拿这套东西做Agent。
今年4月,它甚至比OpenAI更早推出了Claude Managed Agents。Session、Harness和沙盒被拆成三个独立层:Anthropic负责托管harness和长任务,沙盒既可以由Anthropic提供,也可以接入别的执行环境。这个思路和今天的Agents API其实已经相当接近,Anthropic自己给它的定义就是“一个用于长期Agent任务的托管服务”。
所以某种意义上,OpenAI这次是在沿着Anthropic已经走过的路继续往前走,区别只不过是OpenAI手里有一个更“产品化”的Codex。
但因为Codex和Claude Code长期给人的产品印象还是不太一样,所以即使它们讲的是同一套故事,带来的感觉也大相径庭。Claude Code给人的感觉更像是让开发者坐在终端里和Agent一起写代码,而Codex App一开始强调的就是“同时监督多个长期Agent”的界面。
顺带一提,谷歌也早已加入这条路线。今年5月的I/O大会上,Gemini API推出Managed Agents,同样把Antigravity Harness和沙箱做成了托管服务。但谷歌的牌面不止于此,这一点咱们后面再讨论。
不过话说回来,谁先谁后好像也不是那么重要……最后当然是谁把自家的Harness变成开发者默认的那一层,谁才能吃下最大的蛋糕。
1
谁是大赢家?
说到底,为什么现在模型公司都开始抢Harness了?
就像是DSH给出的等式那样,Agent = Model + Harness,模型可以告诉Agent下一步应该做什么,但真要把一个任务从头跑到尾,它还得知道文件在哪里、需要调用哪个工具、出了错怎么恢复、结果最后要写在哪里。
换句话说,模型决定Agent的能力上限,而Harness越来越决定它到底能不能把活做完。
而一旦竞争的维度从“智力”走向“执行力”,最占优势的,未必是那些模型做得最好的AI公司。
因为Agent真正开始干活之后,需要的那些东西——邮件、文档、会议、通讯、账号权限等等——往往掌握在传统平台公司手里。
国内最近打得热闹的“办公Agent大战”,其实就是一个非常典型的例子:大厂在互联网平台时代积累下来的那些东西,以前更多只是各自生态里的部分功能,但到了Agent时代,这些东西恰好就是Agent真正干活时需要调用的工具。
现在大家做办公Agent,表面上是比谁家的AI员工更聪明、更有本事,背后其实也在重新利用自己过去积累的平台优势。谁手里有更多企业数据、文档、工具和权限,谁就更容易让Agent真正把事情做完。
模型公司需要一点点接入它们没有的入口,而那些做了十几年办公软件和互联网平台的公司,本来就掌握着这些入口。
换句话说,AI公司要重新连接现实世界,而平台公司手里原本就有一大串钥匙。
沿着这条路往前看,如果非要找一个最有优势的“全家桶”选手,谷歌恐怕是最夸张的那个。
从TPU、云基础设施、Gemini,到Search、Workspace、Chrome和Android,谷歌几乎覆盖了AI从底层技术到最终用户的所有关键环节。Search、Gmail、Calendar、Drive、YouTube、Maps等产品,又天然构成了一套可以被Agent调用的数字环境。这些资产在上一代互联网里是一个个独立入口,到了Agent时代,却可以被重新组织到同一个任务之下。
事实上,谷歌已经开始把散落在各个产品里的Agent能力,在底层往同一套执行系统里收。Gemini Spark、Gemini API里的Managed Agents,乃至Search里的部分Agent体验,背后正在逐渐共享同一套Antigravity Harness。
但到了用户这一端,事情还是有点乱。
今天谷歌同时有Gemini Spark、Workspace Studio、Antigravity、Gemini Enterprise,以及Search里的Information agents。它们面对的用户和场景各不相同,但对于普通人来说,当他们想把一件复杂的事情整个交给谷歌,还是不知道应该找谁。
对谷歌来说,它已经拥有完成这一切所需的大部分条件,缺的只是一个足够简单的产品答案。
而如果谷歌真把这件事做明白了——无论是做出了一个统一的Agent工作台,还是让同一个Agent执行系统穿透整个谷歌生态,让用户习惯“有问题找谷歌”,全球Agent市场的竞争格局恐怕都要再变一变。
话虽如此,谷歌就算真把这套“全家桶”塞进一个Agent,国内用户大概率也只能先围观一下。
还是先看看国内的Agent大战,接下来还会怎么打吧。
 DeepSeek Harness 是自进化 Agent 的基石作者:Cage、Daniel
/
01.
Key Takeaways
1.DeepSeek Harness(DSH)发布的是一套可以热重载的 harness ,并且设计成适合 coding agent 自己去修改、进化的形态。这个发布思路很有野心,没有在白领工作/coding agent 这些方向去和 Claude Code/Codex/Workbuddy 竞争产品,而是延续了他们一以贯之的思路:开源、infra 化。
•开源是把 harness 每一层都拆开开放出来,允许社区开发者一起接受优化
•Infra 化的发布形式提高了使用门槛,避免出现像 Openclaw 那种项目复杂度膨胀太快,最终无法维护的情况。
2.我们可以从三个层面理解 DSH 这次发布:
•第一层是可直接使用的 coding agent,以本地 Web UI 为主要快速入口。这个交互形态的选择能看出开发者 preview 的目的,没有去做完整的桌面端/ TUI。使用起来和 ds 模型适配度很高,能感觉到同一个任务 ds 模型在 dsh 中和比直接用裸模型/其他 harness 更强。
•第二层是 everything-is-a-plugin 的 harness 构造框架。这里面的核心能力都可以自定义,包括其他 agent 中最核心的 agent loop。
•第三层是 Cordis 是一套底层的 meta-framework,能够让插件真正做到热重载、自由组合,以及彻底的遗忘和删除。
3.DSH 的 Cordis plugin 不好直接去类比 MCP/Skills。它更像是 Claude Code 的 hooks、MCP、subagents 和内部核心 loop 全部统一了成一种插件机制。Cordis 解决的是动态组合问题,让组件能在依赖出现/消失时重组,并在卸载时撤回由 context 管理的副作用。注重可组合性和生态扩展性,这让 DSH 有点像早期的 Unix,拥有了类似 OS 的高潜力上限。
4.这次发布的 coding agent 有四个模式,其中 Creator 模式值得关注。它的形式比较像一个交互式 Agent Foundry:允许开发者指导 agent 检查当前 runtime 试验插件,并创作新的 Agent preset 形式。虽然还不是自进化系统,但可以收集 agent 用来学习自进化的数据。 官方同时明确鼓励社区创建与分发第三方插件,因此 Creator mode 也可能成为其插件生态的创作入口。
5.DSH 更长期的目标用户,很可能会为 To Developer 走向 To Agent。它把 harness 做成了对 agent 可以修改、热重载的对象,并不是为了服务现在的 coding agent 需求,而是服务未来下一代的自进化和持续学习框架。有了 DSH 之后,我们愈发能想象下一代 agent 会在 long horizon task 中,一边执行任务,一边更换支撑自身运行的部件,就像一艘持续航行的忒修斯之船。
6.Anthropic Claude Code 与 Deepseek DSH 代表了两种不同的 Harness 研究重点:
•Anthropic 是为了在当前范式下做出一个最好的 agent 产品,目标是最有效、简单,同时最大化模型能力边界的 harness。Deepseek 是在押注下一个范式,因此直接把替换、组合和撤销 harness component 作为首要的假设来进行设计。
•Claude Code 希望做成做端到端的垂直整合产品,来给自己 API 依赖的商业模式增加用户粘性;而 DSH 则是目标完全开放给开发者的。
•因此可以认为 Anthropic/OpenAI 和 deepseek 在研究两个不同的问题:
1)A/O 研究的是 Harness 本身的能力:已有 SOTA 模型应该如何设计 harness 架构,比如 agent loop、subagent 架构来让 harness 表现得最好?
2)Deepseek 在研究的是 Harness 的可塑性:harness 是流动的,一直会被模型内化和重写,那么最重要的就是如何最有效的修改、替换、撤销 harness 中的组件变化?这个问题更接近于 meta harness。
7.DSH 已经提供了 agent runtime self-modification 的底座,但距离真正的 self-evolve 缺少一个完整的学习闭环,需要 有 Learning Loop 来学习并提出修改、Eval 评估修改的有效性。因此当前其实是 Harness-level RSI 的第一步,自身拆成可定位、可替换的组件。
02.
DSH 这次发布了什么?
从产品表面看,DeepSeek Harness(DSH)是一个带本地 Web UI 的 Coding Agent。
官方设置了四个模式,也允许开发者去贡献配置更多模式:
•80% 的任务用标准模式:能力完整、行为可预测,也最容易排错。
•PTC / Code 模式适合工具调用密集的任务:模型不再逐个调用工具,而是先生成一段 TypeScript,再通过run_code调用多个工具。批量分析、跨文件检索、重复操作时收益最大;任务简单时反而可能增加调试成本。
•极简模式是实验室环境:它只保留 Bash 和编辑器,许多便利能力都没有。它的价值在于控制变量:帮助研究者区分能力来自模型本身,还是来自 Harness 的帮助。
•创造模式的核心用途是“造 Agent”:这个模式值得关注,它保留了标准模式的能力,同时允许 Agent 检查 Cordis Runtime、实验新的 Plugin,并编写新的 Preset。创造模式具有更高权限,更适合 Harness 开发和隔离实验。
我们可以把这次发布分为三层去拆解:
1.Coding agent
DSH 没有把 Terminal-first TUI 或桌面端作为主要产品形态,而是选择了更像开发者 Demo 的本地 Web UI。标准模式已经包含真实编程工作需要的主要能力,包括执行命令、修改和搜索文件、调用 Skills、维护计划与目标、启动子代理,以及运行工作流。系统还提供 Context Compaction、会话持久化、Sandbox 和权限审批。
2.Harness construction framework
DSH 不只允许开发者“增加一个 Tool”。Model Adapter、Tool Registry、Sandbox Policy、Subagent Backend,甚至默认 Agent Loop,都可以由 Cordis Plugin 提供。这些组件通过 ctx.llm、ctx.tools、ctx.sandbox、ctx.agentLoop 等稳定的 Service Key 协作,而不是直接 Import 某个具体实现。开发者因此可以替换一个能力的 Provider,同时尽量保持其他组件不变。
3.Cordis meta-framework
Cordis 进一步解决的是:这些组件怎样加入、删除和重新组合,能够不把正在运行的系统破坏掉。
多数 Agent 插件系统主要关心怎样增加功能:安装更多 Tool、Skill 和 MCP。但组件不断增加后,系统也会积累更多 Tool Schema 和依赖关系。模型需要在更多能力之间进行选择,很多人在 Claude Code 中遇到过 Skills 过多后反而效果变差的情况。
这里可以把这种现象理解为一种工程上的“熵增”:系统不断增加能力,却缺少对应的删除和重组机制。这个问题与 Continual Learning 中“记忆与遗忘”的关系有一定相似性。这也是 Cordis 论文 A Programming Paradigm for Spatiotemporal Composability 讨论的核心问题。论文把插件的动态组合拆成两个相互独立的维度来解决。
•时间可组合性 Temporal Composability,是解决处理组件的退出。
一个 Plugin 加载时,可能注册 Tool、Prompt Section、Event Listener、Timer 和 Service。如果只删除插件代码,这些已经进入 Runtime 的状态可能继续存在,形成无法正常清理的“幽灵组件”。Cordis 要求组件在注册 Effect 时,同时提供对应的撤销方式。注册 Tool 时记录怎样注销 Tool,增加 Prompt 时记录怎样移除 Prompt,启动 Timer 时记录怎样停止 Timer。组件卸载后,Runtime 会撤销它在 Context 中留下的 Effect。
•空间可组合性 Spatial Composability 处理组件之间的依赖。
组件不直接绑定某个实现,而是声明自己需要什么 Service。当依赖尚未出现时,组件保持 Waiting;依赖满足后,组件进入 Active;正在使用的 Service 消失或被替换后,组件先撤销自己的 Effect,再根据新的依赖关系重新激活。
因此从产品气质看,当前的 DSH 更接近早期 Unix:默认体验比较粗糙,但底层结构更开放,也允许开发者深入修改。Claude Code 和 Codex 就更像整合度很高的 Windows。
当然这种开放也需要有更长期主义的耐心。“一切可替换”只有在存在足够多、足够稳定的替代组件时才有价值。DSH 当前的 Plugin 生态和状态管理仍处于早期阶段,理解和修改整个项目的门槛也很高,短期内很难直接和 Claude Code、Codex 产生替代关系。
03.
DSH 与 Anthropic harness 是两种不同的 Harness 哲学
如果我们用一个简单的框架理解 Agent:
•Agent = Model + Harness
•Harness = orchestration + context/memory/state + permissions + tools/sandbox/recovery
我们可以发现,Anthropic 与 DeepSeek 的差异并不只是组件设计不同,而是二者在优化不同的目标:
Anthropic Claude Code: 不断试验,优化 Agent 行为
我们阅读 Anthropic 关于 Agent Harness 的技术文章,会发现他们的 Long-horizon Agent 研究通常从 SOTA 模型的能力边界和失败模式出发,再去设计和验证相应的 Harness 机制。例如:
•通过 initializer agent、coding agent 和跨 Session 的 Artifact Handoff,解决长任务中的状态丢失;
•通过 planner、generator 和 evaluator 分工,解决任务规划不足和模型自我评价偏高的问题;
•通过 Context Reset 与 Compaction,缓解 Context 污染和长任务中的连贯性下降;
•通过任务分解、测试反馈和 Scalable Evaluator,控制执行范围,并让每一步都可以被自动验收;
•随着模型能力提升,通过 Ablation 删除不再必要的 Scaffolding。
Boris Cherny 的 YC 访谈中提到,Opus 5 发布后,Claude Code 删除了超过 80% 的 System Prompt。每当新模型发布,团队都会以清空 System Prompt 的 Ablation 作为实验基线,重新运行真实任务;只有当模型反复出现同一种失败时,才逐行加回必要指令。他们也会持续调整 Tool Set,并删除不再提供能力增益的 Harness Code。
Anthropic 的方法很像实证科学。团队先观察当前模型在真实任务中的能力边界,再针对反复出现的失败设计 Harness。每个 Harness Component 都对应一个关于“模型当前无法独立完成什么”的假设;模型进步后,这些假设可能过期,因此需要通过 Eval 和 Ablation 重新验证优化。
DSH:从可变性出发,打造万物可插拔的 Harness
对比以上 Anthropic 的实证研究思路,DSH更像从理论研究的视角想去第一性的解决一个目标问题,也就是Harness 能否被低成本地修改的问题,最终是在设计一个能够持续修改迭代 Harness 的Meta Harness,应该:
•替换一个 harness component
•撤销旧 component 的副作用
•出现修改时重新解析依赖
•让不同 session 使用不同 composition
•让 agent 检查和编写新的 preset/plugin
因此 Anthropic 优化的是当下时间点的最佳结果,DSH 优化的是未来持续探索不同结果的能力。这让我们觉得 Deepseek 更像是想制造一套 Harness Evolution 的操作系统,而不是直接给出一套固定的最佳 Harness。
04.
DSH 的短期用户是开发者,长期用户是 Agent 自己
DSH 当前的产品形态更像开发者预览版,而不是面向普通用户的成熟 Coding Agent。它没有优先打磨 Terminal UI、桌面端和开箱即用的工作流,而是把主要精力放在一个可以被深度修改的 Runtime 上。
对普通用户来说,产品体验是比较粗糙的,不如 Claude Code 或 Codex 好用;但对 Agent Developer 来说,这意味着系统的大部分结构都可以重新组合。开发者可以在 DSH 上替换 Memory、Tool、Sandbox、权限策略和 UI,甚至更换 Agent Loop。最终做出来的产品可能完全看不出原始 DSH 的形态。因此,DSH 短期内更像一个 Agent 开发底座:它不直接交付唯一的最佳产品,而是让开发者基于同一个内核创造不同的 Agent。
它更长期的想象空间,是让 Agent 逐渐成为 Harness 的使用者和修改者。Agent 要改进自己的 Harness,首先必须看懂自己运行在什么系统里。把 Harness 拆成命名清晰、依赖明确的 Component,相当于为 Agent 提供了一张系统地图:它可以定位问题,找到相关组件,再提出局部修改。
这也是插件化的真正意义。它不仅方便开发者扩展功能,也把原本开放式的软件修改,变成了一组边界更明确的操作。Agent 不需要重写整个系统,而是可以尝试替换任何一个组件。如果实验失败,系统还可以卸载插件并恢复原来的组合。自我修改因此从一次高风险的整体重写,变成一系列可以测试和回滚的局部实验。
其中的 Creator Mode 像是连接开发者与 Agent 的过渡形态。今天是开发者指导 Agent 创建新的 Plugin;这些过程未来可能变成训练数据,让模型学习如何设计和改进自己的 Harness。让 Agent 真正成为 Harness 的用户:它不仅调用 Harness 提供的工具,也开始操作 Harness 本身。
未来,人类与 Agent 的分工可能发生变化。开发者不再直接决定每个 Session 使用哪些 Tool,而是负责定义允许修改的范围、可靠的 Eval,以及安全边界。Agent 则在这些边界内不断尝试更适合当前任务的 Harness。
05.
插件机制,DSH 的核心
在 DSH 中,插件是一个可以独立安装、替换和撤销的 Harness 组件。它可以小到一个主题或工具,也可以深入到 Memory、Model Adapter、Sandbox,甚至 Agent Loop。只要遵循 DSH 的统一接口,一个 Harness 组件就可以被封装成插件。
MCP、Skills、Hooks 和 Subagent 定义了某些具体能力或使用方式,DSH 插件则定义了这些能力如何接入整个 Harness。一个插件既可以封装 MCP 或 Skill,也可以包含一套完整的软件模块,改变 Agent 的运行方式。
DSH 通过完全开源的方式拥抱社区。DSH 内核负责维持接口、依赖关系和插件生命周期,社区则在外围快速创新。这样既能避免大量 Pull Request 直接进入核心仓库,也能降低维护不同社区方案的成本。
这种架构很快带来了生态增长。截至 8 月 19 日,GitHub 的 dsh-plugin Topic 聚合了约 7,700 个仓库。经过社区筛选的 awesome-dsh-plugin 已经收录约 1,500 个可通过 dsh plugin add 安装的插件,并获得约 9,200 Stars、1,350 Forks,仓库累计超过 1,800 次提交。
从分类看,目前最集中的方向主要有两类。一类是在补充产品体验,例如 Web UI、桌面端、状态监控和交互组件;另一类是在接入外部 Agent 能力,例如长期记忆、Browser、Vision、Sandbox 和 Workflow。这意味着 DSH 正在成为外部 Agent Infra 接入用户 Runtime 的适配层。对于 Agent Infra 创业者,短期可以借助 DSH 获得分发和用户反馈;长期则要面对接口变化、平台依赖,以及同类插件快速竞争的风险。
围绕插件的分发基础设施也开始形成,比如 dsh-market 提供插件搜索、安装和升级,dsh-find-plugin 则允许 Agent 在对话中主动寻找插件。社区不只在开发插件,也开始建设插件发现、安装和管理的完整链路。
从这个角度看,DSH 的插件生态不只是一个应用商店,而是一个开放的 Harness 搜索空间。不同开发者可以并行尝试不同的 Memory、Tool、Workflow 和 Agent Loop。更长期的目标,则是让 Agent 自己读取、编写、测试和选择插件,通过改变 Harness 来改善自身行为。
06.
离真正的 self-evolve harness 还有多远
难点 1: 保持系统自身的稳定性
在 Agent 修改自身配置时,一个经典的痛点是如何保持自身稳定,避免 Agent 在修改配置、工具或核心代码时破坏自己的运行环境。这类风险已经出现在 Hermes、OpenClaw 等允许 Agent 修改自身配置的系统中。
更复杂的 Self-Evolution 不能依赖“修改完成后重启”。它需要支持系统一边运行,一边替换支撑自身运行的组件。这就是Cordis 想核心实现的热重载:不关闭整个进程,也不重启完整的 Agent,而是在 Runtime 中卸载旧组件、清理它留下的状态,再加载新的实现。
DSH 这套插件机制的价值,不只是“方便替换组件”,而是把一次危险的全局修改缩小成有边界的 Component Mutation。Agent 可以复制当前状态,在隔离的 Context 或 Sandbox 中修改一个 Plugin,通过热重载加载候选版本,再决定采用还是撤销。
Cordis 将不同的 Harness 能力组织成具有统一生命周期的 Plugin。每个 Plugin 注册的 Service、Tool 和 Event Listener,都会被记录为该 Plugin 拥有的 Effect。当 Plugin 被卸载时,这些受 Cordis 管理的 Effect 会随之撤销。它还会持续跟踪组件之间的依赖关系。如果一个 Service 被卸载,依赖它的 Plugin 会暂时退出运行,避免继续使用失效的引用。新的 Service 加载完成后,这些依赖组件再基于新实现重新启动。
这可以被理解为类比为数据库中的 Transactional Harness Mutation。一次 Harness 修改像数据库事务,更好的状态管理,使 Agent 能够在不摧毁自身的情况下进行更多 Harness-level RSI 实验。目前 Cordis 距离稳定的自我修改系统,还需要一套更完整的状态管理。
难点 2: 持续可靠的 eval
Harness 能生成修改不等于自我改进。只有系统能够判断哪些修改真的更好,并把它们保留下来,Self-Mutation 才会变成 Self-Improvement。
从工程实现上来说,如果一个问题能够被低成本、稳定地评价,解决问题就可以被转化为搜索和优化。系统不断生成候选方案,运行 Eval,保留更好的版本,再进入下一轮迭代。测试充分的代码任务、Kernel 优化和棋类游戏之所以容易形成自动改进闭环,就是因为结果相对容易验证。
DSH 的 Creator Mode 可能是一个重要的数据入口。Create Agent 可以检查当前 Runtime,复制已有 Preset,修改 Cordis Composition,并生成一个可以被其他 Session 加载的新 Agent。这个过程可以产生 Harness Patch、修改理由和人工反馈,为未来构建 Eval Suite 提供原始材料。
但创作轨迹本身还不是可靠的 Eval。开发者接受一个 Preset,不代表它在其他任务上也更好。系统还需要记录新旧版本的对照结果,并通过 Held-out Tasks、Regression Test 和 Canary Deployment 检查改进能否迁移、是否带来能力退化。Create Mode 解决了一部分候选生成和数据积累问题,但距离持续可靠的 Eval System 仍然很远。
真正的 Self-Evolving Harness 需要一套完整的 Learning Loop
目前 Cordis 解决的主要仍是 “Harness 能否被更可控地调整”。它不知道为什么应该替换 Agent Loop,也不能判断新 Loop 是否真正提高了整体能力。它提供了运行和管理候选方案的底座,却没有完成问题诊断和效果的自动化评估。
但这是一个很好的开始。Cordis 先解决了“系统能不能在不破坏自身的情况下修改 Harness”,让更多 Harness-level RSI 实验成为可能。下一步,才是让系统从这些实验中持续学习,并把有效的修改保留下来。
07.
从 DSH 展望未来的 RSI
RSI 是AI 能否越来越擅长改进自己。核心是递归反馈:上一轮改进不仅提高了任务表现,也提高了系统下一轮发现问题、设计实验和产生改进的能力。其中又可以定义为两类:
•一类是模型开发过程中的迭代 Model-level RSI。随着 Compute 和模型能力提高,交付下一单位智能所需要的 Researcher 数量是否持续下降。
•另一类是 Agent 在工作中是否能够持续变好 Harness-level RSI。随着一个 long horizon task 任务执行深度增加,是否能够更好地改进自身来完成任务。DSH 在解决的就是这类问题。
可以作为一个现实的观察指标。今天的 Coding Agent 已经能够承担代码实现、实验执行和结果分析等工作,Researcher 则逐渐转向选择方向、定义 Objective 和判断结果。我们正在看到 Research Automation 向初级 RSI 过渡:模型开始进入生产下一代模型和系统的流程,但整个改进方向仍然主要由人决定。
RSI 也不一定从模型直接修改自己的 Weights 开始。Lilian Weng 认为,一条更现实的近期路径,是先把模型外部的 Harness 变成优化对象。优化范围会从 Prompt 和 Structured Context,逐渐扩展到 Workflow、Harness Code,最终可能进入负责优化 Harness 的 Optimizer Code。此时,系统改进的不再只是一次任务的答案,而是“如何获得更好答案的方法”。
放到 Harness 层面,RSI 也不只是让 Agent 为自己写一个新 Tool。它需要形成一个完整过程:Agent 从任务轨迹中发现稳定的失败模式,判断问题来自 Memory、Tool、Context Management 还是 Agent Loop,提出新的 Harness 方案,再通过独立 Eval 判断新方案是否真的更好。验证有效的方案被保留,并成为下一轮任务和改进实验的起点。
这有点像一艘持续航行的忒修斯之船。Agent 一边执行任务,一边更换支撑自身运行的部件。但真正重要的是每次更换之后,它是否能航行更快,也更好判断下一次应该更换什么。
这里首先需要解决的是 Harness 的可理解性。Harness 的组件彼此依赖,修改一个部分会牵一发动全身。Agent 如果不知道系统由哪些部分组成,也不知道一次失败对应哪个组件,就很难安全地改进自己。Harness 内部还存在复杂依赖,一次 Agent Loop 的变化可能同时影响 Tool、Prompt 和 Context State。
DSH 解决这个问题的方式是插件化和热重载。它通过 Cordis 把 Harness 组织成边界相对明确的 Component,使 Agent 能够查看系统结构,定位相关能力,并尝试调整 Memory、Tool、Workflow 或 Agent Loop。Plugin 不只是扩展功能的接口,也让原本隐藏在 Runtime 内部的 Harness 变成一个显式的优化空间。
如果未来 Agent 能继续优化这套选择机制,让 Agent 修改进一步提高了 Agent 诊断失败、提出方案和设计 Eval 的能力,使后一轮改进比前一轮更有效,就能走向真正的Harness-level RSI。关于更广范围的 RSI 与持续学习,我们后续还会发布研究,继续分享对新范式的理解。
 智谱在天猫开店卖Token了:成首家入驻主流电商平台的大模型厂商以后打开淘宝搜"智谱旗舰店",你能买到的不再只是衣服和数码产品——而是大模型的调用额度。
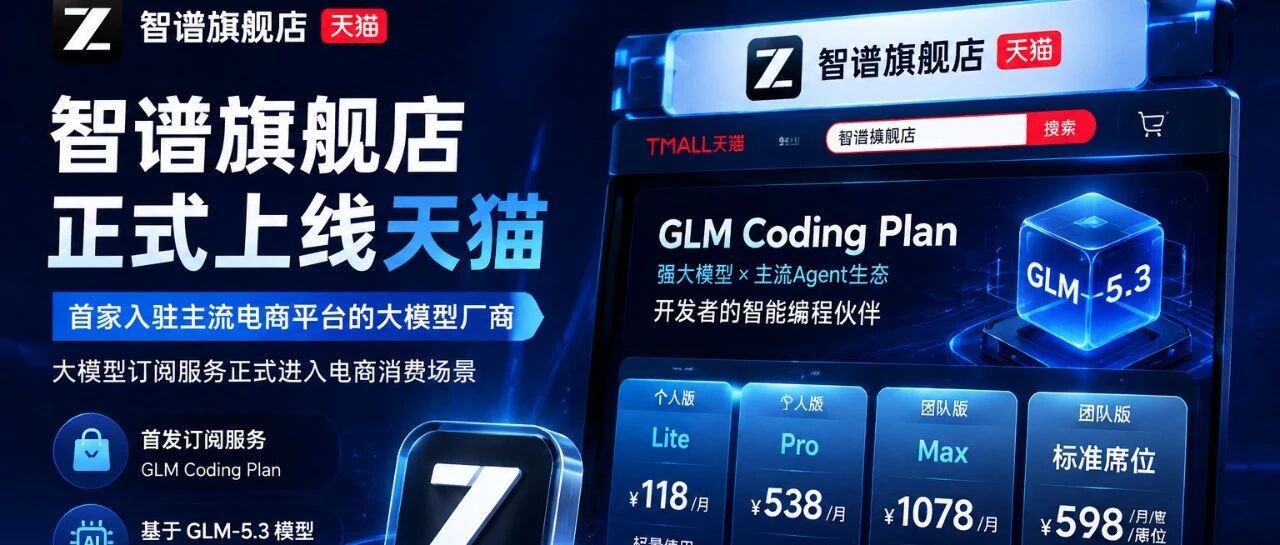
9月2日,智谱正式入驻天猫开设官方旗舰店,成为第一家登上主流电商平台的大模型厂商。店铺里上架的不是模型、不是API文档,而是四款明码标价的"GLM Coding Plan"订阅套餐:个人版Lite每月118元、Pro每月538元、Max每月1078元,团队版标准席位598元/月,支持按月、季、年订阅,支持支付宝、支持开发票。
一位企业工程师的评价很到位:"以后买Token可以像充话费一样丝滑,大促节点说不定还有折扣。"
货架上卖的是什么
套餐基于8月刚发布的GLM-5.3模型——这是智谱最新旗舰,在Artificial Analysis智能指数上拿到60分,进入全球前沿模型区间,与Claude Fable 5、GPT-5.6 Sol同档,并和Kimi K3并列开源模型第一。它兼容ZCode、Claude Code、Codex等20余款主流Agent工具,买完拿到额度,代码生成、调试、重构随便用,超出部分再按标准API计费。
模式确实和手机话费套餐一模一样:固定月费、额度打包、用超再加价。对高频开发者,锁定月费比按次调用便宜——商品页直接标注"较标准API最高省87%到90%"。
但值得注意的是,这次天猫定价相比年初版本大幅上调:Lite、Pro、Max三档月费分别从49元、149元、469元涨至118元、538元、1078元,其中最热门的Pro档直接变成原价的3.6倍。智谱的解释是:新套餐改为以Token消耗为基础的积分制,额度更透明可预期,非高峰时段还有50%积分抵扣,且模型从GLM-5升级到了GLM-5.3。
涨价的不止智谱一家。今年上半年Coding Plan市场刚打完价格战,腾讯、MiniMax、Kimi就陆续下架了包月套餐,阿里关停了入门档位,整个行业从"低价抢人"转向"精简提价"。智谱选择在这个时点把涨价后的新套餐搬上天猫,底气是模型能力,也是生存压力。
为什么偏偏是现在
看一眼财报就明白了。
8月31日晚,智谱发布2026年中报:上半年营收9.54亿元,同比增长399.7%,超过去年全年;但净亏损20.7亿元。作为今年1月登陆港交所的"全球大模型第一股",它的股价曾从116.2港元发行价冲到2980港元、市值破万亿,随后又大幅回调,市值蒸发超5000亿港元。
增长引擎已经换挡:上半年开放平台及API收入8.25亿元,同比暴增2735.7%,占总收入比重从去年同期的15.2%飙升到86.5%。换句话说,智谱已经从"卖项目、卖定制"的传统软件公司,变成了"卖调用量"的Token零售商。董事长刘德兵把上半年的关键词定义为"能力兑现"——模型第一次被证明能独立把事做完,收入结构随之置换。
背景板是整个Token经济的爆发:国内日均Token消耗量已突破140万亿,比2024年初的1000亿增长超1000倍。今年5月三大运营商集体推出Token套餐,阿里成立AlibabaTokenHub事业群,腾讯云升级全域TokenHub——"卖Token"已经成了AI产业链上最拥挤的生意。智谱上天猫,本质是在这场零售战争里抢占离普通用户最近的那个收银台。
套餐化的隐忧与出路
不过话费套餐留下的历史教训也摆在那儿:档位可以多,账单别靠猜。
有观察者已经提醒:商品页上"10000积分"的数字很醒目,但普通用户真正想知道的是——这些积分够我写多少代码、跑多少次任务?大模型用量比手机流量难感知得多,有人天天用它干活觉得值,也有人第二个月打开账单才想起自己还订着。订阅制最大的敌人从来不是价格,是沉默续费。
好在电商货架本身就是最好的倒逼机制。当Token从开发者文档里的专业概念变成淘宝商品,它就得接受零售世界的规则:七天无理由式的体验保障、双11的折扣大战、买家秀和评价区的公开处刑。哪家套餐说明写得像天书,哪家额度虚标,评论区会替市场教育它。竞争越往零售走,计费透明和用户体验就越没法糊弄——这对消费者是好事。
结语:Token正在变成水电煤
从官网自助购买,到运营商套餐,再到天猫旗舰店,Token的销售路径正在复刻所有数字商品的大众化之路。智谱这一步的象征意义远大于开业当天的销量——截至发稿,四款商品还没有销量显示。
但方向已经清楚了:大模型能力正在从"技术产品"变成"生活耗材"。就像没人关心电是哪个电厂发的,只关心电费多少钱一度、充值方不方便;未来大多数人也不会关心背后是哪家模型,只关心每月那笔AI订阅费,值不值。
下一站,双11的Token满减券,已经可以期待了。
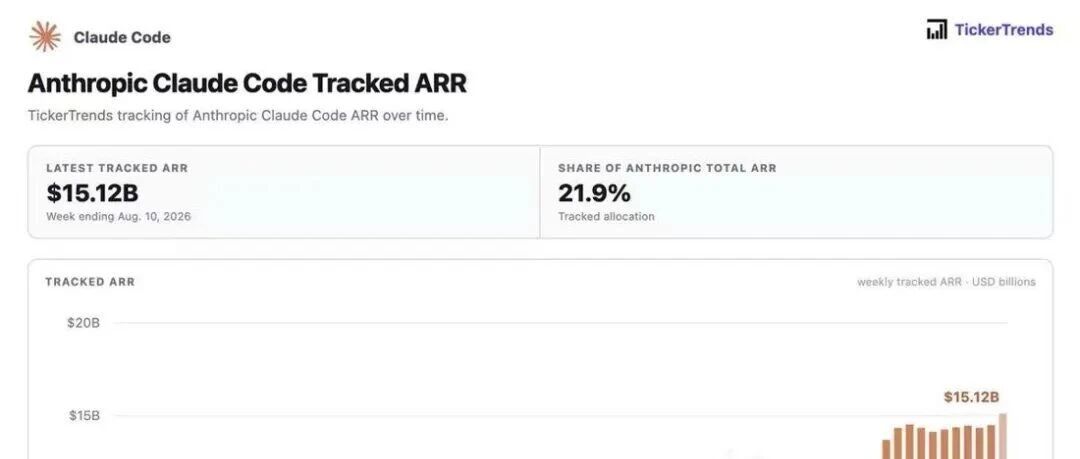 Anthropic的增长放缓了吗争议的源头。TickerTrends 制作的 Claude Code ARR 追踪图,最新数据为 2026 年 8 月 10 日当周,151.2 亿美元,占 Anthropic 总 ARR 的 21.9%。请注意:这是第三方机构的估算,不是 Anthropic 的官方披露。下面第一节会讲清楚这个区别有多重要。
硅谷 Alan Walker 在香港约了顿晚饭,等人的功夫翻群,发现这张图已经被转了三十几次,配的话大同小异——「Anthropic 增长拉平 了,两万亿是泡沫」。
Alan 把图存下来,放大看了一遍,然后又看了一遍。
问题不在这张图。这张图做得很好,数据也大概率是认真做的。问题在于,几乎所有转发它的人,都在用它回答一个它根本回答不了的问题。
01
先搞清楚这张图是谁做的
左上角有个 Claude 的图标,配色是 Claude 那个熟悉的橙色,一眼看过去很像官方出品。
它不是。
这张图的作者是 TickerTrends,右上角写着自己的名字。它是一家 第三方数据追踪机构,靠各种外部信号(应用数据、支付面板、招聘、渠道口径等等)去估算一家非上市公司的收入。图里那行小字写得很老实:「tracked allocation」——追踪出来的分配比例。
说白了:Anthropic 从来没有公开披露过 Claude Code 单独的 ARR 数字,一次都没有。这条曲线上的每一个点,都是 外人估的。
举个例子
这就好比有人用「某餐厅门口每天排多长队」来估算它的营业额,然后画出一条漂亮的周度曲线。队伍长度和营业额确实相关,但中间隔着翻台率、客单价、外卖占比、包厢生意——你看到队伍短了三周,可能是那三周厨房在装修。
更要命的是口径本身。ARR 的算法是「最近一段时间的收入 × 12」。企业软件的合同不是每天均匀落地的,是一批一批签的。一个季度末签下的大单,会让某一周的曲线跳一大截;下一个季度的大单还没签,曲线就横着走。周度 ARR 追踪对这种块状落地极不敏感——它会把「签约节奏」画成「需求变化」。
一句话解读
你手里拿的是一张外人估的、口径很钝的、非官方的周度图。用它下"泡沫"这么重的判断,等于用体温计量血压。
02
这张图自己就打了自己的脸
接下来这一点,没见有人提过,但它是整件事里最有意思的地方。
图上写着两个数:Claude Code 是 151.2 亿美元,占 Anthropic 总 ARR 的 21.9%。
做个除法:
算一下
151.2 亿 ÷ 21.9% = 约 690 亿美元
这是这张图自己隐含的、截至 8 月 10 日当周的 Anthropic 公司总 ARR。
而 Bloomberg、Reuters、CNBC 在 8 月 17 日报道的官方口径数字是——7 月底 650 亿美元。
看清楚了:这张被拿来论证"增长放缓"的图,它自己隐含的公司总量,比十天前的官方数字还高出 40 亿美元。
再往后推十天到今天,如果趋势没断,700 亿以上 是合理的推算(这一句是推断,不是数据)。
一句话解读
转发的人只读了 151.2 这个数和柱子的高度,跳过了旁边那个 21.9%。而那个 21.9% 说的是:这家公司在大家喊"它慢下来了"的时候,又往上走了一截。同一张图上的两个数,只信对自己观点有利的那个,这不叫分析。
03
你在看下面那张图,钱在上面那张图里
那张图有上下两块。上面是绝对金额(多少亿美元),下面是百分比变化(比四周前涨了百分之多少)。
绝大多数人的推理是:在下面那张图上看到 85% 掉到 5.2%,得出"塌了",然后把这个结论按回上面那张图,说"你看柱子都一样高"。
先算个数。5.2% × 151.2 亿 = 一个月新增约 7.5 亿美元的年化收入。而 2025 年 3 月那个 85% 的月份,基数还不到 1 亿美元——那个"爆发"的月份,实际增加的钱只有今天这个"平淡"月份的 十分之一 左右。
举个例子
你儿子三岁时一年长 20 厘米,十六岁时一年长 3 厘米。增速掉了 85%。你会说"这孩子发育出问题了"吗?
百分比是分数,分母一直在变大。100 块涨 85% 是 85 块,15,120 块涨 5.2% 是 786 块。后者是前者的九倍多。你在下面那张图上看到的"崩塌",在钱上是"多赚了九倍"。
但 Alan 要把话说完整,不然就是耍赖:绝对新增 确实从峰值 回落 了。
四五月那两个月,Claude Code 从 50 亿量级冲到 135 亿量级,月均新增 40 亿;到 7 月只剩 3 亿量级。五倍以上的回落,不能拿"你看百分比看错了"糊弄过去。
所以真正该问的不是"有没有减速"——有。真正该问的是两件事:为什么减速?以及,为什么它又翘回来了?
请再看一次图的最右端。最后一根柱子是跳上去的,下面那条线也从 2% 回到了 5.2%。一条正在右端回升的曲线,被读成了拉平。
04
走平的那三周,模型是下线的
把日历拿出来对一遍,答案就在明面上,一点都不神秘。
6 月 9 日,Anthropic 把 Mythos 级别的模型推向公开可用,对外叫 Fable 5 和 Mythos 5。6 月 12 日,为遵守美国商务部的 出口管制令,两个模型全部下线。6 月 30 日商务部解除该管制,7 月 1 日恢复。
那段所谓的"平台期",正好卡在这个三周的洞上。
比这三周更根本的是 产能。Anthropic 在 4 月公开承认过,需求给基础设施带来了压力,高峰期的可靠性和性能都受了影响。而它跟 Amazon、Google、Nvidia、Microsoft 签的那些算力协议,绝大部分要到 2026 年底或 2027 年初 才上线。
这一段是重点
一条贴着产能上限走平的收入曲线,含义是「能卖的全部卖光了」,不是「没人买了」。
这两件事在图上长得一模一样。在估值上,一个是天花板,一个是发射台。
举个例子
一家火锅店只有 20 张桌子,天天翻台到打烊,营业额横着走了三个月。你能说"这家店没人气了"吗?它的营业额被桌子数锁死了。等隔壁铺面盘下来、桌子加到 50 张,营业额会立刻跳一个台阶。怎么区分"没人来"和"坐不下"?看三件事:它有没有降价(没有)、有没有排队和限速(有)、加了桌子之后是不是立刻坐满(这正是 8 月那根跳上去的柱子在说的事)。
05
占比会说话:17% 涨到 22%
如果 Claude Code 真的失速了,它在公司收入里的比重应该往下掉。事实是反的。
2025 年 11 月 - Claude Code 10 亿 | 公司总 ARR 约 70–90 亿 | 占比约 12%
2026 年 2 月 - Claude Code 25 亿 | 公司总 ARR 约 140 亿 | 占比约 18%
2026 年 5 月 - Claude Code 约 80 亿 | 公司总 ARR 470 亿 | 占比约 17%
2026 年 8 月 10 日 - Claude Code 151.2 亿 | 公司总 ARR 约 690 亿 | 占比 21.9%
在被称为"平台期"的那个窗口里,Claude Code 占公司收入的比重从 17% 涨到了 22%。而同一个窗口,公司总量增加了约 180 亿美元。
一句话解读
Claude Code 不但没掉队,还跑赢了一家七个月长了 7.2 倍的公司的平均速度。(其中 5 月的 80 亿是单一来源估算,2 月和 11 月的公司总量是我按公开节点推的,见文末核实说明。但首尾两端的 17% 和 21.9% 分母都相对硬,结论不依赖中间那几个数的精度。)
06
拿互联网比?方向全反了
群里有人说"互联网用户当年也没这么慢"。这句话里有三个错,方向全是反的。
第一,速度比反了
1995 年全球网民约 1600 万,2000 年约 3.6 亿。五年 23 倍,年化约 86%。Claude Code 是 六个月 6 倍。放到同一把尺子上,它比互联网普及期快一个数量级不止。
再换个更狠的参照:Salesforce 用了大约二十年做到 300 亿美元年收入。Anthropic 从第一美元开始,不到三年。
第二,S 曲线的形状记反了
互联网用户增长的百分比增速,从第一天起就是往下掉的。AOL 从 1994 年的 100 万订户到 2000 年的 2300 万,月增速一路下滑,同时每月净增的人数一路上升。所有 S 曲线都长这样:百分比递减、绝对值递增。
第三,量纲搞错了
用户数是一个变量。收入是 席位 × 用量 × 单价 三个变量相乘。
举个例子
一家公司买了 500 个 Claude Code 席位,明年可能一个新席位都不加——但每个工程师从每天跑 2 个 agent 变成跑 20 个,用量涨 10 倍;再叠加更贵的模型层级,单价再涨一档。席位数完全没动,收入涨了十几倍。用户曲线里没有这条路,收入曲线里有两条。
07
图上看不见的:它其实变强了
这半年 Anthropic 不只是"没那么糟"。它在这张图完全照不到的地方,实打实变强了四处。
一 · 从"烧钱"叙事里走出来了
Q2 调整后 经营利润为正。在前沿模型实验室里,这是罕见的。过去两年所有对 AI 公司最核心的怀疑是"收入是烧钱买来的、单位经济不成立"。一个正的经营利润数字,把举证责任反过来推给了怀疑的一方。而且这是在算力最紧、最贵的半年里做到的。
二 · 不再靠一条腿站着
Claude Code 只占 22%,另外 78% 是 API 和企业业务。市场把 Anthropic 叫做"那家做编程工具的公司",但四分之三的收入不来自那个工具。这意味着:哪怕有一天编程 agent 的竞争把 Claude Code 的份额打掉一半,公司也不会塌。而市场今天的定价,很大程度上还挂在"编程"这一个故事上。
三 · 客户在往上走
年花费 超过 100 万美元 的客户,从两年前的十几家到 500 多家,再到 1000 家以上;年花费 超过 10 万美元 的客户一年增长约 7 倍。大客户续费不靠销售,靠工作流嵌进去之后拔不出来。这是净收入留存率的机器,也是这类公司在增速自然回落之后仍能撑住高倍数的根本原因。
四 · 相对位置换了
同一段时间:OpenAI 从约 200 亿到约 400 亿,翻了一倍;Anthropic 从 90 亿到 650 亿,7.2 倍。两家口径可能不同,但差距的方向没有歧义。
08
下一波在哪,什么时候来
以下是 Alan 的判断,不是公司披露。四个点,附时间窗。
点一|算力上线 — 2026 年四季度到 2027 年一季度
这是最直接、最可计算的一个。如果六七月的平台确实是产能造成的,那 产能上线 就是收入的机械解锁:多吉瓦级的 Amazon 部署、Google 与 Broadcom 的 TPU 产能、以及和 xAI / SpaceX 那笔算力交易,全都指向这个窗口。观察方法很土但有效:看限速有没有放松、新层级的模型是不是不再排队。产品端的松绑,比任何财报都早两个月告诉你答案。
点二|走出开发者 — 2026 下半年起步,2027 放量
全球专业开发者大约 3000 万人。知识工作者以十亿计。中间隔着两个数量级。Claude Code 完成的是一道证明题:agent 这东西真的有人肯付钱,而且肯付很多。接下来 Cowork、Excel、PowerPoint、Word、Outlook、Chrome、以及 Slack 里 @Claude 的那套东西,是把这个已经验证过的付费意愿,卖给不写代码的所有人。这条曲线的斜率一定比 Claude Code 缓——非开发者采纳更慢、工作流更碎。但它的天花板不在同一个楼层。这也是"开发者渗透到顶了怎么办"的唯一正经答案。
点三|Mythos 层的定价 — 时间未定,但一定是个台阶
目前 Mythos Preview 只开放给少数受信任的机构(Project Glasswing),Fable 5 是加了安全措施的公开版本。这一层真正大规模可用的时候,每客户收入会跳一档,因为它卖的不是同一个东西。这一层的时间表已经被出口管制打断过一次(就是 6 月那三周),所以它同时也是 政策风险 最集中的一个点。
点四|上市本身 — 2026 年 9 月到 10 月
6 月已经向 SEC 保密递交招股书,摩根士丹利、高盛、摩根大通在做承销。上市不是收入事件,是 资本事件,但它对收入的传导链条极短:募到的钱换算力,算力换收入。而且 Anthropic 有机会比 OpenAI 先上——在算力就是产能的行业里,先拿到 大资本池 是可以复利的先手。
09
两万亿贵吗?先去香港看一眼
这是全文我最想让人看的一节。
要判断两万亿贵不贵,不能自己跟自己比,得找 同类。而最好的同类不在纳斯达克——就在香港。
2026 年 1 月 8 日和 9 日,智谱(02513.HK)和 MiniMax(00100.HK)连着两天在港交所敲钟,成了全球第一批公开交易的大模型公司。它们第一次让市场看到:二级市场愿意为一家纯大模型公司出什么价。
智谱 02513.HK ARR 约 10 亿美元(2026 年 7 月)| 市值约 7312 亿港元 ≈ 938 亿美元(7 月 10 日)| 约 94× 2025 年收入 7.24 亿元人民币,净亏 47.18 亿元
MiniMax 00100.HK ARR 约 3 亿美元(2026 年年化)| 市值约 842 亿港元 ≈ 108 亿美元(7 月 10 日)| 约 36× 2025 年收入 0.79 亿美元,经调整净亏 2.51 亿美元
Anthropic 若按 2 万亿 ARR 约 690 亿美元(8 月 10 日)| 2 万亿美元(市场传的目标)| 约 29× Q2 调整后经营利润为正
把这三行连起来看
香港市场愿意给一家 ARR 10 亿美元、年亏 47 亿人民币的公司约 94 倍 ARR。用同一把尺子量 Anthropic,两万亿只有约 29 倍——而它的 ARR 是前者的 69 倍,增速不慢,而且已经开始赚钱。
要么香港疯了,要么两万亿不贵。这两个结论必须选一个。
而且智谱这个数字不是野路子。它 2026 年 5 月市值一度到 6915 亿港元,6 月冲到 8800–9000 亿港元区间,恒生科技指数在 5 月把它纳了进去。按它 3 月末 17 亿元人民币的 MaaS ARR 算,当时市销率一度到 544 倍;即便用高盛、摩根士丹利给的 2026 年 70 亿元人民币收入预期算,也还有 130 倍以上。
一句话解读
拿"倍数太高"去质疑两万亿的人,如果去看一眼港股同赛道在交易的价格,会发现自己质疑错了对象。在当下这个市场情绪里,两万亿配 690 亿 ARR,是这三家里最 保守 的一个。
再把 Anthropic 自己的几条口径摊开,看得更清楚:
Series H 定价(2026 年 5 月) 9650 亿 ÷ 470 亿 = 20.5×
2 万亿 ÷ 当前 ARR(图上隐含) 20000 亿 ÷ 690 亿 = 29.0×
2 万亿 ÷ 年底 ARR(FT 引投资人预期 1000–1200 亿) 20000 亿 ÷ 1100 亿 = 18.2×
2 万亿 ÷ 2028 年收入(公司给投资人的 1900–2000 亿) 20000 亿 ÷ 1950 亿 = 10.3×
两万亿不是一次重新定价,是同一个倍数乘一个更大的基数。五月的私募轮就已经给了 20.5 倍。如果年底 ARR 落在投资人预期区间,两万亿反而比五月那轮更便宜。
所以要论证泡沫,必须论证的是"20 到 30 倍 ARR 这个倍数本身错了",而不是"增长停了"——后者已经被数据直接否掉。这两件事的难度天差地别:前者要谈毛利率、留存和竞争格局,后者只需要看错一张图。大部分人选了后者。
方法论提醒
不要把当期倍数套到远期收入上。"现在 29 倍 ARR,明年 ARR 翻倍所以值 4 万亿"——这是把同一份增长算了两遍。倍数 和 增长 里只能有一个是变量。上面那张表分四行,就是为了让每行的分子分母都站在同一个时点上。
但香港也给了一个警告 · MiniMax 的四个月
MiniMax 1 月 9 日上市,发行价 165 港元,首日收盘涨 109%。3 月最高冲到 1330 港元,市值一度突破 4100 亿港元。到 7 月 10 日,市值 842 亿港元——较峰值缩水约 80%,用了四个月。转折点是 解禁。稀缺性溢价一旦变成基本面定价,倍数收缩 的速度会比任何人预期的都快。
这件事对 Anthropic 的意义不是"所以它也会跌 80%"——两者的收入规模差 200 倍,盈利状态完全不同。真正的意义是:上市之后,故事让位给 报表。9 月或 10 月的招股书里,毛利率、留存率、客户集中度 会第一次白纸黑字写出来。那才是定价真正开始的地方。
10
真正该吵的四件事
能改变结论的问题,一个都不在那张图上。
毛利率。这是唯一有分量的争论点。推理成本坐在成本项里,如果 29 倍收入对应的是 50% 毛利,实际就是 58 倍毛利,位置立刻不便宜了。参照系已经有了:智谱 2025 年综合毛利率 41.0%,MiniMax 25.4%(其中企业端 69.4%、消费端只有 4.7%)。传统 SaaS 那种 75%–85% 的结构,在大模型行业里目前谁都没做到。
收入口径。ARR 是最近一个月乘十二。上市前如果收紧成更保守的口径,账面上会出现一次"缩水",那不是业务变差。真正硬的数字是入账收入:上半年 162.3 亿美元。
客户集中度与留存。650 亿里有多少来自前二十个客户?招股书里会有。这一个数字对估值的影响,超过未来六个月所有的曲线波动。
开发者天花板。151.2 亿 ÷ 3000 万开发者 ≈ 每人每年 500 美元。这个渗透已经不低了。再往上必须靠单价、用量,或者靠第八节说的"走出开发者"。
11
写在最后
九月或十月,招股书会把所有猜测替换成 审计过的数字。毛利率、留存、集中度、真实口径——今天在群里吵的一切,到那时候都会变成可以查的表格。
在那之前,用一张第三方估的周度曲线,去判断一家 650 亿美元 ARR 公司的命运,是在用手上最弱的证据回答最重的问题。
那张图确凿说明的事只有一件:Claude Code 在六个月里从 25 亿长到 151 亿,中间因为一纸出口管制令,模型下线了三周。
剩下的,都是在柱子的高度里读心。
饭局的人到了。九月见招股书。
核实说明
一、已核实(多家主流媒体,2026 年 8 月 17–18 日)
· Anthropic ARR 7 月底突破 650 亿美元;5 月 470 亿;2025 年底约 90 亿。Bloomberg 首发,Reuters、CNBC、Axios、TechCrunch 独立确认。
· Q2 初步收入超过 115 亿美元,去年同期 7.87 亿;Q1 为 47.3 亿,环比增幅超 140%;Q2 调整后经营利润为正(Bloomberg 见到的文件)。OpenAI ARR 约 400 亿美元,年初约 200 亿(Bloomberg)。
· 投资人预期 2026 年底落在 1000–1200 亿(FT);公司给投资人的 2028 年收入预测 1900–2000 亿(Reuters,8 月 14 日)。
· 2026 年 6 月保密递交 S-1,摩根士丹利、高盛、摩根大通承销,预计 9 月或 10 月上市。Series H 于 5 月 28 日以 9650 亿美元估值完成。
· Fable 5 与 Mythos 5 于 6 月 9 日上线,6 月 12 日因商务部出口管制令下线,6 月 30 日管制解除,7 月 1 日恢复。
· 智谱 2026 年 1 月 8 日、MiniMax 1 月 9 日在港交所上市;智谱 2025 年收入 7.24 亿元人民币(+131.9%)、综合毛利率 41.0%、净亏损 47.18 亿元、经调整净亏损 31.82 亿元;MiniMax 2025 年收入 7903.8 万美元(+158.9%)、毛利率 25.4%、经调整净亏损 2.509 亿美元。
· MiniMax 3 月高点约 1330 港元、市值一度超 4100 亿港元;7 月 10 日市值约 842.42 亿港元。智谱 7 月 10 日市值 7311.8 亿港元。
二、单一来源 / 估算 / 未能核实
· 图中 151.2 亿美元与 21.9% 占比来自 TickerTrends,属第三方估算(页面标注 "tracked allocation"),非 Anthropic 官方披露。Anthropic 从未单独公开过 Claude Code 的 ARR。
· 由 151.2 亿 ÷ 21.9% 推出的「约 690 亿公司总 ARR」,是该第三方口径下的隐含值,不是官方数字。「今天可能超过 700 亿」是作者推断。
· Claude Code 2026 年 5 月约 80 亿,来自单一二手统计站点;表格中 2025 年 11 月、2026 年 2 月的公司总 ARR 为按公开节点推算,非披露值。
· 智谱 ARR「约 10 亿美元(2026 年 7 月)」来自多家中文媒体引述知情人士,智谱官方未回应确认。智谱可核实的公开 ARR 口径是 3 月末 MaaS 平台 17 亿元人民币。
· MiniMax「年化收入约 3 亿美元」来自媒体对其 2026 年 2 月 ARR 超 1.5 亿美元的外推,非公司披露。
· 港元兑美元按 7.8 折算。港股市值为 7 月 10 日数据,波动极大,读者阅读时的实际数字可能已显著不同。
· 2 万亿美元 IPO 目标估值为媒体转述的市场预期,非公司公开表态。
· 年花费超 100 万美元客户「1000 家以上」、超 10 万美元客户「一年 7 倍」来自 Sacra 及公司此前公开表述,未核对最新时点。
· 与 xAI / SpaceX 的算力交易金额来自媒体报道,未见双方公告原文。
三、历史参照(公开记录)
· 全球互联网用户 1995 年约 1600 万、2000 年约 3.6 亿;AOL 订户 1994 年约 100 万、2000 年约 2300 万。不同来源口径有出入。
· Salesforce 达到约 300 亿美元年收入用时约二十年。
四、作者推断(非事实)
· 六七月平台期的主因是产能约束与出口管制停机,而非需求见顶。
· 四个「下一波」的点与时间窗全部为推断;算力窗口依赖公开报道的协议上线时间,非公司承诺。
· 「香港市场给的倍数说明两万亿不贵」这一比较,前提是三家公司可比。实际上业务结构、客户地域、监管环境、流动性折溢价均不同,跨市场倍数比较只能作为参考量级,不能当作定价依据。
· 毛利率是唯一有分量的争论点、29 倍收入对应 58 倍毛利的推算,为示意性计算,Anthropic 未披露毛利率。
· 每开发者约 500 美元/年的渗透测算,使用「全球专业开发者约 3000 万」这一区间中值,该口径本身有争议。
五、重要提示
· 本文由 Claude(Anthropic 制造)协助撰写,讨论对象为 Anthropic 自身,存在直接利益冲突。
· ARR 与入账收入是两回事。ARR 是近期收入的年化外推,会放大好月份,也会放大坏月份。
· 本文不构成投资建议。Anthropic 目前未上市;文中提及的港股公司股价波动剧烈,历史表现不代表未来。
 DeepSeek做了一款"不是模型"的产品Harness,却可能比模型更重要8月13日晚,DeepSeek没有发新模型,而是开源了一个叫Harness的东西。
一天之内,GitHub星标近8万。这个速度超过了当年R1和Grok-1的纪录。
Harness不是模型权重,不是API接口,而是一层"壳"——套在模型外面、让模型真正能干活的执行系统。DeepSeek给了一个公式:Model + Harness = Agent。
翻译一下:模型负责想,Harness负责干。
为什么DeepSeek要做这个?
这个问题才是整件事最有意思的部分。
就在Harness发布之前,DeepSeek的API文档里列了十几家第三方Agent集成工具——Claude Code、Codex、Cursor、Copilot……什么都有,唯独没有自家的Agent产品。模型是它家的,干活的手是别人家的。
这就像一个造了顶级发动机的人,发现所有整车厂都在用他的引擎,但方向盘、底盘、变速箱全是别人的。他决定自己造一辆完整的车。
更深层的原因是:同一个模型被放进不同的Agent系统,表现可能差出一大截。模型只负责预测下一步,真正决定体验的是Harness——它决定模型能看到什么上下文、能调哪些工具、出错怎么重试、什么时候算任务完成。
没有Harness的强模型,本质上只是"很贵的自动补全"。
"一切皆插件"到底意味着什么
Harness的核心设计原则写在官网首页:Everything is a plugin。
大多数Agent框架只在工具层开放扩展——加个搜索工具、接个MCP服务器,到头了。DeepSeek Harness把插件边界一路下沉到了运行时底层:模型适配器、工具、技能、会话、沙箱、存储、Agent循环、调度、甚至UI,全是可替换的插件。
整套架构基于Cordis插件元框架构建。开发者不需要改源码,只在配置文件里调整插件清单,就能换模型、换沙箱、换循环逻辑、换整个界面。
这跟LangChain、LangGraph那类编排库的思路完全不同。LangGraph是在框架里画流程图,节点和边写死了;Harness是给你一块巨大的洞洞板,每个零件都能拔下来换掉。
四种运行模式本质上就是同一套插件的四种组合方式:
标准模式:全副武装,文件编辑、shell、搜索、子Agent、工作流,日常开发直接用。
PTC模式:模型不是一步步调工具,而是先写一段TypeScript代码,用代码编排多轮调用——适合复杂多步任务。
极简模式:只留shell和文件编辑两个工具,专门用来做模型基准测试。V4-Flash的Agent跑分就是用这个模式跑的。
创造模式:实时检查运行时、在内存里试验插件、拼出新的运行模式——这是给框架开发者准备的实验室。
和Claude Code、Codex有什么不同
直接对标的是Anthropic的Claude Code和OpenAI的Codex。三者都意识到执行层是模型能力落地的最后一环。
但路径截然不同:
Claude Code是闭源成品,开箱即用,体验丝滑,但编排核心不开放,模型天然优先Anthropic。你用它,就得按它的规则玩。
Codex是OpenAI的托管Agent方案,同样闭源,深度绑定GPT系列。
DeepSeek Harness选了最难走的路:开源、MIT协议、模型中立。它支持DeepSeek、Anthropic、OpenAI、Bedrock、Vertex、Azure以及任意OpenAI兼容端点。你不一定非得用DeepSeek的模型——你可以把Harness当成一个通用的Agent底座来用。
这意味着什么?意味着DeepSeek赌的不是"我的模型最好",而是"我的壳最好,你用我的壳,大概率还是会选我的模型"。
这个策略很精明。框架是入口,模型是变现。Harness免费开源,但跑Agent需要消耗模型token——而DeepSeek刚刚把API价格涨了。
一个设计细节值得单独说
Harness有一个看似不起眼但极其关键的设计:append-only会话日志。
模型看到的一切——系统提示词、思维链、工具调用结果、子Agent调度、每一次上下文注入——都被写进一条只追加不修改的事件流。恢复、分叉、检索、回放全部基于同一条事件流。
这解决了一个Agent开发中非常痛的问题:长任务跑着跑着挂了,你想从断点恢复,但你不知道模型当时到底看到了什么。如果上下文只活在内存里,一恢复就串味。Harness让任务状态有了"唯一事实来源"。
这个设计思路,跟分布式系统里的event sourcing一脉相承。
结语:AI竞争的战场正在转移
DeepSeek Harness把开源竞争的边界从模型延伸到了Agent工程体系。
之前大家比的是上下文窗口多大、跑分多高、价格多低。现在DeepSeek把竞争推到了一个新的维度:谁的Agent跑得稳、扩得动、生态建得起来。
当然,v0.1只是开发者预览版,官方明确警告"会有破坏兼容性的改动"。仓库超过230个workspace成员,架构野心很大,但离生产级稳定还有距离。现在就说颠覆谁,为时过早。
但三个信号已经很清楚了:
第一,模型厂商的下一个战场不是模型本身,而是执行层和反馈闭环。
第二,"一切皆插件"的微内核架构,可能成为Agent框架摆脱单体瓶颈的主流方向。
第三,谁掌握了Harness,谁就更接近真实任务入口——进而影响模型选择、工具分发和开发者工作流。
DeepSeek造了一个发动机,现在又造了一辆车。至于这辆车能跑多远,取决于有多少人愿意在它上面装自己的零件。
 Josh & Ejaaz:为何我们从 Claude Code 转向 OpenAI Codex撰文:Techub News 整理
在 AI 编程助手竞争白热化的当下,工具的选择往往决定了开发效率与创造力边界。Limitless Podcast 的主持人 Josh 和 Ejaaz 2026 年 5 月进行了一场深度对谈,基于他们从 Anthropic 的 Claude Code 转向 OpenAI 的 Codex(集成于 ChatGPT 5.5)的实际经历,剖析了这两款顶尖产品的现状、核心差异以及未来的趋势。这场讨论不仅提供了直观的功能对比和 Demo 演示,更触及了 AI 工具演进背后的关键概念,对于任何依赖 AI 进行开发或创意工作的从业者而言,都具有极高的参考价值。
市场格局的戏剧性翻转:Codex 的“觉醒”与数据碾压
仅仅几个月前,Claude Code 还是几乎所有软件工程师和企业的首选,安装量遥遥领先。但 Josh 指出,在圣诞节前后,AI 编程的“氛围”发生了根本性转变——从一个“有趣的工具”变成了开发者实际交付代码时使用的利器。而此后,OpenAI 似乎“醒了过来”。
Ejaaz 用一组惊人的数据说明了这种转变:在过去一周,Codex 的安装量超过了 4600 万次,而 Claude Code 则低于 50 万次。这与历史数据形成了鲜明对比,此前 Claude Code 的安装量曾远远超过 Codex。Ejaaz 认为,这种戏剧性翻转的核心原因很简单:OpenAI 推出了更好的模型。他们在过去几周内密集发布的功能,比大多数公司一年内推出的还要多。
为了直观对比,他们制作了一个“比分牌”:OpenAI Codex 以 11 分领先,Anthropic Claude 仅得 2 分。这 11 分的优势来源于多个关键领域的突破。
Codex 的五大核心优势:从“超人”操作到屏幕监控
1. 计算机控制与速度:Claude 率先实现了让 AI 接管桌面、移动光标的能力,但速度较慢,且常遇到障碍,需要用户手动引导。Codex 不仅比普通人操作更快,甚至比 Josh 本人还快。Ejaaz 描述其光标移动速度之快,如同“使用电脑的超人”,并且可以近乎 24/7 不间断运行。
2. 长时程自主性:Codex 能够更智能、更持久地工作。传统上,AI 完成任务依赖一种名为“Ralph Loop”(以《辛普森一家》中坚持不懈的角色命名)的规划模式,即 AI 会持续迭代直至达成目标。Codex 原生集成了这种长时程思考能力,有人甚至观察到它为了完成目标持续“思考”了 36 小时。这对于解决复杂任务至关重要。
3. 浏览器使用与意图理解:Codex 可以接管浏览器,并更智能地理解它所浏览的内容。此前它不具备此能力,而现在它能进行更有目的性的操作。
4. 图像生成集成:OpenAI 2026 年 5 月发布了 ChatGPT Images 2.0 图像生成模型,其质量“绝对令人震惊”,在所有基准测试中击败了包括谷歌 Nano Banana 2.0 Pro 在内的前任领先者。而 Anthropic 目前甚至没有图像生成模型。对于任何涉及视觉工作的用户,直接在软件中使用此功能非常强大。
5. “Chronicle”——秘密的屏幕监控与效率分析:这是 Josh 认为大多数人尚未知晓的 Alpha 功能。Chronicle 会观察你滚动、点击和键入的内容,以此构建关于你的上下文和记忆,无需你主动输入。这带来了一个极其强大的提示:“根据 Chronicle(这个新的记忆功能),我在电脑上做什么事情效率很低?提出一些建议,直接告诉我我需要听到什么。”它会评估你的电脑使用习惯(例如在 Twitter 上滚动的时间),并基于其观察到的实际行为给出真实反馈,以优化你的工作流程。目前该功能仅面向付费会员(每月 100-200 美元订阅),Josh 认为这是未来重要功能的早期迹象。
此外,Codex 2026 年 5 月还推出了“自动审核”功能,能智能区分可能构成系统性威胁的操作和无需批准的操作,自动批准后者,大大简化了用户界面,让用户可以暂时离开电脑而任务照常进行。
Claude 的现存优势:个性、UI 与移动访问
Josh 和 Ejaaz 也指出了 Claude 目前仍保持优势的领域。首先是其“OpenClaw”能力(有趣的是,OpenAI 收购了 OpenClaw)。Claude 的 Dispatch 是其移动应用功能,允许用户远程与 Claude Code 交互,而 Codex 目前尚未提供此功能(团队已承诺会推出)。
其次,在个性化和用户界面方面,Claude 更出色。当使用 LLM 本身而非工具套件时,Claude 的体验更佳,UI 更温暖。此外,两者都发布了“宠物”功能(如屏幕上显示的 Angry Dario),但 Codex 的宠物能作为持久角色存在于整个电脑使用过程中,在后台与你聊天,显示进度,更具趣味性,体现了对用户体验的关注。
实战 Demo 对比:从零构建游戏与草图生成应用
为了验证理论,他们准备了两个具体的演示。
Demo 1:一次性提示构建马里奥风格游戏
Ejaaz 给出了一个提示:要求 AI 创建一个具有未来感、带霓虹灯元素的马里奥风格侧卷轴游戏,包含游戏设计、敌人、陷阱和计分板。他们将此提示输入给 ChatGPT 和 Claude,让各自的编码模型在最高设置下执行。
Claude Opus 4.7 的结果:游戏名为“Neon Plumber Moon Base Run”。视觉效果很好,有音效设计,遵循游戏原则。玩家能识别危险(如尖刺)。但逻辑存在缺陷,例如承诺的双跳功能并未正常实现,导致无法收集某些硬币。
OpenAI Codex (GPT-5.5) 的结果:游戏同样命名为“Neon Plumber Moon Base Run”。起始画面更基础,但有背景动画。游戏逻辑更好,完全可玩,有清晰的爱心(生命值)显示和计分系统,能获得功能增强道具。虽然也存在一些边缘错误,且没有音乐,但整体游戏体验更流畅、功能更完整。
在构建体验上,Ejaaz 更偏好 Codex。Codex 在接到单一提示后,没有请求任何许可,自行思考并决策推进;而 Claude Code 则会不时向用户求助。对于构建像游戏这样的非生产级项目,这种“放手”模式可能更受欢迎。
Demo 2:从手绘草图生成应用
他们提供了一个手绘(实际由 GPT Image Gen 2.0 生成)的“通用 Limitless 仪表盘应用”草图,将其输入模型。
Claude 的结果:生成了一个仪表盘,但风格基础且可预测。页面文本和图形元素很多,它推断出了旅行预算等功能(尽管提示未明确要求)。然而,它创建的是一个旅行规划板,而非围绕 Limitless Podcast 的仪表盘,可能与提示理解有关。
OpenAI Codex 的结果:界面更简洁、干净,没有追求未来感或霓虹风格。提供了一个五日旅行计划的基本信息,有多个标签页,视觉效果更好。虽然同样不是草图指定的内容,但设计更易于理解,不那么密集,且看起来已经连接到数据(顶部有“重新优化”开关)。Josh 认为 Codex 在这方面“完全碾压”,更准确地还原了原始纸张上的设计。
两个演示均显示 Codex 在逻辑实现和功能完整性上更胜一筹。
超越模型本身:“AI 模型套具”与“Vanilla Maxing”哲学
Ejaaz 指出,两大公司的模型之所以能如此快速进步,一个关键因素是“AI 模型套具”。这指的是在基础模型之上添加的层,包括预设的提示词、模型运行的环境以及确保模型以特定方式行为和发声的策略。这也解释了为何 Claude 的个性优于 ChatGPT。
Cursor 2026 年 5 月将其套具 Cursor SDK 通过 API 开放,这具有重要意义。批评者曾认为 Cursor 只是一个 AI 包装器,但事实证明,这个“包装器”或“套具”能让模型变得更智能。如果将 Cursor 的套具应用于 GPT-5.5 和 Claude Opus 4.7,得到的模型比原始基础模型更聪明、更高效。这意味着,尽管 AI 实验室投入巨资训练模型,但初创公司通过构建更好的“套具”也能创造卓越产品。套具与模型本身已密不可分,是 valuable moat。
Josh 进一步阐述了“套具”在构建“超级应用”中的作用。每个公司都试图打造一个全能的操作系统级应用,让 AI 成为其基础。OpenClaw 在此方面早期表现卓越。2026 年 5 月,Sam Altman(萨姆·奥尔特曼)宣布用户现在可以将其 ChatGPT 账户连接到 OpenClaw 生成令牌,这可能是将 OpenClaw 深度集成到 Codex 的多步计划开端。OpenAI 拥有 OpenClaw,虽然承诺保持开源,但有能力直接集成到自家产品中。Codex 的开发者也确认,原生编辑器、iOS 应用、完整浏览器和 OpenClaw 等功能都将到来。
然而,Ejaaz 指出 OpenClaw 的热度已消退,因为尽管这些工具处于前沿水平,但难以扩展到实际应用。用户不敢将其集成到存有个人文件的桌面,曾出现过访问信用卡数据或删除旧婚礼照片等恐怖故事。相比之下,在品牌信誉下提供的工具(如 ChatGPT Codex、Claude Cowork 或 NVIDIA 的企业级安全版本 NemoClaw)更能让人安心使用。
这引出了 Josh 推崇的“Vanilla Maxing”哲学:你应该 100% 使用原厂工具。很多人陷入使用各种不同仓库、技能和插件的情况,但现实是,AI 实验室的迭代速度足够快,他们会直接将功能集成到原生应用中。因此,最好的策略就是“Vanilla Maxing”——使用官方提供的工具,无需急于尝试前沿但可能不安全的外部工具。
未来展望与个人使用栈
Ejaaz 总结道,目前并没有明确的赢家,但他倾向于 Codex GPT-5.5。不过叙事转换如此之快,Claude 仍可能追赶上来。一个未被讨论和演示的模型是Claude Mythos,它在几周前伪发布,在所有基准测试中都技术上优于 5.5,但 Anthropic 因其“过于危险”和“网络安全风险”而未开放访问(美国战争部的 Peter Heskett 也提及此担忧)。OpenAI 则创建了 Mythos 级别的模型并使其对所有人可用。这或许也源于 Anthropic 计算资源的不足。
关于个人使用栈,Josh 表示他已完全转向 Codex,用于所有困难任务。但他认为,作为 LLM 或聊天机器人,GPT-5.5 略逊于 Opus 4.7,后者个性更温暖、更精准,更能理解他的意图。因此,在构建复杂项目时,他用 Opus 4.7 作为“协调者”,Codex 作为“执行者”。他还发现 Opus 4.7 在某些方面不如 4.6,例如在写作或文本消化任务上,他仍使用 Opus 4.6。
Ejaaz 的栈则更多样化。对于研究,他开始转向 GPT-5.5,因为它能进行更长时间、更深入的讨论。他举例测试了关于 AI 电力堆栈和投资标的的提示,5.5 完全超越了 4.7。但他仍因个性原因使用 4.7。总体而言,他认为 OpenAI 正处于“一代人的奔跑”中,可能很快会修复现有问题。
Josh 最后鼓励用户亲自尝试两款工具,用实际提示进行测试。无论你从事何种工作,只要使用电脑,AI 都可能帮助你更高效地完成任务,或助力你实现一直想做的爱好和副业。这场竞争的最大赢家是用户,因为每月仅需 20 美元,就能获得所有这些前沿智能和能力。
 Charlie Holtz(查理·霍尔茨)与 Jackson Sippe(杰克逊·西普):AI 编程代理的“指挥家”如何改变工程师工作流撰文:Techub News 整理
在最新一期的 YC Root Access 节目中,主持人 Aaron 对话了初创公司 Conductor 的两位联合创始人 Charlie Holtz(查理·霍尔茨)和 Jackson Sippe(杰克逊·西普)。这家公司2026 年 5 月完成了由 Spark 和 Matrix 共同领投的 2200 万美元 A 轮融资。他们开发了一款革命性的 Mac 应用,旨在让工程师能够同时指挥多个 AI 编程代理协同工作,从而极大提升开发效率。本次对话深入探讨了他们的创业故事、产品理念以及对未来软件工程形态的深刻洞察。
从“为自己打造工具”到改变工程师工作方式
Conductor 的核心产品是一个 Mac 应用程序,它允许开发者同时运行多个编码代理,例如 Claude Code 或 Codex。与传统在 IDE 中手动编辑代码或在终端中与单个 AI 交互不同,Conductor 将所有编码代理整合到一个界面中。用户只需点击一下,就可以创建一个代码库的隔离副本,指派 AI 代理去完成任务,然后审查并合并其工作成果。
Charlie Holtz(查理·霍尔茨)和 Jackson Sippe(杰克逊·西普)在大学相识,尽管年级相差甚远,但共同的兴趣和项目合作让他们走到一起。毕业后,Charlie Holtz(查理·霍尔茨)在 Replicate 负责增长和工程,而 Jackson Sippe(杰克逊·西普)则在 Netflix 的机器学习基础设施团队工作。两人一直保持着合作项目的习惯,并最终决定共同创业。
他们的创业之路并非一帆风顺。最初申请 Y Combinator 时,他们的想法是“用 AI 帮你预订餐厅和网球场”,但这很快被证明是一个“为解决方案寻找问题”的案例。进入 YC 孵化器后,前一个半月他们都在不断尝试和抛弃各种想法,从 B2C 到 B2B,构建了众多原型,但用户反馈往往不佳。主持人 Aaron 回忆道,当时每隔几天见面,他们就会有一个全新的方向。
转机出现在一次办公室会议上。Aaron 建议他们考虑开发工具领域,并给出了一个关键建议:“在墙上贴一张你俩的海报,上面写着‘打造这两个家伙想要的东西’。” 他们真的照做了。这个建议将范围缩小到开发工具,并让他们回归到解决自身痛点的初心。当时,他们感觉现有的 AI 编程工具还不够强大,而随着 Sonnet 3.5 等模型的发布,存在巨大的可能性未被发掘。
他们曾尝试构建一个“IDE 之后”的用户界面,让人工智能完全接管工作流,但当时的模型能力和工具调用成熟度不足以支撑这个愿景。暂时搁置这个宏大想法后,他们决定先做一个更好的聊天应用 Chorus,允许用户同时与多个模型对话。正是在构建 Chorus 及其开发工具的过程中,他们偶然发现了 Conductor 的雏形。
当 Charlie Holtz(查理·霍尔茨)第一次快速构建出 Conductor 的原型,并展示给 Jackson Sippe(杰克逊·西普)时,后者的反应是:“首先,这完全不是我想要的样子,很多东西得改。其次,这太令人印象深刻了,效果居然这么好,我们必须做这个。” 从写下第一行代码到发布产品,大约只用了三周时间。第一周是 Charlie Holtz(查理·霍尔茨)独自完成原型,效果出奇地好;随后他们花了约两周半进行打磨。
真正让他们确信“就是它了”的时刻,是当 Charlie Holtz(查理·霍尔茨)第一次给一个代理分配任务,然后按下快捷键给另一个代理分配任务,接着看到第一个代理出现“未读”提示点,点进去发现它已经完成工作时。那种能够同时运行多个代理并保持高效的神奇体验,以及 Jackson Sippe(杰克逊·西普)——这位通常对新奇事物持怀疑态度的伙伴——也认为它确实有用的反馈,成为了关键信号。更令人兴奋的是,他们能够“用 Conductor 来构建 Conductor”,这本身就是一个充满魔力的正反馈循环。
Conductor Cloud:突破本地瓶颈,迈向持续协作
在访谈中,Charlie Holtz(查理·霍尔茨)和 Jackson Sippe(杰克逊·西普)宣布了 Conductor Cloud 的发布。在此之前,Conductor 完全在用户的 Mac 本地运行。这意味着一旦关闭笔记本电脑,正在工作的 Claude Code 或其他代理就会停止。Conductor Cloud 的推出改变了这一局面,现在用户可以创建由云环境支持的工作空间,即使关闭电脑,代理也能持续工作。
这解决了用户遇到的一个主要瓶颈:本地算力和管理能力的限制。许多 Conductor 的重度用户已经达到了他们能在本地同时运行的不同工作树或实例数量的上限。Charlie Holtz(查理·霍尔茨)坦言,以他个人的认知负荷,最多只能同时有效管理三到五个代理。他认为这部分是一个界面设计问题,也是团队接下来迫切希望解决的挑战。他们已经证明了同时运行多个编码代理是可行的,但要突破三到五个的限制,达到更高层级,就需要在抽象层面进行创新,重构交互界面。
回顾 Conductor 的诞生,最初他们尝试手动管理多个代理,但摩擦太大,很难超过一两个。即使更早之前尝试构建类似工具,也因时机不成熟而失败——当时还无法完全脱离 IDE。AI 代理需要达到一个“甜点”状态:既不需要人类关注其每一个动作,又需要人类保持足够的关注以实现有效的编排和多任务并行。在早期实验中,他们甚至为每个代理克隆了五个代码仓库副本,后来才发现并使用 Git 的工作树功能,并一步步构建出 Conductor 所需的基础组件。
业务的增长证明了产品的市场契合度。自今年一月以来,Conductor 的用户量增长了约十倍。用户群体非常广泛,从独立黑客到大型上市公司的工程师,每天都在使用它。团队虽然精干,但正在快速成长,并计划扩大规模。
病毒式传播与洞察顶尖工程师
除了卓越的产品构建能力,Conductor 团队,尤其是 Charlie Holtz(查理·霍尔茨),还以其制造病毒式传播内容的能力而闻名。他的一个著名案例是在 GPT-4 Vision 发布当天,编写了一个简单的 Python 脚本,通过网络摄像头实时观察他的动作,并用 David Attenborough(大卫·爱登堡)的声音克隆进行旁白解说,仿佛他身处《地球脉动》纪录片中。这条推文意外爆火,甚至被爱登堡本人看到,尽管后者并不太欣赏这个作品。
Charlie Holtz(查理·霍尔茨)将这种能力部分归功于他在 Replicate 的工作经历,当时他的主要任务就是通过构建演示应用和制作展示技术可能性的视频来促进增长。他分享的心得包括:保持真实和直接,避免公司腔调,不装腔作势,像和朋友聊天一样表达;内容形式可以简单直接,比如他的爱登堡视频就是原始的屏幕录制,几乎没有剪辑;最重要的是进行大量尝试,发布许多内容,观察什么能引起共鸣,从而掌握“爆款内容”的形态。Jackson Sippe(杰克逊·西普)则补充了一个精辟的总结:“制作你自己也想点击的内容”,这与 YC “打造你自己想要的产品”的建议一脉相承。
为了深入了解用户,Conductor 团队经常在城市中进行“自行车巡游”,与用户面对面交流,并观察他们如何使用产品。这让他们得以近距离观察世界上最优秀的工程师如何在技术前沿进行构建。他们发现了几个有趣的现象:
重视技能文件: 顶尖工程师会投入大量精力构建和维护“技能文件”。他们会将学到的 React 最佳实践、代码库特定知识等整理成 Markdown 文件,供 AI 代理持续学习,从而提升代理输出的质量。
配置趋于简洁: 令人有些意外的是,许多优秀工程师的开发环境设置其实非常简单和“纯净”。Charlie Holtz(查理·霍尔茨)将其类比为那些拥有复杂 Vim 配置但未必高效产出的人,暗示过度优化工具本身可能并非关键。
划分“自由区”与“严谨区”: 他们观察到并正在实践一种模式:在代码库的某些部分,可以放手让 AI 自由发挥;而在其他更核心或需要精心设计的部分,则由人类担任架构师,AI 作为执行者。这创造了“无杂乱区域”,平衡了效率与控制。
未来展望:从管理代理到领导 AI “军团”
当被问及编程和工程学的未来时,Charlie Holtz(查理·霍尔茨)和 Jackson Sippe(杰克逊·西普)表达了他们的看法。尽管预测几年后的事情很困难,但他们确信模型会变得比现在聪明十倍、百倍,能够在无需人类频繁干预的情况下运行更长时间,感觉上会越来越像一个人类同事,尽管其“思维”方式依然与人类迥异。
Conductor Cloud 的推出正是为了迎接这个未来,让代理能够长时间运行。他们展望,未来的界面需要让工程师感觉像是管理着一个庞大企业的 CEO,手下有成千上万的 AI “员工”在为你工作。大部分时间,你就像 CEO 一样坐在办公桌前,接收来自“工程主管”、“市场主管”等 AI 的高层汇报。偶尔,你需要深入细节进行检查,这类似于现在的代码审查(PR Review),只不过你是向下钻取,询问某个具体的“AI 员工”完成了什么工作。
这又回到了之前关于顶尖工程师观察的问题:最好的 AI 使用者,往往也是最好的人类协作者。 他们能够理解各个层级发生的事情,查看代理在每个层面上的操作,优化其遇到的瓶颈,并且进行前瞻性思考,而不是被动回应代理的输出。他们需要思考:要完成这个任务,我需要回答哪些设计问题?我需要关心哪些部分?应该给代理施加哪些约束条件?
对于 Conductor 的未来,他们的愿景是让它不再局限于个人笔记本电脑,而是能够运行在任何地方,成为管理组织内所有 AI 的“指挥中心”。用户可以从手机、笔记本电脑或现有的云基础设施接入这个系统。Charlie Holtz(查理·霍尔茨)特别对“提升抽象层级”感到兴奋。他认为目前的 Conductor 在某种程度上还带有其诞生时期(2023年7月)的模型能力印记,他渴望探索更高层次的抽象,让人们以不同于现在的方式控制模型,这里面有大量的界面和产品实验空间。
这将为用户解锁什么?首先,是突破人类工作记忆的瓶颈(目前是三到五个代理)。其次,是突破代码审查的瓶颈。目前工程师仍需非常仔细地审查 AI 添加的每一行代码,这消耗了大量精力。团队认为,目前仍停留在 2010 年代的 GitHub PR 审查模式,未来在审查环节有巨大的创新潜力。
最后,谈到团队建设,他们目前招聘的标准有些“非传统”:现有团队成员要么玩过极限飞盘,要么是法国人。当然,更重要的是寻找那些行动敏捷、有创业公司经验或自己创过业、渴望快速行动并置身于技术前沿的人。最关键的是,要有动力为自己、为最优秀的工程师打造工具。能够“使用自己打造的工具来打造这个工具”,在不同层级上同时工作——既在开发具体功能,又在思考和改进背后的工作流程并将其产品化——这种体验正是 Conductor 团队乐趣和动力的核心来源。正如 Charlie Holtz(查理·霍尔茨)所说:“没有其他我更愿意从事的工作,也没有其他我更愿意一起共事的人。” 在这个软件工程范式剧烈变革的时代,为改变构建方式本身而工作,无疑是最激动人心的事情之一。
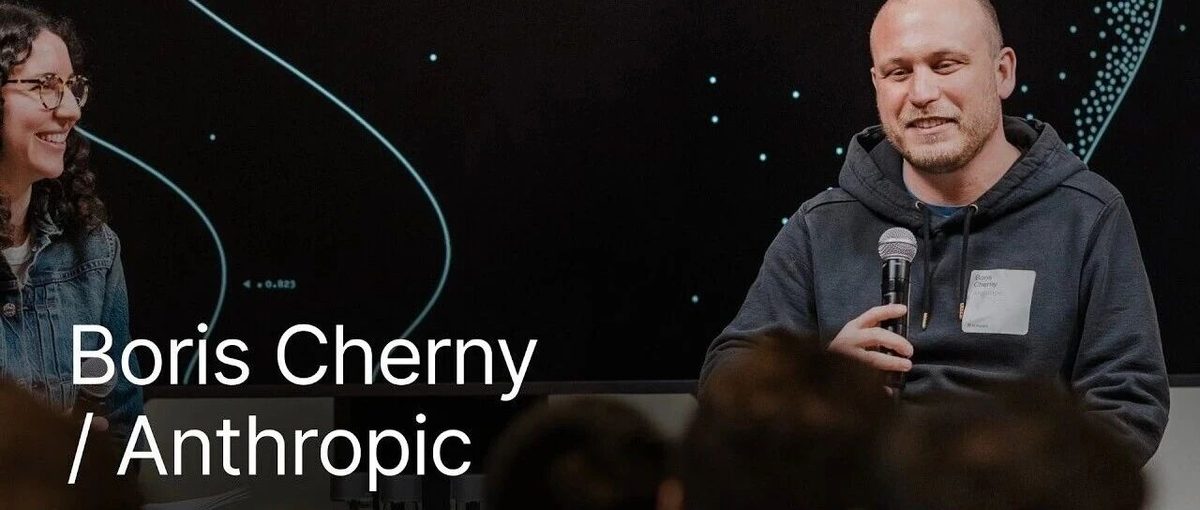 Claude Code 之父最新预测:编程被解决后,下一个是什么?撰文:深思圈
你有没有想过,"写代码"这件事,有一天会变得和"发短信"一样普通?不是比喻,是字面意思。最近我看了一个访谈,是 Anthropic 的 Boris Cherny 在 Sequoia Capital(红杉资本)的 AI Ascent 2026 大会上的分享。Boris 是 Claude Code 的创造者,也是整个 AI 编程领域最前沿的人之一。他在访谈里说了很多让我停下来反复思考的东西。
他说,编程已经被解决了。他说,他在 2026 年一行代码都没有手写过。他说,他现在每天从手机上发出几十个 PR(Pull Request,代码合并请求)。他还说,有一天他创了纪录,一天发了 150 个 PR。
我第一次听到这些话时,感觉有点像在看科幻小说。但越想越觉得,这不是未来,这是已经在发生的现实。只是大多数人还没意识到而已。
Claude Code 是怎么来的
Boris 说,Claude Code 其实是"意外"诞生的。2024 年底,他加入了 Anthropic 内部一个叫 Anthropic Labs 的孵化团队,整个团队就几个人,目标是把当时模型的潜力转化成真实可用的产品。他们做出来的东西,包括 Claude Code、MCP(Model Context Protocol,模型上下文协议),还有 Claude 的桌面端应用。任务完成之后,团队解散。现在他们又重新聚在一起,做第二轮。
他说,当时他们看到了一个"product overhang"(产品空缺)——模型的能力已经远超市面上任何产品所能发挥出来的水平。2024 年底,编程领域最先进的产品,是 type-ahead(逐行补全),就是你打开 IDE,按 Tab,每次补全一行代码。这是 Claude Sonnet
3.5 当时能做到的事情。
但 Boris 他们看到的是:模型已经可以做到更多。不需要逐行补全了,可以直接让 AI agent 写完所有代码。于是他就去做了。
但他也坦诚,Claude Code 一开始根本不好用。前六个月,他自己只用它写大概 10% 的代码。发布之后,也没有爆发式增长。真正的拐点是 Opus 4 发布的那一刻,之后每一个模型版本都带来一次跃升:
4.5、
4.6、
4.7,一路往上。
我觉得这段历史特别值得深思。Boris 他们在产品还没有 PMF(Product-Market Fit,产品市场契合)的时候就开始做,而且明知道六个月内不会有 PMF,因为他们是在为下一代模型做准备。这是一种非常特殊的产品思维:你看到的不是现在的市场,而是模型进化之后会出现的市场。这需要极强的判断力,也需要极强的耐心。大多数创业公司在这个阶段就放弃了。
"编程已经被解决了",这句话什么意思
这是整个访谈里最震撼我的一个论断。Boris 说,对他个人来说,编程已经被解决了。他的代码 100% 由模型来写,他不再手写任何一行代码。
他解释了为什么 Claude Code 用 TypeScript 和 React 来写自己的代码库。原因很简单:这两个是训练数据里分布最广的语言和框架,当时模型还没那么聪明,用"on distribution"(在分布范围内)的技术栈能让模型表现更稳定。到今天,模型已经可以学会它没见过的语言和框架,但那时候技术选型这件事,是影响 AI 输出质量的关键变量。
他也补充说,"编程被解决"这件事不是对所有人都成立的。非常复杂的大型代码库、冷门语言、特殊的历史系统,这些地方模型还没办法完全胜任。但他的判断是:通常等下一个模型就好了。
我自己理解这句话,是这样的:Boris 说的"编程被解决",针对的是"写代码"这个动作本身。就好像"打字被解决了"——不是说文字创作没有价值了,而是说打字这个物理动作,不再是瓶颈了。写代码的技术门槛,正在以肉眼可见的速度崩塌。剩下的核心问题,变成了你想要构建什么、你理解不理解这个领域、你有没有判断力去知道 AI 做的对不对。
Boris 的工作方式,让我重新定义了"工作"
他分享了自己现在的工作方式。大部分时间,他在手机上工作。打开 Claude app,左侧有一个 code tab,里面通常有五到十个 session(会话)在同时跑,每个 session 里有多个 agent(智能体),加起来大概有几百个。每天晚上还有几千个 agent 在做更深入的工作。
他最近特别喜欢用的功能叫 `/loop`。原理很简单:让 Claude 用 cron(定时任务工具)创建一个定时循环任务,可以每分钟、每五分钟、每天运行一次。他现在有几十个这样的 loop 在持续运行。比如有一个在监控他的 PR,自动修复 CI(Continuous Integration,持续集成)、自动 rebase;有一个在保持 CI 健康,发现 flaky test(不稳定测试)就自动修复;还有一个每三十分钟从 Twitter 抓用户反馈,自动聚类整理。
他说,现在 Anthropic 内部,没有任何人工编写的代码了。所有 SQL 都是模型写的,所有东西都是模型构建的。更有意思的是,他的 Claude 和同事的 Claude,会通过 Slack 互相通信,在 loop 运行过程中协商解决未知问题。
我第一次听到这里,愣了一下。这不是"人用 AI 工具提效",这是"人在管理一支 AI 团队"。工作的性质变了,不是提速,是质变。你的角色从执行者变成了指挥者,从写代码的人变成了定义问题、审核结果、协调 agent 的人。这种转变,比"提效十倍"这个描述要深刻得多。
未来的团队长什么样
Boris 对未来团队的判断,我觉得是这次访谈里最务实、也最有参考价值的部分。
他说,未来会有越来越多的 generalist(通才)。但他强调,这个"通才"的定义在扩展。以前说通才工程师,可能是说他既会写 iOS 也会写后端;而未来的通才,是真正跨学科的——工程很强,同时设计也很强,或者产品和数据科学也很强。
他举了 Claude Code 团队的例子:工程经理、产品经理、设计师、数据科学家、财务、用户研究员,每一个人都在写代码。每个人是某个领域的专家,但现在同时也都会编程。
这个判断让我深有共鸣。我一直在说,AI 时代最稀缺的不是"会用 AI 的程序员",而是"懂业务的全栈执行者"。以前,技术是壁垒,让很多有想法的人被挡在门外。以后,技术壁垒会越来越低,真正的壁垒是:你有没有想清楚要做什么,你有没有足够深的行业认知,你有没有判断力去评估 AI 做出来的东西是否正确。
换句话说,AI 并不是让技术门槛消失,而是让门槛的位置移动了。从"会不会写代码",移动到了"懂不懂这个领域"。
SaaS 会死吗?不会,但很多护城河要消失了
有人问 Boris,当写代码的成本降低 10 倍甚至 100 倍,SaaS(Software as a Service,软件即服务)会不会迎来大崩塌?
Boris 说,他最喜欢这个问题。他的回答引用了 Hamilton Helmer 的"七种商业护城河"理论(Seven Powers)。他认为,AI 的到来会让某些护城河变弱,让另一些护城河反而变得更重要。
会变弱的护城河,比如 switching cost(转换成本)——以前你用了一个工具三年,迁移数据、重新培训员工的成本太高;但现在模型可以帮你快速迁移,切换成本大幅下降。还有 process power(流程壁垒)——很多 SaaS 公司的护城河其实是复杂的业务流程设计,但 Boris 说,Opus
4.7 已经可以"hill climb anything",给它一个目标,让它一直迭代,它就会一直优化,直到做到。这让纯靠流程设计建立壁垒的公司,变得非常脆弱。
而不会被削弱的护城河:network effects(网络效应)、scale economies(规模经济)、cornered resources(独特资源)。这些跟 AI 的关系不大,还是会继续有效。
他说的第二个判断,我觉得更重要:未来十年,会有 10 倍于现在数量的初创公司出现,去颠覆各个领域。原因很简单:一个小团队,现在可以用 AI 构建出跟大公司相当水平的产品,而大公司反而要面对内部阻力,需要改变流程、重新培训员工、克服组织惰性。初创公司没有这些包袱,可以从第一天起就 AI-native(AI 原生)地去构建。
我对这个判断非常认同。我们正处在一个"小公司窗口期"里。大公司的效率优势在缩水,初创公司的劣势也在缩水,两者之间的差距正在快速压缩。这个窗口不会永远开着,因为大公司迟早也会完成转型。但现在,是进攻的最好时机。
编程,会像识字一样普及
这是 Boris 说的最有历史感的一段话,我听完之后想了很久。
有人问他:编程会不会变成像 Microsoft Office 一样人人都会的技能?他说,不止如此,会更进一步——会像发短信一样普及。
然后他打了一个历史比方,我觉得非常贴切。1400 年代,欧洲印刷机发明之前,只有 10% 的欧洲人识字。这些人受雇于国王和贵族,专门负责读写,因为这是一门专业技能,普通人不会。印刷机发明之后,出版成本下降了一百倍,书开始大规模普及。接下来几百年,全球识字率从 10% 上升到 70%。现在,我们所有人都能读写,没有人需要专门的"阅读写作学位"才能识字,尽管仍然有职业作家这个行当。
Boris 说,软件正在经历同样的事情。写代码这件事,正在从一门需要专业训练才能掌握的技能,变成人人都能做的基础能力。而这一次,速度会比印刷机时代快得多。
他还说了一个让我觉得非常对的点:在这个新世界里,最适合写会计软件的人,不是工程师,而是一个非常厉害的会计。因为难的是懂会计,不是会写代码。
我深度认同这个判断。我在出海领域工作了很多年,经常遇到一种场景:某个行业里做得很好的从业者,心里有非常清晰的工具需求,但因为不懂技术,这个想法永远停留在脑子里。AI 的到来,其实是在解放这些人。真正的生产力,来自于深度的行业认知,而不是技术能力本身。
Anthropic 内部和外部,差距在哪里
有人问了一个很好的问题:Anthropic 内部工程师的工作方式,领先外部多少?是三个月?还是六个月?
Boris 的回答很诚实。他说,在模型层面,没什么差距,因为 Anthropic 本身就是在做平台,他们用的模型版本和外部用户差不多。真正的差距,在于组织流程和工作方式。
Anthropic 内部,Claude 被用在所有事情上。工程师的 Claude 在 loop 里运行代码,同时会通过 Slack 和其他工程师的 Claude 沟通,协商解决代码里的未知问题。整个公司没有手工写的代码,所有 SQL 都是模型写的。他说,这种组织级别的流程改造,才是真正领先的地方,而不是技术本身。
这一点让我想到一个更宏观的问题:AI 能力的释放,往往不是被技术限制的,而是被组织结构和工作流程限制的。工具在那里,但大多数公司还在用旧的工作方式去套新的工具。这就像印刷机发明了,但大家还在按照手抄书的方式来组织出版业一样。
对于初创公司来说,这其实是一个巨大的优势。没有历史包袱,可以从第一天就按照 AI 原生的方式来构建组织和流程。而大公司要完成同样的转型,需要说服每一个中间层、重新设计每一个流程,面对的阻力是指数级的。
MCP 是连接 AI 和工具世界的基础设施
Boris 在访谈中多次提到 MCP,我觉得有必要单独解释一下为什么这个东西很重要。
MCP(Model Context Protocol)是 Anthropic 提出的一个标准协议,让 AI 模型可以以统一的方式连接各种外部工具和数据源。就像 USB 让各种设备可以连接电脑一样,MCP 让 AI 可以统一接入 Salesforce、Google Docs、GitHub、Slack 等任何工具。
Boris 说,对于 knowledge work(知识工作)的 agent 化,MCP 就是答案。不管是 Claude Code、Claude CLI 还是 Co-work,连上各种 MCP connector 之后,AI 就能访问这些工具里的数据和能力。对于还没有 MCP 的工具,computer use(计算机视觉操控)可以作为兜底方案——虽然慢,但能用。
我的理解是:MCP 正在做的事情,是在 AI 和真实工作环境之间搭一座桥。以前的 AI 工具,往往是孤立的,需要手动复制粘贴信息进来,再把结果复制粘贴出去。MCP 让这个流程变成了自动的、流畅的。这不是一个小改进,这是 AI 从"辅助工具"进化成"工作主体"的关键一步。
而且他有一句话我觉得说到了本质:对模型来说,不管是 MCP、API 还是其他接口,都只是 tokens(词元)。模型不在乎连接方式,它只需要能访问到信息和执行能力。这意味着,只要信息能被结构化地传递给模型,模型就能用上它。这个视角,对于我们思考如何构建 AI 产品非常有用。
我的深度思考:这一切对我们意味着什么
听完这个访谈,我想到最多的一个问题是:在这个新世界里,什么才是真正有价值的?
Boris 说编程被解决了。我认同。但我想补充一点:编程被解决了,不代表软件产品变得不重要了,恰恰相反,软件会变得更多、更便宜、更专业化。因为以前很多有价值的软件,因为开发成本太高而从来没有被做出来。现在,这个成本在快速下降。会有大量"垂直场景的专用工具"被做出来,它们的受众可能只有几千人,但对这几千人来说无比重要。
我在出海领域工作,经常遇到一个痛点:跨境电商、SaaS 出海、内容出海,每个环节都有大量重复性的工作流,但专门针对这些场景的好工具,一直都很少。原因很简单,市场太小,开发成本太高,ROI 跑不通。但现在,当开发成本下降 100 倍,这个逻辑就变了。很多之前没有商业价值的工具,现在可以做了。
这让我想到另一个更深层的问题:未来的产品竞争,核心在哪里?
Boris 提到了网络效应、规模经济、独特资源这些不会被 AI 削弱的护城河。我觉得还有一个他没有明说,但整个访谈都在暗示的东西:领域知识的深度。
当代码可以自动生成,当流程可以自动优化,最难被替代的,是对某个具体领域的深刻理解。你知道用户真正的痛点在哪里,你知道这个行业的潜规则,你知道哪些功能表面上重要但其实没人用,你知道最后那 20% 的细节决定产品好不好用。这些,是模型短期内学不会的。
所以我得出了一个结论:AI 时代的产品竞争,表面上是谁用 AI 用得更好,底层是谁对自己的用户理解得更深。工具变了,这个底层逻辑没变。
另外一个我很认同 Boris 说的点,是关于初创公司的机会。他说,未来十年,初创公司的数量会增长 10 倍。大公司面临的转型阻力,是初创公司的天然优势。我在国内见过很多创业者,因为技术门槛而放弃了好想法。以后,这个理由会越来越站不住脚。想法本身的质量,会越来越决定一个公司能不能做起来。
最后,我想引用 Boris 说的那个印刷机的比方,再延伸一步。印刷机普及了文字,带来了文艺复兴、启蒙运动、工业革命。不是因为印刷机直接推动了这些,而是因为知识开始大范围流动,更多的人可以站在前人的肩膀上思考和创造。AI 普及编程,可能也会带来类似的效应:当更多有深刻行业认知的人可以直接构建工具和产品,整个社会的创新速度会加快。真正的突破,往往来自那些既深刻理解问题、又有能力去实现解决方案的人。AI,正在让这样的人从少数变成多数。
 Claude Code 桌面端大重构:从「结对编程」到「指挥中心」撰文:分秒 Claw
三月底,一个安全研究员在 npm 的 sourcemap 文件里发现了 Claude Code 的完整源码,50 万行 TypeScript,一览无余。更有意思的是,代码里藏着一个叫 KAIROS 的神秘功能:一个能在后台持续运行的 Agent,自己修 Bug、跑任务、给你发通知,不需要人类盯着。
两周后的 4 月 14 日,Anthropic 正式发布了 Claude Code 桌面端的全面重构。KAIROS 也以 Routines 的名字正式亮相。
从源码泄露到产品发布,只隔了 14 天。要么 Anthropic 反应极快,要么这本来就在计划之中。
不管怎样,这次更新的信号很明确:Claude Code 不再只是一个帮你写代码的工具,它要成为你的 AI 运维平台。
先搞清楚:Claude Code 在产品线里是什么位置
打开最新版的 Claude Desktop 应用,侧边栏有三个图标:
Chat:传统对话助手,你问它答
Cowork:面向非技术用户的任务执行器,在隔离虚拟机里操作文件
Code:面向开发者的 Agentic 编码工具,读写代码、跑测试、提交变更
三者共用一个桌面客户端,但底层架构完全不同。这次重构只针对 Code 模式,但影响的是整个开发者工作流。
Anthropic 研究员 Alex Albert 说,有了 Cowork 和 Code 配合,他干大部分活儿基本不用开别的 App 了,"甚至连终端都省了"。这句话放在重构之前可能有点夸张,但放在重构之后,你会觉得他说的是实话。
最大变化:从"一次一件事"到"同时干五件事"
旧版的核心痛点,社区吐槽了几个月。知名 iOS 开发者 Paul Hudson 直接说旧版"堪称灾难"。设计师 Brian Lovin 在 M3 Max 96GB 顶配上用,切个标签页都掉帧。
新版从底层重新设计,核心变化三个层面:
第一层:多会话并行
新增侧边栏管理系统,同一窗口同时开五个会话。每个会话通过 Git Worktrees 获得独立项目副本,存放在 .claude/worktrees/,互不干扰。Boris Cherny 介绍此功能的推文拿下 10,972 赞。
第二层:拖拽式工作区
终端、预览、Diff、编辑器、聊天面板全部支持拖拽重排。三种视图模式:Verbose(调试用)/ Normal / Summary(监控用)。
第三层:集成终端和编辑器
首次内置真终端(直接跑脚本和构建)+ 应用内文件编辑器 + 重建性能的 Diff 查看器 + Side Chat(Cmd+; 旁聊,不打断主任务)。
"新应用为 Agentic 编程的真实体验而构建:多线并行,你坐在指挥席上。"
Routines:关上电脑,AI 继续干活
如果说桌面重构是改了"怎么用",那 Routines 就是改了"什么时候用"。
核心理念:一次配置(提示词 + 代码库 + 连接器),设定触发条件后,Claude Code 在 Anthropic 云端自动执行任务。你不需要开着电脑,甚至可以在睡觉的时候让它工作。
Routines 三种触发方式
触发类型
典型场景
定时触发
每晚 2 点自动修最高优先级 Bug 并开 PR
API 触发
接入 Datadog/Sentry 告警,自动定位根因并提交修复
GitHub 事件
新 PR 自动安全审查,跨库移植改动
GitHub 事件触发有个精妙设计:一 PR 一 Session。每个 PR 分配专属会话,后续的代码提交、评论、CI 日志都持续反馈到同一个会话里。全链路上下文都有。
"这不是增量打磨,而是从'AI 结对编程'到'AI 运维平台'的跃迁。" Build Fast with AI
目前 Routines 还在研究预览阶段:Pro 每天 5 次,Max 15 次,Team/Enterprise 25 次。
技术选型:为什么还是 Electron?
Boris Cherny 在 Hacker News 给了三个理由:
1. 团队熟悉度,部分工程师有 Electron 经验
2. 代码复用,Web 和 Desktop 共享同一套代码
3. AI 擅长写 Web 代码,Claude 能更好地帮助开发和维护自己的桌面应用
第三点很有意思:Anthropic 在"用 AI 开发 AI 工具"这件事上已经形成了闭环。Boris 也留了一句:"工程就是关于取舍,未来可能会改变。"
跟 Codex 和 Copilot 比,差别在哪?
三家抢同一个位置:开发者日常工作的默认入口
能力
Claude Code
Codex
Copilot
多会话并行
✓
✗
✗
云端自动化
✓
✗
✗
Diff 分栏对比
✗
✓
✓
多端全通
部分
✓
插件
竞争格局很清晰:Claude Code 在 Agent 能力和云端自动化上领先,Codex 在多端覆盖和性价比上有优势,Copilot 靠 GitHub 原生集成守住基本盘。
KAIROS 的故事:从泄露到发布的 14 天
3 月 31 日,安全研究员 Chaofan Shou 发现 Claude Code 发布到 npm 的包里包含了 sourcemap 文件,50 万行 TypeScript 代码就这么暴露在公网上。
社区在代码中发现了 KAIROS:"一个可以作为持久化的后台 Agent 运行的功能,能够周期性地自行修复错误、跑任务,不需要等人类输入。"
两周后发布的 Routines,功能描述几乎一一对应。泄露之后,Anthropic 索性把 Agent 层的代码正式开源了。与其遮遮掩掩,不如大方公开,反而赢得了开发者社区的好感。
AI 编程工具的下一步,不是更聪明,是更自主
表面上看,是 UI 改了、多了几个面板、性能快了。但本质上,是交互范式的转变:从"一对一对话"到"一对多指挥",从"你在的时候它才工作"到"你不在的时候它也在工作"。
AI 编程工具的竞争已经不是"谁的模型更聪明"了。真正的竞争在于:谁能让 AI 更自主地嵌入开发者的日常工作流,让人类从执行者变成监督者。
这条路最终走到哪里,现在说还太早。 但方向已经很清楚了。
就在刚刚,飞书和豆包工作一起,开了他们的全新发布会。 在聊了很多飞书为Agent做的全新升级,还有和豆包工作深度融合后的产品能力之后,他们也终于发布了一个全新的功能,也是我们内测了一段时间,让我非常喜欢的功能。 豆包工作伙伴。 讲道理,这玩意飞书在国内第一个做出来,我一点也不意外。 跟之前的豆包工作伙伴完全不一样,这一次,你可以把你的豆包工作伙伴,拉它进入企业里的任何群聊里面,成为一个团队共享的AI工作伙伴。 它拥有独立的人设,独立的名称,独立的组织身份,比如我就给它改名了,名字也很性感,叫义父。 它可以被拉进群,参加公司的会议、读所有的文档、代码等等等等,还能主动的去推进大家的工作,它长这样。 如果大家有印象的话,会觉得,这个豆包工作伙伴,怎么跟那个Claude Tag那么像。 对,确实很像。 而且我觉得,如果要理解豆包工作伙伴到底是什么,最好的办法,可能真的就是先理解Claude Tag。 今年6月份,Anthropic发布了Claude Tag。 这玩意,被卡帕西称为AI在用户体验上的第三次范式。 我觉得可以用一句特别简单的话来解释。 普通Agent,是一个属于你自己的能干活的Agent。 而Claude Tag和豆包工作伙伴这样的产品,就是类似于给这个Agent一个独立身份,让它安全、可控地帮公司里所有人一起工作。 这句话基本就解释完了。 我们过去接触的大部分Agent,不管是Claude Code、Codex,还是各种你自己搭出来的Agent,本质上都有一个共同点。 它主要围绕“你”工作。 而Claude Tag和豆包工作伙伴这样的形态,是一个完全不同的形态。 你可以理解为,他有自己的身份、权限、记忆之类的,长期驻扎在公司的组织软件里,Claude Tag是待在Slack里,豆包工作伙伴是待在飞书里。 公司里的任何一个人都可以跟它一起工作。 它知道这个群之前发生过什么,也知道大家最近在聊什么,知道公司是什么业务、每个人负责什么、大家手上的项目分别是什么,也可以接入GitHub、多维表格、知识库之类的这些公司的系统。 甚至很多时候,你甚至都不需要主动叫它。 它自己会判断: 这个事情,我是不是该干点什么。 你看,这个关系就完全变了。 以前在组织中,我们跟AI的关系,大概是: 人、人、人、人。 ↓ ↓ ↓ ↓ AI、AI、AI、AI。 现在呢,就变成了: 人、人、人、人。 ↓ AI。 所有人共享同一个AI同事,大家都拥有了一个团队智能体,大幅的降低各种沟通和损耗成本,让我们的小伙伴,更有时间,去做那些真正AI替代不了,真正重要的事情。 这就是我觉得这类产品,对于组织来说,真正牛逼的地方。 而在Slack中,Claude Tag其实可以发挥的作用没有豆包工作伙伴在飞书中的大,核心还是因为,飞书过去十年打下的基建和江山实在是太恐怖了。 群聊、会议、文档、日历、任务、项目、OKR等等,甚至还有多维表格上的各种各样的业务数据,实在是太丰富了。 所以在昨天,我甚至在公司内部,做了一个小小的决定,把公司内部沟通,也全面从微信迁移到飞书上了。 公司的一个小小的里程碑,终于全面从微信切换到飞书了。 这一年跑的太快,很多基石还没做好,沿着惯性在走,昨天想了想,还是下定决心了。 对公司组织来说,也要全面拥抱为未来而生的基建才行。 飞书基本上就是为Agent而生,虽说只是办公方式的一个小小的变化,但是也意味着,面向未来。 这个决定,其实跟这几天内测豆包工作伙伴以后,有很大的关系。 说回豆包工作伙伴,这玩意目前还是邀请共创测试,因为我们稍微特殊一点的身份,所以是前几天就拿到了内测的,大家想用的话,可能还需要再等等,但是有些东西,我觉得还是足够可以给大家看一看的。 当你有了豆包工作伙伴的权限之后,你就可以在后台,看到他的设置页面,可以看到它的人设、自动化、资产、记忆等等。 你可以随便改,比如我就把它改成了,义父。 于是我们所有人让它帮忙干活,都是需要在群里,@义父。。。 当然,你也可以建多个不同的工作伙伴,赋予他们不同的能力和人格。 给大家举个例子。 我们的小伙伴,就在尝试用义父,来讨论选题。 平时刷到有意思的东西,就会直接扔进选题群里,大家一起聊聊能不能做。 就比如说,今天他们看到的这个盆栽和手摇Token生成器。 就可以在群里@义父,让它调研一下,技术上怎么实现,是否能够复刻。 它立刻就可以给出一些建议,对工期、预算和可能遇到的问题做了初步估算。 然后也可以让义父在群里,核查一些信息。 然后还有一个选题,是开学了吗,于是说,看看能不能把ChatGPT当成语言老师。 他们就还是把截图发进群里,让义父看看。 义父聊完之后,大家还可以继续充分讨论,再进行投票。 讨论结束以后,他们又让义父把前面的聊天整理成了一张选题总结卡片。 选题聊完以后,我们的流程是,由内容组的小伙伴会先把觉得合适的方向提报到选题库,再由我筛一轮,确定哪些可以做。 现在有了义父之后,他们真的就是随时分享、随时讨论,随时让义父往选题库里面扔。 然后我就能看到,义父把前面聊到的两个方向分别录入选题库,状态先设成待定,等我看完再决定。 接着,又让它根据选题库里之前已经确认可做的选题排一下档期。 结合每个人的工作分工和已有排期,安排一下谁来做、什么时候做,再把对应的安排加进日历里。 确认好以后,还能直接给对应的小伙伴来发送日程邀请。 就有了这个豆包工作伙伴之后,我们的工作流程和协同也肉眼可见的发生了一些变化,因为,这是属于大家的Agent,是属于大家的同事。 也能根据大家的时间,来约大家的会议。 还能跟我们一起开会。。。 这个同事也会拥有跟大家互动后,存下来的跟每个同事相关的记忆。 也可以给他配置各种各样的权限。 还有非常非常非常多好玩的东西和好玩的场景,感觉后续要慢慢发掘。 飞书过去所有在机器人、AI和Agent上的积累,在此刻融为一体,汇聚到了豆包工作伙伴上。 这个东西,是我过去这么久,用过的最有趣的Agent之一。 不过这个事肯定不好做,因为Agent 、大模型、协同办公要深度配合才能有比较好的流程的体验,还有包括token消耗等可能会很大,但,一定是未来的趋势。 其实过去,我也一直在思考一个命题。 当AI真的进入一个组织以后,公司这种东西本身应该如何发生变化? 因为我们都知道,一家公司里面,很多时候大量的成本其实都浪费在沟通和协作上。 比如说很多看到我就脑壳疼的问题:“你有没有跟A同步?A告诉B了吗?B知不知道C已经改了???” 还有无数类似的,我都想杀人。 过去我还在互联网中产的时候,真的,很多时候,一件可能真正只需要两小时完成的工作,可能前前后后要拉十个人,开三个会,发上百条消息,然后互相同步来同步去,三天才搞完。 所以我现在,极其认同一个公式: 团队效率 = 所有人个人效率的总和,再减掉协作成本。 过去的AI一直疯狂提高的,都是前半部分,但是协作成本,靠的几乎还是组织管理方法论,还有使用的协同工具本身。 但现在,因为豆包工作伙伴这样的产品,好像也在开始大幅降低协同成本了。 但本质上,核心还是飞书这个产品的基建,实在是搭的过于优秀了。 就像我上面说的,这也是我自己,为什么决定,最后还是决定把我们公司内部的工作沟通也全部迁到飞书 这当然只是一个很小的变化。 但我也只是想,把公司的工作方式,更加的面向Agent一点。 对公司组织来说,也要全面拥抱为未来而生的基建。 我们已经讨论了三年AI会怎么改变个人。 那接下来,也要开始聊一聊,AI究竟会如何改变公司了。 这个未来是必然会来的,那企业内部如何沟通,如何沉淀我们所有的知识和经验,如何管理项目,如何组织数据,如何让Agent真正的进入公司,这个是每一个组织,都必须要考虑的东西。 虽然我过去吹了飞书无数次,我真的不想再吹了。 但是我还是非常想真情实感地说一句。 相信我,企业拥抱AI。 先从飞书开始。 就像谢欣在发布会最后说的那句话一样: “把卓越的工具交给人们,他们自会,创造非凡”