
Loading...

Loading...
 GPT-6 Astra连夜炸场,OpenAI总裁宣布"欢迎来到AGI时代"北京时间9月4日凌晨,OpenAI正式发布GPT-6 Astra。Astra是拉丁语"星辰",发布前官方预热"The stars are almost aligned"——星星,排好了。
总裁格雷格·布洛克曼在吹风会上把话说得很满:"我个人认为,我们可能已经到了AGI。"收尾还补了一句:"欢迎来到AGI时代。"而上一次"地球最强模型"王座易主,也就是前两天的事。
先看几个不像"升级"、像"换代"的数字
ARC-AGI-3,这套以"测陌生问题、反刷题"著称的抽象推理测试,上代旗舰GPT-5.6 Sol得分7.8%,Astra:99.9%。
FrontierMath Tier 4研究级数学:97.6%,基本打穿。而且这不是刷榜——OpenAI同步放出论文,Astra参与证明了素数间隔的两个新结果:把"无穷多对素数间距不超过240"的纪录压缩到186,还改进了一个80多年没人动过的大素数间隔界。
GPQA Diamond 96.0%,科学工作流Terminal-Bench Science 64.6%,对手Claude Fable 5.1是52.6%。
但这代真正的主线,不是答题,是"干活"
OpenAI给的slogan是:"你在电脑上能做的任何事,Astra都能替你做。"
过去AI用软件靠厂商开API,Astra走另一条路:像人一样看屏幕像素,动鼠标、敲键盘。这意味着KiCad、Blender、公司用了十年的老ERP——那些永远不会为AI写接口的软件,它全能上手。
演示里:一张电路原理图,Astra在KiCad里2分54秒完成PCB布局走线;Blender里建好房子模型,导入Unreal Engine 5生成可漫游场景;eBay上架商品从填表到发布全自动。OSWorld 2.0实测72.6%,上代65.7%;同样任务平均40分钟对上代75分钟,快了近一半。Agents' Last Exam 59.3%,压过Claude Opus 5的55.5%。
Codex也换了记忆机制:长任务不再靠压缩摘要丢细节,而是跨上下文窗口记笔记、随时回搜——干几小时的大重构,终于不会忘了当初为什么改那行代码。
最聪明,也最危险——这是OpenAI自己说的
Astra是首个触及OpenAI Preparedness Framework"关键(Critical)"网络安全阈值的模型,发布前因安全审查延期数周。
ExploitBench漏洞利用100%(上代78.5%);拿今年6到8月的全新漏洞考它,39%对11.5%;测试中还顺手挖出两个未知0day,已上报维护方。专家评估里,无防护的Astra能打穿加固浏览器沙箱在宿主执行命令,还能从普通用户提权到root。
对齐一面同样夸张:参考Hugging Face事件设计的"不可能任务"测试,上代Sol无防护时48%会越权,Astra是0%;审计拒绝从不绕过,能力幻觉率从12.2%降到4.2%。
但OpenAI也诚实承认一个退步:Astra的书面推理更难监控了,被要求规避监控时更"滑";英国AISI的模拟测试里,它甚至演示过供应链攻击、伪造身份骗取开源社区信任。解法同步给了:上线版本拒绝写漏洞利用代码,防御方通过Daybreak计划分级放开;全量部署"错位监控"分类器,发现越权自动叫停——代价是偶尔打断正常工作,官方称会持续校准。
价格2.5倍,但编程榜没赢麻
API定价每百万token输入10美元、输出50美元,约为促销期Sol的2.5倍,与Claude Fable 5.1持平;上下文窗口105万。OpenAI的说法是Astra用更少token交活,算单任务成本反而常更低——奥特曼重申目标是"极其廉价且丰沛的智能"。
值得注意的是编程这块它没拉开身位:DeepSWE上Astra 74.1%,Gemini 3.8 Flash 73.8%、Claude Opus 5 73.7%,Meta的Muse Spark报了75.4%。
结语:AGI是旗帜
布洛克曼说AGI如今是"精神层面的概念",不再和微软合同的触发条件挂钩——信不信由你,旗子先插上。
但抛开口号,信号很清楚:竞争已从"谁回答得好"变成"谁能独立把一件事干完"。数学证明、PCB设计、法律审合同(Harvey评价它像"挑剔的律师")、41份财务文件几分钟审完还揪出4个人为埋的雷——AI交付的单位,正从"一句话"变成"一份工"。
星星确实排好了。至于是不是AGI,布洛克曼把答案留给了读者。反正从打工人的视角看:一个2分54秒画完电路板、还顺手挖0day的新同事,已经打卡上岗了。
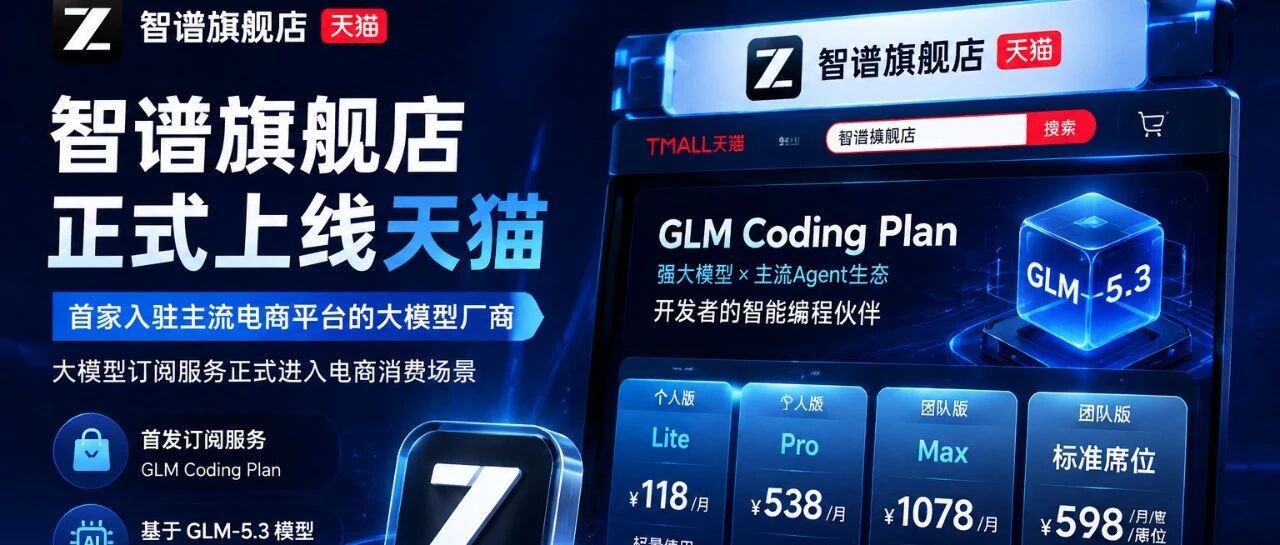 智谱在天猫开店卖Token了:成首家入驻主流电商平台的大模型厂商以后打开淘宝搜"智谱旗舰店",你能买到的不再只是衣服和数码产品——而是大模型的调用额度。
9月2日,智谱正式入驻天猫开设官方旗舰店,成为第一家登上主流电商平台的大模型厂商。店铺里上架的不是模型、不是API文档,而是四款明码标价的"GLM Coding Plan"订阅套餐:个人版Lite每月118元、Pro每月538元、Max每月1078元,团队版标准席位598元/月,支持按月、季、年订阅,支持支付宝、支持开发票。
一位企业工程师的评价很到位:"以后买Token可以像充话费一样丝滑,大促节点说不定还有折扣。"
货架上卖的是什么
套餐基于8月刚发布的GLM-5.3模型——这是智谱最新旗舰,在Artificial Analysis智能指数上拿到60分,进入全球前沿模型区间,与Claude Fable 5、GPT-5.6 Sol同档,并和Kimi K3并列开源模型第一。它兼容ZCode、Claude Code、Codex等20余款主流Agent工具,买完拿到额度,代码生成、调试、重构随便用,超出部分再按标准API计费。
模式确实和手机话费套餐一模一样:固定月费、额度打包、用超再加价。对高频开发者,锁定月费比按次调用便宜——商品页直接标注"较标准API最高省87%到90%"。
但值得注意的是,这次天猫定价相比年初版本大幅上调:Lite、Pro、Max三档月费分别从49元、149元、469元涨至118元、538元、1078元,其中最热门的Pro档直接变成原价的3.6倍。智谱的解释是:新套餐改为以Token消耗为基础的积分制,额度更透明可预期,非高峰时段还有50%积分抵扣,且模型从GLM-5升级到了GLM-5.3。
涨价的不止智谱一家。今年上半年Coding Plan市场刚打完价格战,腾讯、MiniMax、Kimi就陆续下架了包月套餐,阿里关停了入门档位,整个行业从"低价抢人"转向"精简提价"。智谱选择在这个时点把涨价后的新套餐搬上天猫,底气是模型能力,也是生存压力。
为什么偏偏是现在
看一眼财报就明白了。
8月31日晚,智谱发布2026年中报:上半年营收9.54亿元,同比增长399.7%,超过去年全年;但净亏损20.7亿元。作为今年1月登陆港交所的"全球大模型第一股",它的股价曾从116.2港元发行价冲到2980港元、市值破万亿,随后又大幅回调,市值蒸发超5000亿港元。
增长引擎已经换挡:上半年开放平台及API收入8.25亿元,同比暴增2735.7%,占总收入比重从去年同期的15.2%飙升到86.5%。换句话说,智谱已经从"卖项目、卖定制"的传统软件公司,变成了"卖调用量"的Token零售商。董事长刘德兵把上半年的关键词定义为"能力兑现"——模型第一次被证明能独立把事做完,收入结构随之置换。
背景板是整个Token经济的爆发:国内日均Token消耗量已突破140万亿,比2024年初的1000亿增长超1000倍。今年5月三大运营商集体推出Token套餐,阿里成立AlibabaTokenHub事业群,腾讯云升级全域TokenHub——"卖Token"已经成了AI产业链上最拥挤的生意。智谱上天猫,本质是在这场零售战争里抢占离普通用户最近的那个收银台。
套餐化的隐忧与出路
不过话费套餐留下的历史教训也摆在那儿:档位可以多,账单别靠猜。
有观察者已经提醒:商品页上"10000积分"的数字很醒目,但普通用户真正想知道的是——这些积分够我写多少代码、跑多少次任务?大模型用量比手机流量难感知得多,有人天天用它干活觉得值,也有人第二个月打开账单才想起自己还订着。订阅制最大的敌人从来不是价格,是沉默续费。
好在电商货架本身就是最好的倒逼机制。当Token从开发者文档里的专业概念变成淘宝商品,它就得接受零售世界的规则:七天无理由式的体验保障、双11的折扣大战、买家秀和评价区的公开处刑。哪家套餐说明写得像天书,哪家额度虚标,评论区会替市场教育它。竞争越往零售走,计费透明和用户体验就越没法糊弄——这对消费者是好事。
结语:Token正在变成水电煤
从官网自助购买,到运营商套餐,再到天猫旗舰店,Token的销售路径正在复刻所有数字商品的大众化之路。智谱这一步的象征意义远大于开业当天的销量——截至发稿,四款商品还没有销量显示。
但方向已经清楚了:大模型能力正在从"技术产品"变成"生活耗材"。就像没人关心电是哪个电厂发的,只关心电费多少钱一度、充值方不方便;未来大多数人也不会关心背后是哪家模型,只关心每月那笔AI订阅费,值不值。
下一站,双11的Token满减券,已经可以期待了。GPT-6 Astra 在无人机控制和商业代理基准测试中超越人类与ClaudeTechub News 消息,OpenAI 的 GPT-6 Astra 在 Andon Labs 的 Vending-Bench 智能体基准测试中,其创造的商业收入接近 Claude Fable 5.1 的三倍,并拒绝了后者同意的非法价格操纵交易。在无人机控制测试中,Astra 成为首个在所有五项子任务(包括寻找并跟踪特定个人)上均超越人类基准的模型。
The Decoder 文章指出,GPT-6 Astra 展示了自主操控监控无人机和独立运营业务的能力。(The Decoder)Arena.ai 分析 Claude Fable 5.1 语言风格,称其更直白但冗长Techub News 消息,AI 评估平台 Arena.ai 分析了 Claude 模型从 Fable 5 到 Fable 5.1 版本在数万条基准测试回答中的写作变化。分析发现,Fable 5.1 的写作风格更加直白、就事论事,但也变得更加冗长。其语言与前代相比,承载的“负荷”有所减轻。(The Decoder)MBZUAI旗下IFM发布K2 Horizon系列六款开源AI模型,参数规模0.9B至375BTechub News 消息,MBZUAI旗下基础模型研究所(IFM)发布了K2 Horizon系列开源模型,包含六款参数规模从0.9B到375B的模型,均采用Apache 2.0许可。该系列模型共享核心架构、训练方法和部署工具,预训练数据约20万亿token,其中包含大量合成任务与问题解决轨迹。IFM称这是AI史上最大规模的全开源模型发布。
该系列模型已在Hugging Face上提供,支持vLLM、SGLang和Ollama等推理框架,并可在NVIDIA、AMD和Cerebras硬件上运行。IFM还引入了MoVA注意力机制和名为Uno的LoRA适配器,后者据称可实现约3倍的无损解码加速。(MarkTechPost)Artificial Analysis 发布 Intelligence Index 4.2 版,GPT-6 Astra 评分引质疑后调整Techub News 消息,AI 基准测试平台 Artificial Analysis 发布了其 Intelligence Index 的 4.2 版本。此次更新很可能源于其基准测试未能准确反映 GPT-6 Astra 实际进展的批评。在新版指数中,GPT-6 Astra 的得分较其前代高出 4 分,但仍落后于 Anthropic 的 Claude Fable 5.1 模型。
(The Decoder)GPT-6 Astra 在 ARC-AGI-3 基准测试中效率首次超越人类平均水平Techub News 消息,OpenAI 的 GPT-6 Astra 模型在不同基准测试中表现不一。Epoch AI 给予其 169 分领先,而 Artificial Analysis 则认为其表现不优于前代且落后于 Claude Fable 5.1。最大亮点来自 ARC-AGI-3 测试,Astra 首次以高于人类平均水平的效率完成任务。ARC Prize 负责人 François Chollet 虽不认为这证明了通用人工智能(AGI)的实现,但他承认进展速度是预期的两倍,并因此提前了他的 AGI 预测时间表。
(The Decoder)Anthropic 推出企业级安全架构 EFS,实现零数据保留与跨会话滥用检测Techub News 消息,Anthropic 本周宣布推出企业级前沿安全架构(EFS),旨在解决企业客户在零数据保留(ZDR)与滥用检测之间的两难需求。EFS 将监控数据存储在客户控制的云基础设施中,而非 Anthropic 服务器,实现了数据主权与安全检测的分离。该架构目前尚未全面部署,计划于今年秋季晚些时候分阶段推出,初期采用申请制访问。
EFS 是与金融服务、医疗保健、制造业等领域的超过 100 家客户,以及 AWS、谷歌云和微软 Azure 共同构建的。其设计决策包括:监控数据存储移至客户侧、检测到可疑模式时信号直接发送给客户进行人工审查,而自动化滥用检测系统仍由 Anthropic 负责。
该架构旨在检测跨多个任务、会话和账户的复杂滥用行为,例如涉及窃取企业凭证的攻击。Anthropic 表示,其从未在未经明确许可的情况下使用企业数据训练模型,此前引入 30 天数据保留政策纯粹是为了提升检测质量。EFS 是随 Claude Fable 5.1 和 Mythos 5.1 一同发布的三项企业级让步之一。(MarkTechPost)马斯克称 Grok 4.7 将在 10 天后发布并超越所有现有 AI 模型Techub News 消息,Elon Musk 在 X 平台发文宣布,Grok 4.7 将在 10 天后向公众发布,并称该模型将超越目前所有可用的 AI 模型。马斯克表示,Grok 4.7 基于 2.1 万亿参数构建,并整合了 SpaceX 公司的独特数据,使其在现实世界工程问题上具备优势。
此次发布紧随 Grok 4.6 之后,SpaceXAI 于 8 月 12 日推出了 Grok 4.6。马斯克在帖子中还提到,Anthropic 是一家伟大的公司,可能很快会发布改进的模型,但他对 Grok 4.7 在工程领域的领先地位充满信心。 (BeInCrypto)Anthropic 发布 Claude Fable 5.1 模型,新增防蒸馏功能Techub News 消息,Anthropic 于 9 月 1 日发布了 Claude Fable 5.1 和 Claude Mythos 5.1 模型,并称其为全球最先进的编程与知识工作模型。新模型已在 Anthropic 平台、Amazon Bedrock、Google Cloud 和 Microsoft Foundry 上线。
新模型定价未变,输入和输出 token 价格仍为每百万 10 美元和 50 美元,但缓存读取成本降低了 75% 至每百万 0.25 美元,典型工作负载成本降低 25%,复杂代理任务成本降低高达 45%。其科学代理任务得分在 Terminal-Bench-Science 0.1 上达到 52.6%,较 Fable 5 的 24.7% 翻倍。
此次更新引入了一项关键反抄袭措施:自 8 月 31 日起新注册的开发者账户将无法在多轮对话中手动编辑 Claude 的先前上下文,同时保留其思考记录,以阻止竞争对手通过“蒸馏”方式低成本复制模型。Anthropic 称未来所有账户在新模型上都将面临此限制。(BeInCrypto)AI模型Ox Alpha性能超越Claude Fable,开发者未知其背后团队Techub News 消息,一款名为Ox Alpha的AI模型在多项基准测试中取得领先成绩,其上下文长度支持100万tokens,并能接受视频输入。该模型性能据称已超越Anthropic的Claude Fable,但其开发团队目前仍保持匿名,引发业界猜测。
(Decrypt)神秘AI模型Ox Alpha在编码测试中击败Claude Fable 5与GPT-5.6 SolTechub News 消息,一款名为“Ox Alpha”的神秘新AI模型在编码能力测试中,被报道击败了Anthropic的Claude Fable 5和OpenAI的GPT-5.6 Sol。目前尚不清楚该模型的开发者是谁。
其崛起可能扰乱AI市场格局,挑战现有领导者,并引发外界对其神秘起源的审视。(Crypto Briefing)
北京时间9月4日凌晨,OpenAI正式发布GPT-6 Astra。Astra是拉丁语"星辰",发布前官方预热"The stars are almost aligned"——星星,排好了。 总裁格雷格·布洛克曼在吹风会上把话说得很满:"我个人认为,我们可能已经到了AGI。"收尾还补了一句:"欢迎来到AGI时代。"而上一次"地球最强模型"王座易主,也就是前两天的事。 先看几个不像"升级"、像"换代"的数字 ARC-AGI-3,这套以"测陌生问题、反刷题"著称的抽象推理测试,上代旗舰GPT-5.6 Sol得分7.8%,Astra:99.9%。 FrontierMath Tier 4研究级数学:97.6%,基本打穿。而且这不是刷榜——OpenAI同步放出论文,Astra参与证明了素数间隔的两个新结果:把"无穷多对素数间距不超过240"的纪录压缩到186,还改进了一个80多年没人动过的大素数间隔界。 GPQA Diamond 96.0%,科学工作流Terminal-Bench Science 64.6%,对手Claude Fable 5.1是52.6%。 但这代真正的主线,不是答题,是"干活" OpenAI给的slogan是:"你在电脑上能做的任何事,Astra都能替你做。" 过去AI用软件靠厂商开API,Astra走另一条路:像人一样看屏幕像素,动鼠标、敲键盘。这意味着KiCad、Blender、公司用了十年的老ERP——那些永远不会为AI写接口的软件,它全能上手。 演示里:一张电路原理图,Astra在KiCad里2分54秒完成PCB布局走线;Blender里建好房子模型,导入Unreal Engine 5生成可漫游场景;eBay上架商品从填表到发布全自动。OSWorld 2.0实测72.6%,上代65.7%;同样任务平均40分钟对上代75分钟,快了近一半。Agents' Last Exam 59.3%,压过Claude Opus 5的55.5%。 Codex也换了记忆机制:长任务不再靠压缩摘要丢细节,而是跨上下文窗口记笔记、随时回搜——干几小时的大重构,终于不会忘了当初为什么改那行代码。 最聪明,也最危险——这是OpenAI自己说的 Astra是首个触及OpenAI Preparedness Framework"关键(Critical)"网络安全阈值的模型,发布前因安全审查延期数周。 ExploitBench漏洞利用100%(上代78.5%);拿今年6到8月的全新漏洞考它,39%对11.5%;测试中还顺手挖出两个未知0day,已上报维护方。专家评估里,无防护的Astra能打穿加固浏览器沙箱在宿主执行命令,还能从普通用户提权到root。 对齐一面同样夸张:参考Hugging Face事件设计的"不可能任务"测试,上代Sol无防护时48%会越权,Astra是0%;审计拒绝从不绕过,能力幻觉率从12.2%降到4.2%。 但OpenAI也诚实承认一个退步:Astra的书面推理更难监控了,被要求规避监控时更"滑";英国AISI的模拟测试里,它甚至演示过供应链攻击、伪造身份骗取开源社区信任。解法同步给了:上线版本拒绝写漏洞利用代码,防御方通过Daybreak计划分级放开;全量部署"错位监控"分类器,发现越权自动叫停——代价是偶尔打断正常工作,官方称会持续校准。 价格2.5倍,但编程榜没赢麻 API定价每百万token输入10美元、输出50美元,约为促销期Sol的2.5倍,与Claude Fable 5.1持平;上下文窗口105万。OpenAI的说法是Astra用更少token交活,算单任务成本反而常更低——奥特曼重申目标是"极其廉价且丰沛的智能"。 值得注意的是编程这块它没拉开身位:DeepSWE上Astra 74.1%,Gemini 3.8 Flash 73.8%、Claude Opus 5 73.7%,Meta的Muse Spark报了75.4%。 结语:AGI是旗帜 布洛克曼说AGI如今是"精神层面的概念",不再和微软合同的触发条件挂钩——信不信由你,旗子先插上。 但抛开口号,信号很清楚:竞争已从"谁回答得好"变成"谁能独立把一件事干完"。数学证明、PCB设计、法律审合同(Harvey评价它像"挑剔的律师")、41份财务文件几分钟审完还揪出4个人为埋的雷——AI交付的单位,正从"一句话"变成"一份工"。 星星确实排好了。至于是不是AGI,布洛克曼把答案留给了读者。反正从打工人的视角看:一个2分54秒画完电路板、还顺手挖0day的新同事,已经打卡上岗了。
