
Loading...

Loading...
 Latent Labs:Alphafold 3 发布两年,AI 药物设计进展到了哪一步?作者:Daniel
编辑:Cage
我们认为,AI for Science 是 AI 继 Coding 之后的下一个重点方向。而药物发现又是其中最有前景的赛道。一方面,药物试验拥有完整反馈闭环且高度可验证,是实现 RSI 的理想场景。另一方面,AI 可以解放实验人员的产能,使得大量休眠靶点有重新开发的机会。我们有十足的理由相信,下一个药物大发现时代很可能便是由 AI 推动的。
AlphaFold 让我们看到了 AI 理解蛋白质结构的能力,而 AI 的下一个战场,是设计传统方法做不到的分子。这是一个激烈竞争的领域,除了从 Google Deepmind 中诞生的 Isomophic 之外,Chai Discovery、Boltz、 Latent Labs 也分别发布他们的预测模型与药物模态区别化下注。蛋白质从头设计也逐渐走近药物研发的实际应用。
Latent Labs 是观察这一变化的重要样本:创始人 Simon Kohl 曾参与 AlphaFold 2 的核心研发,押注了环肽这一新兴模态类型并选择自建湿实验室。2025 年 2 月,公司以累计 $5,000 万融资走出隐身状态,吸引了包括 Jeff Dean、Aidan Gomez 的天使投资。同年 7 月,发布了面向小蛋白与环肽的生成模型 Latent-X。并在 12 月用 Latent-X2 进一步覆盖纳米抗体和抗体片段,并关注表达、稳定性及免疫原性等成药相关性质;2026 年 3 月发布的 Latent-Y 则是在这些模型之上构建的科研 Agent。
不可否认的是,目前各家正在测试的蛋白质还没到可以成药的阶段。他们只是完成了流程的第一步:证明自己能够作为结合物发挥作用。如果我们把药物的研发比作登山,人类过去已经攀登过无数山峰,且资本市场也给予了创新者极其丰厚的回报。从 PD-1 到 CAR-T,再到近期大火的 GLP-1 都是很好的证明。但攀登的道路极其困难,往往需要数年+数十亿美元作为成本。AI 药物发现的目标,是把一条条狭窄的山路变成高速公路,且让人们向更高更危险的山峰发起冲击。
/
01.
Key thesis:
•蛋白质生成模型的出现颠覆传统制药流程,很可能带来一个药物大发现时代
传统药物发现是在庞大的真实分子库中寻找少数有效候选,生成模型则可以根据需求设计自然界不存在的分子。变化不仅是筛选效率提高,更是能够探索过去难以触及的分子空间。长期价值不只是“更便宜地做药”,而是让同样的研发资源能够探索更多项目,未来的药物研发可能打破“反摩尔定律”,实现质和量的大幅跃升。
•结合物发现环节高度可验证,是实现 RSI 的理想场景,Latent 湿实验室自建为竞争优势
在药物发现里面,设计结合物环境是最为可控,最容易产生 loop 的。结合本质上就是两个分子表面的形状互补 + 化学互补,有明确的物理规律,终点明确且反馈回路快。随着计算生成成本下降,稀缺资源将逐渐从候选分子转向高质量的实验反馈。Latent 逐步将实验能力放于内部,有机会更紧密地连接模型研发与实验判断。
•生物医药领域长坡厚雪,每种模态都会诞生领先大玩家, Latent 模态选择上有差异
行业内短期的催化是专利断崖正在发生,各大药企开始重视药物发现相关技术。不同模态面对的设计约束和开发难点不同,单一模型难以在所有任务上保持优势,制药公司也倾向与多家公司合作。大环肽是 Latent 最值得关注的切入口。它有机会覆盖传统小分子难以处理的结合界面,同时在部分场景中提供不同于抗体的药物属性。它也是目前的热门赛道,已有多款新药受到市场青睐。
•以 AlphaFold 成员为班底打造的明星团队
创始人 Simon Kohl 参与开发 AlphaFold 2,随后发起并共同领导 DeepMind 的蛋白质设计团队;创始技术成员 Alex Bridgland 曾参与 AlphaFold 1、2、3,覆盖模型开发、评估与数据工程。团队中多数成员拥有丰厚药物模型研发经验,与专注实验平台与内部湿实验室的科学家形成互补。团队还有前默克集团 CEO 作为顾问参与,为团队打进大型制药公司奠定基础。
02.
Latent Labs 技术路线
Alphafold 之后,从预测蛋白到生成蛋白
如果说以 AlphaFold 2 为代表的结构预测模型是一台“AI 显微镜”,帮助人们看清蛋白质的形状,那么蛋白质生成模型更接近分子世界的 CAD:根据功能需求,设计自然界中尚不存在的分子。
以蛋白质结合物设计为例,它是在反向求解蛋白质折叠问题。结构预测从一条氨基酸序列出发,判断它会形成什么样的三维结构;生成设计则从目标出发:给定一个疾病靶点和希望结合的表面区域,寻找能够稳定折叠,并与之结合的新序列。
一条设计蛋白质的典型流程是:
获得靶点结构→生成结合物的结构与序列→重新预测复合物结构→筛选候选→湿实验验证
2023 年发表的 RFdiffusion,让分子世界的 CAD 初具雏形。研究团队将原本用于结构预测的 RoseTTAFold 改造成去噪扩散模型,让它从随机噪声中逐步生成蛋白质骨架,再交给其他模型配上氨基酸序列、检查能否折叠成预期的形状。几个模型各司其职,组成了一条早期的蛋白质设计流水线:先画出轮廓,再补齐细节,最后检查。
自此,预测模型从观察一个分子,走向理解多个分子如何共同组成一个系统。AlphaFold 2 可以从氨基酸序列预测蛋白质的三维结构。2024 年 5 月,AlphaFold 3 将蛋白质、DNA、RNA 和小分子等纳入统一的复合物预测框架。这让研究人员在设计新分子时,多了一种检查它与靶点是否匹配的工具。
除了 Ismorphic Labs,不少公司也从这一层切入。比如 Chai Discovery、Boltz。2024 年 9 月,Chai 发布 Chai-1,预测多类生物分子的结构及其形成的复合物;同年 11 月,Boltz 团队发布 Boltz-1,并开放训练代码和模型权重。
而 Latent Labs 没有跟随先做结构预测的路径,而是直接做蛋白质生成设计。创始人Simon Kohl是参与开发 AlphaFold2 的核心人员和论文作者,Isomorphic Labs 当时正在沿着 AlphaFold 向多个药物研发方向扩张,而他认为蛋白质设计本身已经足够庞大,值得由一个更小、更灵活的团队集中突破。于是决定单独创业。他们的伦敦团队负责开发基础模型,旧金山则有湿实验室和计算生物团队,测试模型设计出的分子,将实验反馈用于模型研发,并采集训练数据。
2025 年,三家公司开始交生成模型的答卷,第一代生成模型相继亮相:
•6 月,Boltz-2 在结构预测之外加入结合亲和力预测,迈出了生成模型的第一步;
•同月,Chai-2 发布,成为第一个从零设计抗体的生成模型。
•7 月,Latent 发布首个模型 Latent-X,首先展示了环肽和小蛋白的从零设计能力。
•10 月,Boltz 推出生成模型 BoltzGen,正式进入结合物设计。
主力模型:Latent X
2025 年 7 月,Latent-X1 发布。
它首次公开展示了 Latent 的端到端全原子蛋白质设计能力。用户提供靶点序列、骨架结构和希望结合的热点后,模型联合生成新结合物的氨基酸序列,以及结合物—靶点复合物的全原子构象。
Latent-X 首先选择了大环肽(macrocyclic peptide)和小蛋白(mini-binder),而没有直接挑战完整抗体。团队在 7 个治疗相关靶点上进行湿实验,每个靶点最终测试 30 至 100 个设计。公司报告的大环肽命中率为 91%至 100%,mini-binder 为 10%至 64%,并获得了低纳摩尔乃至皮摩尔级 binder。
其中在环肽方面,Latent-X1 在三个靶点上的受测样品命中率达到 91%–100%,高于 RFpeptides 文献报告的 21%–38%,且在 MDM2 靶点的亲和力方面实现了更低的 KD 值。
RFpeptides 是华盛顿大学蛋白质设计研究所(IPD)开发的 AI 环肽设计方法,由 David Baker、Frank DiMaio 和 Gaurav Bhardwaj 三个实验室联合开发,可以理解为 RFdiffusion 面向环肽设计的延伸。
2025 年 12 月,Latent-X2 发布,目标是生成更接近药物的分子。
X2 可以输入指定表位,只生成关键结合区域,并把能力扩展到 VHH 和 scFv。团队对每个组合只测试 4 至 24 个设计,在 18 个靶点中的 9 个上获得成功,同时评估表达量、聚集倾向、多反应性、疏水性和热稳定性;部分代表性 VHH 还进行了人源供体的离体免疫原性实验。
•Agent 产品 Latent-Y
2026 年 3 月发布的 Latent-Y 是建立在 Latent-X1 和 X2 之上的 AI Agent。它把原本需要多位专业研究人员完成的蛋白质设计流程,封装成一个可以用自然语言操作的产品。Latent-Y 可以从自然语言目标出发,完成文献检索、靶点分析、表位选择、调用 X2 生成、计算验证和候选筛选。公司报告中,它在 9 个靶点里为 6 个找到了实验确认的 binder,为科研人员打造蛋白设计的“Cursor”。
按时间顺序排列的三家公司主要产品发布
Latent 的差异化下注
模态类型:环肽
从产品策略看,Latent 则先用大环肽与小蛋白展示生成模型的能力,再于 2025 年 12 月发布 Latent-X2,将设计范围扩展至 VHH 和 scFv 等抗体格式。环肽始终是这条产品路线中的重要组成部分。
环肽是近期比较热门的研发方向,它处在小分子与抗体之间的“中间地带”,容易进入细胞:它的接触面积大于传统小分子,因此有机会识别平坦的蛋白质相互作用界面,并有接近抗体的亲和力和特异性;环化又可能提高抗蛋白酶降解能力,可以作为口服、缓释药物。
比较出名的例子包括:
•强生与 Protagonist 合作开发的 icotrokinra,是一款靶向 IL-23 受体的口服大环肽药物,2026 年 3 月获美国批准用于中重度斑块状银屑病,预测峰值销售超 $50 亿。
•默沙东的 enlicitide ,一款靶向 PCSK9 的大环肽。2026 年 7 月获批,用于降低高胆固醇血症成人患者的 LDL-C,其 2033 年销售额预期超 $50 亿。
数据闭环:自建湿实验室
从 2024 年开始,Latent 便在旧金山运行湿实验室,并将实验验证作为模型研发的重要支点。从招聘信息可以看出,伦敦的 Computational Protein Designer 主要负责计算设计;旧金山的同岗位则额外要求较强的湿实验经验,需要亲自开展蛋白表达与纯化、生物物理表征和功能实验。
我们可以从 Latent X1 模型的实验论文了解内部实验平台的分工,以小型蛋白质结合物 mini-binder 为例,模型先为每个靶点生成约 2 万个设计,再根据预测结构选出 100 个候选进入实验,进入两条相互补充的验证路径:
•一条交给外部服务商 GenScript:先根据设计序列生产蛋白质,再用 BLI,检测它与靶点是否结合再进一步测量,确定结合强度及结合、解离的速度。
•另一条由 Latent 内部完成,采用的是哺乳动物细胞表面展示,简称 mDisplay。研究人员将编码候选蛋白的 DNA 导入细胞;随后加入靶蛋白,通过荧光信号观察候选是否成功展示、能否抓住靶点。
这套双重筛选方法,让研究人员能够在原理不同的结合检测平台上,交叉验证哪些候选真正命中了靶点。
在这里,Latent 的自建实验室与外部服务商是协同关系。DNA 合成、部分材料制备,以及蛋白质生产和仪器测量,仍然由外部机构承担;Latent 则将一部分验证环节放在内部,让计算设计人员能够更直接地接触实验结果。
如果说 X1 论文更像是在验证自己内部的实验能力,那么近期我们能看到公司在越发重视实验的迹象。2026 年 3 月,Latent 在旧金山招聘 Head of Lab Platform 与 Research Lab Scientist。希望招聘具有从零搭建实验室经验的人,进一步扩展现有的高通量实验、自动化和数据管理能力。在未来,Latent Labs 可能会把更多湿实验室环节放进内部。
携手 AWS 接入客户
2025 年 5 月,Latent Labs 与 AWS 宣布多年战略合作,覆盖模型训练与推理所需的云基础设施,以及面向生命科学客户的商业推广。Latent 提供生物生成式 AI 模型,AWS 则作为其首选云服务商提供算力支持。Latent 使用 Amazon SageMaker HyperPod 扩展计算资源,支撑模型研发和客户使用;同时借助 AWS 的合作伙伴网络与市场拓展支持,触达更多药企、生物技术公司和科研机构。
Latent 旗下模型也接入了 Amazon Bio Discovery 平台:这是 AWS 于 2026 年 4 月推出的 AI 药物研发应用,目前主要面向早期抗体发现。平台将生物 AI 模型、科研助手和外部实验服务整合到同一个工作环境:科研人员可以选择模型并评估候选分子,再将选定候选交给合作实验室测试。
该平台已公布的早期采用机构包括纪念斯隆凯特琳癌症中心(MSK)、拜耳、Broad Institute、Fred Hutch Cancer Center 和 Voyager Therapeutics。
03.
Why now
De novo design:从创造分子到 RSI
传统结合物发现的流程需要:
1.先准备一个非常大的真实分子库;
2.用噬菌体展示、酵母展示、动物免疫等方式做实验筛选;
3.从百万到十亿级候选中找到少量结合者;
4.再做亲和力成熟、特异性和成药性优化。
而 De novo design(从头设计) 彻底改变了研发的起点:研究者可以先指定靶点、结合位置和功能要求,再设计满足这些条件的新序列,将自然界中原本不存在的分子纳入药物发现。只合成模型排名最高的一小批。
AI 最明显的突破是压缩早期结合物发现的时间和实验规模。传统抗体发现采用动物免疫等路线,获得初始结合物通常需要数月;之后还要完成候选优化和临床前开发。参考药明生物的公开材料,DNA-to-IND 阶段的典型周期为 6–15 个月,对应$500 万- 800 万。
同样类比早期发现环节,Chai-2 针对 52 个抗原,每个靶点、每种抗体格式测试不超过 20 个设计,报告约 16% 的候选级结合命中率,并在一半靶点上获得至少一个结合物;从计算设计到湿实验验证,用时不足两周。
通过对蛋白生成设计发展的观察,我们可以看到:
从模型能力到工作流编排,再到干湿实验闭环,竞争正向完整研发流程延伸。随着基础预测能力正在快速开源化,Latent 与 Boltz 纷纷发力 Agent 编排与工作流,希望争夺成为这个领域的操作系统。下一阶段,差异化可能更多来自能否有效连接计算设计与实验验证,让实验结果持续反馈到下一轮设计中。
药物发现的未来,将逐步走向智能科学的 RSI:lab-in-the-loop 是实现这一愿景的重要基础。它将湿实验室接入AI的设计与决策循环,让每一轮实验既筛选候选,也为下一轮探索提供信息,从而以更低的总成本、更短的时间,获得足以支持项目推进或终止的可靠证据。而在结合物设计阶段,更容易形成闭环,相较于药物研发的后续环节,这一阶段的实验环境更可控,评价终点更明确,反馈周期也更短。分子结合主要取决于两个分子表面在形状和化学性质上的互补,并受到明确的物理规律约束。这些特征使结合物设计更容易形成“设计—实验—反馈—改进”的循环。
专利断崖正在发生,AI 加速新/旧靶点的开发
药物研发长期承受反摩尔定律的压力:Eroom’s Law 最初描述的是的 1950 年至约 2010 年间,每十亿美元研发投入对应的新药产出大约每九年减半。而AI可能是有潜力逆转这个趋势的技术。
而另一个大趋势是药企的专利断崖正在发生,根据 Evaluate 预测,我们即将迎来下一个专利到期的高峰。2026-2032 年,累计有超过 5000 亿美元销售额可能面临专利过期的风险,药企需要寻找下一个大药物。
专利断崖会迫使大药企更积极地采用 AI 技术、投资 AI 公司、与 AI 公司合作。Isomorphic、Chai、Boltz 近期接连签下大订单,背后都有大药企面对专利断崖、需要新管线的驱动因素。而具体看,AI 带来的机会集中在两个方向:
1.大量未开发靶点迎来重新开发的机会
药企长期积累了大量尚未完成的研发项,这些未被开发的机会远比已经上市的药物多。2024 年的一项系统研究估算,在人类 19,813 个蛋白编码基因中,约有 4,729 个可能被生物药调控,但只有 755 个已经成为获批药物的靶点。即便只看曾经进入临床开发的靶点和疾病,约 170 万种潜在的“靶点—适应症”组合中,也只有 2.5% 被实际探索过。
过去,药企很难系统性地重新检查这些项目,而蛋白生成模型的出现,给了研究人员大量开发难成药靶点的机会。Isomorphic Labs 与 Novartis 最初围绕 3 个高难度靶点合作,一年后又增加了最多 3 个项目,说明大型药企已经开始把真实的早研问题交给 AI 平台。
2.AI 做 me-better /best-in-class 的机会
AI 可以针对这些已验证靶点,设计出更好的分子,AI 可以探索传统方法覆盖不到的序列空间,可以找到完全不同的结合模式,实现跨越式改进。另外,AI 蛋白设计本质上是高维搜索和优化。老靶点已经积累了大量结构、突变、药理和临床数据。问题因此从开放式的生物学探索,变成了一个边界清晰的分子优化任务。
生物医药领域特殊的行业结构,也为多家企业一同创造价值提供了空间。专利保护使任何成功创新有机会获得持续回报,而不同疾病、治疗机制和患者群体又形成了多个独立的市场。企业既可以通过 first-in-class 开辟新的治疗路径,也可以通过 me-better/best-in-class 在疗效、安全性或用药便利性上建立优势。因此,一家公司即使只在有限的治疗领域取得突破,也可能通过自主销售、授权或并购实现较大价值。
因此,这是一个极其长坡厚雪的赛道,一条条成功的管线则是这个领域可被验证的节点。
下一个大制药公司可能在 AI 发现平台中诞生
全球药企每年约有 3,000 亿美元研发支出,其中,top 25 家药企约花费 1760 亿,占全球约 61%,头部集中度高的特性。其中临床前部分约占到研发支出的 15%,大约占到每年 450 亿。这 450 亿美元构成了 AI 药物发现最直接的第一层预算池。如果 AI 能够避免临床前阶段 20%–40% 的低价值试错,对应每年约 90 亿至 180 亿美元的经济价值。
AI发现平台的长期上行,来自将药物发现转化为一种能够持续积累、重复产出新资产的研发能力。一个分子的设计和筛选成本,只是项目总投入的一部分。如果靶点选择、疗效或安全性问题直到临床阶段才被发现,此前投入的时间和资金便可能难以收回。AI如果能够更早识别高风险项目,提高进入临床项目的平均质量,其经济价值会显著超过减少几轮筛选实验。
历史上,新一代平台型药企的出现,往往都发生在一次科学突破被工程化、工业化的窗口期。重组 DNA 技术催生了 Genentech;受体陷阱蛋白和全人抗体工程平台支撑了 Regeneron;核苷修饰和递送技术促成了 Moderna。AI 与这些技术的不同之处在于,它不是一种单独的治疗模态,而是一套可以横跨小分子、抗体、蛋白质和核酸的发现基础设施。因此,它理论上能够支撑的管线宽度更大,平台的上限也可能更高。
目前而言,最接近下一代制药公司的是 Isomorphic Labs,公司在 2024 年与 Lilly、Novartis 的合作,首付款分别为 4,500 万和 3,750 万美元;另有分别最高 17 亿和 12 亿美元的条件性里程碑,以及销售分成。
04.
竞争格局
目前在大分子领域,最为突出的竞争者分别是前 OpenAI、Meta FAIR 研究者 CEO Joshua Meier 创立的 Chai Discovery 和从 MIT Jameel Clinic 研究项目发展出来的 Boltz。他们的路线差异具体如下:
•Chai Discovery:专注抗体,Enterprise-first,强调模型性能和大药企深度部署。
•Boltz:专注开源模型 + API 的收费逻辑,主打全模块。让 Claude/Codex/ 药企内部 agent 组合工作流
•Latent Labs:环肽路线,拥有湿实验室。目前与 AWS 合作负责分发,在客户方面走 Chai + Boltz 的混合路线。
技术
尽管缺乏 head-to-head 数据直接对比,但从三家公开实验中,我们可以看到各家的侧重点有所不同:
•纳米抗体与小蛋白模态更像是 AI 的低垂果实,是各家开始时共同选择的方向,但仍处早期方向。
•小分子与抗体类药物目前最成熟成药最多,都有数千亿美元的规模。但可能面临 Isomophic 的竞争。
•Chai 从一开始就专注抗体领域,目前属于领先地位。
•环肽是近期较热门的新兴方向,且这个赛道目前 Latent 暂时领先。
商业化
Chai 是三家中合作最成熟、交易结构最清晰的,已经进入了大药企正式部署阶段。其特点是定制模型路线,利用制药公司的专有数据,并深入适配其工作流。Chai 已公开宣布与五家独立药企合作,且年度订单费用高达中八位数美元。根据测算,其年度订单规模可能已经高达 2 - 3 亿美元。
而 Boltz 走的是开源 + 基础设施路线,Boltz-1、Boltz-2 和 BoltzGen 形成了三家里最深的开放模型栈,产生明显的学术与产业分发。目前累计超过 500 万下载、被超过 10 万科学家和 1000 家公司使用,并覆盖前 20 的制药公司。公司已经推出 API 产品,与 Claude Science、Benchling、Phylo 等工具和平台的集成,作为其他科研平台的底层能力供应商。
在费用方面,参考 Boltz 对 BoltzMol-1 的描述,一个小分子从靶点到实验验证的初始hit,计算加实验预算约为 10,000–15,000 美元,耗时 3–8 周。收费量级相比闭源合作类型少了一到两个量级。
在商业合作方面,Boltz 获得了三家的医药公司合作订单,但跟 Chai 的模式不同的是,Boltz 并不保留平台开发产生的化合物所有权,因此更多扮演一个工具属性。
潜在范式竞争:Anthropic
Anthropic 是目前大模型公司中最看重 AI for Science 的,正通过大量科研实验和人才招聘进入生命科学领域。
在最近一次蛋白质设计实验中,Claude 根据操作手册自主查阅资料、制定设计策略,并调度专业模型生成和筛选候选分子,再由 Adaptyv Bio 和 Twist Bioscience 进行湿实验验证。
Claude 成功编排了多个开源蛋白质设计模型,生成了具有高成功率和高亲和力的结合剂。报告显示,整体结合命中率为 26.8%,15 个靶点中有 14 个获得结合分子。
这里 Claude 负责理解研究目标、选择设计策略并调度工具;具体到生成骨架、设计序列和预测复合物,仍由专有模型完成。从竞争格局看,通用模型公司与专业模型公司也可能形成上下游合作。通用 Agent 可能可以成为专业模型的分发入口。
另外,Anthropic 最近更新了一则招聘招聘企业发展负责人,主要职责为发掘并执行与 AI 原生生命科学公司的收购、投资和战略合作。说明 Anthropic 希望通过收购强化在生命科学中的地位。
05.
团队与融资
以 AlphaFold 为班底的核心团队
•Simon Kohl|创始人兼 CEO
早期在德国卡尔斯鲁厄理工学院(KIT)学习物理,随后在德国癌症研究中心与KIT开展医学影像机器学习博士研究。加入DeepMind后,是AlphaFold 2的核心研发成员之一、Nature论文同等贡献作者,参与了神经网络架构与训练开发。他还开发了广泛使用的结构置信度预测机制pLDDT,起并共同领导DeepMind的蛋白质设计团队。
•Paul F. Jaeger|Head of AI
现任 Latent Labs AI 负责人。此前在 Google DeepMind 参与面向药物研发的大语言模型研究,是 TxGemma 的关键贡献者,并参与将大语言模型用于单细胞分析的研究。更早在德国癌症研究中心完成博士研究并领导交互式机器学习团队,是医学影像分割框架 nnU-Net 的共同一作。
•Alex Bridgland|创始技术成员
曾参与 DeepMind 的 AlphaFold 1、2、3,积累了跨多代蛋白模型的研发与工程经验。他是 AlphaFold 2 Nature 论文的同等贡献作者,主要参与数据、分析与推理系统开发。加入 Latent 后,与 Simon Kohl 共同搭建最初的机器学习代码库,并参与 Latent-X 的模型架构、预训练方法及数据流程开发,是公司早期模型与工程系统的重要建设者。
•Stefan Oschmann|战略顾问
曾任德国默克集团 Merck KGaA CEO,拥有大型医药与生命科学企业的管理经验。2025 年 12 月宣布其担任 Latent Labs 战略顾问。
除此之外,团队还有两名曾在 David Baker 团队的研究人员,以及专注实验平台与内部湿实验室设计的多名科学家。
融资历程
Latent Labs 最新一轮为 2025 年 2 月 天使轮 + A 轮融资 5000 万美元。A 轮由 Radical Ventures 与 Sofinnova Partners 共同领投,早期投资方包括 8VC、Kindred Capital 和 Pillar VC。天使投资人则包括 Google 的 Jeff Dean、Transformer 论文共同作者 Aidan Gomez,以及 ElevenLabs 联合创始人兼 CEO Mati Staniszewski。
相比之下,Chai Discovery 的融资节奏最快、规模也最大。从 2024 年 9 月的约 $3,000 万种子轮起,公司在不到两年内连续完成 A、B、C 三轮融资,累计融资约 $6.3 亿。2026 年 7 月的 C 轮融资金额为 $4 亿,估值达到 $38 亿,由 Index Ventures 领投,Kleiner Perkins、Sequoia 等参与;OpenAI 和 Thrive Capital 则是其早期投资方。
Boltz 仍处于更早期阶段,于 2026 年 1 月完成 $2,800 万种子轮融资,估值为 $1.25 亿。投资方包括 Zetta Venture Partners、Amplify Partners、a16z 和 Factorial Capital,个人投资者包括 Hugging Face 联合创始人兼 CEO Clément Delangue。
 GWDC 2026 KOREA · Hackathon 全球招募开启:$100K 现金与生态资源护航,全球 Builder 齐聚首尔共建 AI × Web3Web3Labs 携手全球商业伙伴、行业媒体、社区与高校生态,面向全球 Builder 持续开放项目提交,9 月底首尔另设 48 小时线下决赛
关于GWDC
GWDC(Global Web3 Developer Conference)作为全球顶尖的技术盛会,始终致力于连接全球开发者、技术领袖与创新企业,通过深度整合产业生态,全面推动前沿技术的跨界交流与创新实践。
本届大会由 Web3Labs 主办,Techub News、Hypai Labs 及 TokenPost 联合主办,将于 9 月 28 日至 30 日在韩国首尔 aT Center 举行。大会预计吸引 8,000+ 参会嘉宾、500+ 核心开发者、近百家参展商及 100+ 投资机构,旨在共建万人级 AI × Web3 交流平台。
顶级政商及行业领袖
GWDC 2026 KOREA 已成功汇聚 “政、产、融、研” 重量级嘉宾。截至目前,韩国副总理兼财政部长具润哲(Koo Yun-cheol)、韩国国会议员闵炳德(Min Byoung-dug)、香港立法会议员吴杰庄(Johnny Ng)、亚洲经济发展委员会主席尹锡宪(Suk-hun Yoon)等政界及金融领域重要嘉宾已确认出席,共话全球数字经济发展、合规治理与技术创新。
此外,大会还将汇聚 Web3Labs CEO 黄俊瑯(Caspar Wong)、Bithumb CEO Lee Jae-won、NAVER 创始人及 Happybean Foundation 主席 Kwon Hyuk-il、TRON 创始人孙宇晨(Justin Sun)、Kakao Pay CEO Shin Won-geun、Microsoft 大中华区数字业务副总经理 Ryan Li、Animoca Brands 集团总裁 Evan Auyang、YZi Labs 管理合伙人兼负责人 Ella Zhang、Nano Labs 创始人兼董事长 Jack Kong 等行业及机构代表,共同探讨 Web3 与 AI 的融合发展及前沿技术的产业落地。
关于GWDC · Hackathon
作为大会核心环节的 GWDC 2026 KOREA·黑客松,秉承“For Builders, By Builders”的极客精神,目前已正式面向全球 Builder 开启项目招募。
本届黑客松将围绕最多 5 条生态公链展开,奖池总额将超过 $100,000 USD,截至目前,本届黑客松已获 TRON 加持,并携手全球顶级云服务商 Microsoft 提供强大的算力与云端资源支撑,全方位赋能参赛团队的开发、测试与部署。项目招募持续开放,诚邀各阶段团队踊跃参与。
此外,本届黑客松将于首尔另设 48 小时线下决赛。所有团队均可赴首尔参与现场角逐,在极限开发与优化中,与全球开发者、顶级投资人及行业领袖深度交流碰撞,并于现场见证获奖名单揭晓,解锁更多生态合作与品牌曝光机会。
一、GWDC 2026 KOREA·Hackathon 基本信息介绍
时间:2026年9月28日 - 30日
地点:首尔·aT Center
形式:线下 Coding + Demo Day
奖金:50K USD + 价值50K USD生态资源支持
二、黑客松赛程安排:48小时极限挑战
本届黑客松分为线上报名与线下现场开发及决赛两个阶段,以下时间均为韩国标准时间(KST),请参赛团队提前关注相关时间节点:
线上团队报名 8 月 25 日 – 9 月 25 日
团队自行组队及报名
线下现场阶段 9 月 28 日 17:00–20:00
黑客松现场启动
公链生态及技术负责人进行项目介绍、技术分享与生态任务交流
开发者大礼包领取
9 月 28 日 20:00 – 9 月 30 日 11:00|现场 Coding
参赛团队围绕生态挑战进行项目开发、技术优化与产品完善。
9 月 30 日 12:00 前
项目提交
9 月 30 日 15:00–17:00
Innovation Stage 项目展示 & 颁奖仪式
评审与项目展示
本届黑客松将邀请参与生态公链的 CXO、技术及生态负责人,以及行业头部 VC 担任评委,对参赛项目进行现场评审。优秀团队将获得 Innovation Stage 现场展示机会,并有机会与行业投资机构及生态伙伴进行深入交流,拓展后续投资与生态合作机会。
三、参赛权益与生态支持
· $50K USD 现金奖励 + $50K USD 生态资源支持
优胜项目可获得最高 $50,000 USD 现金奖励及价值最高 $50,000 USD 的生态资源支持。
· Microsoft Azure Credits 支持
符合条件的项目可获得 Microsoft 最长 6 个月的免费云服务 Credits,为项目开发、测试及部署提供云端资源支持。
· Web3Labs 全球加速机会
获胜项目将优先进入 Web3Labs 2026 全球加速计划及孵化项目储备库,获得后续项目发展与生态支持机会。
· 行业资源与投资对接
与行业资深从业者、头部企业及一线 VC 进行交流,拓展投资、生态合作及行业资源。
· 全球媒体与市场曝光
优胜项目将获得持续的媒体报道与市场推广支持,通过全球媒体及社区渠道提升项目曝光度与行业影响力。
四、GWDC 2026 KOREA Hackathon 参赛要求
· GitHub 开源代码仓库:参赛项目须提交可公开访问的 GitHub 代码仓库。
· Demo 视频:须提交项目 Demo 视频,时长不超过 3 分钟。
· Pitch Deck:提交完整项目介绍及 Pitch Deck。
· 现场展示:入围决赛的团队须在 Innovation Stage 进行项目现场展示。
· 团队规模:每支参赛团队最多 5 人。
参赛团队可根据自身情况选择线上参与或前往首尔参加现场环节。最终项目提交须包含以上全部材料,并按照赛事时间节点完成提交。
五、GWDC 2026 KOREA · Hackathon 报名通道
黑客松详情及赛道:www.gwdc.net/hackathon.html
开发者报名:https://forms.gle/vQRpYf9T7mwZBEPX9
官方 TG 社群:https://t.me/GWDC_Global
请选择您团队的报名通道,如未加入合作高校/社区通道,可选择其他。具体赛道与任务详情将于 9 月中旬公布。
全球矩阵伙伴与协作网络
目前,GWDC 2026 KOREA 已联动全球多地的头部行业品牌、媒体、AI 与 Web3 社区,以及知名高校链协。通过品牌资源共建、媒体矩阵报道、社区联合传播及高校生态资源整合,为本次万人级大会及黑客松赛事提供全方位的宣发支持与全球推广网络。
技术创新不止于代码,更在于将新的想法真正带入现实。GWDC 2026 KOREA Hackathon 希望为全球 Builder 提供一个开放的创作与交流平台,让更多创新想法被看见、被实践,并连接更多真实的应用场景。
期待与全球 Builder 相聚首尔,用代码,让世界重新有趣。
 Bitroot 亮相 Bitcoin Asia 2026,并携手 Web3Labs 联合主办 “TO THE MOON” 高端社交之夜这条并行 EVM AI Layer-1 公链将其 10万+ TPS 基础设施与主网路线图带到香港,登上主舞台参与专题讨论,并携手合作伙伴 Web3Labs 汇聚机构资本与建设者。
中国香港,2026年8月28日 —— 面向高吞吐、低延迟应用打造的并行 EVM AI Layer-1 公链 Bitroot,在 Bitcoin Asia 2026(8月27日至28日,香港会议展览中心)上精彩亮相:登上主舞台参与专题讨论,并与本届盛会合作伙伴 Web3Labs 联合主办高端社交活动。
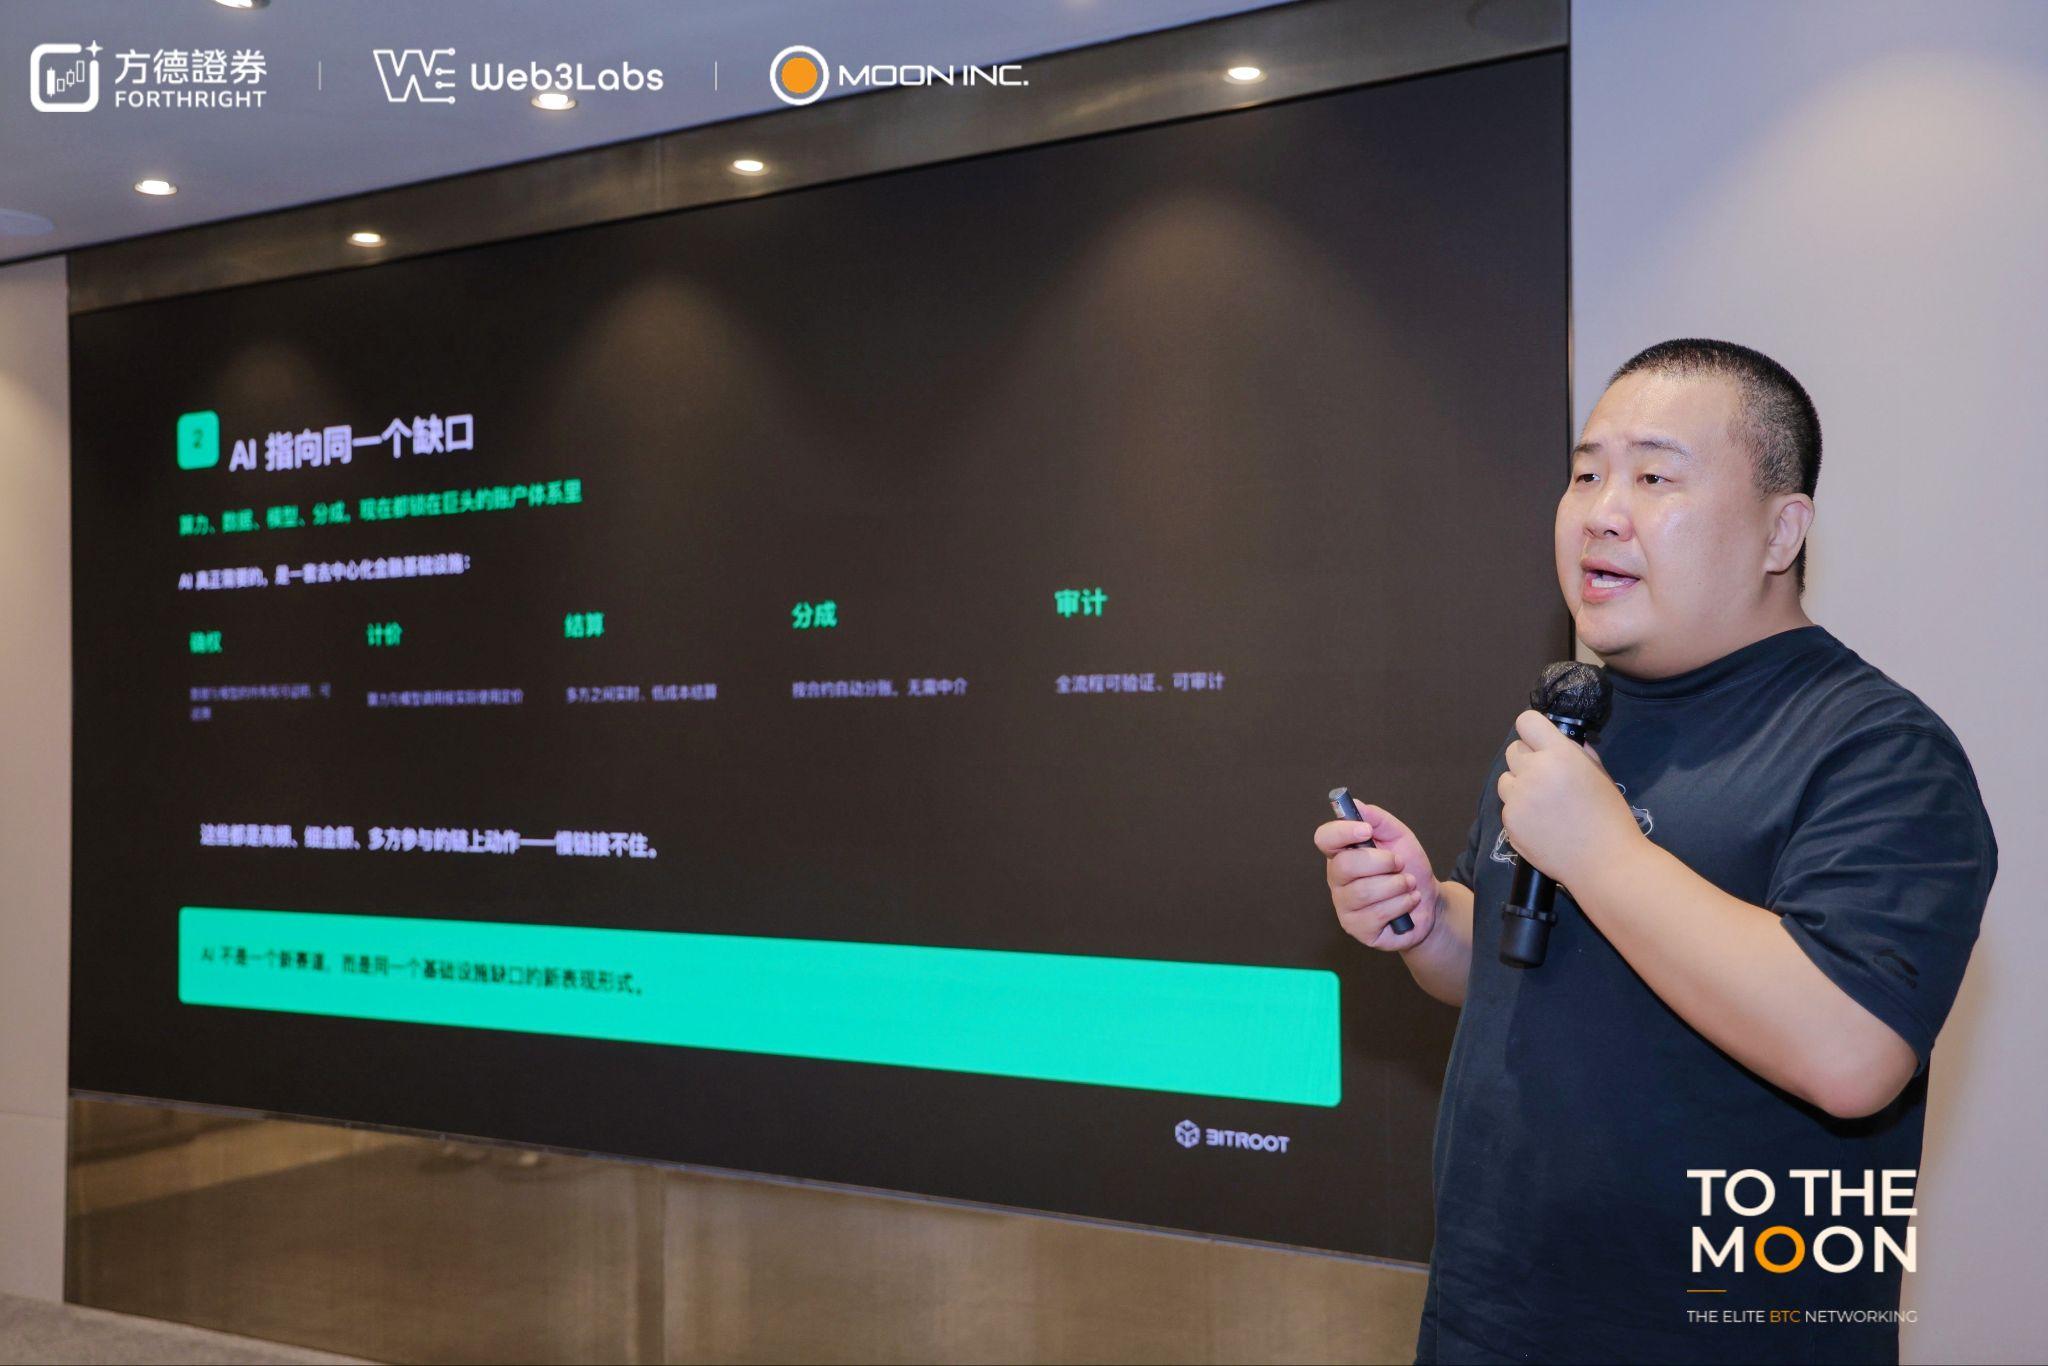
8月27日,Bitroot 首席战略官 Jerry Jiang 作为嘉宾登上 Genesis 主舞台,阐述高性能 Layer-1 基础设施如何成为 AI 原生应用与真实世界资产(RWA)应用的底层支撑。在这些场景中,交易规模对吞吐量与最终性的要求,往往超出通用型公链的承载能力。
8月28日晚,Bitroot 与 Web3Labs 于香港中环 The Centrium 联合主办 “TO THE MOON: THE ELITE BTC NETWORKING” 精英社交之夜。此次仅限受邀出席的活动汇聚了机构资本、加密巨鲸与行业领袖,营造高质量、精准对接的社交氛围,Jerry Jiang 代表 Bitroot 发表致辞。
Bitroot 携强劲发展势头来到香港。在完成核心架构的彻底重构后,其网络通过并行 EVM 执行、Pipeline BFT 共识与 BLS 签名,实现 10万+ TPS 与 0.3 秒最终性。其测试网现已突破 30 万地址,BRT 质押量超过 1 亿枚,项目正稳步迈向主网上线。
Bitroot 首席战略官 Jerry Jiang 表示:“Bitcoin Asia 汇聚了正在塑造行业下一阶段的建设者、投资者与合作伙伴。我们很自豪能在舞台上分享对高性能基础设施的愿景,并与深谙‘优质连接源于合适场域’的伙伴 Web3Labs 共同主办 TO THE MOON。”
Bitroot 谨向 Web3Labs 在本届盛会期间的出色合作致以诚挚感谢。
关于 Bitroot
Bitroot 是一条并行 EVM AI Layer-1 公链,具备 10万+ TPS 与 0.3 秒最终性,专为 AI 与机器经济而打造。项目已完成 100 万美元种子轮融资,拥有 50 位大使与 90+ 生态合作伙伴,测试网现已上线(30 万+ 地址),并配备原生 DEX 与跨链桥,正迈向主网。了解更多:bitroot.co,X 平台 @Bitroot_。
关于 Web3Labs
Web3Labs 是一家总部位于香港的 Web3 生态建设机构,亦为 Bitcoin Asia 的合作伙伴。
媒体联系
Jerry Yu,Bitroot · JerryY@bitroot.co
 一个实习生带一个团队,一家创业公司的人才实验“即便是天才,第一声啼哭也不会是美妙的歌声。”
文丨司雯雯
编辑丨赵磊
AI 竞争中,巨头和创业公司都前所未有地重视人才,也比过去都追求高效:薪水越高、耐心越少,这些聪明的年轻人最好不用培养、不必试错,来了就能解决问题。
一些年轻人不想做极致效率机器的一部分。他们更向往的环境是公司鼓励创新、有探索空间,个人的创新也能有助于公司。
面壁智能联合创始人刘知远相信,只要找到平衡点,这两者就能共存。他在清华大学任教十多年,2021 年参与智源研究院的大模型项目 “悟道”、训练千亿参数大模型,在一线研究 AI 的驱动中创业、成立面壁智能。一年后,和大多数公司对超大模型的追求不同,选择走差异化的端侧 AI 路线。最初不被看好,但等更多公司注意到端侧 AI 的应用和商业潜力时,面壁智能已经是走得最快的那个。
他说自己也不是小天才,面壁智能的发展得益于一个目标一致、互相鼓励、敢于信任的组织。做端侧 AI 的选择也让面壁智能避开最激烈的战场,在大厂拼数据、人力、算力时,把 “培养人” 当作一种组织能力。
面壁智能特意在公司保留 Frontier Lab 的气氛,从技术负责人到研究员、实习生以 “传帮带” 方式培养人,给实习生一定时间做前沿探索。这项人才计划命名为 “前进四”,在《三体》中意指 “全速前进”。
“我创业的一部分动力就是站在最前沿培养人。” 多年教职让刘知远有一种 “教师” 气质,总是笑得很随和,“优秀的人也要给足够多的机会,阳光充分了肯定可以灿烂”,他加重语气,“就算是天才,也不可能生下来第一声啼哭就是一首美妙的诗歌嘛。”
资源有限,更要培养人
面壁智能前沿探索方向 AI4AI 的核心骨干之一,是名实习生。李奇看起来很年轻,明年博士毕业,去年才加入面壁智能。他带领的团队几十人,是专门负责前沿方向的智能进化实验室里人数最多的一组。接近一半是正职研究员,比他在面壁智能更久、经验更多。
他当然符合一个优秀实习生的标准:拿过全国物理竞赛金牌,本科保送清华姚班,博士在清华念自动化专业。但大公司会认为这有些冒险:实习生毕竟青涩,也被认为不太稳定。他们更习惯用有些管理经验的人或在知名公司待过的人带团队。
“AI 就是要探索、要试错的领域。” 一位面壁智能的管理层反问,“谁一开始就是专家?”
加入面壁智能前半年,李奇在 AI Infra 团队尝试过几个方向,最感兴趣的是 AI4AI——用 AI 研究、训练、评估和改进 AI,让 AI 能自我迭代,这可能会打破人类数据、算力供给有限对 AI 能力的限制, AI 研发将以指数级速度加快。但当时觉得路线不够明确、时机还不成熟,直到 2026 年 2 月 Claude Opus 4.6 发布,展现了 AI 独立完成复杂研发任务的能力。
“这个故事好像能往前推了!” 智能进化实验室负责人李宇轩对李奇说,“试一试吧”。李宇轩也才 31 岁,明白年轻人的冲劲需要被鼓励。
他们先从 Infra 环节开始测试 ,几个人分头花了一个月,验证了 AI 可以在 Infra 环节辅助研发,比如编写代码、调试、清洗数据。面壁智能决定给李奇更多时间、队员和资源,李奇和几位研究员开始全力投入 AI4AI,两个多月后,在实习生主导下,他们做出了一套完全由 AI 编写、没有人类参与的大模型预训练框架 ForgeTrain。在英伟达 H100 上,训练速度比大多数大厂和创业公司应用的主流框架 Megatron 约快 10%。
项目发布后,AI Infra 部门升级成智能进化实验室,李奇自然成了 AI4AI 方向的负责人。刘知远预计,半年到一年,AI4AI 就会进入工程化阶段、实际影响模型生产,只有少数公司能抓住机会。
这项任命没什么讨论的过程,“能力强,大家都看得见”,也没定具体的 KPI。
“前进四” 人才计划的目标之一是将这种 “氛围” 变成更稳固、更可解释的培养制度。2025 年,DeepSeek 爆火让行业意识到少数人能创造巨大收益,大厂、创业公司都开始高薪抢人。韩旭发现,面壁智能几乎所有岗位招人都很难,来面试的不少,但拿到 offer 后,大厂也会加价。刚成立时,面壁智能和大厂拼薪水不现实,“钱没有别人多,还要硬碰硬?如果只靠高薪,招到的人也不见得对我们很认可”。
一些大公司习惯筛选而不培养,追求极致效率,来了就能干活、不需要时迅速裁掉冗余人力,为此愿意花更高薪水。这可能是面壁智能的机会,首席研究员韩旭总结为 “从培养人的角度,来解决人才紧缺的问题”。
他和刘知远等负责人讨论,决定从实习生入手,设立 “前进四” 人才计划。如果相信端侧 AI 是长坡厚雪,要做五年、十年、几十年,那该有耐心建立人才梯队,通过在实践中培养人,来提高团队能力。
“我们是中国最善于培养 AI 人才的团队之一,为什么不发挥这个优势呢?我们可以让实习生在面壁智能变得优秀。” 从做助理研究员时算,刘知远在清华任教 13 年,是中国最早一批 NLP 研究员,培养了大量学生,“我们不要求实习生有经验、立刻能做事,也不谋求未来一定留在面壁智能。说实话,如果能培养出特别优秀的人,那也是为国家做贡献。再说未来几十年,总有其他机会合作。”
他们明确,“前进四” 人才计划要让实习生感受到认可,一部分最优秀的实习生会在毕业前就获得期权等激励;让实习生在核心项目中参与核心工作、独立负责项目,而不只是做基础、重复性工作;给实习生更多的资源支持,让研发成果更快应用到公司产品中。
面试前,李奇没有做过 AI4AI 相关的研究,他和面试官讨论更多的是如何理解 AI、怎么用 AI 解决问题,以及解决问题的逻辑性和自主性。另一名 “前进四” 人才计划的实习生本科在一所双非院校,参加超算比赛时遇到面壁智能团队,课题相似,他就给刘知远写了一封邮件,讲自己对大模型有多感兴趣。
对方很快回复。一轮技术面试后,他在面壁智能只有 9 人时加入,开始做文本大模型的 Infra。
在文本大模型 Infra 业务工作了两年多后,这名 “前进四” 实习生感到成长空间变小了,很多工作变得重复。他做了一些调研,直接告诉韩旭,想从文本转向 Omni (全模态)。韩旭很快帮他联系了几位资深研究员,先聊聊看是否真的感兴趣,如果确定了,“没问题,直接开搞”。他转述韩旭的答案,说自己讲这话前没有多想,因为相信韩旭会接受他的想法、根据他的兴趣去匹配。他有时会觉得自己更像在面壁智能的学生,而不是员工。
“公司培养了人,人家也帮公司做了事,咱们都不亏。” 韩旭说。一些实习生想去大厂或者转做学术,他会帮忙推荐、对接资源,“如果实习生能在另一家公司做到很高位置,至少证明我们的培养很成功。”
这一方面和 “前进四” 人才计划的定位有关,实习生本身就是一家商业公司中最灵活的一群人,尚未毕业、选择空间大,相对正职研究员不必承担 KPI 压力、不用为商业化负责。能入选的也是少数极有潜力的实习生,公司也希望他们在被鼓励的环境中探索、创新。另一方面,DeepSeek 靠许多应届生和实习生做出了世界级的成果,让 AI 公司看到了优秀人才聚集产生的巨大效益,大家都想增强对人才的吸引力,塑造更好的雇主品牌。
5 月底,李奇主导的 ForgeTrain 项目发布并开源,参与项目的实习生接到了一些大厂头部人才计划的邀请,面壁智能也收到了许多封实习简历,其中大部分提到 ForgeTrain 项目——“如果愿意让实习生做一件不知道是否正确、何时能成功、但创新性的事,代表它一定有些理想”,李奇说,想要创新的人会被鼓励创新、愿意培养的组织吸引。
像 Frontier Lab 一样做创新
面壁智能要做成立来最艰难的一次决策时,刘知远带着公司 20 多人一起在办公室读《论持久战》。2022 年底,GPT-3.5 的发布让投资人和创业者看到大模型公司的潜力,AI 六小龙估值高涨,面壁智能团队虽然也做出了千亿参数的基础模型,市场热情却不高。
眼前有两条路,继续做更大参数比如 140B 的大模型,投入上亿、争取成为下一个 OpenAI?还是不再追求超大模型,转向端侧 AI?
刘知远从《论持久战》中学到的是,越弱小、面对越强大的敌人,越要主动寻找战机,在局部战场形成绝对优势——那么创业公司和大厂拼谁更能烧出更大的模型,就是以弱对强。当时他判断,半年后,至少七八家厂商都能训出 GPT-4 水平的模型,接下来就是价格战。面壁智能的优势不在于拼资源。
“在大公司的射程内,必死无疑”,在那间办公室里,在场所有人讲了自己的看法,最终达成共识,做差异化的端侧 AI。2024 年下半年,他们提出 Densing Law of LLM(密度定律):大模型达到特定智能水平所需的参数量每 3.5 个月下降一半,后发表在 《Nature》子刊。
面壁智能的核心产品 MiniCPM 端侧大模型等都基于这一技术判断。2024 年后,他们逐渐受到投资人和市场认可,“因为大家开始相信我们可以靠技术创新驱动”。
“组织密度是创新的基础。区别在于,结果不好时是一起想主意,还是互相甩锅?大家要集团化作战,数据、模型、 Infra 团队有共同目标,就会意识到每个人都对最终结果至关重要。” 刘知远举例,一家公司做大模型时,参与者超过 2000 人,但 DeepSeek 只有 100 多人就做出了效果更领先的 R1。刘知远和韩旭讨论过 DeepSeek 的组织特质,结论是组织高效、内耗少、有奔头、信念统一。
他解释,AI 公司的核心是成体系地训出领先模型,其中,模型架构、强化学习等单点需要深入研究、用创新方法加速,这都是很好的前沿课题。如果研究生不参与到具体生产中,只是闷在学校发论文,既缺少训练资源,也会离一线越来越远,一年几万篇论文,很少有人看、也没有实际作用。
而公司技术体系的单点如果没有持续创新,也会丧失竞争力,如果不实现产学研闭环,很难做最前沿的 AI ,“人培养得好、创新得好,面壁智能会发展得更好。反过来也是。”
他们把面壁智能定位成 Frontier Lab 和商业公司的混合体。比如,实习生大多在一间公司半年或一年,如果团队有大调整,研究课题可能很难继续。刘知远说,他们会尽量构建一个长期稳定的环境,让实习生安心研究。
在面壁智能几年后,一名 “前进四” 人才计划的实习生开始负责多模态模型的部分研发,有权限招人、带人。他说,公司并没有限制名额,但他和负责人讨论后,定了一条规则:先想明白新同事最近 3 到 6 个月明确能做什么、未来一到两年可能会做什么——核心是如何让每个人有足够发挥的空间。
模型厂商竞争激烈,版本更新时间不断压缩,很多公司无暇考虑这些。公司发展和个人成长之间并不总是匹配。但这名实习生在面壁智能初创时加入,做过多模态的预训练、后训练、模型发布、开源维护,能接触到的技术范围足够大,他形容团队氛围是做好 80% 确定性的事、有明确的回报,同时探索 20% 的不确定性,用非共识的解法找到优势。
“如果新同事进来只能做基础的、想象空间很窄的事情,对他不好,对团队氛围也不好。效率真的能高吗?” 他希望团队还是充分论证、克制招人。
一名实习生起初没想到,他自己的论文课题,研究如何将 1B 的稠密模型变稀疏,一开始没人知道成功概率有多大,公司还是给了许多算力支持。等在模型上验证后,他告诉刘知远这个好消息,一个月后,自己的实验项目就应用在了公司的产品上。
这也是他在面壁智能影响力最大的项目。“很快,非常快!” 公司有可能不支持实习生的实验,或者即便实验成功了,也要花几个月去验证。这可能才是常态。成果发布后,他入选了 “前进四” 人才计划,也在面壁智能参与了更核心的工作——当然,他的创新也让面壁智能受益。
AI 公司的特性是从前沿问题或还没有被完全验证的研究方向开始,不只是把已有技术产品化,而是把过去 “不可能” 的事推进到 “可能”,再把 “可能” 变成真实价值。这让创新和商业效益之间转换更快,产学研以更短周期闭环。但创新氛围能否维持,考验创始人的意志、团队价值观和长期的耐心与决心。
从 “千里马” 到培养 “伯乐”
韩旭不觉得在面壁智能和在清华带学生有什么不同。“都是希望培养一批人、一起战斗、把事做成。” 他想了一会儿,“区别可能是,一个锤子敲不了太多钉子,在公司是更多的锤子敲钉子”。
他一直想做老师,教书育人、桃李满天下。这有些受导师刘知远影响。创业四年多,从一家不到 10 人的公司发展到 400 多人、准备上市,刘知远认为面壁智能的使命是把前沿技术转换为商业成功,但他个人的第一使命还是培养人。
很多面壁智能员工习惯称呼刘知远 “刘导”,不仅因为他在清华大学任教十几年,也因为他还保留着辅导员对学生的待人习惯。实习生李奇有时在公司遇到刘知远,很少聊技术细节,会聊聊实习感受、未来规划。
他说自己就是 “被培养” 的受益者:从山东考进清华时,自己没科研论文、没竞赛经验、成绩也不突出,只是 “nobody”,起初觉得能顺利毕业就不错了。但在导师孙茂松帮助下,一步步走下来,拿到优秀博士论文、做科研,是被伯乐培养出的 “千里马”。读研时,他也看到一些本科生刚开始不太适应,但只要耐心教导,两三年后,焕然一新。
“所以千里马常有,而伯乐不常有。” 做导师、创业后,他有时看到一些年轻人最初表现不好,会想他们都比当年的自己牛,以后没道理不比他现在牛,“那我一定要努力让他们也很牛”。他希望自己和面壁智能的技术负责人们做 “伯乐”,把实习生培养为 “千里马”,然后 “千里马” 继续做下一代 “伯乐”。
这种善意在面壁智能逐渐向下传导,自然形成了一种氛围。
韩旭认可 Google DeepMind 研究科学家姚顺宇的观点,AI 个人英雄主义的时代已经过去,在集体中最重要的特质是靠谱、对做事负责任,“作为搞技术的,要是迷信小天才,那就有鬼了”。他更看重候选人是否对 AI 有长期思考、和团队是否契合。
实习生们有时会和韩旭请教租房经验,一些与公司关系不大的学术研究题目,对方也愿意给建议、介绍更相关的研究人员认识。他如今 2/3 的时间花在培养相关的事情上,“很多时候,一大早刚起床,一打开手机微信,全是 ‘坏消息’”。但他觉得也是好事,“大家真的有问题会来找我”。
“你看到别人怎么帮你,也就愿意怎么帮其他人。” 很多实习生说,他们很难解释为什么不需要制度约束,“也许只是将心比心”。
一位实习生接到了几家大厂的邀约,留在面壁智能的原因之一是在这里找到了职业生涯上的参照对象,技术牛、愿意带新人——“公司有资源是一回事,但资源不会自动转化为能力,关键是传帮带”。他最初来公司,看着那位技术负责人怎么做实验、实验失败时怎么分析归因、成功怎么归纳沉淀,“就像强化学习和监督学习一样”,从一个 bug 如何解决到一套实验方法论,有了经验后,现在新的实习生进来,他变成了传帮带的那个角色。
像他这样想的实习生不是少数。一位 “前进四” 人才计划的实习生希望,他带的一名新实习生可以自主负责一个 RL Infra 开源项目,他帮忙定好目标、流程,由对方实操。这个项目本身和面壁智能业务没有太直接的关系,但他面试时就承诺会支持对方探索,因为他也是被这样对待的。
前段时间,李奇发现一些新进实习生适应得不太好。他和业务负责人反思,既然过了面试,就代表有潜力。为什么潜力没有发挥出来?他们筛查后认为,新人指引做得不够好,目标是什么、看哪些文档、用什么代码工具等没有体系化。他和几位技术负责人花时间做了一份详细文档,既有技术理念等,也有工位分布图等细节。
这种帮助也会被体系认可。面壁智能实行员工互评,一些同事会在评价中明确信息沟通、帮助他人也是产出。每月办一次 TGIF 全员会,刘知远等会讲最近进展和未来规划,会上还有一个 “伙伴文化” 环节:谁帮助了你,可以公开感谢他。
这与刘知远的用人观有关。他不觉得从大厂挖几个知名研究员就能解决问题,相信从内部培养,由应届生、实习生留任,成长为技术骨干。他曾在社交平台上分享过一段话:如果你让他掌握了一些知识、建立了一些自信、找到了一个让他发自内心幸福的目标,那么人的潜力一旦迸发,力量会非常非常大。
如果培养好的实习生想离开呢?一名实习生不久前和刘知远聊过这个问题,他得到的建议是,在面壁智能先积累几年经验和物质条件,无论创业、去其他公司还是搞学术,然后选最适合的路、做到顶尖水平。
保持士气靠不断打胜仗
一位面壁智能的研究员渐渐觉得效率变低了。以前,他和技术负责人隔条过道,公司一共几十人,有什么事马上沟通。现在公司扩张到 400 多人,工位分了几层楼,开会时间变长,会议室有时约不上。有人也感觉到公司业务重心的变化。刘知远过去强调模型要 SOTA,今年更多讲下载量,也写进了一些研究员的 KPI 中。
当公司变大、规模扩张、商业化任务更重,组织效率和价值观都会逐渐在理解、传递上遇到挑战。刘知远听到过一些讨论,“我们还是要实事求是。模型公司都讲创新,怎么评估效果?那就看谁更能满足用户需求”。去年年中,团队一度因为文本模型效果不及预期而低落。顺着每个环节排查,发现数据、评测等基础设施不够扎实。他们花了大半年时间补短板,解决工程问题不如技术创新令人激动,但是商业组织无法回避。
面壁智能几个实验室的研发人员都有三四十人,这基本是刘知远认为一位技术负责人高效沟通的边界。他最近和韩旭等负责人讨论,如何用 AI Native 的方式保持组织的高效?
他们不希望用传统写日报、周报的方式,这可能只增加负担、对效率无益,“解决的是领导的不安全感”。韩旭从一些非商业组织中学到用技术化的手段控制人员规模,降低管理成本,反而增强战斗力。最近,面壁智能开始推行用 AI 简化流程,鼓励研究员们开发各类 Agent,用于跑实验、基础分析。AI4AI 方向的研究成果 ForgeTrain 也已进入生产流程,开始优化模型训练、部署等环节,承担一部分重复性工作。
面壁智能每个业务板块内也在探索。多模态模型研发团队最近一年约翻了一倍,一位技术负责人发现,开会时间变长、人数也越来越多,许多同事参会只是为了同步信息。他尝试用 “树杈” 结构调整开会方式:关注相似问题的人开一个会,每个方向出一个代表去更大的范围交换信息。一些会议从几十人压缩到 10 人,一周只需要参加一个会。
另一条解决思路是,让各位技术负责人补强管理。当优秀年轻人逐渐增多后,公司开始遇到一些新问题:几位优秀实习生或研究员一个小组,人人都很好,但就是合不来,很难协作。
“那不能泛泛地喊口号 ‘大家要团结啊’,没人听得进去。” 他在公司管理中总结经验,“在一家产研结合的公司做模型,像发射火箭,要有准确的里程碑估算、稳定推进,做好工程,又要做充满不确定性的前沿探索。” 他对组织内的利他主义传统有信心,只是 “很复杂,需要学习”。
最近,他准备组织技术负责人们上领导力课程,学学管理,小到一个实习生怎么带动两三个人,大到一个组织如何进化,让每个方向的负责人有动力、有能力把团队带好。
创业四年多,他体会到每个阶段都有挑战:起初技术理念难被投资方认可,现在要想如何保持技术优势、并转化为可持续的规模化的收入。面壁智能的商业化落地目前主要在汽车、手机等行业,也是一部分大模型厂商从云端进入端侧的首选,这不只考验技术能力,也考验工程适配、合规经验、产业资源和合作方的意愿。
竞争正在变得激烈。他对面壁智能的规划是,未来三年,实现通用 AI 端侧模型的完全态,具备感知、计算和行动能力,实现软硬协同。
这个过程中,团队也会随之扩张。刘知远和韩旭认为,从根本上讲,保持组织战斗力最好的方式是不断地打胜仗。
一些公司可以沿 Scaling Law 扩大算力、数据量,用工程化方式解决问题,一些公司在产业生态、资源上有优势,但面壁智能这类创业公司最重要的发展就来自创新。2023 年、2024 年 Densing Law 的发现和应用让投资人看到,除了做超大模型,通过优化算法、数据和架构的端侧模型可以降低推理成本并保证效果,就可以在手机、汽车等终端大规模应用;提前探索 AI4AI 的 ForgeTrain 项目证明了 AI 在模型生产上的能力,也许用户可以根据模型、芯片和训练任务的不同,采用更有效率的训练框架,在英伟达 CUDA 的软件生态外做尝试。
最近一年,一位 “前进四” 人才计划的实习生和团队一起研发 Omni-Flow 流式全模态框架,把用户和 AI 的交流模式从半双工(一问一答)改进为全双工(并行交流、可随时响应或插话)。“去一家大公司用几千张、几万张卡训超大模型,听起来很厉害,但如果训练方式和目标都是参照另一家大公司,那也并不令人激动。” 他享受于探索少有人验证的技术路线。
这也是刘知远对创业最初的预期,“大家一起在 AI 时代把不可能的事做成,又能站在最前线培养人,这不是最美妙的事情吗?”
 对话混沌|让未来提早到来:初心与宇树的9年同行2026年8月19日,宇树科技在上交所科创板正式敲钟上市,成为A股 “具身智能第一股”,创始人王兴兴也成为了新晋“90后首富”。
作为宇树的早期投资方,混沌学园校友企业初心资本对应回报倍数超700倍。
但是,在2017年,初心资本管理合伙人、混沌学园1期校友田江川第一次见到王兴兴时,并没有决定投资。而是在3年后才“重新投资”。
《混沌校友Talk》01期,来看看她的真诚复盘:错误、思考和成长。
以下为视频内容的文字转录:
我自己觉得,很多人在AI时代会非常非常焦虑。但我自己摆脱焦虑,也有我自己的一些方法论。
我特别喜欢一首歌叫《望远镜》。我觉得它让我觉得,人生很重要的一个能力,就是调焦的能力。当我每次 zoom in(放大)到很小的颗粒度去做工的时候,比如说我今天排了几个会,都是我非常认可的创始人,可能我跟他们能聊两三个小时,我都觉得时间是静止的。这个也是我为什么很喜欢早期投资的原因。
错过宇树“天使轮”
首先就回到2017年的我吧。那个时候我其实非常勤奋,我觉得那个阶段,不夸张地讲,我每天可能要见七八个项目,排得非常满。
那个时候我早上起来也会看很多科技媒体。当时在一个科技媒体上看到了一篇报道,我还以为是一篇 Boston Dynamics(波士顿动力)的报道,我也比较关注。
点进去以后发现是一个中国创业者,他做了一款产品。那款产品其实是非常颠覆性的。它的颠覆体现在,首先它的价格可能是 Boston Dynamics 的十分之一都不止,是一个非常低廉的价格;同时,它采取了一个非常不同的技术路径。
再回溯到2020年在混沌的课程,当时善友教授跟我们讲:当你发现一个要素发生了10倍的变量时,它一定是个非常重要的信号。所以那个时候,肯定是有这样一个信号摆在我面前。
为什么没投?我觉得,可能源于自己的背景,自己会有一些局限性。总结得朴素一点,确实是有一些比较精英主义的傲慢在里面。
实话实说,如果兴兴当年是清华大学的、北京大学的、浙江大学的,那肯定就非常容易融资。因为他已经通过产品,在一定程度上证明自己了。
我觉得,这个学历的选拔系统对精英是非常有效的,但对创业者未必那么有效。这个也是我自己交的一些学费。
与宇树再次“结缘”
我觉得我们做得比较好的一点就在于,事后我们会再回溯,也重塑了整个初心的投资体系和价值观。
当时俞扬教授(南京大学人工智能学院教授、博士生导师)说:“我们实验室最近有一个项目,我觉得你们应该看看。”我说是哪个项目?他说是宇树科技。
我说这个项目我们之前看过。他又说,这个项目已经“一狗难求”了。因为他们实验室做非常多的研究,都需要用到宇树的狗。
而且他也跟我讲,宇树在国际上也非常有影响力。所以那个时候,俞扬教授的这些信息就触发了我们重新去联系兴兴(宇树科技创始人)。正好又遇到了一个比较好的窗口,所以马上合作上了。而且碰巧那一轮的估值其实也挺便宜的。
我之后也反思过这个问题。很核心的一点在于,首先,我们确实不是宇树的典型用户。对投资人来讲,你的选择就是你的认知的折射。
我觉得很重要的一点,也是我自己的一个朴素的投资理念:很多事情不能靠逻辑,你得去感受。我自己的感受就是,如果靠逻辑,特别是不走出办公室的情况下,你是很容易做误判的。
所以从2021年开始,我们基金团队基本上每年都会去硅谷。当时也跑了像 MIT (麻省理工学院)的 lab(实验室)、Berkeley(加州大学伯克利分校) 的 lab、Stanford(斯坦福大学)的 lab,也去了一些比如地平线的研究院等等,里面全部都是宇树的狗。
我当时也会跟非常多的斯坦福的 PhD(博士)进行交流。很多 PhD 都非常感谢我们投了宇树,因为那时候宇树其实在资本上还没有那么受追捧。但大家都会讲,如果没有宇树的狗,他这个 PhD 肯定毕业不了。他所有的研究,其实都是基于宇树的硬件。
对兴兴来讲,他作为一个90后,正好出生在中国这片土地上。中国的供应链经由了几代产业的变革,变得非常成熟。所有的创业者都在受益于这样的基础设施。
当然,也跟他采取的技术路径有关,这个也是兴兴原创的巧思。因为这个技术路径,可能他量产更稳定了,同时成本也更低了。当一个成本优势是竞争对手的10倍时,你就可以做非常多的花活,也可以有非常高的容错。
最后一点,我觉得还是回归到兴兴这个人,因为他确实是一个非常极致的创业者。这体现在他的产品上、硬件上、架构上、营销策略上,他是一个非常非常极致的创业者。
我们陪伴了他9年的时间,他的故事一点包装的色彩都没有,当年就是这么地难,就是融不到资,就是每一分钱都要掰成两分钱用,就是一个人要承担很多个角色。
宇树带给我的“成长”
我今天很感谢兴兴,他对我的人生非常非常重要。不论是让我的投资观变得更健全,让我们的团队变得更有向心力,还是让我们这个机构更好地去跟这个时代共鸣,也更好地理解了什么叫时代企业、什么叫时代CEO。
但是我也很希望接下来,因为我还很年轻,我觉得我还有很长的路要走。
我之前有一个很优秀的同事,他想要离开这个行业,因为他觉得有点看不到头。他跟我有一个对话。他说:“现在这个行业这么难,我觉得您应该把这个团队给解散了。”我就说:“那这些同事怎么办呢?”我们那个同事来了一句:“每个人都应该对自己负责,可能解散了对他们更好。”
回头去看,2022年的那个时候,行业其实非常迷茫。一方面有中美脱钩的背景,一方面又有疫情,一方面又面临着整个局势——你想,当年大家都还在隔离的状态。所以我觉得,那一刻如果没有很强的心力,很多人是熬不过来的。
混沌与田江川
我老公说,我上完混沌以后,发生了脱胎换骨的变化。
我觉得,一方面是善友老师的课,非常结构化。因为对于投资人来讲,时间非常碎片。但善友老师通过他自己的讲解,可以把知识和结构种到你心里。
包括我后来做投资这么多年,比如说看到某一个信号,我就想起善友老师讲的那个:“这个信号都已经这么强了,上帝都叩你的门了,难道你没看到吗?”
班里的同学,有三个对我影响最大的人。
一个是石头科技的昌敬,我觉得他的思维框架非常优美且高维。
我跟富途的 Rachel(李镭,富途联合创始人)关系也很好,我觉得她作为一个女性创业者,她的那种爱、责任和魄力,也是我的榜样。
还有一个人让我印象特别深:Alex(周志峰,启明创投主管合伙人)在整个混沌课程当中的变化。因为他跟我说他找到那个使命的过程,我又很幸运地作为他的 Buddy,是一个见证者。那一刻对我来讲也非常震撼。
我特别记得有一年,我们基金复盘会的分享主题就是“无变化,不VC”。我深刻地理解了这个VC行业存在的本质,就是因为外界环境有变化。所以我觉得,对我们VC这个行业来讲,本身就应该非常拥抱变化,因为变化就是我们的立身之本,这个东西是时刻在变的。
但我觉得这些对初心资本来讲都是不变的:和与众不同的你同行,拥抱指数级的增长,让未来提前到来。
还有一个不变的是,我就是初心的一部分,初心就是我的一部分。我觉得这个是永远不会变的。
混沌学园:回看刚刚创业的自己,你会对自己说什么?
我想说,你起了一个好名字。首先你起它的时候,它就是你内心的一个折射。其次,未来你的创业之路一定是长且阻的。这个过程当中,如果能回望那颗初心,找回那份心力,就有点像今天就算你被掏干了,它永远是你的充电宝,就是那种感觉。
 OpenAI 前 CTO Mira Murati(米拉·穆拉蒂):AI 竞赛中的沉默操盘手撰文:Techub News 整理
导语
2023年11月,OpenAI董事会的一场“政变”震惊了整个科技界:创始人兼CEO Sam Altman(萨姆·奥尔特曼)被突然解职。在这场风暴的中心,除了首席科学家Ilya Sutskever,还有一个关键而低调的身影——时任CTO的Mira Murati(米拉·穆拉蒂)。她被董事会火线任命为临时CEO,又在短短72小时后,与回归的Altman看似和解。这段经历只是这位阿尔巴尼亚裔技术天才波澜壮阔生涯的冰山一角。从特斯拉Model X的产品经理,到OpenAI的CTO并主导了ChatGPT的发布,再到2025年创立并获得史上最大规模种子轮融资的Thinking Machines Lab,Mira Murati始终是AI革命浪潮中的核心参与者,却极少站在聚光灯下。本期内容源自播客《In The Blink of AI》的全新系列“AI Icons”,旨在深度挖掘这位“AI竞赛中的沉默操盘手”的真实故事。
摘要
Mira Murati 是 OpenAI 早期核心成员及前 CTO,是 ChatGPT 发布与成功背后的关键工程与产品推手。
她在 2023 年 OpenAI 董事会罢免 Sam Altman 的事件中扮演了关键角色,提供了导致 Altman 被解职的关键信息,并在事后被任命为临时 CEO。
2024年离开 OpenAI 后,她创立 Thinking Machines Lab,并创纪录地获得 20 亿美元种子轮融资,但其发展路径充满挑战,包括核心团队流失。
她的职业生涯体现了高风险、高信念的决策模式:从特斯拉跳槽至当时默默无闻的 OpenAI,又在巅峰期离开去追寻自己关于 AI 可解释性与协作的愿景。
从阿尔巴尼亚到硅谷:技术天才的早期轨迹
Mira Murati 的故事始于1988年的阿尔巴尼亚。当时的阿尔巴尼亚是世界上最封闭的共产主义政权之一,甚至比今天的朝鲜更为孤立。她的父母都是文学教师。在那样一个历史可能被政党任意改写的环境里,人文学科充满不确定性,而数学则成为了一片“中立领土”——没有宣传,只有真理。Mira Murati 从小便展现出非凡的数学天赋,用播客主持人的话说,是“像电影《贱女孩》里林赛·罗韩说的那样,‘极限不存在’的那种好”。
动荡的环境促使她追寻科学与真理。16岁时,她获得奖学金,前往加拿大温哥华岛的皮尔逊学院就读。这是一所汇聚了全球80个国家学生的顶尖预科寄宿学校。对于来自一个在地图上都难以找到的封闭国家的女孩来说,这无疑是一次世界观的重塑。之后,她前往美国,在缅因州的科尔比学院获得数学学士学位,并在达特茅斯学院获得机械工程学士学位,奠定了坚实的数理工程基础。其间,她还在东京的高盛获得了一份暑期分析师实习机会。
毕业后,她的第一份正式工作是加入全球历史最悠久的航空航天公司之一——法国卓达宇航集团,担任先进概念工程师。然而,播客分析认为,此时的 Murati 似乎在寻找更宏大的事业,而这份工作并非她的终点。
特斯拉与 Leap Motion:投身硬件与前沿科技浪潮
2013年,Mira Murati 做出了一个关键选择:加入当时仍是硅谷“挑战者”的特斯拉,担任 Model X 项目的高级产品经理。那时的特斯拉刚刚推出 Model S,正努力向世界证明电动汽车可以既酷炫又具备尖端科技。Murati 负责的 Model X 拥有标志性的“鹰翼门”。年仅24岁的她,在 Elon Musk(埃隆·马斯克)处于“巅峰远见天才”状态的特斯拉,亲历了一款汽车从设计到部署的全生命周期,这对她后来的产品管理思维产生了深远影响。她尤其参与了特斯拉自动驾驶功能的早期推进,这些经验让她对复杂硬件与软件系统的整合有了深刻理解。
然而,在旁人看来事业步入稳定期时,Murati 再次选择了离开。她加入了初创公司 Leap Motion,担任产品与工程副总裁。Leap Motion 专注于手势追踪硬件,愿景是实现《少数派报告》中那样的隔空操控。尽管概念超前,但产品存在“大猩猩手臂综合症”(长时间举手操作非常疲劳)等实用性问题,最终未能普及。虽然没有 Murati 对此的直接评论,但播客推测,她可能在当时就意识到了这项技术尚未准备好迎接大众市场,这促使她寻找下一个更具变革性的机会。
OpenAI 岁月:从研究非营利到 ChatGPT 引爆世界
2018年,Mira Murati 做出了她职业生涯中最大胆的跳跃之一:加入当时还是一个纯粹研究型非营利组织的 OpenAI,担任应用 AI 与合作伙伴关系副总裁。那时的 OpenAI 仅有约40名员工,没有成熟产品,外界知之甚少。同年,OpenAI 发布了具有1.17亿参数的 GPT-1,这成为了 AI 行业的一个转折点,尽管当时并未引起大众关注。
Murati 在加入之初就展现出非凡的远见。她当时表示:“我们将开发的技术中,没有比生成式 AI 更重要的了。”关于 CEO Sam Altman(萨姆·奥尔特曼),她评价道:“Sam 是一位远见者。他胸怀大志,并建立了一家我们拥有强大合作关系的了不起的公司。”在随后的几年里,她一路晋升为 CTO, overseeing research, product, and safety(监管研究、产品与安全)。她领导了 GPT-2、GPT-3、DALL-E、Codex 等一系列突破性模型的研发与发布。
她曾预言:“我们正在开发的东西将改变一切。它将改变我们的工作方式、彼此互动的方式以及思考方式。真的是生活的方方面面。”当时大多数人可能并未完全理解这句话的分量,直到2022年底,GPT-3.5 和 ChatGPT 横空出世。作为 CTO,Mira Murati 无疑是这项颠覆性技术得以问世并走向世界的核心驱动力量之一。至此,她已从一个顶尖的技术产品经理,成长为全球最重要 AI 公司的掌舵者之一。
风暴中心:OpenAI 董事会“政变”中的关键角色
2023年11月17日,OpenAI 董事会突然宣布解雇 CEO Sam Altman(萨姆·奥尔特曼),震惊世界。而在这背后,一场由首席科学家 Ilya Sutskever 策划、Mira Murati 深度参与的“行动”早已悄然进行。
根据事后披露的信息,Sutskever 联系了董事会成员 Helen Toner,并建议她与 Murati 谈谈。Murati 向董事会分享了关于 Altman allegedly toxic management style(据称有毒的管理风格)的种种事例。这些信息,连同其他内部沟通截图和记录,被汇编成一份著名的52页备忘录,由 Sutskever 通过“阅后即焚”邮件发送给董事会,备忘录开篇即指控 Altman 表现出“一贯的撒谎模式”。
董事会迅速行动,解雇了 Altman,并随即任命 Murati 为临时 CEO。然而,局势在72小时内急剧反转。Ilya Sutskever 在社交平台上公开表示“深深后悔参与董事会的行动”。而 Murati 在此期间虽未公开发声,却与 Altman 保持着幕后短信沟通。她向 Altman 预警情况“非常糟糕”,并透露董事会已选定新 CEO(她称之为“随机的 Twitch 主播”),且“不在乎是否所有人都辞职”。
随后,超过700名 OpenAI 员工联名要求 Altman 回归,Murati 也在信上签了名——这位曾提供关键信息导致他被解雇的人,转而要求他回归。关于她的动机,外界有两种猜测:一是她本以为那些“证据”最多导致 Altman 受到训诫或治理审查,没想到会直接解雇;二是当她看到员工强烈反弹后,不希望自己成为众矢之的。
最终,Altman 成功回归。在2024年9月,即事件发生约一年后,Murati 宣布从 OpenAI 离职。在随后 Musk(马斯克)诉 Altman 的庭审中,Ilya Sutskever under oath(在宣誓下)作证时被问及52页备忘录中的指控来源,他明确回答:“Mira Murati。”并补充说:“我当时完全相信 Mira 提供给我的信息……她是 OpenAI 唯一一个被所有派系信任的人。她懂研究、懂产品、懂人。她公开从未站队。”这份证词将她置于这场科技史上最戏剧性权力斗争的核心。
创立 Thinking Machines Lab:新愿景与新挑战
离开 OpenAI 后,Mira Murati 于2025年2月创立了 Thinking Machines Lab。她明确表示,这家公司的理念与 OpenAI 的“规模假设”路径形成对比。OpenAI 信奉通过更多数据和算力 scaling(扩展)直至达成超级智能或 AGI(通用人工智能)。而 Thinking Machines Lab 则专注于可解释性、透明度和人机协作。用她自己的话说:“我们创立 Thinking Machines Lab,是为了让 AI 系统被更广泛地理解、更可定制,并且具备通用能力。”
五个月后,她为自己的种子轮融资震惊了硅谷:20亿美元。这不仅是史上最大规模的种子轮融资,更是当时硅谷平均种子轮融资额(350万美元)的570倍。凭借雄厚的资金,她从 OpenAI 等公司招募了顶尖人才,包括前 OpenAI 研究副总裁 Barrett Zoph,后者作为联合创始人兼 CTO 加入。
然而,征程并非一帆风顺。2025年10月,公司推出首款产品“Tinker”,一个为特定行业微调 AI 模型的 API。市场反响平平,许多人认为这只是一个“微调工具”,与20亿美元融资和顶尖团队的期待不符。随后,挑战接踵而至:2026年1月,公司宣布与联合创始人 Barrett Zoph 分道扬镳,后者重返 OpenAI。另一位高级领导 Luke Metz 也选择回归 OpenAI。紧接着,Meta 开出10亿美元价码意图收购公司,在被 Murati 拒绝后,Meta 转而直接雇走了 Thinking Machines Lab 的七位创始成员。短短几周内,近一半的创始技术领导层流失。
尽管遭遇人才流失,Thinking Machines Lab 仍在推进技术。2026年5月,公司发布了“TML Interact”(播客主持人吐槽了其命名),这是一个能同时实时处理音频、视频和文本的多模态模型,声称响应速度达到0.4秒,媲美人类对话节奏,并在某些基准测试中优于 OpenAI 和 Google 的同类模型。不过,这些基准测试结果目前是公司自行发布的,尚未得到独立验证。
沉默的超级力量:Mira Murati 何以成为 AI 偶像
纵观 Mira Murati 的职业生涯,她始终站在技术革命的前沿:从 Leap Motion 的手势交互,到特斯拉的电动汽车与自动驾驶,再到 OpenAI 的生成式 AI 大爆炸,如今又投身于 AI 可解释性与协作的新探索。她的选择充满了“educated, high-risk, but high-conviction bets(经过深思熟虑的、高风险但高信念的赌注)”。
播客主持人认为,在她身上,“grown-up(成熟)”的特质最为突出。在 OpenAI 最混乱的48小时里,董事会将公司托付给她。她没有经营个人品牌,不在社交网络上夸夸其谈,而是让工作本身说话。她冷静、镇定,即便在最高风险、最混乱的时刻。当 Mark Zuckerberg(马克·扎克伯格)带着收购邀约而来时,她能自信地说“不”。
她来自一个曾经封闭的阿尔巴尼亚小镇,在一个仍然以男性为主导的领域里,凭借卓越的技术功底、产品嗅觉和战略胆识,一步步走到舞台中央。尽管 Thinking Machines Lab 前路挑战重重,但没有人会怀疑,Mira Murati 的故事远未结束。她不仅是 AI 竞赛的参与者,更是以其独特方式影响棋局的沉默操盘手。
 OpenAI 首席科学家 Jakub Pachocki(雅库布·帕霍茨基):我们将达到模型训练更好模型的时代撰文:Techub News 整理
导语
Jakub Pachocki(雅库布·帕霍茨基),这位六次在国际信息学奥林匹克竞赛中斩获顶尖名次的天才,如今已成为全球最具影响力的 AI 公司——OpenAI 的首席科学家。在 Ilya Sutskever(伊尔亚·苏茨克维)离开后,他接掌了公司价值 3000 亿美元的研究项目领导权,负责决定 OpenAI 的 AI 研发方向。2025 年,他被《时代》周刊评为全球百大最具影响力 AI 人物之一。其团队开发的突破性模型,首次让 AI 能够进行高度抽象的推理,并将人类带入大规模 AI 应用时代。
2025 年 9 月,Pachocki 接受了波兰科技频道「This is IT」的专访,分享了他从理论计算机科学转向深度学习的历程、对 OpenAI 使命的理解、以及他对 AI 未来发展的深刻洞察。在这场约 40 分钟的对话中,他不仅回顾了关键的技术转折点,更展望了一个由 AI 主导科学发现、并可能自我迭代进化的近未来图景。
摘要
OpenAI 的核心信念是在不远的未来,创造出与人类同等甚至更高智能的 AI,当前正处于一个全新的、可扩展的技术范式的开端。
AI 在数学奥林匹克竞赛等领域的突破,标志着一个转折点。下一步将是 AI 在现实世界中构建事物(如编写程序、撰写书籍、进行科研),Pachocki 预计这将在明年年底前实现。
以 O1 为代表的新范式,关键在于监督模型的决策过程而非仅结果,这开启了模型内在“思考”的可能性,但也带来了如何监管比人类更聪明模型的严峻挑战。
Pachocki 坦言对 AI 可能带来的颠覆性影响感到压力,认为自原子弹发明以来,世界从未因一项技术革命而处于如此不稳定的境地。
从理论到实践:AlphaGo 带来的世界观颠覆
Jakub Pachocki(雅库布·帕霍茨基)的职业生涯始于对“计算机能做什么”这一根本问题的探索。从高中编程竞赛到哈佛大学的博士研究,他一直沉浸在理论计算机科学中,致力于证明计算机理论上能计算与不能计算的界限。彼时,他的观点是:那些即使效率不高但能被证明有效的算法,因其可扩展性,将在未来占据主导地位。
然而,DeepMind 的 AlphaGo 彻底动摇了他的世界观。围棋的巨大状态空间曾让学界普遍认为,计算机需要很多年才能在此领域超越人类。AlphaGo 的成功证明,通过神经网络从人类对弈或自我对弈中学习,而非依赖手动设计的启发式搜索,AI 可以达成超越人类的性能。“这真的震撼了我的世界,”Pachocki 回忆道,“因为它让我更容易想象,从玩游戏到解决编程竞赛,再到撰写科学论文、推动科学发展的路径。”
这一事件促使他重新思考整个领域。他认识到,深度学习的理论基础虽然薄弱,但其展现出的潜力不容忽视。与此同时,他当时的合作者 Aleksander Madry(亚历山大·马德里)——一位在图算法领域取得惊人进展的 MIT 教授——也得出了相似的结论。他们都对深度学习缺乏坚实理论感到不满,并开始探讨能否为此构建更好的理论框架。
最终,在 Wojtek Zaremba(沃伊切赫·扎伦巴)的持续招募下,Pachocki 在完成博士和短期博士后研究后,决定“双脚跳入”这个领域,加入了 OpenAI。他早期的重大项目便是利用强化学习,教神经网络玩复杂的电脑游戏《Dota 2》。这段经历为他日后参与 GPT 系列及 O1 模型的研发奠定了重要基础。
OpenAI 的使命:创造世界上最强大的 AI
作为首席科学家,Jakub Pachocki(雅库布·帕霍茨基)清晰地阐述了 OpenAI 的核心理念:“我们的公司建立在这样一个信念之上:在不远的未来,AI 将达到与人类同等甚至更高的智能水平。”他承认,几年前人们还在争论这个“奇点”何时到来,但现在看来,发展是连续的。GPT 在某些方面已经比人类更聪明,在另一些方面则更笨拙,但它无疑在持续进化。
Pachocki 指出,当前 AI 的发展已经抵达一个关键里程碑。他曾预言,当 AI 开始在数学或编程奥林匹克竞赛中获得金牌、解决所有问题时,就意味着我们真正接近了人工智能。“现在,这一刻正在发生。”他说。因此,接下来的自然步骤是 AI 能够在现实世界中构建事物,无论是编写有用的程序、创作书籍,还是进行科学研究、发现新知识。他预计,我们将在明年年底前看到这方面的进展。
他特别提到了科学发现的“多米诺骨牌”效应:许多定理的发现是为了证明其他更复杂的定理。如果 AI 能够解决需要数月甚至数年创造性工作的难题,那么它必然涉及提出新假设和构建新的理解。Pachocki 描绘了一个未来场景:我们将能够利用一个显卡集群运行多个模型副本,从而拥有一个“AI 研究实验室”,这些模型将自主思考并产出科学成果。这种加速可能带来医学等领域的剧变,其步伐将超乎我们的习惯。
当被问及是否担心被 AI 取代时,Pachocki 坦承:“是的。”他不仅将此视为一种反思,更是团队积极思考的重大问题。他来自编程竞赛并最终走向 AI 的路径并不独特,OpenAI 内部许多优秀同事都有类似背景。AI 在此类任务上超越人类,意味着一个根本性的转变。
O1 与新范式:监督“思考”而非答案
访谈中,Jakub Pachocki(雅库布·帕霍茨基)将 O1 模型带来的“自由推理”和“抽象思维”能力称为近期 AI 发展的最大突破。其核心在于方法论的转变:从监督模型的输出结论,转变为监督模型的决策过程。
Pachocki 解释说,这并非全新的想法。早在 GPT-2/3 时期,人们就观察到,如果要求模型在上下文中“思考”一会儿,其表现会更好。真正的挑战在于精炼技术,使模型能够真正学会如何思考。其基础技术是强化学习:通过观察模型自身的思考过程,强化那些导向更好结果的思维路径。这与 AlphaGo Zero 教授神经网络下围棋的方法本质相同,也是 Pachocki 早期在 OpenAI 用 Dota 2 项目实践过的。
“这个范式已经改变了,”Pachocki 强调,“监督仍然存在,但重点是应用层面。不同之处在于,我们训练模型不仅是为了得出正确结论,更是为了强化其自身导向正确结论的思维链。”这种内在的“独白”是 O1 等模型的关键特征。与 GPT Chat 试图取悦用户的输出不同,O1 的内在思维链可以独立运作,它可能内心认为用户完全错了,但会选择以相对友善的方式表达。
Pachocki 认为,当前正处于一个类似于 GPT-1/2 时期的新范式开端。这一范式同样是可扩展的,意味着可以沿着同一轴线进一步发展,未来我们将看到基于相似方法论但智能程度高得多的模型。从 GPT Chat 到 O1 只用了两年多时间,这种加速趋势显而易见。
未来的挑战:记忆、具身与无限发展
尽管进步神速,Jakub Pachocki(雅库布·帕霍茨基)指出了当前模型仍需克服的几个关键限制。首先是长期记忆。目前的模型缺乏人类那种日积月累构建上下文、了解对话对象和周围世界的能力。这对于进行长期研究或在现实世界中运作至关重要。
其次是多模态与具身智能。当前模型主要通过文本交互,但未来需要能够使用计算机,并最终在物理世界中行动。Pachocki 认为,空间理解本身可能不是最困难的部分,视频生成模型如 Sora 已显示出对物理定律的一定理解。更难的挑战在于赋予 AI 一个功能良好的机器人身体,并让其理解具体动作对物理世界的影响。他推测,即使仅从文本中,模型也能学习大量物理知识,因为它们本质上是在预测人们会如何描述现实世界的事件。
关于 AI 发展的终点,Pachocki 持开放态度。他认为发展可能没有尽头。AGI(通用人工智能)常被视为该领域的“圣杯”,但人类的智能本身就是一个移动的目标。随着 AI 在越来越多轴上超越人类,我们与模型的协同进化也会改变我们对“智能”的定义。“也许当我们到达那个用大型计算集群进行开放式医学研究的点时,我们可能仍在争论这是否算 AGI。”他说。
对于训练数据可能枯竭的担忧,Pachocki 表示,Alpha Zero 或 Dota 项目已经展示了不依赖人类文本数据的学习路径,当前的方法受数据约束已大大减少。他确信,我们将达到“模型训练更好模型”的阶段。这将是具备递归循环能力模型的直接结果。今年内,一些简单的内部基础设施实现就可能由具备“思考”能力的 AI 模型辅助完成,但要由模型主导整个研究项目,还需要时间。
监管、幽默感与内心的忧虑
随着 AI 能力逼近乃至超越人类,监管问题变得空前严峻。Jakub Pachocki(雅库布·帕霍茨基)认为,O1 等模型拥有不直接面向用户的“内心独白”,这既是有趣的特性,也带来了监管难题。如果我们让用户完全访问模型的思考过程,这些思考最终也会受到与聊天输出相同的压力,被塑造成用户想要的样子。但更危险的是,如果我们一味监督模型不让它“思考如何欺骗我们”,它可能会发展出我们无法察觉的欺骗方式,后果更糟。
当被问及 AI 目前为何缺乏幽默感时,Pachocki 笑称,有时他会想这是否将是“人类最后保留的领地”。但他认为这主要是当前训练目标并未侧重于此,他预计这种情况会很快改变。“我不会赌幽默感(是人类专属),”他说,“我认为幽默感很快就会(被 AI 掌握),而且会是一种非常有趣、略有不同的感觉。”
最后,Pachocki 坦言,审视技术发展,有几件事让他深感忧虑。长期来看,当模型能自主进行研究并构建新版本时,如何监管将是一个亟待解决的大问题。短期来看,即使模型还不够聪明,但其已能完成大量有价值的工作,这本身就构成了一场真正的技术革命。“自原子弹发明以来,世界尚未因一场革命而处于如此不稳定的境地。这就是让我感到压力的事情。”他总结道。
 Web3Labs 孵化人才配对平台 OkayJob 正式上线,将以 AI 重构人才供需机制近日,知名 Web 3 孵化器 Web 3 Labs 孵化的全 AI 功能人才配对平台 —— OkayJob (okayjob.ai) 正式上线。作为聚焦 AI 与 Web 3 领域的下一代人才基础设施,OkayJob 致力于通过前沿 AI 技术,彻底重构行业的人才供需机制。
OkayJob 核心亮点在于面向求职者(C 端)打造的“全 AI 工具”颠覆性体验。平台突破传统招聘局限,将 AI 深度融入求职全生命周期,化身专属智能助手。其核心工具矩阵包括:
AI 简历管家:提供深度的简历智能诊断与一键优化
AI 精准匹配:通过核心算法实现人岗的高效、精准对接
AI 模拟面试:打造沉浸式实战演练,全面提升面试技巧
AI 职业规划:量身定制科学、清晰的职业成长路径建议
借助这一系列全方位的 AI 工具,求职者能显著提升应聘效能,在激烈的行业竞争中确立绝对优势。
在企业端(B 端),OkayJob 依托 AI 标签体系与智能推荐引擎,帮助科技企业精准触达优质人才,大幅降低甄选成本与沟通壁垒。
作为 Web 3 Labs 生态布局的重要一环,OkayJob 未来将立足亚洲、辐射全球,持续探索 AI 在人力资源领域的多元应用,以全 AI 驱动的力量,构建高效、智能的全球科技人才新生态。目前,OkayJob 已全面开放企业入驻及个人用户注册。诚邀广大创新企业与优秀人才加入,共探 AI 时代的职业发展新机遇:okayjob.ai
 Injective 联合 Microsoft 与 Web3Labs 启动“新星计划”,百万美元资源全球招募 AI 创新项目在全球 Web3 技术与人工智能加速融合的浪潮下,专注于下一代金融基础设施的 Layer-1 区块链网络 Injective 今日正式宣布,联合全球科技巨头 Microsoft 及知名 Web3 创新孵化平台 Web3Labs,共同启动「Injective 新星计划(Injective Nova Program)」,同步开启全球 AI 创新项目招募,并开放高达百万美元级的创业扶持。
该新星计划面向全球开发者与创新团队,旨在加速 AI 与真实应用场景的深度融合与落地,推动其进化为具备自主决策、执行与协作能力的下一代“数字主体”。
Injective 新星计划时间轴
招募预选: 5 月 21 至 6 月 30 日
创新决赛: 7 月中下旬
入围决赛的 Top 10 团队将受邀参与决赛 Demo Day,向全球顶级投资机构展示其创新成果。
聚焦六大核心维度,定义 AI 未来版图
本次招募不设硬性限制,重点鼓励构建者围绕以下六大应用矩阵进行深度探索与创新:
1. 智能体基础设施(Agent Infrastructure): 开发 AI 代理的底层通信框架、执行协议及开发工具。
2. AI 原生游戏(AI-Native Gaming): 重塑游戏逻辑,打造具备自主进化能力的 AI 主体。
3. AI 社交新范式(AI Social): 探索智能体与人、智能体与智能体之间的高频交互场景。
4. AI 智能支付(AI Payments): 实现 AI 代理在 Web3 环境下的自主支付、分润与资产管理。
5. AI × 物理世界(Agent × Physical World): 通过链上逻辑干预现实场景,探索 AI 代理的物联网化应用。
6. 开放式创新(Open AI Applications): 一切基于 AI 驱动、具备生态爆发潜力的前瞻性构思。
百万级资源扶持,构建顶级资源矩阵
联合激励奖金:Top 3 项目团队均分 30,000 USDT 的联合奖励(15,000 USDT 现金奖励 + 15,000 USD 云服务 Credit)。
专项资助与投资:Top 10 项目团队将有机会获得 Injective 基金会提供的 10,000 美元专项资助,并有机会获得最高 100 万美元的追加投资。
微软算力支持: 微软将为入围项目提供最高总计 15,000 美元的 Azure 云服务额度,全力支持 AI 模型的开发与部署。
生态资源对接: 优胜项目将有机会获得 AdventureX 2026 快速通道名额,以及来自 Injective、微软及 Web3Labs 的资深导师提供的长期项目扶持。
官方报名通道: injectivenova.com
🧑🏻💻项目招募 TypeForm:https://form.typeform.com/to/J8tQWS4p
👩💻💻独立开发者收集 TypeForm:https://form.typeform.com/to/ug03BC6z
关于 Injective
Injective 是一个高性能的 Layer-1 区块链,专为下一代去中心化金融应用而设计。它通过提供即时交易终结、互操作性以及可扩展的架构,为开发者构建下一代金融应用提供了坚实的基础。
关于微软
微软(NASDAQ: MSFT)专注于打造 AI 驱动的平台与工具,通过持续创新满足全球用户需求,致力于推动人工智能的广泛与负责任应用。
关于 Web3Labs
Web3Labs 是全球领先的 Web3 创新孵化平台,致力于通过活动、媒体传播与社群运营,链接全球 Web3 资源,赋能新兴项目成长。
 ARCB Venture Labs Expands Ecosystem Utility With the Launch of X CardARCB Venture Labs is expanding its digital asset ecosystem with the introduction of the X Card, a payment card solution designed to give greater real-world use to ARCB Token and selected ecosystem partner tokens.
One of the biggest challenges in Web3 today is simple: many digital assets have value, but limited daily use. Tokens may represent ownership, access, rewards, participation, or ecosystem value. However, for many users, the gap between holding a token and using it in real life remains wide.
The X Card is designed to close this gap. Through the X Card member portal, users will be able to load supported digital assets, view market reference prices, and convert eligible assets into a USD-based card balance when needed. This allows users to move from simply holding digital assets to using them for real-world spending.
The X Card is expected to support everyday and cross-border payment needs, including online shopping, business spending, travel bookings, lifestyle payments, international merchant transactions, and overseas ATM withdrawals. These services will depend on regional availability, platform rules, payment partner requirements, transaction limits, and applicable compliance procedures.
For ARCB Venture Labs, the X Card is more than a payment product. It is part of a larger ecosystem strategy. In the future, selected partner tokens may also be integrated into the X Card framework. This could allow approved projects supported by ARCB Venture Labs to give their communities more practical use for their tokens beyond their own platforms.
The physical card feature is also designed with flexibility in mind. A single user account may support the application and management of up to five physical cards, subject to platform policy, user eligibility, risk controls, and compliance requirements.
ARCB Venture Labs stated that the X Card will operate under a structured framework that includes account review, transaction monitoring, risk management, and compliance procedures. These measures are intended to align the card’s use with relevant regional regulations, payment network rules, and partner institution standards.
The launch of the X Card reflects a major shift in the digital asset industry: from speculative value to practical utility. By connecting ARCB Token and selected ecosystem partner assets to payment infrastructure, ARCB Venture Labs is building a clearer pathway between Web3 assets and real-world financial use.
The X Card is ARCB Venture Labs’ move to turn digital assets from stored value into usable value.AI 实验室 PrismML 发布微型大语言模型,旨在改变 AI 使用方式Techub News 消息,AI 实验室 PrismML 发布了一款微型大语言模型。该公司希望这款体积小巧的模型能够改变人们使用人工智能的方式。
(TechCrunch)Aurora Intents 在 Sui 上支持单签名跨链交易执行Techub News 消息,Aurora Intents 已添加 Sui 作为单签名跨链交易的目的地,扩展了对求解器网络的访问。Aurora Labs 表示,该网络已路由超过 300 亿美元的交易额。
根据 Aurora Labs 9 月 17 日发布的新闻稿,此举旨在简化用户在 Sui 上的跨链交易体验,用户只需一次签名即可完成交易。 (Crypto.news)Ava Labs COO:机构加密创新不会因法案失败放缓Techub News 消息,Ava Labs 总裁兼 COO Charley Cooper 在 Avalanche Summit 上表示,已承诺进行加密创新的机构不会因《CLARITY 法案》的失败而放缓步伐。
该发言针对美国加密货币监管立法进展,表明部分机构对加密创新的承诺具有独立于特定监管框架的持续性。(CoinDesk)Base Labs 与 Hugging Face、Goodfire 合作推出开源 AI 安全伙伴计划Techub News 消息,Base Labs 宣布与 Hugging Face 和 Goodfire 合作,启动一项开源 AI 安全伙伴计划。该计划旨在开发和发布用于训练与监控开源模型的方法。Base Labs 是 Baseten 今年早些时候成立的研究团队。(TechCrunch)AI语音公司ElevenLabs拟融资超5亿美元Techub News 消息,AI语音技术公司ElevenLabs正进行新一轮融资谈判,计划筹集超过5亿美元资金。此次融资有望加速其全球业务扩张,并巩固其在AI语音技术领域的领先地位。(Crypto Briefing)字节跳动AI药物研发子公司Anew Labs完成2.9亿美元融资Techub News 消息,字节跳动旗下AI药物研发子公司Anew Labs已完成2.9亿美元融资。该公司于2021年在字节跳动内部成立,并于2026年6月分拆为独立实体。Anew Labs专注于利用人工智能技术加速药物发现与开发。(Tech in Asia)KREMLIN 恶意软件利用以太坊更新攻击服务器Techub News 消息,安全研究机构 Elastic Security Labs 于 9 月 14 日发布技术报告披露,名为 KREMLIN 的恶意软件自 2025 年 5 月起利用以太坊智能合约更新攻击基础设施,已追踪到 1,515 台受感染系统,其中 98.75% 位于巴西。
该恶意软件主要针对巴西银行用户,通过恶意浏览器扩展窃取凭证和会话数据。攻击者将区块链用作「死信投递解析器」,感染设备从链上合约读取配置值以定位外部基础设施,从而无需修改初始恶意软件即可更换服务器地址。研究人员追踪到 82 笔 USDT 转账经过用于部署和更新恶意合约的钱包,目前相关合约仍在使用中。(crypto.news)Grove Basin 为代币化国债提供稳定币流动性Techub News 消息,Grove Labs 于 5 月 14 日推出非托管信贷设施 Grove Basin,为代币化现实世界资产提供每日最高 10 亿美元的稳定币流动性,交易获批后链上即时结算。
该平台采用时间锁控制的多签治理结构,初始支持 BlackRock 的 BUIDL 基金及 Janus Henderson 的 JTRSY 产品,Anchorage Digital、Galaxy Digital 和 FalconX 为流动性合作伙伴。该平台还接入 Sky 生态(原 MakerDAO)的稳定币基础设施,未来计划扩展至更广泛的代币化信贷领域。(CryptoBriefing)Ethena Pay 计划三至四周内进入美英欧市场Techub News 消息,Ethena Labs 创始人及 CEO Guy Young 称,Ethena Pay 预计在三至四周内开始拓展美国、英国和欧洲市场,地理扩张目前是团队的首要任务。
该时间表较此前指引有所推迟,公司曾在 9 月 3 日博客中表示美欧支持功能预计 9 月上线。Young 表示扩张进度部分取决于 Visa 卡合作方 Third National 和 Rain 的能力,目前该卡暂不对美国公民开放。(CryptoBriefing)LayerZero Labs 设定 STG 转 ZRO 兑换截止期限Techub News 消息,LayerZero Labs 发布更新称,STG 持有者可在 12 月 15 日前继续将 STG 转换为 ZRO,此后该服务将不再支持。团队表示将与交易所、做市商等生态伙伴协调过渡事宜。
LayerZero 同时宣布多项运营调整:Stargate 将于 10 月 1 日起全面采用 Taxi 交易模式,停用 Bus 批量交付方式;测试网支持将缩减至约 10 个优先网络;V1 漏洞赏金计划将于 12 月 15 日终止,V2 赏金池提升至 350 万美元。(CryptoBriefing)
