
Loading...

Loading...
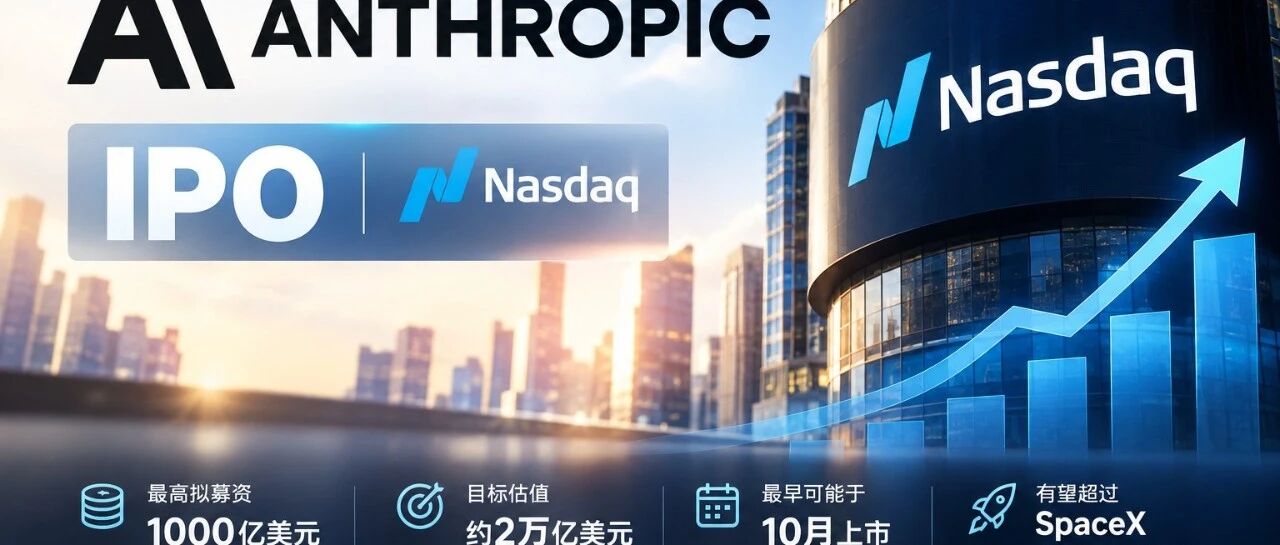 Anthropic冲刺史上最大IPO:目标11月挂牌纳斯达克,估值2万亿美元据《商业内幕》报道,Anthropic已经选定纳斯达克作为上市地点,目标10月启动路演,11月挂牌。路透社12日披露,英伟达正以基石投资者身份洽谈参与,出手就是最高100亿美元。
Anthropic这轮IPO计划募资最高1000亿美元,目标估值约2万亿美元。什么概念?SpaceX今年6月在纳斯达克上市,募资863亿美元,估值1.77万亿——已经是史上最大IPO了。Anthropic想把这个纪录再往上拉一个台阶。
高盛、摩根大通、摩根士丹利三家联手做主承销商。6月1日就已秘密向SEC提交了S-1草案。
英伟达:又卖芯片又投钱
英伟达这步棋下得精。
100亿美元的基石投资,占总募资额的10%。基石投资者是在股票面向公众发售之前就预先承诺认购的机构,核心作用是给市场"打样"——你看,我英伟达都押了100亿,你敢不买?
但问题在于,英伟达本来就是Anthropic最大的芯片供应商。Claude模型的训练和推理全靠英伟达的GPU跑。2025年11月,英伟达已经宣布投资Anthropic最高100亿美元,Anthropic则承诺采购300亿美元由英伟达芯片驱动的微软Azure算力。
现在又要以基石投资者身份再投100亿。
供应商变成了股东,股东投的钱又变成了供应商的收入。这不是套娃,这是闭环。
更绝的是,Anthropic还跟英伟达支持的云厂商Nscale签了450亿美元算力协议,又跟同样有英伟达背景的Lambda签了350亿美元。加上亚马逊超过1000亿美元的AWS十年合同和谷歌的TPU租赁——Anthropic本质上在用英伟达的钱,买英伟达的芯片,跑自己的模型,再把收入的一部分还给英伟达。
永动机也不过如此了。
营收:数字很炸,但得拆开看
循环归循环,营收数据确实炸裂。
Q2营收115亿美元,去年同期7.87亿,增长15倍。年化营收从年初的90亿飙到7月的650亿美元,半年翻了7倍多。毛利率超过80%,Q2调整后营业利润首次转正,达到5.59亿美元。
但注意,"调整后营业利润"是个有弹性的词。
调整后意味着剔除了股权激励、训练成本等一大堆开支。有分析师直接给这个指标起了个外号叫"EBTIT"——Earnings Before Training, Interest, and Taxes(训练、利息和税前利润)。公司自2021年创立以来累计净亏损超百亿美元,从没在任何一个完整财年赚过钱。
管理层自己还告诉投资者,下半年因为算力和训练投入加大,大概率不会再盈利。
所以这个"首次盈利",更像是一道精心调整后的财务表演。
估值:市场在赌一个你看不到的数字
2万亿除以650亿年化营收,PS(市销率)约31倍。
但投资者讨论的不是650亿。他们看的是2028年的预期——公司预计2028年营收1900亿到2000亿美元。按那个算,PS约10倍,"好像没那么贵了"。
问题是:你要相信一家公司能在两年内把收入做到现在的三倍,还要维持5%以上的运营利润率。
纽约大学金融学教授Aswath Damodaran直接说了:这个估值"已触及合理边界,甚至超出了可信范围"。
最讽刺的一幕
最有意思的地方来了。
就在Anthropic冲刺IPO的同时,CEO达里奥·阿莫代伊公开呼吁:AI行业需要放慢最先进模型的开发速度。理由是AI能力的发展已经超过了安全措施。
Sam Altman表示支持。马斯克也发了声。OpenAI直接表态今年不上市。
然后Anthropic一边喊刹车,一边踩油门冲上市。
矛盾吗?其实不矛盾。踩刹车的是前沿模型的能力竞赛——最危险的那些东西,确实该慢一慢。但商业化不能停。Claude卖给企业,该赚的钱照赚。
只不过,两条路线的分歧已经很明显了。OpenAI选择不上市,Anthropic选择上。两条路最终都要面对同一个裁判:市场和投资者。
结语
2026年美股IPO市场已经疯了。剔除空白支票公司,今年募资总额1606亿美元,2021年以来最高。SpaceX、SK海力士之后,Anthropic又来了。
这不是结束,AI时代的资本大戏可能才刚开场。
但真正值得盯的不是"2万亿贵不贵"——而是那个循环能不能转下去。
英伟达卖芯片赚的钱,投给Anthropic。Anthropic拿钱买GPU做营收,营收增长推动估值,估值支撑IPO,IPO回馈英伟达的投资。
只要模型能力还在涨、企业需求还在扩、资本信心还在,这个循环就能转。但任何一个环节松动——芯片降价、需求放缓、或者有人发现"原来利润是这么算出来的"——整条链子就会开始发抖。
Anthropic的IPO,本质上是对整个AI行业循环投资逻辑的一次压力测试。
市场很快会给答案的。Lambda, 通过Python代码帮助部署AI推理的‘Flash’公开AI云企业Runpod推出了软件开发工具包(SDK)兼平台“Flash”,让开发者无需复杂的 infrastructure 设置即可直接部署 AI 推理服务。其核心特点是从本地 Python 代码直接连接到云端 AI 推理,大幅减轻了容器设置、镜像管理和基础设施配置的负担。
Runpod 在此次发布中表示,其重点在于解决开发者对“无服务器虽强大,但初始设置繁琐”的不满。首席执行官甄露(Zhen Lu)解释说:“Docker 是一个出色的工具,但这并不是开发者原本想做的事情。Flash 是一款能将这些时间还给他们的产品。”他补充道,开发者只需编写 Python 代码,然后选择所需的计算选项,就能在几分钟内启动请求处理环境。
AI 开发重心,从“训练”转向“推理”
此次发布的背景是 AI 市场的快速变化。如果说初期生成式 AI 的竞争以模型“训练”为核心,那么近期随着 AI 智能体和实际服务的普及,“推理”基础设施的需求正在激增。推理与训练为中心的基础设施要求不同,因为用户请求是实时涌入的,需求波动大,而延迟和扩展速度可能决定服务的成败。
Runpod 强调,在这种趋势下,他们简化了设计,使开发者能够专注于应用逻辑和代码而非基础设施。特别是考虑到 AI 智能体难以通过单个容器或单一端点整齐地处理,而是需要同时调用不同模型、连接各种计算资源以及基于需求进行扩展。
采用 Python 作为主要语言这一点也值得关注。Python 被认为是 AI 开发中使用最广泛的语言之一。根据 2025 年 JetBrains 的调查,超过 57% 的受访者表示使用 Python,37% 的人将其作为主要语言。这一比例高于 JavaScript、Java 和 TypeScript。
在单一服务中连接多个端点
Flash 支持开发者以自己喜欢的方式创建应用程序后,将多个具有不同计算配置的 AI 云端点连接到一个服务中。开发者只需指定所需的计算资源类型,后台会自动处理负载均衡、流量管理和扩展任务。
自动扩展功能也是核心。当需求增加时,端点会扩展到预设的最大值,而在空闲状态时则会缩减回“零”水平。这种结构有利于开发者降低初始成本和运营负担,同时应对突发的请求增长。
此外,Flash 还提供基于命令行界面(CLI)的控制功能。这使得偏好于在本地环境中进行开发、测试和部署的软件工程师能够在不大幅改变现有工作流程的情况下使用它。Runpod 计划通过这种方式,提高从实验阶段到生产环境的整个软件生命周期中 AI 推理的可及性。
AI 云竞争,“易部署”成为新变量
此次 Flash 的发布表明,AI 云市场的竞争正在从单纯的 GPU 获取扩展到“开发者体验”。这是因为在 AI 推理需求快速增长的情况下,如何轻松快速地将原型转化为服务正成为重要的竞争因素。
特别是随着智能体型 AI 的普及,不仅简单的计算性能,灵活的部署结构、自动扩展以及多模型联动能力可能变得更加重要。Runpod 的 Flash 是一项顺应这一趋势、专注于降低基础设施壁垒的服务,它能否在未来以开发者为基础的 AI 云市场中引起显著反响,值得关注。
TP AI 注意事项
使用 TokenPost.ai 基础语言模型对文章进行了摘要。正文主要内容可能被遗漏或与事实不符。Lambda256与Crystal Intelligence携手进军AML市场Dunamu旗下区块链企业Lambda256携手全球分析公司,正式进军"反洗钱(AML)"市场。此举旨在精准瞄准监管强化趋势下国内虚拟资产运营商的合规需求。
Lambda256宣布与全球区块链分析公司Crystal Intelligence签署战略业务合作协议(MOU)。双方计划通过整合Lambda256的FRAML合规引擎"Clair"与Crystal Intelligence的区块链分析平台,面向国内金融机构和虚拟资产运营商(VASP)提供"AML·CFT(反恐怖融资)"整合解决方案。
合规整合…从旅行规则到稳定币
本次协议的核心在于数据与技术的结合。通过联动Lambda256在国内市场积累的交易数据与Crystal Intelligence的全球VASP数据,将实现更精准的资金流向追踪与风险分析。
尤其值得关注的是,双方合作范围将超越旅行规则应对,扩展至稳定币监控功能。公司计划构建包含发行/销毁追踪、多链间资金流动分析、流动性及风险评估等高级功能,达到可实际应用于监管应对水平的系统。
顺应国内监管强化趋势的战略合作
此次合作与国内虚拟资产监管环境变化紧密相关。自旅行规则实施以来,AML·CFT体系强化全面启动,交易所与金融机构的合规负担正持续加重。
Dunamu也在加速提升监管应对能力。此次协议被解读为超越单纯技术合作、旨在构建符合全球标准合规体系的战略举措。
Lambda256事业本部长赵元浩表示:"我们将提供从旅行规则应对到稳定币监控,能够通过统一合规体系管理风险的实质性解决方案。"
接轨全球标准的韩国虚拟资产市场
业界认为此次合作将成为提升国内虚拟资产产业"全球兼容性"的契机。随着国际水平的区块链分析与监管应对体系相结合,预计也将对机构投资者和金融界参与扩大产生影响。
在合规能力即竞争力的局面下,数据与技术结合的整合解决方案能否成为市场标准备受关注。
TP AI注意事项
本文采用TokenPost.ai语言模型进行文章摘要生成。可能存在遗漏正文主要内容或与事实不符的情况。Lambda,以AI基础设施创新实现光速宣言在AI产业飞速发展的浪潮中,企业正高度关注如何构建和维护先进的AI基础设施。近期举行的Nvidia GTC AI大会上,Lambda公司战略副总裁Sam Khosroshahi强调了这一趋势,并指出必须重构现有系统,以支持因AI应用而日益复杂化的工作流程。
Lambda正致力于利用Nvidia技术开发支持下一代AI应用(特别是自主智能体)的AI基础设施。Khosroshahi解释道:"我们专注于调整基础设施以最大化性能,并通过研究团队进行各种测试和基准评估。"
在本次活动中,Khosroshahi特别提及了通过结合光学与光子学的网络解决方案来降低对传统铜缆连接的依赖的重要性。他表示:"光速传输正成为现实",并阐述了这种技术转型如何助力需要处理海量数据及机器学习应用的领域。
Lambda正在建设千兆瓦级规模的园区设施,以帮助客户最大化利用这些技术创新成果,从而加速其AI转型进程。Khosroshahi强调:"从长远来看,这些投资将为那些勇于拥抱技术变革的组织带来巨大收益。"
以上内容由SiliconANGLE媒体旗下直播工作室theCUBE独家报道,本次活动系Nvidia GTC AI大会暨展览会的重要组成部分。Lambdas,以业界首个HBM4E控制器IP革新AI解决方案램버스(Rambus Inc.)今日发布了HBM4E内存控制器IP。该解决方案是专为满足高内存带宽需求而设计的业界首款产品,能够满足下一代人工智能加速器、图形处理器及高性能计算系统的需求。新控制器支持每引脚最高16Gb/s速率,为每个HBM4E设备提供高达4.1TB/s的内存带宽。
HBM4E设备采用垂直堆叠的DRAM芯片,可提供极高的内存带宽与低延迟特性,其效能尤其在AI和高性能计算系统中得以彰显。支持AI加速器配置的此解决方案,在连接8个HBM4E堆栈时可实现超过32TB/s的总内存带宽,非常适合大规模模型训练及数据密集型计算工作负载。
高带宽内存已成为现代AI芯片的基础性技术,助力缩小计算吞吐量与内存访问速度之间的差距。램버斯旨在通过此控制器IP,在AI芯片设计中实现重要的差异化优势。
全新HBM4E控制器基于램버斯超过100项HBM设计成功经验及长期积累的内存接口IP专业知识开发而成。其集成了可靠性功能,可帮助客户首次流片即获成功。
该IP可与第三方标准或硅连接PHY解决方案协同使用,构建形成2.5D或3D封装内的HBM4E内存子系统。这为集成至AI SoC或定制化芯片实现提供了灵活性,支持涵盖云端、企业及边缘部署场景的多样化设计。该IP现已开放授权,并通过早期接入计划向设计客户提供。Lambda256-KSnet,为构建稳定币支付基础设施签署业务合作协议区块链技术企业Lambda256与综合支付专业企业KSNET签署了关于利用稳定币构建支付基础设施及Web3业务合作的战略业务协议(MOU)。
Lambda256于2月3日在首尔KSNET总部与KSNET签署了关于"构建稳定币支付基础设施及Web3业务合作"的业务协议,并宣布正式启动稳定币支付相关的PoC(技术验证)业务。此次协议旨在结合KSNET在实体经济环境中强大的线上线下支付网络与Lambda256卓越的区块链核心技术能力,验证基于稳定币的支付模式的可能性。
通过此次协议,Lambda256将围绕稳定币发行及管理平台'SCOPE',负责链上支付流程设计和区块链节点基础设施运营。Lambda256将基于在交易所及金融环境中积累的节点运营经验,设计兼顾稳定性和扩展性的稳定币支付架构,并支持PoC阶段的技术验证。
签约仪式照片 - 左 KSNET代表理事 朴韩国,右 Lambda256代表理事 郑义正
KSNET运营着涵盖VAN和PG的线上线下支付基础设施,是一家拥有大韩航空、Olive Young、阿迪达斯等航空、流通、零售、医疗、公共领域各类大型企业和机构作为客户的支付基础设施企业。通过此次协议,计划基于其大规模实体支付环境,结合现有支付网络与区块链技术,验证稳定币支付环境。
Lambda256近期在国内区块链行业首次获得SOC 2 Type II认证,正式验证了其在金融及企业环境中所要求的区块链基础设施服务运营能力。在稳定币业务领域,也计划基于金融级别的基建能力扩大合作。
Lambda256代表理事郑义正表示:"与KSNET的合作是验证区块链技术与大规模实体支付基础设施结合可能性的重要案例","Lambda256将基于在金融和企业环境中经过验证的基础设施运营能力,继续提供技术支持,以确保基于稳定币的支付和Web3业务能够稳定扩展。"LambdaTest,以'Testμ AI'重新出发…宣布基于AI的质量革新在AI驱动的质量测试平台领域,致力于树立下一代标准的TestMu AI正式启航。云测试平台企业LambdaTest正式宣布更名,并着手进行全面重组,转向全面的AI中心架构。这家自2018年创立之初就支持自动化测试环境的公司,表明了其将AI技术内化、为工程质量管理全流程引入革新的决心。
首席执行官阿萨德·汗强调了新转型的必要性,他表示:"AI正在彻底改变软件的开发和部署方式。曾经需要数周时间的开发周期,如今几小时内即可完成,但若没有质量作为支撑,最终只会导致混乱。"在此背景下,TestMu AI正专注于超越传统自动化方法的局限,通过AI智能体实现自主质量管理。
TestMu AI通过能够主动响应代码变更、理解开发者意图并自主设计执行最优测试策略的主动型智能体,追求最小化人工干预。仅通过自然语言提示即可对数据库、云、UI、性能等全层级进行集成测试,这一点尤其值得关注。这种架构超越了简单的测试自动化,从人工智能与开发文化融合的角度提出了新的可能性。
品牌名"TestMu"同样源于开发者社区。自2022年起以"Testμ大会"名义运营的年度活动,已使其成为一个广为人知的术语。汗首席执行官解释道:"TestMu不仅仅是一个名字,它代表了测试与质量工程的共同理念,是承载全球社区精神的象征。"这种基于社区的方法有助于巩固品牌形象。
公司的规模增长也引人注目。过去两年年均增长率超过110%的TestMu AI,目前已拥有超过18,000家全球企业客户。其中包括微软、OpenAI、英伟达、Vimeo等知名IT企业,累计测试执行次数已达数十亿次。这些数字印证了AI驱动质量验证的实际需求和信任水平。
展望未来,TestMu AI将完全自主型AI智能体开发、AI系统间的相互测试、以及与代码库的直接集成等纳入核心课题。公司特别设定了目标,旨在通过AI验证AI的元测试环境,为日益复杂的软件生态系统提供解决方案。
此次品牌转型超越了单纯的公司更名层面,是一次试图从测试工作的定义到整体方法进行重构的尝试。在快速变化的开发环境中,TestMu AI的方向性,正日益可能成为下一代质量保障的新基准。AI云巨头Lambda,上市前拟追加筹集4800亿韩元……会成为“英伟达生态的游戏规则改变者”吗基于人工智能的云基础设施初创公司Lambda据悉正在推进规模高达4.8万亿韩元的新一轮融资。穆巴达拉资本被认为是本轮融资的主要潜在领投方,这之所以引人关注,是因为它可能是上市前夕Lambda的最后一轮私募融资。继短短两个月前成功完成120亿美元规模的E轮融资后,Lambda接连进行大规模融资的背后,是其旨在主导AI云市场的积极扩张战略。
Lambda目前在美国运营着12个数据中心,通过名为"超级集群"的GPU集群租赁服务,可为企业客户提供多达16.5万个英伟达GPU。该服务允许每位客户自行配置防火墙策略,并自主管理加密密钥及监控工具,旨在同时实现高度的安全性和可扩展性。
在硬件配置方面,Lambda也在持续引入最新技术。客户可以选择英伟达的GB300 NVL72设备或集成了8个GPU的HGX B300模块,两者均基于英伟达的Blackwell Ultra加速器。此外,公司去年11月还宣布了计划开发基于下一代GPU Rubin的NVL144系统集群。该GPU已于近期在CES 2026上正式发布,据称基于NVFP4数据,可提供每秒50 petaflops的性能。
通信技术也是Lambda的差异化优势之一。公司利用英伟达的共封装光学技术,显著改进了传统以收发器为中心的光传输架构,大幅降低了网络交换机的功耗。这不仅有助于降低数据中心运营成本,也确保了大规模AI计算所需的高带宽连接。
此外,Lambda还自主开发并运营着一个名为Lambda Stack的定制化软件平台。该平台基于开源技术,提供了针对Lambda硬件优化的开发环境,集成了PyTorch、JAX、TensorFlow等工具。其中,JAX是谷歌于2018年开源的技术,能有效加速AI模型的数学运算处理性能。
上市时间点的变化也值得关注。公司最初以2026年7月为目标进行IPO准备,但近期有迹象表明时间表已推迟至下半年。业界认为,若此轮融资能进一步推高企业估值,其上市前景将更加乐观。
在AI云市场的快速增长中,Lambda正构建从数据中心基础设施、GPU优化、安全性、通信技术到开发工具的全方位竞争力。如果本轮融资成功完成,外界评价认为,Lambda很可能基于英伟达生态系统,崛起成为下一代AI基础设施市场的游戏规则改变者。AI基础设施初创公司Lambda 成功融资2.1万亿韩元 启动吉瓦级数据中心建设人工智能基础设施初创企业Lambda成功为数据中心建设筹集大规模资金。Lambda于18日(当地时间)宣布已完成规模超过15亿美元(约合2.16万亿韩元)的E轮融资。本轮融资由亿万富翁投资者托马斯·图尔和马克·沃尔特控股的TWG Global主导,去年曾向Lambda注资3.2亿美元的美国创新技术基金也再次参与本轮融资。
成立于2012年的Lambda专注于运营针对AI工作负载优化的云平台。客户可通过其名为“超级集群”的AI环境调用最高16.5万个GPU,该平台还支持客户直接管理防火墙和加密密钥。针对计算需求较低的客户,Lambda提供小型GPU实例,并于去年推出支持短期租用最多2000个GPU的“一键集群”服务。
此外,Lambda通过提供托管版Kubernetes和Slurm,自动化适配各类AI工作负载的基础设施控制功能。其中Kubernetes专精推理任务,Slrum则擅长长时间AI训练。在技术布局之外,Lambda还致力于AI研发,其推出的名为“潜在思维模型”的新一代AI架构,在数值计算等特定任务中展现出超越竞争模型的性能。
据《华尔街日报》报道,本轮融资将用于大规模新建数据中心。目前正在将堪萨斯城一栋建筑改造为24兆瓦级AI专用数据中心,预计2026年初将部署超1万个英伟达新一代Blackwell Ultra GPU并投入运营。
Lambda联合创始人兼CEO史蒂芬·巴拉班强调:“此次融资为开发支撑数百万人使用的吉瓦级AI工厂奠定了基石。”
此次基础设施扩张与同微软签订的数千亿韩元规模云合约形成协同效应。根据双方最新协议,Lambda将在自有数据中心为微软构建数万个GPU的AI基础设施。
在AI需求激增的背景下,Lambda正以差异化策略切入硬件导向的AI云市场。分析认为,其通过大规模投资与技术差异化战略,意在AI专用数据中心市场建立稳固壁垒。英伟达在 AI Infra 峰会上展示 AI 工厂能效优化成果与多项合作Techub News 消息,英伟达超大规模与高性能计算副总裁 Ian Buck 在 AI Infra 峰会上介绍了 AI 工厂效率的最新进展。会上,英伟达与亚马逊 Annapurna Labs 在 NVHBM 高带宽内存技术、与 d-Matrix 在 NVLink Fusion 平台集成方面达成合作。此外,Emerald AI 与硅谷电力公司展示了 AI 工厂灵活负荷项目,Lambda 通过 DSX MaxLPS 将每瓦性能提升 23%,Pinterest 则采用 Blackwell 平台与 Dynamo 推理软件为视觉发现引入对话式 AI。
英伟达强调,AI 基础设施的衡量标准正从峰值性能转向经过验证的每兆瓦智能体令牌数。其 DSX MaxLPS 通过全工厂电力优化,可将每兆瓦令牌数提升高达 1.4 倍。同时,DSX Flex 软件能接收电网信号,自动根据预设的工作负载层级调整能耗,使 AI 工厂可作为灵活的电网资源运行。
(NVIDIA Blog)英伟达推出 DSX 套件优化 AI 工厂能效,可提升 24% 令牌吞吐量Techub News 消息,英伟达在 AI 基础设施峰会上发布 DSX 套件,旨在优化 AI 工厂的每兆瓦产出。该套件包含 MaxLPS、Flex、OS、Sim 及参考设计等组件,其中 MaxLPS 通过动态分配电力,可在固定电力预算下将令牌吞吐量提升 24%。
英伟达合作伙伴 Emerald AI 的 Conductor 平台已与电网协同,成功响应硅谷电力公司超过 200 次需求信号,在保障高优先级 AI 负载的同时自动降低数据中心功耗。英伟达超大规模计算副总裁 Ian Buck 将此作为 AI 工厂效率提升的核心案例。
Lambda 云服务总裁 Dave Ward 表示,该技术验证了突破固定电力预算限制的可行性,能显著提升相同占地面积内的计算密度。英伟达此举旨在不依赖新建输电线路的情况下,解锁美国 AI 工厂所需的电力资源。(NVIDIA Blog)Clichmont CEO 称自建数据中心比租用 GPU 更具战略优势Techub News 消息,AI 基础设施公司 Clichmont CEO Alexis Cathalifaud 在接受采访时阐述了公司自建数据中心而非租用 GPU 的战略。他认为,GPU 迭代迅速且贬值快,而具备电力、土地、冷却和网络连接的实体基础设施是更持久的战略性资产,能提供对计算经济性的控制权。
Cathalifaud 表示,当需求激增时,租用 GPU 的访问可能变得昂贵或受限。而拥有基础设施则让公司能自主决定部署何种 GPU、升级时间、安装密度以及商业化方式,且同一设施可适配多代 GPU。他强调,稀缺资源正逐渐从 GPU 本身转向大规模为数千 GPU 供电的能力。
Clichmont 的 $CLAI 代币在其更广泛的生态系统中扮演角色。该公司认为,与 CoreWeave、Crusoe 和 Lambda 等专注于 GPU 租赁的竞争对手不同,控制和拥有物理基础设施将是更关键的长期瓶颈。 (NewsBTC)Anthropic 与 Lambda 达成 350 亿美元云计算协议Techub News 消息,Anthropic 已与 Lambda 达成价值 350 亿美元的云计算协议,该交易由 Nvidia 支持,涉及 Hut 8 在德克萨斯州新建数据中心的租赁权。Nvidia 将持有该数据中心租约,Lambda 负责采购英伟达硬件并向 Anthropic 提供云服务。
Hut 8 同时运营比特币挖矿和数据中心业务,此次交易显示 Nvidia 正扩展其 AI 芯片销售以外的角色,通过帮助新兴云服务商获取数据中心容量和融资。该公司本月早些时候还与 Nvidia 支持的 Nscale 达成 450 亿美元独立协议。(CryptoBriefing)Anthropic 与英伟达投资的 Lambda 签署 350 亿美元算力协议Techub News 消息,AI 公司 Anthropic 与英伟达投资的云服务商 Lambda 签署了一项价值 350 亿美元的算力协议。该协议旨在为 Anthropic 的 Claude AI 模型提供更多英伟达芯片算力,以满足其日益增长的需求。
(Tech in Asia)Neocloud Lambda 获 10 亿美元私募债融资,用于购买英伟达 AI 芯片并租赁给微软Techub News 消息,AI 基础设施公司 Neocloud Lambda 已筹集 10 亿美元私募债务融资,资金将用于购买英伟达 AI 芯片,并租赁给微软。这是该公司近期一系列贷款中的最新一笔,凸显了 AI 热潮下的高昂成本。(TechCrunch)Lambda 拟融资 30 亿美元为潜在公开上市做准备Techub News 消息,GPU 云计算公司 Lambda 正在洽谈融资 30 亿美元,以为潜在的公开上市做准备。此举预计将在 2026 年显著影响 GPU 云计算市场的竞争格局。
(Crypto Briefing)比特币生态稳定币协议 Lambda 完成 180 万美元天使轮融资Techub News 消息,比特币生态稳定币协议 Lambda Finance 完成 180 万美元天使轮融资,参投方包括 Curve CEO Michael Egorov、Hashcow、AladdinDAO、A TEAM DEFI、DLC.Link、Threshold Network 等。Dunamu子公司Lambda256因业绩不佳更换CEO金色财经报道,据业内人士11日透露,区块链研究机构Lambda256已转为独立代表制,从本月1日起任命ChungJung-jeong和ParkYong-shin为CEO。前任首席执行官ParkJae-hyun已于上月辞职。Chung是一位开发专家,曾任Kakao首席技术官(CTO)。ParkYong-shin是一位具有公共管理背景的金融专家,曾担任Heungkuk投资信托管理公司的负责人。 Lambda256是Dunamu的子公司,Dunamu持有该公司60.6%的股份。该公司2020年净亏损21亿韩元(156.89万美元),2021年净亏损37亿韩元(276.43万美元),2022年净亏损465亿韩元(3474万美元)。
据《商业内幕》报道,Anthropic已经选定纳斯达克作为上市地点,目标10月启动路演,11月挂牌。路透社12日披露,英伟达正以基石投资者身份洽谈参与,出手就是最高100亿美元。 Anthropic这轮IPO计划募资最高1000亿美元,目标估值约2万亿美元。什么概念?SpaceX今年6月在纳斯达克上市,募资863亿美元,估值1.77万亿——已经是史上最大IPO了。Anthropic想把这个纪录再往上拉一个台阶。 高盛、摩根大通、摩根士丹利三家联手做主承销商。6月1日就已秘密向SEC提交了S-1草案。 英伟达:又卖芯片又投钱 英伟达这步棋下得精。 100亿美元的基石投资,占总募资额的10%。基石投资者是在股票面向公众发售之前就预先承诺认购的机构,核心作用是给市场"打样"——你看,我英伟达都押了100亿,你敢不买? 但问题在于,英伟达本来就是Anthropic最大的芯片供应商。Claude模型的训练和推理全靠英伟达的GPU跑。2025年11月,英伟达已经宣布投资Anthropic最高100亿美元,Anthropic则承诺采购300亿美元由英伟达芯片驱动的微软Azure算力。 现在又要以基石投资者身份再投100亿。 供应商变成了股东,股东投的钱又变成了供应商的收入。这不是套娃,这是闭环。 更绝的是,Anthropic还跟英伟达支持的云厂商Nscale签了450亿美元算力协议,又跟同样有英伟达背景的Lambda签了350亿美元。加上亚马逊超过1000亿美元的AWS十年合同和谷歌的TPU租赁——Anthropic本质上在用英伟达的钱,买英伟达的芯片,跑自己的模型,再把收入的一部分还给英伟达。 永动机也不过如此了。 营收:数字很炸,但得拆开看 循环归循环,营收数据确实炸裂。 Q2营收115亿美元,去年同期7.87亿,增长15倍。年化营收从年初的90亿飙到7月的650亿美元,半年翻了7倍多。毛利率超过80%,Q2调整后营业利润首次转正,达到5.59亿美元。 但注意,"调整后营业利润"是个有弹性的词。 调整后意味着剔除了股权激励、训练成本等一大堆开支。有分析师直接给这个指标起了个外号叫"EBTIT"——Earnings Before Training, Interest, and Taxes(训练、利息和税前利润)。公司自2021年创立以来累计净亏损超百亿美元,从没在任何一个完整财年赚过钱。 管理层自己还告诉投资者,下半年因为算力和训练投入加大,大概率不会再盈利。 所以这个"首次盈利",更像是一道精心调整后的财务表演。 估值:市场在赌一个你看不到的数字 2万亿除以650亿年化营收,PS(市销率)约31倍。 但投资者讨论的不是650亿。他们看的是2028年的预期——公司预计2028年营收1900亿到2000亿美元。按那个算,PS约10倍,"好像没那么贵了"。 问题是:你要相信一家公司能在两年内把收入做到现在的三倍,还要维持5%以上的运营利润率。 纽约大学金融学教授Aswath Damodaran直接说了:这个估值"已触及合理边界,甚至超出了可信范围"。 最讽刺的一幕 最有意思的地方来了。 就在Anthropic冲刺IPO的同时,CEO达里奥·阿莫代伊公开呼吁:AI行业需要放慢最先进模型的开发速度。理由是AI能力的发展已经超过了安全措施。 Sam Altman表示支持。马斯克也发了声。OpenAI直接表态今年不上市。 然后Anthropic一边喊刹车,一边踩油门冲上市。 矛盾吗?其实不矛盾。踩刹车的是前沿模型的能力竞赛——最危险的那些东西,确实该慢一慢。但商业化不能停。Claude卖给企业,该赚的钱照赚。 只不过,两条路线的分歧已经很明显了。OpenAI选择不上市,Anthropic选择上。两条路最终都要面对同一个裁判:市场和投资者。 结语 2026年美股IPO市场已经疯了。剔除空白支票公司,今年募资总额1606亿美元,2021年以来最高。SpaceX、SK海力士之后,Anthropic又来了。 这不是结束,AI时代的资本大戏可能才刚开场。 但真正值得盯的不是"2万亿贵不贵"——而是那个循环能不能转下去。 英伟达卖芯片赚的钱,投给Anthropic。Anthropic拿钱买GPU做营收,营收增长推动估值,估值支撑IPO,IPO回馈英伟达的投资。 只要模型能力还在涨、企业需求还在扩、资本信心还在,这个循环就能转。但任何一个环节松动——芯片降价、需求放缓、或者有人发现"原来利润是这么算出来的"——整条链子就会开始发抖。 Anthropic的IPO,本质上是对整个AI行业循环投资逻辑的一次压力测试。 市场很快会给答案的。

