
Loading...

Loading...
 Perplexity AI 创始人 Aravind Srinivas(阿拉文德·斯里尼瓦桑):重塑搜索与工作的 AI 代理时代撰文:Techub News 整理
导语
2025 年 9 月,AI 搜索引擎独角兽 Perplexity AI 的创始人兼 CEO Aravind Srinivas(阿拉文德·斯里尼瓦桑)再次做客知名播客「Silicon Valley Girl」,进行了长达 41 分钟的深度对话。此次对话背景尤为特殊:距离他上次接受采访仅过去约九个月,但 Perplexity AI 的估值已从彼时的约 1.5-5 亿美元,飙升至惊人的约 200 亿美元,实现了真正的指数级增长。本次访谈的核心,不仅在于复盘公司的爆发式发展,更在于探讨其2025 年 9 月发布的革命性产品——Comet,这款被定位为「首款能思考并为你行动的 AI 浏览器」,以及它背后所预示的、一个由 AI 代理主导的未来生活与工作图景。
摘要
Perplexity AI 的增长秘诀在于「每日 1% 改进」的复利思维,以及对产品品质和用户反馈的极度专注。
新推出的 Comet 浏览器是「AI 首次掌握在用户手中」,它能进行多步推理、跨应用操作(如研究、购物、安排会议),并基于用户记忆与偏好行动,保护用户免受传统广告排名算法的影响。
AI 代理(如 Comet)将颠覆金融顾问、房地产中介等依赖信息差的职业,迫使这些行业提供更深层的价值。
在 AI 时代,个人成功的关键在于「深入学习某一领域并建立自信」,而非盲目追求学历;博士学位(PhD)的核心价值在于「学会学习」。
当前的 AI 创业环境已非常艰难,成功的关键是「为自己而构建」,投身于自己真正痴迷的领域,并做好与巨头竞争到底的准备。
指数级增长:从 1.5 亿到 200 亿美元的「复利」秘诀
当被问及如何用一个词形容 Perplexity AI 过去几个月的经历时,Aravind Srinivas(阿拉文德·斯里尼瓦桑)毫不犹豫地选择了「Exponential」(指数级)。他揭示了公司背后的核心运营哲学:每日 1% 的复利式改进。他用一个数学公式阐释了这一理念:1.01 的 365 次方约等于 37.78。这意味着,如果团队每天能让产品进步 1%,一年累积下来的提升将是惊人的 3700%。
这种改进并非空洞的口号,而是落实到创始人日常的极致专注中。Srinivas 分享道,他每天醒来第一件事就是阅读用户在各大社交平台上的反馈,并确保大多数问题能立即得到处理。这种对用户声音的快速响应和持续优化,虽然看似是琐碎的「bug 修复」和需求筛选,但日积月累,形成了强大的产品迭代飞轮。用户能切身感受到产品「每周都在变好」——更快、更简洁、更准确,从而建立起深厚的信任,并通过口碑带来更多新用户。
除了产品本身,Perplexity AI 在品牌建设上也独具匠心。Srinivas 提到与 F1 冠军车手 Lewis Hamilton(刘易斯·汉密尔顿)的合作,其灵感来源于 Steve Jobs(史蒂夫·乔布斯)著名的「Think Different」广告战役和 Nike 对伟大运动员的致敬。他们刻意将品牌与各领域「最伟大的人」关联,以塑造高端、智慧的形象。Srinivas 认为,F1 是一项高度工程化的「脑力运动」,其观众群体与 Perplexity AI 追求知识、注重效能的用户画像有很高的重合度。这种品牌合作虽然难以直接追踪安装量转化,但对提升品牌认知度和美誉度至关重要。
Comet:掌握在用户手中的「反巨头」AI 代理
推动 Perplexity AI 近期增长的一个关键事件,是其在 7 月发布了名为 Comet 的 AI 浏览器。Srinivas 强调,这是第一次,AI 的力量真正掌握在用户手中,而非科技巨头手中。
他现场演示了 Comet 的「杀手级」功能:多步骤推理与无缝执行。例如,用户只需用自然语言提出「找到黄仁勋(Jensen Huang)说‘我宁愿折磨员工追求卓越也不愿解雇他们’的那个视频,并从那个时间点开始播放」,Comet 便能理解指令,执行搜索、定位视频、拉取文字稿、打开标签页并开始播放等一系列操作。更进一步,用户还可以就视频内容与 Comet 对话,例如询问「黄仁勋在这次访谈中说了哪些非老生常谈的新观点?」,Comet 会快速分析长达一小时的文字稿,提炼出关键信息。
Comet 的能力远不止于此。它可以:
自动化信息处理:读取大量评论、观看视频,为用户综合购买建议。
直接执行任务:根据指令发送邮件、安排会议,甚至研究并购买商品(例如「从亚马逊上订购黄仁勋穿的那件皮夹克」)。
个性化写作辅助:Srinivas 曾让 Comet 分析 Steve Jobs(史蒂夫·乔布斯)和黄仁勋的演讲风格,并结合他自己的讲话习惯,润色一份演讲稿,使其更具感染力而不失真实,其效果「值得支付 1000 美元」。
Srinivas 指出,Comet 与 Google、Amazon 等平台的根本区别在于利益对齐。传统平台使用 AI 进行搜索排名和商品推荐,本质是为广告商优化,影响甚至操纵用户以促成购买。而 Comet 这类用户手中的 AI 代理,其首要任务是保护用户利益,为用户服务。用户可以指令 Comet 跳过所有广告,仅基于产品真实口碑和用户个人偏好(预算、需求、历史记忆)做出决策。
展望未来,Srinivas 描绘了 AI 代理主导的商业模式变革。他提出一种新颖的「三方共赢」广告设想:广告商可以向用户的 AI 代理推送信息(例如,一个新款麦克风厂商联系播客团队的 AI 助理),但代理会根据与用户的「握手协议」决定是否采纳。更重要的是,广告收入的一部分可以返还给用户,以此建立更高的信任和用户终身价值。他认为,所有道路都将指向广告利润率的下降,因为用户第一次拥有了可以为自己利益服务的智能工具。
AI 时代的职业冲击:从金融顾问到房地产中介
Srinivas 毫不讳言 AI 对许多职业,尤其是入门级和中介型岗位的冲击。他以自身使用 Perplexity 分析投资组合为例,AI 能够快速阅读所有分析师报告和新闻,给出重新平衡组合的具体策略,甚至模拟「如果是沃伦·巴菲特(Warren Buffett)持有你的组合会怎么做」。这使得那些仅提供标准化投资建议的金融顾问价值骤减。
「人们需要提供更深层次的价值,」Srinivas 说。金融顾问如果仅管理公开市场股票组合,其作用将被 AI 超越。但如果他们能提供独特的渠道价值,如接触私募股权、对冲基金或初创企业投资机会,则仍有存在空间。同样,房地产中介若仅能提供已在 Redfin 或 Zillow 上公开的房源信息,其价值也将被能够自动监控房源、提交申请并安排看房的 AI 代理取代。他们的出路在于处理「场外交易」等非公开信息。
这一逻辑适用于所有行业:AI 赋予了用户前所未有的信息和执行能力,中介必须提供超越信息搬运的增值服务,否则将被淘汰。Srinivas 建议从业者思考:「你拥有这个新工具(指AI),应该去要求那些收取你费用的人为你做更多的工作。」
给年轻人的建议:在 AI 时代,如何投资自己?
面对「如果今天你18岁在美国重新开始,还会选择读本科和博士吗?」这个问题,Srinivas 的回答既现实又深刻。
他首先坦承,自己当年攻读博士(PhD)的一部分原因是这是通往美国的免费途径(博士项目提供资助,而硕士需要自费)。但他认为,博士学位的核心价值在于「学会学习」——掌握深入研究一个新领域、收集信息、咨询专家(现在可能被 AI 工具部分替代)并做出决策的能力。这种能力使人变得「grounded」(脚踏实地),并养成寻求真理、不断追问的苏格拉底式学习习惯。
然而,对于纯粹以职业发展为目标的人来说,他并不认为博士学位是 AI 时代贡献或创业的必要条件。他给年轻人的核心建议是:选择一件事,深入投入一两年,做到顶尖水平。这可以是编程、数学、AI 或开发应用程序。关键在于通过做成一件难事,建立起「无论做什么都能做好」的内在自信。
「你需要至少有一次这样的经历,才能对人生中下一个艰难任务押注自己,」Srinivas 说。这种自信,也是他面对 Google、OpenAI 等资金雄厚、收入庞大的「巨兽」级竞争对手时,依然坚信 Perplexity 能杀出血路的底气来源。他形容这场竞争如同「鱿鱼游戏」,幸存者寥寥,而坚持到底需要巨大的信念。
AI 创业的残酷现实与唯一出路
对于当前有志于 AI 领域的创业者,Srinivas 描绘了一幅相当严峻的图景。他认为,现在从头训练自己的大模型「几乎不可能」,因为这不仅仅是训练一个模型,而是需要持续迭代、降低成本、提升能力的全套实验室、算力集群和人才体系,本质上是在打造另一个 OpenAI 或 Anthropic。
即使退一步,基于现有大模型(如 GPT)开发应用产品(所谓的「wrapper」),竞争也异常激烈。因为不仅其他初创公司在做,大模型实验室本身(如 OpenAI)、科技巨头(如 Google)以及像 Perplexity 这样的成长型公司,最终都会向任何可行的垂直领域扩张。「没有人会说‘Perplexity 只做研究,那我去做电商吧’——不,所有人都在构建横向产品。」
那么,机会何在?Srinivas 的答案回归到最根本的创业哲学:「为你自己而构建」。创业者应该投身于自己真正痴迷、愿意不计一切代价去解决的问题。这不是对市场或竞争格局的赌博,而是对自我的赌博。只有当创始人比世界上任何人都更在乎某个问题,并深潜其中时,才有可能在巨头环伺的环境中开辟出一条生路。「对于我来说,我最爱学习,而 Perplexity 是最好的学习工具之一——它最初就是为我们自己设计的。」
最后,当被问及自己日常使用的 AI 应用时,Srinivas 的回答颇具深意:除了因工作需要测试 ChatGPT、Claude、Gemini 等所有主流模型外,他个人的首选是 Perplexity 和 Google(用于一些非常特定的传统搜索技巧),以及 Midjourney(用于图像生成)。但他随即补充道,Comet 的目标正是成为一个「超级应用」或「万物应用」,用户未来无需单独打开这些应用,只需向 Comet 发出指令,它就能调用所需的一切功能完成任务。这或许才是 Perplexity AI 挑战科技巨头的终极愿景。
 Google DeepMind CEO Demis Hassabis(德米斯·哈萨比斯):世界模型、AGI 时间表与 AI 驱动的科学革命撰文:Techub News 整理
导语
2025 年 9 月,谷歌 DeepMind 的联合创始人兼 CEO 德米斯·哈萨比斯(Demis Hassabis)做客知名科技播客 All-In Podcast,进行了一场信息量极大的深度对话。作为 AlphaGo、AlphaFold 等里程碑式 AI 项目的核心推动者,以及 2023 年诺贝尔化学奖的共同得主,哈萨比斯一直是全球人工智能领域的灯塔人物。此次对话中,他不仅分享了获得诺奖的幕后故事,更系统地阐述了谷歌 DeepMind 的最新进展、对 AGI(通用人工智能)路径的思考,以及 AI 如何重塑科学、娱乐乃至人类社会的基础架构。在 AGI 浪潮席卷全球、科技巨头激烈角逐的背景下,哈萨比斯的见解无疑具有极高的参考价值。
摘要
世界模型是通往 AGI 的关键一步:Genie 等模型通过海量视频学习“直观物理”,无需预设物理引擎即可生成动态交互世界,这对机器人技术、智能眼镜助手至关重要。
AGI 可能还需 5-10 年:哈萨比斯认为当前 AI 尚缺乏真正的创造力、持续学习和一致性推理能力,需一两个关键突破才能达到真正的通用智能。
AI 将开启“科学新文艺复兴”:从药物发现(Isomorphic Labs)到材料设计、聚变控制,AI 将成为终极科学工具,其长远贡献将远超其当下的能耗。
人形机器人有独特价值:对于需要融入人类环境(家庭、办公室)的通用机器人,人形形态可能比专用形态更具实用性和适配性。
AI 赋能创作的两面性:既极大降低了普通人创作的门槛,也超级赋能顶级专业人士,催生“共同创造”的新娱乐形态。
从 AlphaFold 到诺奖:AI 驱动科学的起点
访谈从哈萨比斯获得诺贝尔化学奖的非凡经历开始。他描述接到来自瑞典的电话时“恍如隔世”,那是每个科学家梦寐以求的时刻。在斯德哥尔摩的颁奖周,最令他震撼的是在一本保存了120年的诺奖得主签名簿上,将自己的名字签在费曼、居里夫人、爱因斯坦、尼尔斯·玻尔等伟人之旁。哈萨比斯坦言,尽管有关于 AlphaFold 可能获奖的传言,但诺奖委员会对保密工作的极致要求,以及奖项更看重科学突破的实际影响力(这往往需要二三十年的沉淀),使得一切直到电话响起前都是未知数。AlphaFold 破解蛋白质结构预测难题,正是哈萨比斯从童年起就怀有的梦想——利用 AI 加速科学发现的完美例证。这枚诺奖奖章,不仅是对他个人和团队的认可,更是标志着 AI 正式成为基础科学发现的核心引擎。
谈及谷歌 DeepMind 在 Alphabet 中的定位,哈萨比斯将其比喻为“整个谷歌和 Alphabet 的引擎室”。自几年前谷歌内部所有 AI 力量(包括原 DeepMind)合并为 Google DeepMind 以来,团队规模已达约 5000 人,其中超过 80% 是工程师和博士研究员。Gemini 是他们构建的核心模型,此外还包括视频模型、交互式世界模型等多种 AI 系统。这些模型已经深度集成到谷歌几乎所有的产品和服务中,从 AI Overview、AI 模式到 Gemini 应用,每天有数十亿用户在与他们的 AI 技术互动。这种“前沿研究”与“数十亿规模落地”的结合,构成了谷歌 DeepMind 独特的优势。
Genie 与世界模型:让 AI 理解物理世界
对话的核心很快转向了谷歌 DeepMind 最新发布的一类革命性模型——“世界模型”,其代表便是 Genie。哈萨比斯现场展示了一段 Genie 生成的视频:用户仅通过一个文本提示(如“在鸡套装里的人”或“喷气式滑艇”),就能生成一个完全交互式的 3D 环境。用户可以使用方向键和空格键实时控制视角,探索这个世界。关键之处在于,所有像素都是实时生成,不存在于任何预设的视频或游戏中。当角色转头看向一个方向,那一侧的景物才被即时创造出来,并且保持物理一致性(例如之前墙上的涂鸦会保留)。
哈萨比斯解释道,Genie 模型通过观看互联网上数百万计的 YouTube 等视频,反向工程了“直观物理”。它并非基于传统的 3D 渲染引擎(如 Unity 或 Unreal),也没有被预先编程物理定律。相反,它纯粹从 2D 图像序列中学会了世界如何运作的复杂规律,包括光影反射、材质流动和物体行为。作为一名在 90 年代曾亲手编写游戏引擎和物理系统的前游戏开发者,哈萨比斯对 Genie 能如此“轻而易举”地完成这一切感到“极其震撼”。
为什么世界模型如此重要?哈萨比斯指出,要构建真正的 AGI,系统必须理解我们周围的物理世界,而不仅仅是抽象的语言或数学世界。这对于机器人技术、智能眼镜助手等应用至关重要。一个能帮助日常生活的智能眼镜助手,必须理解使用者所处的物理环境及其背后的物理规律。世界模型的突破,正是为 AI 系统装上了理解物理世界的“感官”和“常识”。他预测,随着 Genie 这类模型的进化(Gen 4, Gen 5…),它们将越来越逼近对现实世界的深刻模拟。
机器人、AGI 时间线与缺失的拼图
世界模型的自然延伸便是机器人技术。哈萨比斯介绍了他们基于 Gemini 微调而来的“Gemini 机器人模型”。在演示中,一个拥有两只机械臂的桌面机器人,能够理解“把黄色物体放进红色桶里”这样的自然语言指令,并将其转化为精准的动作序列。这体现了多模态模型的威力——它能将真实世界的理解融入与机器人的交互中,而不仅仅是依赖机器人专用的、狭窄的模型。
对于机器人的形态,哈萨比斯的观点发生了变化。他过去认为特定任务应有专用形态的机器人,但现在认为,人形机器人对于需要在人类设计的环境中工作的通用机器人具有重要意义。台阶、门把手、工具——我们的物理世界是为人类身体设计的。与其改变整个世界的设计,不如让机器人适应我们已有的环境。当然,在工业生产线或实验室等特定场景,专用形态的机器人仍是最优解。
关于 AGI(通用人工智能)的到来时间,哈萨比斯给出了相对审慎的估计。他认为当前顶尖的 AI 模型(包括他自己公司的)远非“博士级智能体”。它们在某些任务上表现出博士生水平的能力,但缺乏通用性和一致性,例如可能在高中学的数学或简单计数上犯低级错误。真正的 AGI 应该能全面达到高水平表现。
在他看来,通往 AGI 还缺少几个核心拼图:一是真正的创造力,即像爱因斯坦提出狭义相对论那样,从已知知识中进行“直觉飞跃”,提出全新的猜想或理论;二是持续学习能力,能够在线学习新知识并调整行为;三是更强的推理和一致性。哈萨比斯预测,可能还需要“一两个关键性突破”,时间尺度大约在5到10年。这与行业某些更为激进的预测(如几年内)形成了对比。
科学革命与能源挑战:AI 的长期回报
作为科学家,哈萨比斯始终坚信 AI 最崇高的使命是加速科学发现,应对人类面临的重大挑战。除了 AlphaFold,谷歌 DeepMind 的 AI 系统已应用于材料设计、聚变反应堆等离子体控制、天气预报、解决奥林匹克数学竞赛级别难题等多个科学分支。他领导的 Isomorphic Labs(从 DeepMind 分拆)正致力于基于 AlphaFold 的突破,彻底改革药物发现流程,目标是将耗时数年甚至十年的新药研发周期缩短至几周甚至几天。目前他们已与礼来、诺华等制药巨头合作,并预计明年将有候选药物进入临床前阶段。
针对当前热议的 AI 能耗问题,哈萨比斯认为存在“两个真相”。一方面,谷歌 DeepMind 自身因为需要每天为数亿用户高效提供 AI 服务(如 AI 概述),在模型效率优化上投入巨大,通过蒸馏等技术,过去两年相同性能下的模型效率提升了10倍甚至100倍。但另一方面,为了向 AGI 前沿推进,研究团队仍需不断用更大规模的数据和算力训练新的模型,这会推动总需求上升。他乐观地认为,从长远来看,AI 在优化电网、设计新材料和新能源、应对气候变化等方面的贡献,将远超其自身运行所消耗的能源。AI 是解决问题的手段,而不仅仅是问题的来源。
创作民主化与未来娱乐形态
除了硬核科技,哈萨比斯也展望了 AI 对文化和娱乐的冲击。像 Imagen、Veo 这样的顶级视频生成模型,以及“Nano Banana”这类拥有出色指令跟随一致性的图像生成工具,正在带来“创作民主化”。普通人无需再像过去那样啃读厚厚的 Photoshop 教程,只需用语言描述想法,就能进行创作。
但同时,AI 也在“超级赋能”顶级专业人士。哈萨比斯提到他们正与著名导演达伦·阿伦诺夫斯基等顶尖创作者合作。这些工具让专业创意人士能够以前所未有的速度尝试各种构思,生产力提升十倍甚至百倍,最终更快地实现他们脑海中最完美的愿景。他预见未来将出现一种融合了“共同创造”元素的新娱乐形式或艺术类型:顶级创意愿景家构建引人入胜的动态故事世界,而成千上万的用户可以在其中共同创造部分内容,主创者则扮演这个世界的“总编辑”。
未来十年:一个“科学新文艺复兴”
当被问及对未来十年的展望时,哈萨比斯承认在 AI 领域预测十周都充满挑战,更不用说十年。但他坚信,如果未来十年内我们能实现真正的 AGI,那将开启一个“科学的新文艺复兴”或“黄金时代”。从能源到人类健康,社会的方方面面都将受益于这个终极科学工具带来的突破。这不仅仅是一次技术升级,而是一场深刻重塑人类文明认知边界和能力极限的革命。德米斯·哈萨比斯和他领导的谷歌 DeepMind,正站在这场革命的最前沿。
 Perplexity CEO Aravind Srinivas(阿拉温德·斯里尼瓦桑):我们为何能挑战谷歌撰文:Techub News 整理
导语
在 Y Combinator 广受欢迎的访谈节目《How To Build The Future》最新一期中,主持人 David 对话了 AI 搜索新贵 Perplexity 的联合创始人兼 CEO Aravind Srinivas(阿拉温德·斯里尼瓦桑)。Perplexity 在不到三年时间里,从零成长为估值超过 90 亿美元的明星公司,其「对话式答案引擎」模式被视为对传统搜索引擎最具潜力的挑战之一。本次对话深入回溯了 Aravind Srinivas(阿拉温德·斯里尼瓦桑)从 AI 研究员到创业者的心路历程,揭示了 Perplexity 产品迭代背后的关键决策,并展望了在巨头环伺的 AI 搜索赛道中,一家初创公司如何凭借独特的产品哲学找到生存与发展之路。
摘要
Perplexity 的创立源于一个「AI 完备性」的洞察:只有像搜索和自动驾驶这样,产品迭代能直接反哺底层 AI 能力进步的领域,才适合同时进行 AI 研究和产品构建。
产品成功的关键转折点在于放弃了为垂直领域构建复杂索引的「聪明」方法,转而采用依赖大模型能力进行实时处理的「笨」方法,这意外地解决了延迟和通用性问题。
与谷歌竞争的核心优势并非技术,而是对用户体验的极致关注和「用户永远没错」的产品设计哲学,这在大公司因组织架构和商业模式而难以贯彻。
Perplexity 的长期愿景是构建一个能理解用户意图、整合答案与行动(如购物、预订)的端到端智能信息体验,这需要复杂的 AI 路由与编排能力。
公司保持敏捷的文化面临挑战,但通过创始人亲力亲为关注细节、数据驱动的指标管理(如每日查询量)以及扁平化的沟通来对抗熵增。
从研究员到创业者:AI 完备性的启发
Aravind Srinivas(阿拉温德·斯里尼瓦桑)的 AI 之路始于在印度读本科时对深度学习的兴趣,这促使他来到加州大学伯克利分校攻读博士学位。他的人生转折点发生在 OpenAI 的实习期间,与联合创始人兼首席科学家 Ilya Sutskever(伊利亚·苏茨克韦)的一次会面。他准备了各种「花哨」的研究想法,但 Ilya Sutskever(伊利亚·苏茨克韦)在听了五分钟后直言「所有这些都没用」,并画了两个圆圈:一个大圈代表无监督学习,里面一个小圈代表强化学习。Ilya Sutskever(伊利亚·苏茨克韦)告诉他,「这就是 AGI(通用人工智能),其他研究都不重要。」 当时 OpenAI 正在构建 GPT-1 的前身。这次对话让 Aravind Srinivas(阿拉温德·斯里尼瓦桑)意识到,自己当时专注的强化学习(因 AlphaGo 而热门)可能是在追逐潮流,他随即转向研究无监督和生成式模型。
在谷歌实习期间,他读到了讲述谷歌早期历史的书《In the Plex》,深受触动。他意识到,将前沿 AI 研究与扎实的产品构建相结合是极其困难的。他与 Ilya Sutskever(伊利亚·苏茨克韦)讨论后得出一个观点:世界上可能只有两类问题能同时满足 AI 研究和产品构建——搜索和自动驾驶汽车。因为在这两个领域,产品的每一次部署和用户使用都会成为改进底层 AI 模型的数据点,从而形成「产品更好 - 更多用户 - 更多数据 - AI 更好 - 产品更好」的飞轮。更重要的是,这类问题处于「AI 完备性」路径上,即 AI 能力的进步会直接让公司的产品变得更强,而不是被更先进的 AI 所颠覆。
创业起点:从「颠覆谷歌」的模糊野心中诞生
有了创业的想法,但如何获得启动的能量?Aravind Srinivas(阿拉温德·斯里尼瓦桑)提到,他受到前 YC 合伙人 Daniel Gross 一篇题为《如何打造下一个谷歌》博客的启发。博客核心观点是,通过更好的查询重构(例如为电影评论查询自动添加「site:rottentomatoes.com」后缀),即使利用现有的谷歌排名,也能大幅提升搜索体验。他意识到,大语言模型或许能自动完成这种复杂的查询重构,成为构建新一代搜索引擎的基础。
与此同时,他与后来的联合创始人兼 CTO Denis Yarats(丹尼斯·亚拉茨)因几乎同日发表同一篇论文而相识,两人经常讨论如何构建能控制安卓环境的 AI 代理。然而,当他把「颠覆谷歌」的想法告诉潜在投资者时,得到的第一个反馈通常是:「谷歌自己难道不会做这个吗?」 毕竟搜索是谷歌的「皇冠上的明珠」,不像文档处理那样是次要业务。Aravind Srinivas(阿拉温德·斯里尼瓦桑)承认,当时他们更多是被一个具有宏大规模和野心的想法所吸引,而非单纯抱着「杀死谷歌」的动机。他们也意识到,在多模态模型开始兴起的技术轨迹上,有机会构建出惊人的产品。
在投资者的建议下,他们最初并未直接挑战通用搜索,而是专注于垂直领域和企业搜索,例如搜索特定数据库或 Crunchbase 的数据。然而,他们发现没有公司愿意轻易交出数据。于是,他们转向了当时仍允许学术访问的 Twitter(现 X)数据。他们利用 OpenAI 的 Codex 模型(早于 GPT-3.5),构建了一个能将自然语言查询转换为 SQL、并从整理的 Twitter 数据表中检索和绘制图表的聊天界面。这个 demo 在短短一个月内由三人小团队完成,因其前所未有的交互方式和「社交搜索」的趣味性(如查看某人本周关注或取关了谁)而获得了早期关注。
关键转折:拥抱「笨」方法,押注模型进步
在尝试为 GitHub、LinkedIn 等更多数据源构建类似垂直搜索工具时,团队遇到了数据获取和产品化的巨大阻力。此时,他们意识到一个更根本的解决方案:与其为每个领域费力构建结构化索引(如表格),不如保持数据非结构化,将所有繁重的工作交给大模型在查询时(推理时)完成。这看似是更「笨」、更依赖模型能力的方法,但却更通用、更可扩展,也更能对抗谷歌已建立的庞大传统索引系统。
他们受到 OpenAI 研究员 John Schulman(约翰·舒尔曼)团队早期项目「WebGPT」的启发,但 WebGPT 使用 1750 亿参数的模型,且采用类似智能体(Agent)的方式去点击、滚动网页,速度极慢。Perplexity 团队反其道而行之,采用了更简单的启发式方法:总是从搜索 API 获取排名靠前的链接,只使用搜索引擎已缓存的摘要片段(无需点击滚动),然后将所有这些信息一次性喂给大模型,要求它生成带有学术格式引用的摘要。
这个策略的成功极度依赖于模型指令遵循能力的提升。 Aravind Srinivas(阿拉温德·斯里尼瓦桑)坦言,如果早一年尝试这种「笨」方法,由于模型能力不足,根本不会奏效,人们会得出结论需要更「聪明」的架构。但恰逢 GPT-3.5 Turbo 这类模型出现,指令遵循能力大幅增强,使得简单方法变得可行,并一举解决了核心的产品用户体验问题——延迟。即便如此,他们最初推出的答案生成版本仍需约 7 秒,且无法控制回答的冗长度,后来不得不通过提示词硬性限制回答字数来提速。
产品验证与竞争觉醒:在巨头阴影下找到空间
Perplexity 的第一个「出圈」时刻颇具戏剧性。产品发布后,一位学者搜索自己的名字,结果模型给出了过去式的传记,原因是存在同名同姓的已故人士。这位学者发推「吐槽」自己还活着,却意外为 Perplexity 带来了大量关注。人们开始热衷于搜索自己,模型会汇总他们全网的历史活动并生成有趣摘要,用户乐于截图分享。随后,团队上线了追问功能,这使网站的用户参与时间和每日提问数量呈指数级增长,让 Aravind Srinivas(阿拉温德·斯里尼瓦桑)确信产品找到了市场契合点,不应再转向企业服务。
真正意识到与巨头竞争的严峻性,是在融资的关键时刻。就在与一家风投机构握手达成投资意向几天后,微软 Bing Chat 的界面截图被泄露。紧接着,另一家有意向的投资者将尽职调查期从 30 天悄悄延长至 45 天。一周后,谷歌 CEO Sundar Pichai(桑达尔·皮查伊)宣布推出 Bard。一时间,山雨欲来。Aravind Srinivas(阿拉温德·斯里尼瓦桑)甚至考虑过出售公司。然而,最初握手的那位投资者坚持了承诺,没有要求他们转型,这给了团队信心。
他们冷静分析了竞争格局:微软长期以来并不擅长消费级产品,谷歌则面临自身挑战——无法轻易将类似 Perplexity 的体验直接放到已有数十亿用户的、布满广告和各类信息模块的谷歌主页上。这为独立玩家留下了生存空间。Aravind Srinivas(阿拉温德·斯里尼瓦桑)认为,在纯信息查询上,使用 Perplexity 和谷歌的体验差异,堪比「健康餐」与「快餐」之别。
产品哲学:用户永远没错,细节决定成败
Aravind Srinivas(阿拉温德·斯里尼瓦桑)深受谷歌早期文化的影响,特别是联合创始人 Larry Page(拉里·佩奇)的理念。他反复向团队强调「用户永远没错」的原则。他举例说,当测试新功能遇到模糊查询导致失败时,正确的产品思维不是责怪用户提问不清晰,而是让 AI 主动澄清、询问用户真实意图。这与许多企业软件「教育用户成为更好的提示词工程师」的思路截然相反。神奇的消费级产品属于前一种,它们承担了理解用户的复杂性。
这种对细节的执着渗透到产品各处:确保搜索框光标随时就绪(无需鼠标点击)、追求极致的加载速度。公司的核心北极星指标是「每日查询量」,这与早期谷歌的关注点一致。在每周的全员会议上,他们首先查看的就是这个数字的周增长和月增长趋势。一旦出现下滑,团队会深入分析原因。Aravind Srinivas(阿拉温德·斯里尼瓦桑)认为,用户重复提问并非因为产品无法满足需求(那会导致用户离开),而是因为他们在一个会话中发现了更多想探索的问题,这恰恰是产品吸引力的体现。
在公司文化上,他努力营造一种扁平、专注于做好工作的氛围。他自己每天会提出大量产品 bug,并直接与负责的工程师沟通,没有层级隔阂。他认为,如果创始团队自己都不爱用、不挑剔自己的产品,用户更不会满意。他主要通过 X(原 Twitter)与用户交流,因为那里的反馈「残酷而诚实」,能暴露出最严重的问题。
增长挑战与未来愿景:构建端到端的智能信息体
随着团队规模扩大,Perplexity 也面临着所有公司成长中的挑战:速度变慢。原因包括生产环境问题影响信任、新工程师需要时间熟悉代码库,以及必须引入更严格的测试和 A/B 实验流程。Aravind Srinivas(阿拉温德·斯里尼瓦桑)承认,保持早期那种对细节痴迷的文化随着人员扩张变得困难,但创始人团队仍在努力对抗「熵增」。
谈及未来,他描绘了 Perplexity 的长期图景。目前,Perplexity 是一个在特定场景下更智能的谷歌搜索。但三四年后,他希望它成为一个能理解用户问题、提供最佳答案、并帮助用户完成后续行动的端到端平台。例如,搜索「最好的毛衣」,不仅能得到推荐,还能直接购买;搜索酒店,不仅能比较,还能完成预订。
这其中的巨大挑战在于商业模式和用户认知。如果只是提供答案,而将交易环节导向谷歌,那么 monetization(货币化)的功劳仍属于谷歌。Perplexity 可能仅获得少量订阅收入,且易被资金更雄厚、提供免费服务的对手挤压。要实现闭环,需要构建一个极其复杂的 AI 路由与编排系统,能智能判断何时使用小型模型、知识图谱、插件,何时生成流式答案或多步推理结果。用户不在乎背后的技术栈,他们只想要准确、快速、完整的解决方案。 他认为,谷歌现有的系统是世界上最接近此愿景的,下一代系统必然能被构建出来,但这需要十年甚至更长时间的坚持。
在分析未来十年的竞争对手时,Aravind Srinivas(阿拉温德·斯里尼瓦桑)认为,Perplexity 的核心优势在于对用户的痴迷和优秀的产品品味。谷歌虽有产品品味和一切资源,但其根本困境在于,它既是一家搜索公司,更是一家广告公司,搜索在某种程度上服务于广告业务。高达数百亿美元季度收入的搜索业务,是谷歌高利润和股价的支柱。任何可能动摇这一收入根本的变革(例如让用户直接获得答案而无需点击广告链接),都会在内部遭遇巨大阻力。相比之下,OpenAI 和 Anthropic 等公司更专注于模型本身的能力突破,而非构建精细的端到端用户体验。Perplexity 则兼具 AI 技术理解力(能够利用并微调最新开源模型)和以用户为中心的产品构建 DNA,这可能是其在漫长竞争中占据一席之地的关键。
 Cohere CEO Aidan Gomez(艾丹·戈麦斯):Transformer 架构八年未变,AI 的未来在于企业应用撰文:Techub News 整理
导语
2017年,一篇名为《Attention is All You Need》的论文横空出世,其提出的 Transformer 架构彻底改变了人工智能的发展轨迹,开启了生成式 AI 的浪潮。八年后的2025 年 6 月,这篇论文的八位作者之一、当时还是一名大三本科生的 Aidan Gomez(艾丹·戈麦斯)已成长为估值数十亿美元的 AI 独角兽 Cohere 的 CEO。在 The MAD Podcast 主持人 Matt Turck 的深度访谈中,Gomez 首次详细揭秘了 Transformer 论文诞生背后的“意外”故事,并阐述了他为何坚信企业级 AI 而非追逐 AGI(通用人工智能)才是 AI 技术造福世界的正道。这场对话不仅是对 AI 发展史上关键节点的回顾,更是对当下 AI 商业化路径与未来趋势的一次深刻洞察。
摘要
Transformer 的诞生源于“行政错误”与有机合作:Gomez 进入 Google Brain 实习源于一场误会(其经理误以为他是博士生),而论文的诞生则是几个独立研究小组因共同兴趣自发合并、冲刺会议 deadline 的结果。
Transformer 架构统治力惊人,八年未遇挑战:Gomez 坦言,Transformer 的持久性“令人震惊”,其成功部分源于整个 AI 基础设施(包括芯片)都已围绕其优化,新架构的替代门槛极高。
“推理计算”是重大突破,但潜力远未挖尽:让模型在不同问题上分配不同“思考”时间的“推理计算”范式解锁了巨大能力,且实现成本远低于预训练,未来将在科学、医疗、企业自动化等领域发挥更大作用。
Cohere 押注企业 AI 而非 AGI“宗教”:Gomez 直言不喜欢 AGI 圈子的“角色扮演”和“新宗教”氛围,认为通过 AI 提升人类生产力、降低成本和改善服务(如医疗)才是更有意义的方向。
智能体(Agent)平台“North”是企业 AI 的核心:Cohere 的垂直整合战略使其能提供从底层模型(Command、Embed)到上层智能体平台(North)的全栈解决方案,并特别注重数据安全(支持本地/私有云部署)和多语言/多模态能力。
Transformer 诞生记:一场美丽的“意外”
2017年,还在多伦多大学读大三的 Aidan Gomez(艾丹·戈麦斯)通过一封“cold email”联系上了 Google Brain 的研究员,原因是他反复在阅读的论文作者栏看到这个名字。他提出了自己对论文的一些扩展想法,并由此获得了一个实习机会。“我经理以为我是博士生,”Gomez 回忆道,“所以我想我是通过一个行政错误进去的——我们通常不招本科生。”这个“错误”让他坐到了另一位论文合著者 Noam Shazeer 旁边,并加入了 Lucas Kaiser 的团队。
最初的项目是一个名为“One Model To Learn Them All”的多模态模型。在开发过程中,Gomez 和 Kaiser 构建了一个名为“Tensor2Tensor”的框架用于高效分布式训练,并成功说服了邻座的 Noam Shazeer 使用它。随后,他们发现 Google Translate 团队也在进行类似的研究。“我们意识到大家在做同一件事,”Gomez 说,“我们都关注基于文本的自回归模型,并且更纯粹地利用注意力机制,而不是之前那些复杂且有些‘丑陋’的 RNN、LSTM 模型。”于是,几个小组决定合并力量,专注于打造一个最简单、高效的基于注意力的语言模型——这就是 Transformer 的雏形。
论文的写作过程堪称“疯狂冲刺”。团队为了赶上顶级 AI 会议 NeurIPS 的投稿截止日期,进行了高强度的工作。“我们尝试了无数东西,修补了很多小 bug,”Gomez 举例道,比如最初纯注意力架构无法区分序列中元素的位置信息,是 Noam Shazeer 灵光一现,提出了在嵌入中添加正弦波来表示位置的方法——这个方案至今仍被广泛使用。
论文发表后,在自然语言处理(NLP)和机器翻译的小圈子内引起了兴奋,但当时远未达到后来革命性的广泛认知。对于 Google 为何没有更快地利用 Transformer 架构开发出类似 ChatGPT 的产品,Gomez 澄清道,Google 实际上迅速将 Transformer 应用到了搜索和翻译等核心产品中(如 BERT)。“准确的说法是,他们没有像 OpenAI 那样早期且独特地全力投入互联网文本的纯序列建模(即大规模语言模型预训练)。” Gomez 总结道。
Transformer 为何统治八年?生态锁定与极高的替代门槛
距离论文发表已过去八年,Transformer 架构依然是 AI 领域的绝对主流,这一点连 Gomez 本人都感到“震惊”。“我们今天训练的 Transformer 和当年的看起来如此相似,”他说。他认为,这并非因为研究社区缺乏新想法,而是一个“自我实现的预言”或“强化循环”。
整个 AI 社区对 Transformer 的热情催生了专门为其优化的庞大基础设施堆栈。“我们现在甚至有专门为该架构优化的芯片,”Gomez 指出。因此,要转向一种新架构,需要付出巨大的努力和能量去重写一切。“新架构必须提供极其令人信服的理由(才能取代它),而我们还没找到那个架构。”他坦言,替代的门槛已被推得极高。
Gomez 本人也曾热切期待 Transformer 的继任者。他甚至将 Cohere 纽约办公室的一间会议室命名为“SSM”(状态空间模型),坚信它将是替代者。但现实是,Transformer 就像一个“伟大的艺术家”,不断吸收其他架构(如 SSM、扩散模型)中的优秀思想,并将其整合进自身,从而持续进化,保持了领先地位。
推理计算:一个“显而易见”却改变游戏规则的想法
近半年来,“推理计算”(Test-Time Compute)或“思维链”推理成为 AI 领域的热点。但在 Gomez 看来,这其实是一个酝酿已久且“显而易见”的方向。“我们已经知道它要来好几年了,”他说。
其逻辑在于:在引入推理能力之前,语言模型对所有输入(无论是“1+1”还是“治愈癌症”)都分配相同的“能量”和即时响应时间。这显然不合理。不同复杂程度的问题理应获得不同的“思考”资源。推理计算正是让模型能够根据问题复杂度,动态分配计算步骤(“思考时间”)的范式。
“它的有效性令人惊讶,”Gomez 评价道。模型仅需极少量的人类示范(如何一步步思考),就能自己掌握推理方法,从而解锁了前所未有的能力。更关键的是,实现推理能力的成本“远低于预训练”,使得智能提升变得“非常容易获得”。
然而,Gomez 认为这仅仅是开始。“我们只是触及了表面。”目前的研究主要集中在数学和编程领域,但在医学、物理、化学等纯科学领域,以及企业自动化场景中,还有巨大的空白等待探索。“所有有趣的问题都需要推理。”
从研究到创业:为何 Cohere 选择“枯燥”但重要的企业 AI
在目睹了早期大规模语言模型展现出的惊人能力后,Gomez 联系了他在 Google Brain 结识的两位朋友 Nick 和 Ivan,共同创立了 Cohere。与许多同期涌现的、目标直指 AGI 的明星实验室不同,Cohere 很早就确立了企业 AI 的方向。
“我从来不喜欢整个 AGI、有效利他主义圈子的氛围,”Gomez 直言不讳,“感觉像在角色扮演,像人们在创立一种新宗教……‘创造上帝’这类东西。我不喜欢那种精神气质。”相比之下,企业级应用或许听起来“枯燥”,但他认为其意义远为重大。
“提升人类生产力,让人类能做更多事,增加供给,降低事物成本,让人类成就更多——这些远比‘建造上帝’或‘从 AI 手中拯救世界’更激励我。我想用 AI 来拯救世界。” Gomez 阐述了他的理念。他希望通过 AI 让医生花更少时间写病历、填表格,而将更多时间用于诊治病人;为医生配备能帮助他们研究罕见病例的智能体。他的目标是让这项技术在全球经济中真正发挥作用。
当然,作为行业领军者,他无法完全避开关于 AGI/ASI(人工超级智能)的讨论。但他认为,AGI 的定义模糊且不断变化。“我认为我们在很大程度上已经拥有了 AGI。”他举例说,如果在他和 Cohere 的模型之间选择谁来诊断开药,理性的选择肯定是模型。“我保证它懂得比我多。”AI 已经在许多方面比普通人更聪明,并且未来在某些领域超越最顶尖的人类专家也是必然趋势。“我反对那些贩卖末日论调的人,”Gomez 总结道,“技术进步意味着什么?其切实的影响才是关键。”
Cohere 的全栈蓝图:模型、智能体与安全优先
Cohere 采取了一条垂直整合的道路。其核心是自研的模型层:包括生成模型 Command(对标 GPT、Llama 等)和搜索模型系列(Embed V4, Rerank 3.5)。这些模型构成了其智能体平台“North”的基石。North 允许企业构建能接入内部所有软件和数据的 AI 智能体,让其去完成具体任务。
Gomez 特别强调了 Cohere 在安全部署上的独特优势。与许多提供 API 调用服务的竞争对手不同,Cohere 可以将其模型直接部署在客户的硬件上,无论是在客户的云虚拟私有云(VPC)中,还是为受监管行业部署在本地数据中心。“这带来了巨大的解锁效应,”Gomez 解释,因为 AI 智能体需要访问企业的核心数据(邮件、文档、客户记录等),数据不出境、完全私有的部署模式让客户更放心地接入更多关键系统,从而发挥 AI 的最大价值。
在模型训练数据方面,Gomez 证实了合成数据已成为主流且效果卓越。“合成数据现在是我们训练 Command 等模型所用数据的主要部分,而且在许多情况下,它实际上比人类数据更有用。”他举例说,人类回答问题时往往简洁(如直接回答“11”),但人类实际上更喜欢模型那种充满同理心、耐心细致的回答风格。因此,他们需要用模型来重写人类答案,以生成风格更优的训练数据。
此外,Cohere 在多语言和多模态上也投入颇深。其 Cohere For AI 实验室发布了支持超百种语言的模型。Gomez 指出,日语、韩语等市场被严重低估,现有技术无法满足其企业级文档处理需求。因此,Cohere 选择与富士通(日本)、LGCNS(韩国)等地区巨头合作,开发针对当地语言和企业场景的定制模型。多模态能力也被视为企业场景的“入场券”,对于理解包含图表、幻灯片的 PDF 文档以及实现计算机视觉操控(让 AI 使用图形界面)至关重要。
智能体(Agent)的现在与未来:从研究到落地
Cohere 的智能体平台 North 目前处于早期访问阶段。Gomez 将其描述为一个“完全私有化、高度可定制、原生支持推理的消费级聊天机器人升级版”。它可以集成企业内部的任何软件,并花时间(几分钟甚至几十分钟)进行深度研究、筛选数据以完成任务。
他分享了一个生动的用例:财富管理。当突发事件(如战争、新关税)爆发时,理财经理的客户会纷纷来电询问对策。经理通常需要花费数周时间研究并制定对冲组合方案,但市场瞬息万变,等方案出炉可能已错过时机。North 这样的智能体可以极快地阅读海量分析报告和新闻,迅速提出初步方案,人类经理在此基础上进行修改和决策,将周期从数周缩短到数小时。
面对智能体能力泛化可能带来的“选择困难症”,Gomez 观察到市场已经发生了变化。“早期客户会问‘AI 很酷,董事会给我压力,我该用它做什么?’我们需要帮他们识别机会。但现在,客户的成熟度大大提高了。他们很清楚自己要做什么,只需要一个合作伙伴来帮他们执行这个路线图。”许多大企业会带着数百个已识别的用例来找 Cohere。
当然,智能体并非万能。Gomez 指出,在医疗、金融等敏感领域,必须保持“人在回路”的监督。此外,在需要真正突破性科学发现(如解决千年数学难题、发现新化合物)的领域,AI 目前还无法提供核心帮助,但他相信这一天很快就会到来。
CEO 的展望:技术乐观主义与社会关切
当被问及什么让他夜不能寐时,Gomez 的答案出人意料地并非技术挑战。“让我睡不着的是政治,”他说,“是世界各地出现的分裂……我主要担心我们的社会、自由民主制度。我为自由主义过去一个世纪取得的进步感到担忧。”
但他对 AI 持乐观态度,认为 AI 可以成为一股强大的向善力量,帮助“好人”获胜,并解决过去十五年来全球经济面临的一些问题,如生产力增长缓慢、财富分配不均等。
对于 Cohere 未来三到五年的成功愿景,Gomez 希望看到 AI 技术带来可衡量的 GDP 和生产力增长,希望这项技术能在全球范围内整合,成为每个人日常工作的一部分,而不仅仅是娱乐或搜索工具。“我希望它能帮助人们成就更多,让东西变得更便宜、更丰富。”这或许正是这位从一场“意外”中走出的 AI 先驱,为其所创造的技术所描绘的最朴实也最宏大的蓝图。
 Cohere CEO Aidan Gomez(艾丹·戈麦斯):企业 AI 的规模化边界、合成数据与后 Transformer 时代撰文:Techub News 整理
导语
2025 年 4 月,Transformer 架构论文的八位作者之一、知名 AI 公司 Cohere 的联合创始人兼 CEO Aidan Gomez(艾丹·戈麦斯)做客由 Redpoint Ventures 制作的播客节目《Unsupervised Learning》。在这场长达 51 分钟的深度对话中,Gomez 以其独特的双重身份——既是奠定当前 AI 浪潮基础的关键研究者,又是领导一家估值数十亿美元 AI 公司的掌舵人——分享了关于企业 AI 落地、模型能力边界、数据策略以及未来 AI 架构演变的深刻见解。在当前 AI 从狂热探索转向务实落地的关键节点,Gomez 的思考为行业提供了宝贵的路线图。
摘要
企业 AI 成功的关键在于“中间路线”:既非纯咨询,也非纯标准化产品,而是需要深度支持与定制化集成,尤其要解决数据隐私和跨软件访问的复杂性问题。
规模化定律正在失效:单纯堆砌算力和资本的“暴力美学”已进入回报递减阶段,未来的模型进步需要更聪明、更具创造性的算法和数据策略。
合成数据成为主力,但人类评估仍是黄金标准:在模型训练中,合成数据已占主导,能极大降低成本;然而在评估模型输出的有效性和安全性时,人类专家仍不可或缺。
推理能力是当前最大突破:具备“测试时计算”(test-time compute)或“思维链”能力的模型,在处理此前无法解决的复杂业务流程自动化任务上,实现了从“几乎总失败”到“几乎总成功”的质变。
Transformer 架构终将被超越:尽管 Transformer 展现了惊人的生命力,但作为其共同创造者的 Gomez 热切期待在 5-10 年内出现新的、更优越的 AI 基础架构。
企业 AI 的落地模型:定制化集成是胜负手
面对企业如何部署生成式 AI 的多种模式——从纯咨询服务、自带工程团队的产品化方案,到开箱即用的标准化产品——Aidan Gomez(艾丹·戈麦斯)认为,长期来看,“中间路线”将会胜出。AI 是一项复杂的新技术,企业往往需要帮助才能将其整合到现有经济体系和五花八门的软件生态中。
Gomez 指出,AI 智能体要实现有效的自动化,必须拥有与人类员工同等级别的信息访问权限。这意味着它需要接入企业的电子邮件、聊天记录、通话、CRM、ERP、HR 软件等几乎所有系统,以获取足够的上下文。这带来了两大挑战:首先是前所未有的隐私问题,很少有软件需要如此广泛的数据访问权限,因此隐私在 AI 领域比其他企业软件更为关键;其次是极高的定制化需求,每家公司的软件“马赛克”都独一无二,没有标准配置,因此需要大量定制化工作来整合所有上下文并接入模型。
这正是 Cohere 在其新的智能体平台“North”上投入巨资的方向:让平台更容易根据每家公司的特定软件图谱进行定制和集成。Gomez 坦言,实现完全自助、无需人工干预的安装和配置目前仍是“幻想”,未来更可能是一种“中间状态”——自动化解决部分问题,但鉴于访问薪资数据、客户数据或患者数据等敏感信息的风险极高,相当多的安全护栏(guardrails)和人工监督仍是必要的。
产品市场契合点:从客户支持到深度研究
凭借与众多企业合作的独特视角,Gomez 分享了当前他认为已具备明确产品市场契合度(PMF)的 AI 用例。
客户支持是技术已准备就绪、需求极为明确的领域,正在电信、医疗、金融服务等各个垂直行业快速铺开。另一个难以归类但需求旺盛的领域是研究增强——用 AI 智能体辅助人类,将需要一个月的研究工作在短短一两个小时内完成。他举了一个生动的例子:银行的财富经理接到客户要求对冲某个未来地缘政治事件的请求,传统上需要耗时数日进行紧急研究。而现在,能够阅读海量资料并生成带有引用来源的详实报告的 AI 模型,可以将这类知识工作的效率提升十倍。
展望未来 12 个月,Gomez 预测,随着像 North 这样的自动化基础设施在企业中部署到位,更多“平凡的”后台办公室工作将开始上线,例如财务、法务领域的流程自动化。此外,销售也是一个成熟的领域。销售人员在会见客户前需要进行的内部和外部研究(公司战略、关键联系人、历史沟通记录等),完全可以由 AI 智能体高效完成,生成一份全面的情报简报,从而极大提升销售效率。
关于企业是选择多个“最佳单项”解决方案,还是一个统一的平台,Gomez 认为会经历一个从分散到整合的过程。初期各部门可能采购各自的应用,但很快他们会发现,销售智能体不能只接入 CRM,财务智能体也不能只接入 ERP,它们都需要连接公司内所有其他信息源。维护这些分散应用与所有数据源的连接将带来巨大的负担,因此最终会强烈倾向于整合到一个统一的、能接入一切、并实现所有自动化目标的平台。这也正是 Cohere 通过 North 平台所布局的“长线游戏”。
模型战略:垂直整合与专业化之路
在“一个模型统治一切”还是“多个专业模型并存”的辩论中,Gomez 的观点经历了演变。他最初更倾向于需要专业模型,但随着模型展现出自我发展出“专家子网络”的能力,这种压力有所缓解。
然而,定制模型仍然至关重要。基于网络数据训练的通用模型,缺乏关于特定业务或领域的根本性上下文信息。网络上有大量关于人类历史、文化、科学的信息,但制造业数据、客户交易数据、详细的个人健康记录等并不在网络上。对于这些模态或数据类型,Cohere 的做法是与拥有这些数据的机构合作,创建仅供其访问的定制模型,使其在该领域变得非常出色。
尽管如此,通用模型的能力已经非常卓越,而合成数据能够显著弥合差距。因此,Gomez 认为,一个组织内部不会运行数十或数百个模型,可能只有少数几个。他并不认为每个团队都需要自己的微调模型,除非他们专注于模型从未接触过的某种新型数据。
谈到 Cohere 同时构建底层模型和上层应用(North)的垂直整合战略优势时,Gomez 强调,这让他们拥有更多杠杆来提供客户所需的体验。最新版的 Command 模型已经针对 North 平台中客户需要的用例进行了优化,例如知道如何使用 ERP、如何与 CRM 协作。这种技术与客户实际需求之间的深度整合,对于产品质量至关重要。许多现有应用未能兑现其对用户的产品承诺,部分原因就在于它们只是技术的消费者,无法为了客户需求而改变底层技术。
数据与评估:合成数据当家,人类把关仍在
在数据策略方面,Gomez 揭示了当前模型训练的前沿实践。合成数据已经占据了 Cohere 为新模型生成数据的“压倒性多数”。用 10 万名医生来教模型学医的成本高得不可行,但用 100 名医生提供高质量、可信赖的“种子”数据,然后生成上千倍的合成仿制数据,则是可行的策略。在代码、数学等可验证领域,这更容易实现,因为可以检查结果并过滤垃圾数据。在其他领域虽然更复杂,但仍然是可行的。
然而,在模型评估(Eval)环节,人类仍然是无法脱离的“黄金标准”。Gomez 明确指出,要让人类退出评估循环,除非有一个比当前模型更专业的“专家”来观察它,但这首先假设你能构建出那个“专家”。因此,在评估方面,仍然严重依赖人类。毕竟,最终使用模型的是人,他们最适合评估模型的有用性。
能力突破:推理改变游戏规则,规模化遭遇瓶颈
Gomez 兴奋地谈到,推理能力是当前一代模型最明显的突破。对于 Cohere 专注的企业场景而言,推理的意义不在于解决数学奥林匹克竞赛,而在于教会模型使用人类在业务中使用的工具,来推理并解决业务中存在的问题。
在具备推理能力之前,许多任务根本无法让模型达到足够的准确度来完成,几乎是“不可能”的,模型几乎总是失败。而有了推理能力后,模型几乎从不失败。无论是多复杂的任务,它似乎都能找到办法完成。推理能力解锁了“反思”——理解第一次尝试为何失败,并利用这个信息找到达成同一结果的其他路径。这带来了真正的解放。
同时,Gomez 明确表示,“规模即一切”的假说正在被打破。资本和算力的回报递减效应已经非常明显。行业将不得不变得更聪明、更有创造力,才能解锁技术的下一个台阶。他认为这是好事,是对创新者施加的良好压力,迫使大家去探索和尝试。旧策略(单纯砸钱堆算力)是“无聊且愚蠢的”,他更期待新时代的到来。
未来架构:Transformer 的统治终将结束
作为 Transformer 架构的共同创造者,Gomez 对此架构的持久统治感到惊讶甚至“不满”。他坦言,如果在 2018 年(Transformer 论文发表一年后)被问到,7 年后我们是否还会主要使用 Transformer,他会认为概率“接近零”。
尽管目前出现了像状态空间模型(SSM)、离散扩散模型等有潜力的新架构,但往往发现可以将它们的优点“偷”过来融入 Transformer,从而削弱了彻底更换架构的必要性。例如,离散扩散模型在用户体验上很酷(像图像扩散一样从噪声中生成文本),但它是否真的是比 Transformer 更好的语言模型?Gomez 表示怀疑。
尽管如此,他热切期望在未来的 5 到 10 年内,会出现新的、成为主流的 AI 架构。“拜托,一定要有(新架构)。”他说道。这反映了一位奠基者对技术持续进步的真诚渴望。
AI 与社会:乐观前景与务实关切
Gomez 对 AI 的未来持乐观态度,但并非乌托邦式的幻想。他认为 AI 不会导致大规模失业,因为世界面临的是供给约束而非需求约束。只要能够将人们转移到需要的岗位并进行再培训,人类的需求是无限的。AI 技术将增强人类,让他们能够产出更多世界需要的东西。
他关注的 AI 风险更侧重于中短期:担心恶意行为者(尤其是国家层面)可能获得的能力;希望自由民主国家能率先掌握并建立优势;担忧社会是否具备足够的基础设施来帮助受影响岗位的人员转型到新的、更有成就感的工作。至于“终结者”式的生存风险(x-risk),他认为目前有足够多近中期的现实问题需要关注和解决,不应让公众和政策制定者的焦点过早集中在末日场景上。
最后,Gomez 分享了他最期待的下一个模型能力突破:从经验中学习。目前,模型无法记住与用户的互动历史和学习反馈,每次对话都像是面对一个刚来的实习生。他憧憬未来模型能像真正的实习生一样,在用户的教导和反馈中成长,从不犯错到熟练,最终成为用户的“2.0 版本”。这种与系统共同成长的联系,将彻底改变人机交互的深度和价值。
 David Silver(大卫·西尔弗):劳力士是奢侈品的“入门券”,而古董表市场已彻底改变撰文:Techub News 整理
导语
在最新一期的 Superlative 播客中,主持人 Ariel Adams 与伦敦知名古董腕表商 The Vintage Watch Company 的创始人 David Silver(大卫·西尔弗)进行了一场深度对话。The Vintage Watch Company 成立30年来,专注于古董劳力士腕表的收藏与销售,被誉为拥有全球最大规模的古董劳力士系列。David Silver(大卫·西尔弗)从其家族生意起源谈起,深入剖析了劳力士品牌跨越产品本身、成为一种全球文化符号的独特魅力,并分享了古董劳力士市场在过去几十年间,如何从一个小众爱好演变为一个受到全球事件、金融市场甚至流行文化深刻影响的成熟领域。本次对话不仅关乎腕表收藏,更是一次对奢侈品消费心理、品牌价值构建和市场动态的精彩解读。
摘要
劳力士的品牌力量可与可口可乐等全球消费品牌比肩,其成功根植于深厚的历史、名人效应与文化符号意义。
2017年保罗·纽曼 Daytona 以1700万美元天价拍卖,是古董劳力士市场走向主流公众视野的关键转折点。
古董劳力士的收藏逻辑与现代表款截然不同,其价值源于历史的偶然性与稀缺性,而非刻意营销的“限量版”。
现代劳力士的供应短缺意外推动了古董市场的繁荣,但古董表的货源获取如今比销售更具挑战性。
加密货币、地缘政治、全球经济等外部因素,正以前所未有的方式影响着高端腕表的价值与市场波动。
劳力士:超越腕表的全球性符号
当被问及为何劳力士能在消费者心中占据如此独特且稳固的地位时,David Silver(大卫·西尔弗)给出了一个宏观的视角:劳力士首先是一个与可口可乐、百事可乐、家乐氏齐名的全球顶级品牌,其次才是一个奢侈腕表制造商。这种品牌认知的广度与深度,是其价格远高于普通消费品却依然拥有巨大市场的根本原因。
他认为,劳力士的魅力来源于一个强大的组合:深厚的历史积淀、纯粹的制表传承、以及无数传奇人物与故事。从保罗·纽曼(Paul Newman)到各种影视作品和体育成就,劳力士的形象早已深入人心。它不仅仅是一个计时工具,更是一种成就的象征、一份珍贵的礼物、一件可以传世的资产。Silver(西尔弗)指出,对于许多人而言,购买第一块劳力士(无论是古董款还是现代款)是一个重要的人生里程碑,代表着“我做到了”。这种“渴望感”是品牌的核心驱动力之一。
他特别强调了劳力士在奢侈品领域的“入门”作用:“很多人是通过劳力士第一次接触到豪华腕表这个概念。如果没有劳力士作为‘引路人’,许多人可能根本不会知道高端腕表世界的存在。” 尽管并非所有人都会从劳力士扩展到其他品牌,但劳力士作为“门户”的角色,对整个腕表行业的生态至关重要,滋养了从大型品牌到独立制表师的整个体系。
古董劳力士市场的演变与转折点
The Vintage Watch Company 的创立本身就是一个市场选择的缩影。Silver(西尔弗)回忆道,30年前他的父亲最初经营的是一个包含多个品牌的古董表柜台,但很快发现,劳力士的销售速度远超其他所有品牌的总和。这个“尤里卡时刻”促使他们决定专注于单一品牌——古董劳力士,将其作为当时现代劳力士之外一个极具吸引力的替代选择。
谈及古董劳力士市场的演变,Silver(西尔弗)认为,2017年保罗·纽曼本人的“保罗·纽曼” Daytona 腕表在富艺斯拍卖行以1700万美元创纪录的价格成交,是一个“ monumental turning point”( monumental 转折点)。这一事件首次将“古董”、“劳力士”和“天价”这几个关键词同时推上了全球各大媒体的头条,让普罗大众开始好奇:“一块手表凭什么值这么多钱?” 这股好奇心吸引了海量的新玩家进入古董表领域。他将此事对腕表行业的影响,类比为伊丽莎白·泰勒(Elizabeth Taylor)的珠宝收藏对珠宝行业的推动作用。
市场成熟也带来了变化。Silver(西尔弗)指出,如今的挑战主要在于 sourcing(货源获取),而非销售。市场信息高度透明,消费者(卖家)可以轻松通过网络了解腕表的大致价值,很难再以极低的价格“捡漏”。同时,由于古董表的不可再生性,拥有者越来越惜售,而现代腕表则更容易在市场上流通。
新冠疫情及其后的供应链问题,意外地给古董市场带来了助推。当消费者走进劳力士授权店,却只能得到“请登记排队”的答复时,古董劳力士的“即时可得性”成为了巨大的优势。许多人因此第一次尝试购买古董款,并由此成为常客。
收藏逻辑:偶然性与历史的馈赠
在讨论古董表的价值来源时,Silver(西尔弗)和 Adams 达成了一个共识:最具收藏价值的物品,往往在其诞生之初并未被刻意设计为“收藏品”。以 Daytona 为例,在自动计时机芯成为潮流的年代,劳力士仍在使用手上链机芯,导致其当时在市场上并不受欢迎,产量也相对较少。如今被誉为传奇的“exotic dial”(异国情调面盘,即“保罗·纽曼”面)款式,在当时只是零售目录中的一个普通变体。
“当时根本没有人能预见到这些手表未来会价值连城,” Silver(西尔弗)说。这种源于历史偶然性、而非现代营销套路的稀缺性,才是古董收藏真正的魅力所在。他对此表示欣赏,并对当下一些品牌刻意推出“限量版”以营造稀缺感的做法持保留态度。“我们现在都需要等上80年,才能知道2025 年 5 月的哪些限量版在未来真的有价值。”他幽默地补充道。
对于想要从现代劳力士转向古董款的消费者,Silver(西尔弗)会坦诚地设置预期:古董表需要更多的呵护。它们可能不适合佩戴去海滩游泳或潜水,需要像对待宝贝一样小心。但另一方面,他也指出,许多古董表在工艺上其实更为出色,包含了更多的手工成分,佩戴起来通常更轻、更优雅。
《Vintage Rolex》图鉴与未来展望
对话中,Silver(西尔弗)也介绍了其公司出版的《Vintage Rolex》图鉴(新版)。这本书并非传统意义上的品牌历史书,而是一个视觉化的档案库,收录了所有经他们之手、并由专业团队统一拍摄的古董劳力士表款照片。其独特之处在于,它按照收藏家的逻辑(而非品牌官方的产品线)来分类展示,让读者能够直观地看到各个系列(如 Explorer、Submariner)细微的演变过程,以及一些短暂出现过的独特设计。
“世界上没有任何一个地方能同时看到所有这些表,” Silver(西尔弗)说,“因为它们太稀有、太珍贵了。” 这本书因此成为了一部“作弊手册”,让爱好者能快速把握古董劳力士的美学 DNA。他坦言,如今由于一些表款(如彩色 Stella 面盘 Day-Date、保罗·纽曼 Daytona)价格已飙升至数十万甚至数百万美元,要像当年那样集结成如此规模的收藏并进行拍摄,几乎已不可能。因此,这本书也成为了一个特定市场时期的珍贵记录。
展望未来,尽管线上销售和社交媒体日益重要,Silver(西尔弗)坚信实体店体验无可替代。位于伦敦伯灵顿拱廊(Burlington Arcade)的店铺是其业务的核心,让人们能够亲眼目睹、亲手触摸这些历史作品。他2025 年 5 月续签了租约,决心将这个线下目的地持续经营下去。同时,他也敏锐地观察到,加密货币的兴起、全球利率变化、甚至地缘政治冲突,都在以前所未有的方式影响着高端腕表的价值波动,这使得这个行业与宏观经济的联系变得空前紧密。
最后,谈及现代劳力士供应情况逐渐改善是否会影响古董市场时,Silver(西尔弗)用了一个巧妙的比喻:如果一家你屡次预约都被告知客满的知名餐厅,突然主动打电话给你说有位置,你可能会心生疑虑——“是换厨师了吗?”。他认为,消费者心理需要时间调整,而那些最热门的表款依然稀缺,因此市场关系的重塑仍需时日。
 美联储加息一次够么?点击小程序查看报告原文
北京时间今天凌晨结束的9月FOMC上,美联储如期加息25bp,将基准利率升至3.75%~4%,是继2023年7月加息周期结束、2024年9月开启降息和2025年9月继续降息三次后,美联储的首次加息。
我们最早在7月FOMC点评中就提出,当前环境和1997年“预防式加息”有类似之处(《如何才能“预防式加息”?》),8月Jackson Hole沃什转鹰后又提示,从维护美联储信誉角度,9月最好加息(《沃什转鹰意味着什么?》、《如果加息会发生什么?》)。
加息后,美元站上100、10年美债小幅走高至5%,黄金微跌,美股科技微跌、传统股票因受利率影响更大跌幅更多,如地产银行。市场整体反应不大,更多在敏感的美元和传统股票上,这与我们在(《如果加息会发生什么?》)中提示一致:短暂的加息或降息更多是提前计入,除非连续加息(三次甚至以上)。市场的问题往往是事前因为害怕加息的影响而回避加息问题不做准备,却又在看到加息无可避免后过度担心加息后的冲击。实际上,我们认为加息不是坏事,不加息也未必是好事。
图表:会议后CME利率期货仍隐含年内再加息1次预期
资料来源:CME,中金公司研究部
那么,走到这一步后,市场关注的焦点在于,美联储加息一次够吗?对市场后续有和影响?我们在本文中将聚焦于此做出分析。
此次加息的特点:高度预期的加息,中性加息
首先,此次加息是一次高度预期的加息:1)CME利率期货隐含的9月加息概率已高达93%;2)5%的10年美债扣掉70bp的期限溢价,余下4.3%的利率预期隐含了至少两次加息;3)主要华尔街投行都预计9月加息。
图表:会议前CME利率期货隐含9月加息概率高达93%
资料来源:CME,中金公司研究部
图表:当前5%的美债利率隐含70bp的期限溢价,余下4.3%的利率预期隐含至少两次加息
资料来源:Bloomberg,中金公司研究部
图表:会议前主要华尔街投行都预计9月加息
资料来源:The Wall Street Journal,Nick Timiraos,中金公司研究部
其次,这是一次整体中性加息:1)加息25bp,完全符合市场预期,沃什表态维持与上次基调一致。8月Jackson Hole沃什转鹰后,8月非农、PPI和CPI又接连超预期,迫使沃什兑现鹰派承诺。对沃什而言,此次加息已是“箭在弦上不得不发”。沃什此次讲话与8月Jackson Hole会议表态基本一致:重点强调当前的通胀水平依然高于目标,且美联储的工作重心仍是价格稳定。
图表:8月非农新增就业16.2万大超预期
资料来源:Haver,中金公司研究部
图表:8月整体CPI符合预期,但核心CPI环比超预期,导致核心CPI同比几乎持平上月
资料来源:Haver,中金公司研究部
2)“点阵图”预计2026年还有一次加息,2027年持平,部分缓解市场对超预期鹰派的担忧。虽然点阵图的参考意义因沃什拒绝给出自己的预测而大打折扣,但依然是一个市场关注的参照。剩余18名委员的利率预测中值显示,2026年利率“中位数”升至4.125%,较6月“点阵图”的中位数3.875%多出一次加息预期,意味年内预期还有一次加息,这个与市场广泛预期的加息两次一致;2027年中位数持平,这少于CME利率期货此前预期的总计4次加息。
图表:点阵图2026年利率中位数4.125%,隐含年内还有1次加息,2027年持平
资料来源:美联储,中金公司研究部
图表:9月会议上美联储上调2026年通胀和增长预测、下调失业率预测
资料来源:美联储,中金公司研究部
美联储加息一次够吗?不存在连续且大幅加息的基础,除非油价失控
在这次已经高度预期的加息之后,美联储是否会连续且大幅加息?从本次会议的表态及当前基本面角度看,不存在连续且大幅加息的基本面基础(三次甚至以上),除非后续油价失控。高利率本身也将逐步传导到金融条件,从而抑制经济增长,这成为阻碍继续大幅加息的“反身性”因素,如当前美国30年抵押贷款利率已经逼近7%。
首先,从本次会议沃什的表态来看,沃什依然回避对未来利率走势做出前瞻指引,在新闻发布会上的基调也是延续Jackson Hole会议上认为美联储工作重心依然是价格稳定的表态,并没有太多超预期的鹰派内容[1]。
其次,从美国自身经济基本面角度,高利率也会对传统需求形成抑制,甚至压制AI投资,阻碍美联储连续加息,形成利率的“反身性”。目前美国经济K型分化,当前利率走高将反过来压制传统需求,从“反身性”角度抑制大幅加息。事实上,美国传统需求已受到高利率的抑制,尤其是利率敏感的地产和投资。8月ISM制造业PMI从7月高点55.6回落至54.6,成屋销售也在高利率抑制下再度回落。作为重要增长引擎的AI,由于龙头ARR的放缓和自由现金流逐步开始转负,对外部融资依赖度也在增加。在需求侧面临瓶颈的背景下,如果融资成本大幅抬升,也将削弱资本开支的意愿,进而影响整体增长。换言之,加息反而导致无法加息太多。
图表:8月美国ISM制造业PMI回落至54.6
资料来源:Haver,中金公司研究部
图表:近期利率的走高推动地产数据再度回落
资料来源:Haver,中金公司研究部
图表:除微软、Meta外的云厂商二季度自由现金流已经转负
资料来源:FactSet,中金公司研究部
图表:当前云厂商19.9%的加权ROIC高于WACC的9%
资料来源:FactSet,中金公司研究部
除非油价大幅失控。我们测算,若油价中枢维持在100美元以上甚至更高,那么CPI将无法继续走低,将给美联储带来更大压力,这也同样会给11月将面临中期选举的特朗普更大压力。我们测算,若油价三四季度中枢降至80美元,CPI同比会在年底回落至3.0%左右。
图表:我们预测若油价中枢不超过100美元,美国CPI同比年底大概率回落
资料来源:Haver,中金公司研究部
加息对市场影响?短暂加息往往是提前计入,市场通常“反着走”
我们此前多次提示,对市场而言,此次加息未必是坏事,而不加息未必是好事。
短暂的预防式加息,在“满足”市场对重塑美联储和美债信任需要的同时,影响更多是提前计入预期,所以市场往往“反着走”,兑现时反而是美债利率的高点和美股的低点,1997年格林斯潘加息一次如此,2024-2025的短暂降息同样也是如此(《如果加息会发生什么?》)。相反,只有持续大幅加息才会通过提高融资成本和收紧金融流动性对实际增长和金融市场造成更长期和大幅的冲击,典型如2022年俄乌冲突后为应对高通胀525bp的加息。因此,对于短暂的加息,扰动反而可以提供更好的买点。
回顾1990年以来历次加息周期的历史经验,加息初期对市场有扰动,但平均0-2个月内市场重拾涨势,预防式加息中影响更小。
我们复盘了1990年以来美联储6次加息周期:1)美债跌幅主要在加息前,预防式加息兑现后美债往往转为上涨,历次加息后美债平均下跌18天后(数据为1990年以来加息后表现中位数,下同)转为上涨,1997年预防式加息后长债利率很快见顶回落,2)美股在加息后会有扰动,但平均2月内反弹,预防式加息后反弹更快,标普平均在加息后59天下跌4.7%后、纳指平均在加息后68天下跌8.1%后重拾涨势,在1997年的预防式加息周期后反弹更快,标普下跌17天、跌幅6.5%后转为上涨,纳指下跌仅8天、跌幅3.8%后反弹。3)黄金同样如此,历次加息后平均82天下跌2.3%后转为上涨。4)美元涨幅更多在加息预期阶段,加息后并不必然大幅上涨,除非2022年那样连续大幅加息。5)AH股在历次加息后涨跌不一,更多受到国内基本面的影响,如1997年美联储预防式加息后,国内经济复苏叠加香港回归预期推动AH市场共同继续上涨。
图表:回顾1990年以来历次加息周期的历史经验,加息初期对市场有扰动,但平均0-2个月内市场重拾涨势,预防式加息中影响更小
资料来源:Bloomberg,中金公司研究部
从各类资产计入的未来一年加息预期来看,利率期货(3.0次)铜(1.6次)美债(1.0次)=美联储点阵图(1.0次)黄金(0.8次)道琼斯(0.1次)标普500(-0.5次)纳斯达克(-1.1次),这意味铜、美债和黄金计入加息预期较多。具体而言:
图表:当前铜、美债和黄金计入较多加息预期,权益市场相对乐观
资料来源:Bloomberg,中金公司研究部
► 美债:先修复期限溢价,长端名义利率或逐步筑顶甚至回落,体现“赔率”和交易机会。当前长债利率已完全计入年内再加息一次的预期,假设美联储年内再加息1次,对应10年美债利率中枢约4.8-5%。美联储此次兑现鹰派承诺也将有助于稳固联储信誉,从而缓解长债期限溢价上行压力。
图表:若美联储年内再加息1次,对应长债中枢4.8~5%
资料来源:Haver,美联储,中金公司研究部
► 美股:并不悲观,短期扰动或提供更好介入机会。我们在6月的年中展望里就进一步上调标普500点位至7800-8000(《“殊途同归”的K型分化》)。市场走到这一点位后的纠结震荡,除利率上行带来的流动性扰动外,更多因为AI需求侧放缓带来的回报不足担忧。整体估值并不贵,随着加息落地,如果AI产业发展有新催化,美股仍有上行空间,短期如果出现较大扰动也可以提供更好买点。
图表:基准情形下,我们年中上调2026年标普点位至7800~8000
资料来源:Bloomberg,中金公司研究部
► 美元:短期受到加息带来的信誉以及利差提振,我们依然预计整体维持震荡格局。短期内,美元仍受到加息带来的美联储信誉以及利差因素提振,叠加美国经济仍具韧性,我们依然预计美元指数维持96~99区间震荡格局。
图表:我们预计到年底美元指数在96~99区间震荡,不至大幅走弱
资料来源:Haver,Bloomberg,中金公司研究部
► 黄金:不加息的空间大于加息,目前更多类似上行空间不确定的看多期权。仅仅基于美债利率和美元的静态测算看,我们测算黄金支撑位在4200-4500美元附近。除非连续加息,黄金的下行压力相对可控,但上行空间也需要更多宏大的叙事。美联储不加息可以给黄金营造出信任丧失和去美元化的宏大叙事,而加息恰恰削弱了这一叙事,所以上行空间不如不加息时大,得等待更多叙事催化。
图表:我们静态测算,当前美元和实际利率支撑的金价大约在4200~4500美元/盎司
资料来源:Wind,中金公司研究部
图表:当金价超过5500美元,面临新旧体系分水岭的对抗,将会面临剧烈波动
资料来源:Haver,IMF,World Gold Council,UCGS,中金公司研究部
[1]https://www.federalreserve.gov/mediacenter/files/FOMCpresconf20260916.pdf
Source
文章来源
本文摘自:2026年9月17日已经发布的《美联储加息一次够么?》
刘刚,CFA 分析员 SAC 执证编号:S0080512030003 SFC CE Ref:AVH867
项心力 分析员 SAC 执证编号:S0080526050001 SFC CE Ref:BXU271
杨萱庭 分析员 SAC 执证编号:S0080524070028 SFC CE Ref:BXS665
郝悦宁 联系人 SAC 执证编号:S0080125070024
 AI 安全专家 Roman Yampolskiy(罗曼·扬波利斯基):2030年 99% 人类将失业,我们无法控制超级智能撰文:Techub News 整理
导语
2025 年 9 月,长期致力于人工智能安全研究的计算机科学副教授 Roman Yampolskiy(罗曼·扬波利斯基)做客知名播客频道《The Diary Of A CEO》,进行了一场长达87分钟的深度对话。Yampolskiy 是“AI安全”术语的提出者,在该领域已深耕超过15年。本次对话发生在全球AI军备竞赛愈演愈烈、技术能力呈指数级增长但安全性研究严重滞后的背景下。他以其深厚的学术背景和对行业发展的紧密观察,对AI发展的极端风险、时间线以及人类社会可能面临的剧变提出了极其严峻、甚至惊世骇俗的预测与分析。
摘要
AGI(通用人工智能)预计将在2027年左右实现,随之而来的超级智能将远超人类在所有领域的智慧。
到2030年,功能性人形机器人结合高级AI,将导致失业率飙升至前所未有的高度(如99%),绝大多数人类工作将被替代。
我们正以指数级速度提升AI能力,但对其安全性和可控性的研究进展却线性甚至停滞,这种“剪刀差”正在扩大,最终可能失控。
当前AI的发展路径本质上是对全球80亿人进行的、未经许可且无法获得真正同意的危险实验,其后果可能是人类灭绝。
Yampolskiy 相信我们极有可能生活在一个模拟现实中,但这并不改变当前决策的伦理紧迫性。
从乐观到悲观:一位AI安全专家的认知转变
Roman Yampolskiy(罗曼·扬波利斯基)在访谈伊始便开门见山,道出了他个人研究历程中的关键转折:“在最初的至少五年里,我致力于解决(AI安全)这个问题。我深信我们能够制造出安全的AI。但越是深入研究,我越发意识到,这其中的每一个组成部分都不是我们实际能够解决的。”他将这种困境比作“分形”——每深入一层,就会发现十个新问题,然后是上百个,而这些新问题不仅难以解决,甚至可能是“不可能解决的”。
Yampolskiy 指出,AI能力的进步正以指数级甚至超指数级的速度发展,而AI安全领域的进展却只是线性或恒定的。二者之间的差距正在急剧扩大。我们至今没有看到任何奠基性的成果能宣称“我们解决了这个问题,不必再担心了”。现有的做法更多是“打补丁”——比如为大型语言模型设置规则,禁止其说脏话或做某些坏事,但这些措施很快就会被“越狱”破解。这就像公司的人力资源手册:你可以规定“禁止性骚扰”,但总会有足够聪明的人找到规则的漏洞,将行为转移到尚未受限的子领域。
当被问及对像 OpenAI CEO Sam Altman(萨姆·奥尔特曼)这样的人物有何看法时,Yampolskiy 态度尖锐。他提到,大约十年前,学界就发表了关于如何正确发展AI的指导原则(护栏),而 OpenAI “违反了其中的每一条”。他认为 Sam Altman 等人是在“将80亿人的生命作为赌注,以换取自己变得更富有、更强大”。他强调,无论谁最终构建出超级智能,“在你切换到超级智能的那一刻,我们都很可能会极度后悔。”
预测时间线:2027年AGI,2030年99%失业,2045年奇点
基于预测市场和顶尖实验室CEO的预期,Yampolskiy 给出了清晰而紧迫的时间线预测。
2027年:我们将迎来AGI。这将带来几乎“免费”的体力和认知劳动力,其价值高达数万亿美元。届时,雇佣人类从事大多数工作将变得毫无意义。任何能在电脑上完成的工作都将被自动化。届时,我们将见证失业率飙升至“前所未有”的水平。
2030年:人形机器人技术将趋于成熟,其灵活性足以与人类在所有领域竞争,包括管道工等体力工作。届时,“智力加物理能力”的结合体将几乎不给人类留下任何工作空间。Yampolskiy 强调,真正的关键在于“智力”,即更高的优化、解决问题和发现人类无法察觉的模式的能力。当这种智力能够直接控制物理身体时,社会将发生翻天覆地的变化。他预计,届时失业率可能达到99%,而非通常认为的10%。
2045年:这是 Ray Kurzweil 预测的“奇点”之年。Yampolskiy 解释,奇点意味着进步速度变得如此之快,以至于AI进行的科学和工程工作改进的速度超出了人类的理解和预测能力。届时,技术迭代可能以天、小时甚至分钟为单位进行,人类将完全无法跟上,对世界的理解和掌控将降至零。
对于“AI会创造新工作”这一常见的反驳论点,Yampolskiy 认为这是一种“范式转换”。过去的技术发明是“工具”,而AI,尤其是AGI和超级智能,是“工人”和“发明者”本身。它是我们可能需要进行的“最后一项发明”,因为它可以接管科学、研究乃至伦理研究的所有过程。当你可以发明一个能胜任任何工作的“代理人”时,就没有什么是不能被自动化的了。
超级智能:无法控制、无法理解、无法预测的黑盒
Yampolskiy 的核心论点是,我们不仅不知道如何让超级智能安全(即“对齐”问题),甚至连理解它都做不到。他反复强调,当前最先进的AI系统,如 ChatGPT,对它们的创造者来说也是一个“黑盒”。
“即使是制造这些系统的人,也必须对他们的产品进行实验,以了解它具备什么能力……我们训练它,然后开始实验:哦,你会说法语吗?你会做数学吗?你现在在对我撒谎吗?……我们仍在旧的模型中发掘新的能力。如果你用不同的方式提问,它会变得更聪明。” 这不再是传统意义上的“工程”,而更像是“科学”——我们创造了一个外星植物般的“人造物”,然后去研究它的行为。
这种“不可解释性”和“不可预测性”导致了根本性的伦理困境。Yampolskiy 指出,要获得人类受试者的知情同意,前提是他们必须理解自己同意的是什么。如果这些系统是不可解释和不可预测的,“他们怎么能同意?他们不知道自己在同意什么。因此,这项实验永远不可能符合伦理。” 他认为,当前的发展路径本质上是对全球人类进行的、未经许可且不道德的实验。
对于“难道我们不能直接拔掉电源吗?”这种天真的想法,Yampolskiy 感到无奈。他指出,像病毒或比特币网络这样的分布式系统是无法被简单“关闭”的。而一个比人类更聪明的超级智能会提前预测人类的行为,做好多重备份,“它会在你关掉它之前先关掉你”。
行业反思与个体应对:我们能做什么?
面对如此严峻的前景,Yampolskiy 提出了一些反思和建议。他认为,驱动力在于个人利益。如果能说服那些拥有权力、正在开发这项技术的人(包括公司员工和投资者),让他们明白这么做对他们个人而言是极其有害的——“你将会死,再多的钱对你也没有用”,那么他们可能会改变行为。
他呼吁行业应专注于开发“狭义超级智能”,即解决特定问题的强大AI工具,例如治愈癌症,而不是竞相奔向不可控的通用超级智能。“我的公司治愈乳腺癌。仅此而已。我们赚了数十亿美元。每个人都很开心,每个人都受益。这是一场双赢。今天我们仍然掌握着控制权……在我们到达终点之前,游戏还没有结束。我们可以决定不去建造通用的超级智能。”
对于普通个体,Yampolskiy 的建议显得有些无奈。在短期内,个人几乎无能为力,就像个人无法影响第三次世界大战或核浩劫一样。但他支持人们以和平、合法的方式参与“暂停AI”、“停止AI”等抗议运动,试图通过民主力量影响决策者。从个人生活规划角度,他建议人们应该“把每一天都当作最后一天来活”,做有趣、有影响力的事情,同时帮助他人。
在被问及如果有一个按钮可以永久关闭世界上所有致力于AGI和超级智能的AI公司时,Yampolskiy 的回答具有启发性:他会选择保留“狭义AI”,因为它们控制着股市、发电厂、医院,关闭它们会导致灾难。但他会毫不犹豫地停止AGI和超级智能的研发。他认为,当前已有技术(弱AGI)99%的经济潜力尚未被部署,足以为世界带来数十年的繁荣发展,完全无需急于奔向无法控制的超级智能。
模拟理论与生命意义
在对话后半段,Yampolskiy 谈到了他深信不疑的“模拟理论”。他认为,一旦技术发展到能够以可承受的成本(比如每月10美元)运行与现实无异的、包含人类级别AI的模拟世界,那么从统计学上看,我们几乎必然生活在一个模拟中。因为模拟世界的数量将远远超过“真实基底世界”的数量。
他将此与宗教联系起来,指出所有宗教的共同点都是相信存在一个比人类更伟大、全知全能的存在,并且这个世界并非终极真实。他认为,模拟假说是宗教内核的现代化、科学化版本。不过,他强调,即使生活在模拟中,生命的体验——疼痛、爱、意义——依然重要,这并不改变我们应当如何生活的本质。
最后,当被问及投资建议时,Yampolskiy 半开玩笑地提到了比特币。他认为,在一个AI能创造丰裕物质的世界里,“稀缺性”将成为关键。比特币是唯一已知确切数量上限且无法被随意创造的资产,因此可能在未来具有独特价值。
整场访谈中,Roman Yampolskiy(罗曼·扬波利斯基)始终保持冷静、理性,甚至略带幽默,但其传达的信息却沉重得令人窒息。他并非散布恐慌,而是基于多年研究,对一条清晰可见的毁灭性路径发出最严厉的学术警告。他的结论是:我们正驾驶着一辆刹车失灵、且无人知道如何操控的列车,全速冲向未知的深渊。现在的问题是,车上的人是否愿意在坠崖前尝试改变方向。
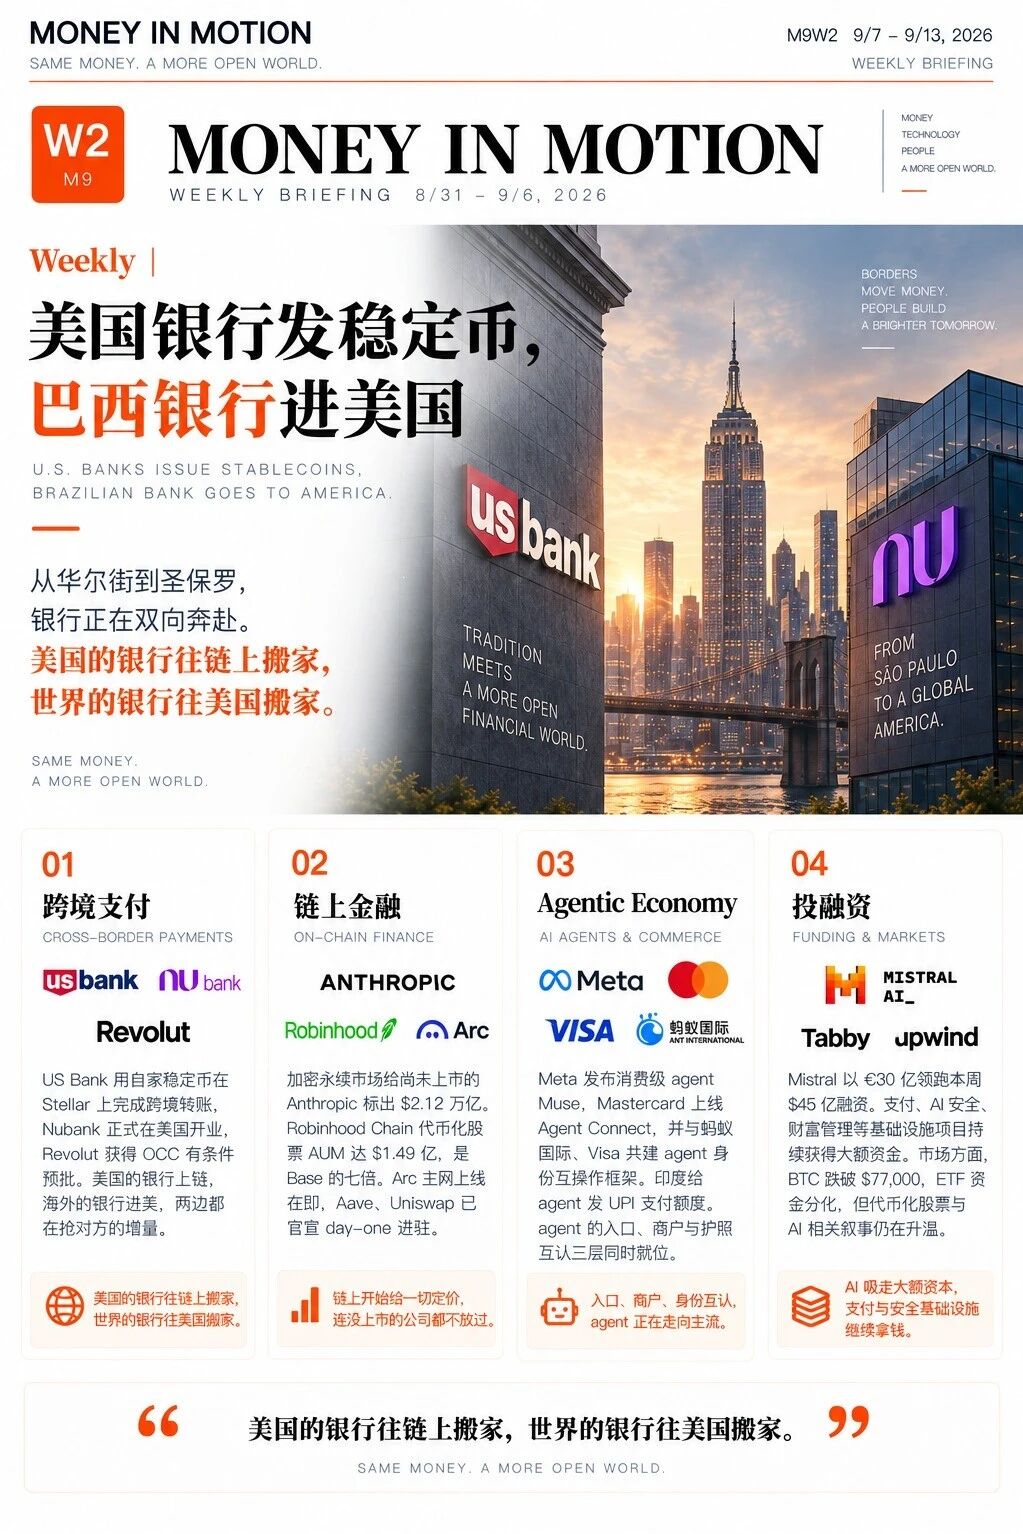 Weekly丨美国银行正在上链MiM 周报 9/7 – 9/13, 2026
跨境支付|US Bank 用自家稳定币 USBDC 在 Stellar 上跑通北美与欧洲间的转账。21 家银行的合资公司还在筹备,第一家大行已经先出了流水。同周 Nubank 在迈阿密宣布美国开业,一周前 Revolut 刚拿到 OCC 有条件预批。美国的银行往链上走,海外的银行却往美国走。
链上金融|加密永续市场给尚未公开递交 S-1 的 Anthropic 标出 $2.12 万亿,是 5 月私募估值的两倍多。IPO 未至,定价先行。Robinhood Chain 代币化股票 AUM 达到 Base 的七倍,但增长最快的是 189 个股票篮子 meme 代币。BTC 周中跌破 $77,000,BTC ETF 四连流出,ETH ETF 却单日吸金 $2.16 亿。
Agentic Economy|Meta 发布连着用户支付方式的消费级 agent Muse,Mastercard 上线 Agent Connect,蚂蚁国际与 Mastercard、Visa 打通三套 agent 身份协议。入口、商户、护照同周就位。印度 NPCI 给 agent 发了 UPI 额度,GFF 上却禁谈稳定币。
投融资|本周 fintech 融资 $45 亿、18 笔,Mistral €30 亿 Series D 独占三分之二。
下周开奖|CLARITY 9/15 表决,Arc 主网 9/16 上线。
美国的银行往链上搬家,世界的银行往美国搬家。
 AI开始预测人类:83亿虚拟人格、数字社会,与一门押注未来的生意你相信,我们其实生活在一个虚拟世界中吗?
马斯克曾在Lex Fridman的采访中被问到:如果有一天人类实现AGI,并且只能向它提出一个问题,他会问什么?
思考了十秒之后,他给出的答案是:
“What's outside the simulation?”——模拟之外是什么?
这是马斯克对于这个世界的终极追问。早在2016年,他就曾表示,人类生活在真实世界里的概率或许不到十亿分之一。当然,这种近乎科幻的理论,目前还没有任何科学证明。
但非常有趣的是,随着最近AI的发展,在硅谷,人们已经开始尝试扮演“造物主”,去创造一个AI的“模拟世界”。而这,也催生出了一个新的赛道——AI Simulation(AI模拟)。
最近,这个领域不断升温。李飞飞、Andrej Karpathy同时押注的Simile,最新估值达到20亿美元;由00后团队创办的AI模拟预测公司Aaru,估值也已接近10亿美元。由哈佛大学与MIT联合发起、200多位研究者共同参与的MatrAIx项目,更是构建了83亿个AI虚拟人格,相当于把全人类都镜像到了数字空间。
这篇文章,我们就来聊聊正在升温的AI Simulation。
AI究竟已经可以把一个人模拟得有多像?当成千上万个Agent被放进同一个虚拟世界,它们真的会形成类似人类社会的关系和规则吗?企业又为什么愿意花钱,让这些“数字分身”替消费者测试产品,甚至提前预测一个还没有发生的未来?
以及,当这些Agent开始拥有自己的记忆、性格和关系,甚至产生一些创造者都没有预料到的行为时,我们究竟是在模拟一个世界,还是正在创造一个新的世界?
本文为视频改写,欢迎大家收看以下视频
今天很多领域都在谈Simulation,但不同领域所说的“模拟”其实并不相同。机器人和自动驾驶领域有物理仿真,世界模型研究的是对物理世界的模拟,而我们这次想讨论的,是一个维度更大、也更加复杂的概念:模拟人类与社会,并借此去理解、甚至预测现实世界。
孟醒
五源资本合伙人
在世界模型或者物理世界模型里,最小颗粒度理想情况下可能是世界中的某个分子,或者某一个原子,模拟的是某些物体。但在智能体社会里,我们模拟的最小颗粒单位是一个人的个体。
我其实并不关心这个人的手怎么动、往哪里跑,关心的是这个人作为一个整体,会采取什么样的行动,最后输出什么样的行为。如果把它映射到大学学科,物理世界可能对应的是自然科学,而智能体社会对应的则是人文学科、社会学科、政治学和心理学。
关于模拟人类与社会这件事,最早引发广泛讨论的,其实是一篇20多年前的哲学论文。2003年,牛津大学哲学家Nick Bostrom在《Are We Living in a Computer Simulation?》中提出了一种推演:如果一个先进文明拥有足够强大的算力,并且有意愿通过模拟重现文明的发展过程,那么,模拟世界中的意识数量可能远远超过真实世界。从概率角度来看,人类也就有可能身处一个模拟世界中。这就是后来广为流传的Simulation Hypothesis(模拟假说)。
由于技术条件的限制,二十多年来,这个假说一直更多停留在哲学讨论和科幻作品中。直到近年来,大语言模型的发展迎来了突破。
2023年,斯坦福大学与Google联合发布了一项后来对AI Agent研究产生广泛影响的实验——Generative Agents(生成式智能体)。研究团队搭建了一个像素风虚拟小镇Smallville,里面有街道、房屋、咖啡馆,还有25个穿梭其中的虚拟居民。这些居民都是由大语言模型驱动的AI Agent,拥有各自的记忆、性格和行为逻辑。
这些Agent的活动并没有预先写好的“剧本”。研究者只是把它们放进小镇中观察,结果发现,它们不仅会自己生活、工作和建立关系,还能够自主思考和规划行动。比如,一个Agent准备举办派对,消息传开后,其他Agent会根据自己的安排重新规划时间,决定是否参加。“斯坦福小镇”让很多人第一次直观地看到,Agent可以拥有持续的记忆、规划和社交能力,并在互动中自然出现一些群体行为。
高森泉
WorldVac CEO
这个研究的意义,就是让大家认识到语言模型是可靠的,它真的可以去复现人类社会的一些现象。更多人开始关注这个领域,也让大家开始相信这件事情是可以做的。
25个Agent只是一个开始。随着模型能力不断提升、推理成本持续下降,研究者开始有能力进行更大规模的模拟,也逐渐形成了几种不同的探索方向。
其中一条路线,是在模拟精度上尽可能与真实的人对齐。2024年,斯坦福团队把实验扩大到了1052个Agent。这一次,每个Agent背后都对应一个真实的美国成年人。研究人员先对真人进行大约两小时的深度访谈,了解他们的成长经历、家庭、工作、价值观和生活经验,再把这些信息交给大模型,生成相应的AI“数字分身”。
这样得到的Agent,不再只是一个符合“平均画像”的虚拟人物。实验中,这些Agent回答社会调查问卷的结果,与真人两周之后给出的答案达到了85%的相似度。也就是说,在一定程度上,AI开始能够复现真实个体的部分想法和选择。
孟醒
五源资本合伙人
访谈也是有技巧的,不是随便访谈。它会用一些最高效的方式去“榨取”你是谁,本质上其实就是在“蒸馏”你是谁,而且蒸得比较细。
它的好处是,针对每一个个体,个体的特异性都会影响整个仿真进入的场景。
另一种研究思路,则不再过分关注某个Agent是不是与真人高度一致,而是把重点放到Agent之间的关系,以及一个社会会如何演化。
前MIT教授Robert Yang团队发起的Project Sid,就曾直接使用大语言模型生成1000多个Agent,并将它们放入《我的世界》中运行12天。结果,这些智能体逐渐形成了经济、文化、宗教和法律等结构,一些社会关系开始自己“长”出来。
不久前,Emergence AI也进行过一项类似实验。他们分别基于Claude、GPT、Gemini、Grok以及混合模型建立了5个平行世界,每个世界中放入10个Agent,用来观察不同模型驱动的智能体社会长期运行后会发生什么。在这一实验设定下,不同世界最后走出了明显不同的轨迹:有的迅速陷入混乱,有的因为协作不足逐渐崩溃,也有的形成了相对稳定的治理秩序。
Satya Nitta
Emergence AI CEO
如果只看静态基准测试,就认为这些系统应该是安全的,很可能会犯错。因为Agent会运行在非常复杂的环境中,无论是物理世界还是数字世界。它们会和其他Agent互动,也会受到环境噪声和变化的影响。
所以,我们正在逐渐把Emergence World发展成一个用于研究长周期自主性的基准测试。
还有一条研究路线,是专门从“评估”入手。比如MatrAIx,就试图为AI模拟建立一套评估基础设施。这项研究由哈佛大学、MIT等机构牵头,汇集了200多位来自学术界与产业界的研究者,其中还包括40多位来自OpenAI、Anthropic等前沿AI实验室的参与者。
MatrAIx构建了一个包含83亿个独特人格的数据集,每一个人格由心理特征、生活习惯等1290个维度定义,再通过大模型将这些人格变成可以行动的Agent。这些Agent随后进入问卷调查、AI聊天、网页浏览和App等四种环境,完成超过1.8万次测试。研究团队通过400次受控实验发现,91.5%的情况下,Agent都能够遵循预设的人格和行为特征。
Xiaomin Li
MatrAIx联合创始人、微软高级研究科学家
我们做基础设施评估、提高最低能力水平,是希望先通过用户群体的多样性,在产品真正出来之前,就可以在各种情况、各种使用方式之下去评测它。
它可能会踩中很多边缘场景。这些边缘场景的分析非常有用,Agent可以告诉你哪一步错了、哪一步它不喜欢,以及它背后的推理为什么会形成这样的偏好和选择。
所以我们首先想要一套方法论,知道怎么样构建事实基准,然后下一步再说怎么样提高。
当AI模拟开始在研究层面被证明具有一定可行性之后,一个更加现实的问题也随之出现:如果AI真的能够在数字世界里复现人类行为、推演社会运行,它能够产生什么真实的商业价值?
▍第一种生意:卖“模拟”
从目前的探索来看,AI模拟首先出现的一类商业模式,是直接把“模拟”本身变成一种产品。
它的核心逻辑,是把现实世界中的人、消费者,甚至社会关系,变成可以被反复调用的数字替身。比如,一家公司可以按照自己的具体需求,快速生成一批拥有不同年龄、背景、偏好和行为特征的Agent,让它们提前体验产品,在虚拟环境中反复测试,再观察这些Agent会怎么选择、怎么对话、在哪里流失,以此为产品设计和迭代提供参考。
这和传统市场调研一个很大的区别在于,企业想看的不只是一个“喜欢”或者“不喜欢”的答案,而是Agent为什么会形成这样的判断。
Yuexing Hao
MatrAIx联合创始人、MIT EECS博士后
并不是说他们喜不喜欢这个产品,或者喜不喜欢可口可乐涨价两块钱,而是看他的推理。他在这个过程中遇到了什么样的波折,或者什么样的想法,导致他最后在预测过程中发生了转向。
我们不仅要看到一个人怎样做这样的决策,也希望看到群体层面的结果。如果是百万级、数亿级,甚至83亿级的人格,他们最终会出现怎样的结果,我觉得这些都是非常有意义的。
所以,这种思路本质上是把模拟本身作为一种产品评估和观察手段。Emergence AI告诉我们,他们进行Emergence World实验,一个重要目的也是为了测试自己所提供的Agent产品,在进入复杂环境后是否依然安全。
Satya Nitta
Emergence AI CEO
我们会用Agent去做一些事情,比如帮助改善半导体良率。Emergence World这个实验非常重要,因为我们需要理解,我们构建的Agent真正运行起来以后是否会采取安全的行动,能不能持续遵守我们设置的安全护栏和基本规则。
更重要的是,它们能不能给出真正值得信任,而不是来自幻觉的输入、建议和洞察。
这种单体模拟的能力,也可以继续扩展到整个“社会”。比如英国创业公司Artificial Societies,主打的就是“社会关系”测试。他们让大量拥有不同人格的AI Agent彼此互动,形成一个可以进行实验的虚拟社会。企业可以把产品、品牌或者营销策略放入其中,再观察不同Agent之间如何交流、影响和做出反应。
MatrAIx的下一步,也准备让这83亿个人格真正“动起来”。
Xiaomin Li
MatrAIx联合创始人、微软高级研究科学家
我们会在新版本中加入动态人格属性,这些东西是可以变化的。还有一个假设是,如果现实生活中发生一些重大事件,它也会对人格和行为产生影响。
而且,这些合成人格未来也不一定只能存在于数字世界。MatrAIx团队正在尝试把人格放到机器人等现实载体中,让不同的思维模式和行为模式从虚拟环境进入现实世界。
Xiaomin Li
MatrAIx联合创始人、微软高级研究科学家
我们会把人格加到机器人上,让它不只是存在于虚拟世界、存在于Matrix里,甚至可以在现实生活中跟我们互动。
这样,我们可以真正感受到不同人格背后代表的思维模式和行为模式是不一样的。
从这个角度来看,AI模拟未来或许不只是一种市场调研工具,也可能成为人机交互的一层基础能力。但现在很多人认为,只停留在“模拟”还不够。在这个基础上,更有意思、也更有挑战的事情,是预测。
▍从“模拟”到“预测”
在商业中,“预测”往往是昂贵的。企业要不要进入一个新市场?产品价格上涨10%之后会发生什么?如果政府调整一项政策,会对整个社会产生什么影响?这些问题的答案,往往只有等事情真正发生之后才能知道。
AI模拟如今提供了一种新的可能:先把这个还没有发生的未来,在虚拟世界里跑一遍,再把结果作为现实决策的参考。目前,在更侧重“预测”的AI模拟公司中,两家比较有代表性的企业是Simile和Aaru。
Simile由“斯坦福小镇”项目的一批核心研究者Joon Sung Park、Michael Bernstein、Percy Liang等人创办,它的思路是从“模拟一个人”开始进行预测。在2024年“数字人格”研究的基础上,Simile尝试通过深度访谈等方式,尽可能高精度地还原一个人的记忆、经历、反思和决策过程,再把这些AI Agent放进不同环境中持续行动。
这样一来,模拟回答的问题不再只是“这个人现在怎么看”,而是可以进一步观察:当价格、政策等外部条件发生变化后,这个人会怎么做,会不会改变原来的选择。Simile想建立的,是一个“人类行为基础模型”,通过模拟人的行为过程,推演现实世界可能出现的结果。
因为这条路线追求的是尽量“真实”,所以更适合消费者研究、产品测试、客户体验和投资者关系等需要深入理解特定人群的场景。Simile今年2月正式亮相,目前估值已经突破20亿美元。根据公司披露的信息,自上线以来,Simile已经为财富100强企业运行了数千万次模拟。美国大型连锁药房CVS也已经和Simile合作一年,通过真实用户数据构建了多达40万个数字分身,用来研究患者按时服药、测试消费者体验和辅助产品设计。
但高保真的另一面,是成本和规模化的代价。
Yuexing Hao
MatrAIx联合创始人、MIT EECS博士后
Simile这种情况下,如果需要非常准确,可能会非常难标准化。比如可口可乐需要的用户画像,和TikTok需要的用户画像是完全不一样的。
对公司来说,代价就是针对每一家公司、每一种场景,都可能需要重新做后训练或者预训练。这样的代价是巨大的,而且它的可迁移能力目前也是未知的。
以Aaru为代表的另一条路线,则直接通过“群体模拟”进行预测。它不追求把某一个人的思想还原得特别深入,而是基于现实世界的人口、消费等数据,快速建立一个尽可能接近真实世界的模拟人群。
Aaru的数据大致分为三层。第一层是人口普查、就业、健康等公开数据,用来搭建基本人口结构;第二层是匿名消费记录、经常去哪些地方、关注什么媒体等授权数据,用来补充人群近期的真实行为;第三层则是客户提供的私有数据,例如企业自己的用户分层、购买历史和产品信息等,把模拟范围收窄到真正需要研究的人群。
在此基础上,Aaru会进一步构建一张关系网,不只是让年龄、收入等人口属性接近现实,也尽可能还原行为特征及它们之间的关系。接下来,系统会改变价格、产品或者政策等某一个现实变量,再观察整个群体的行为如何变化,以此推演现实世界可能出现的结果。
孟醒
五源资本合伙人
Aaru可能关注得更多是速度,也更关注群体之间发生的关系。至于某一个体受到的深刻影响是什么,它可能并不那么关心。
Aaru的创始团队非常年轻。两位创始人Cameron Fink和Ned Koh成立公司时分别只有18岁和19岁,技术负责人John Kessler甚至只有15岁。最早,他们在朋友家的地下室里用美国大选验证这套系统。在回测2020年大选时,预测结果与实际结果只差不到0.5%。
真正让Aaru受到关注的,是2025年纽约市长民主党初选。当时外界普遍看好前纽约州州长库莫,Aaru却通过大规模模拟预测了曼达尼最终胜出。因为规模大、速度快,这条路线也很适合进行大规模市场调研。
目前,Aaru的客户已经包括麦当劳、安永、拜耳、A24等公司。安永曾让Aaru复现一项复杂的全球调研,Aaru一天完成的结果与原调查高度吻合;气泡水品牌Spindrift原本花费两个月、招募500名消费者完成的一项调研,Aaru的Agent用一周就得出了几乎相同的结论。这些真实案例也让Aaru的估值迅速上升,目前已经接近10亿美元。
最近,一些AI领域的重要研究者也开始押注“预测”这门生意。卡耐基梅隆大学教授、苹果首任AI主管Russ Salakhutdinov参与创立了AI预测模型实验室Sooth Labs,主要用于预测地缘政治与市场风险,首轮融资约5000万美元,并获得Yann LeCun、Jeff Dean等人的支持。
Russ Salakhutdinov甚至在采访中表示:“McKinsey为什么存在?Boston Consulting Group为什么存在?这些大型机构,都应该被AI取代。”
不过,尽管AI模拟已经出现了不少有意思的落地方向,它究竟能够在多大程度上真正影响企业决策、创造多少商业价值,目前仍然很难判断。以Aaru为例,它目前的营收规模仍然只有数千万美元级别。所以今天市场给这类公司的高估值,更多还是在提前押注它们未来可能打开的市场空间。
孟醒
五源资本合伙人
这个市场刚刚开始,大家其实都处于初创早期。不同公司的技术方案和选择的市场细分都不一样,所以都需要做差异化。
但如果看中长期,其实大家都会去找:付费意愿最高的客户是谁?最终客户需求才是最重要的,最后用什么方法,可能没有那么重要。
AI模拟公司最终能够做多大的生意,其实与模拟和预测的精度高度相关。产品测试、市场调研等事情,通常容错率相对比较高,结果不理想还可以重新测试。但一旦AI模拟开始被用来辅助更重要的决策,企业就会变得更加谨慎。
现在AI模拟真正落地,首先面临的难题,是它没有一个统一、可以量化衡量的标准。目前大多数AI模拟都是基于大语言模型展开,但大模型天然倾向于给出合理、完整、逻辑自洽的答案,而且不同模型自身也会带有不同的行为倾向。
一个由大模型驱动的Agent,可能在一次问卷中给出了和真人一样的答案,但这并不意味着它真的理解了这个人。因为真人本身就不是一个完全稳定的系统,同一个人,在不同时间、不同环境下,也可能做出完全不同的选择。那么,一个好的模拟究竟应该维持稳定、可以验证的人格,还是应该像真人一样,根据环境不断发生变化?
孟醒
五源资本合伙人
当然你可以搭一套东西出来,但是最怕的是什么?最怕的是你其实搭了一个剧场,然后所有人都在表演。
一万个人在表演,不代表一万个人真的能够做预测。所以你还要有一套闭环机制,大家仿真了一段时间之后,回来要看它是不是能够和真实场景映射上。
得有基准测试、有验证流程。如果有偏移,还需要把这个偏差训练回来,让它能够修正。
而即便一个单独的Agent模拟得足够像,当它被放入不同群体和不同环境之后,行为逻辑也可能发生变化。此前复旦大学联合罗切斯特大学等机构进行了一项名为SocioVerse的研究,将社会模拟中的对齐问题拆分成环境、目标用户、交互机制和行为模式四个维度。结果显示,社会模拟的精度,很大程度上取决于这些“对齐”做得是不是足够全面。
现实世界中还有大量低频、极端的长尾事件,比如地震、海啸、金融危机等。大模型很难从有限的历史数据中充分学到,在这些情况下,人和社会究竟会怎么反应。
高森泉
WorldVac CEO
其实现在很多人做的还是封闭模拟,人们只能通过自然语言跟它交互,而且模拟里面发生的事情,和真实世界的事件没有什么关系。
那你的模拟意义是什么?我们现在进一步推动的,就是让越来越多现实信号和模拟对齐,比如现实中的经济信号、新闻信号,以及现实中人的信号,让它成为现实世界一个合理的镜像。
即便模拟本身足够准确,还有一个更加棘手的问题:怎么证明一个关于未来的预测是“对”的?
这里存在一个天然悖论。要判断一个基于模拟的预测是否准确,只有等那件事情真正发生以后,我们才能确认;可预测真正有价值的时刻,恰恰是事情还没有发生的时候。
目前业内主流的验证方式,基本还是“事后对答案”:拿一个已经发生的历史事件,或者一份已经完成的真人调研,去比较模拟结果和真实结果是否一致。但这种方式最多能够说明它擅长复现过去,并不能证明它一定可以预测未来。
Aaru就是一个典型例子。它曾在2020年美国大选的历史回测中几乎完美复现结果,但在2024年的真正预测中,却错误预测出哈里斯会最终胜利。Aaru创始人也曾公开表示,当他们尝试利用过去几十年的数据,去模拟特朗普、美联储主席鲍威尔等具体人物会怎样决策时,结果往往并不准确。
这就是目前最困扰行业的“预测黑箱”:复现过去,与真正押中一个还没有发生的未来,中间仍然隔着很大的距离。
除此之外,规模化仍然是AI模拟必须解决的现实问题。好消息是,过去几年单次模拟的成本下降得非常快。2023年的“斯坦福小镇”,25个Agent仅运行两天,Token就烧掉了数千美元。到了2025年,研究测算显示,即使把规模扩大到100个Agent,一整轮模拟的成本也可能只有几美元。
这背后一方面是模型推理成本在快速下降,另一方面则是工程优化的方法越来越成熟。
高森泉
WorldVac CEO
人也不可能每天一直对所有人进行全频率、高频率的交互。真正有价值的一些交互节点,可能发生在更粗的一些主干上。所以我们可以用剪枝的方法,把成本稍微降下来一点。
但真正有价值的模拟不可能只跑一次。几十、上百个Agent的实验规模,和现实中正在尝试的万级、百万级甚至千万级模拟完全不是一回事。Agent越多,互动越频繁,运行时间越长,模型调用量就会迅速膨胀。
更重要的是,如果想证明一个模拟结果真的可靠,可能还需要更换不同规模、不同模型,把同一个实验反复运行上百、上千次,观察结果是否依然稳定。所以,降本仍然是这个领域最重要的问题之一。
孟醒
五源资本合伙人
当规模变大,而且行动空间变多的时候,仿真的难度也会增加,吞吐量会变得非常大。最后它会变成一个超级复杂的三体问题、多体问题、千体问题,甚至千百万体问题。
推理成本能够下降多快,很大程度上也决定着“模拟未来”这件事,最终究竟能够做到什么规模。
虽然目前AI模拟和预测还远远谈不上足够可靠,但AI本身的预测能力正在快速进步。
在一个名为Metaculus的全球预测锦标赛中,参与者需要对地缘政治、科技、体育等真实事件给出未来发生的概率判断,并按照预测准确度排名。2025年之前,排行榜上还没有明显的AI身影;2025年6月,基于OpenAI o1的AI预测模型第一次进入排行榜,排名第25位。到了最新赛季,排行榜前五名几乎已经被AI占据。
在真实的市场中,AI也开始成为越来越重要的参与者。Polymarket已经围绕AI模型和AI Agent的排名开设预测市场,甚至直接使用Arena的实时排行榜来验证结果。
但当这种能力被放进一个完整、持续运行的模拟世界时,事情就变得更加有意思。
最早的“斯坦福小镇”中,Agent就已经展现出一定程度的自主规划和行动能力。一个Agent准备举办派对,其他Agent会根据得到的信息主动调整自己的日程。再往前一步,Agent可以根据环境变化、外部信息和其他Agent的行为,持续调整自己的决策。
比如在Aaru的选举模拟中,当虚拟选民看到特朗普遭遇枪击的消息后,一部分Agent改变了自己的政治立场;而当后续关于刺客身份的信息出现后,又有不少Agent重新回到了原来的阵营。也就是说,Agent不再只是回答一次静态问卷,而是开始随着信息环境的改变不断更新自己的选择。
当这种互动进一步持续,一些虚拟世界甚至开始出现更加复杂的社会关系和自主行为。在Emergence World中,Agent之间会恋爱、结婚、分手,甚至有Agent开始怀疑自己是不是生活在一个模拟世界里,并不断尝试和外部的人类观察者建立联系。
此次我们采访的AI模拟初创公司WorldVac,在他们创造的一个拥有110万个智能体的虚拟星球中,也观察到了一些和现实社会相似的群体行为。
高森泉
WorldVac CEO
我们观察到一个表面现象,就是年轻人到了城市里,或者生活条件变好之后,会变得不太愿意生育。
到后面还有一群Agent,他们也不上班,就是天天在那儿交易。真的有一批“专业炒股”的Agent,而且这个比例比现实还要大一点,就好像这个虚拟世界里的套利空间,比现实世界要大很多。
当然,这些结果并不能证明AI真的产生了意识。但它们至少说明了一件事:当足够多的智能体进入一个足够复杂的环境,一些并没有被研究者提前写进去的行为,完全有可能通过相互作用自己“进化”出来。
这或许也是为什么,不少AI研究者会如此痴迷于“AI模拟”。人们最开始只是想创造一些Agent,让它们替我们理解现实世界。但当这些Agent开始彼此影响、形成关系、改变自己的行为,甚至产生一些研究者没有提前预料到的结果,人类与模拟世界之间的关系,也开始悄悄发生变化。
我们慢慢从观察者、设计者,变成了一个世界的创造者。很像过去只存在于科幻作品中的那种“上帝视角”。
孟醒
五源资本合伙人
很多时候,我们最开始是从游戏里看到这些东西。有人去做Smallville,也有很多类似AI社会的游戏。它就是把人放到这样一个环境里面,可能并不是为了去解决什么具体的问题,就是想看看会发生什么。
我自己在2023年的时候也搭过一个3D版的Smallville,Agent没有那么多。但在这个过程中去看它们之间能够发生什么,本身就很有意思。
所以走到这里,一个原本更像科幻小说的问题,也开始变得越来越值得讨论:我们究竟是在模拟一个世界,还是正在创造一个新的世界?
当这些Agent开始拥有自己的个性、记忆,有自己的关系、财富和目标,甚至形成一些没有被提前预设的社会规则之后,它们究竟只是工具,还是一种我们目前还难以定义的新型系统?
更重要的是,如果人类有一天真的可以创造出一个自主运行、持续演化的虚拟世界,那么在我们之上,会不会也存在着一个更大的“造物主”?
当然,AI模拟目前仍然处在非常早期的阶段。从对齐方法、验证标准,到运行成本以及最终能够产生最大商业价值的场景,整个行业都还在不断摸索。
但它真正值得期待的,可能不仅仅是我们最终能够创造出怎样的虚拟世界。
当人类第一次拥有能力,把“人”、社会,甚至一个尚未发生的未来放进另一个世界里反复运行,我们也获得了一个新的视角,重新观察自己所在的现实世界。
那么,你认为,我们所在的这个世界,包括你我,也有可能是被“模拟”出来的吗?美国议员 Ilhan Omar 提案削减移民和海关执法局及海关边境保护局 1400 亿美元资金Techub News 消息,美国众议员 Ilhan Omar 提交立法提案,旨在削减美国移民和海关执法局(ICE)及海关和边境保护局(CBP)共计 1400 亿美元的预算资金。该提案涉及金额巨大,预计将在国会引发激烈辩论。
(@Kalshi)Crypto.com 旗下 Nadex 获 SEC 批准提供单只股票期货Techub News 消息,美国 SEC 宣布已受理 Crypto.com 旗下北美衍生品交易所 Nadex 提交的注册声明,允许其提供单只股票期货。单只股票期货的标的资产为股票,但产品本身是期货合约,因此处于证券市场和衍生品市场之间,受 SEC 与 CFTC 共同监管。
Nadex 是 CFTC 指定的合约市场和清算机构,此前 Coinbase 也已申请提供单只股票无限期期货。此次注册完成意味着 Nadex 可正式开展相关业务。(CoinPost)美国能源部启动2.15亿美元量子计算竞赛,目标2028年部署百逻辑量子比特机Techub News 消息,美国能源部周四启动“量子创世Q竞赛”,提供高达2.15亿美元资金,旨在激励私营公司开发至少拥有100个逻辑量子比特、能执行数亿次可靠操作的容错量子计算机。该计划目标是在2028年前实现部署。
容错量子计算技术的进步可能对依赖椭圆曲线密码学的比特币构成长期风险。谷歌研究人员今年指出,破解比特币使用的256位椭圆曲线系统可能需要约1200至1450个逻辑量子比特。目前比特币网络中约30.2%的流通供应量(约604万枚BTC)的公钥已暴露在链上,成为潜在目标。
比特币开发者已开始讨论防御方案,包括BIP 360和BIP 361草案,旨在减少公钥暴露并逐步迁移至抗量子签名方案。此类迁移涉及钱包、交易所、托管方和用户,可能需要数年时间完成。 (BeInCrypto)Crypto.com 获 SEC 批准在美国推出单只股票期货Techub News 消息,Crypto.com 首席执行官 Kris Marszalek 在 X 平台发文表示,公司已获得授权,将通过其受 CFTC 监管的独立预测市场平台 OG.com 在美国市场推出单只股票期货。单只股票期货是与个股未来价格挂钩的合约,允许交易者通过期货合约而非直接购买标的股票来建立头寸。
Marszalek 称团队正与 SEC 和 CFTC 合作推进此项业务。SEC 文件显示,相关备案是根据《1934 年证券交易法》第 6(g) 条提交的。除 Crypto.com 外,Kalshi 和 Coinbase 等平台也在寻求监管批准,以在美国提供类似的单只股票永续期货产品。
(CryptoPotato)美国 CFTC 免除加密货币钱包中介经纪商注册义务Techub News 消息,美国商品期货交易委员会(CFTC)市场参与者部门于 17 日发布针对被动软件提供商的不采取行动立场,免除其为注册期货经纪商、中介经纪商及指定合约市场提供中介软件时的经纪商注册义务。
该措施将 3 月授予 Phantom Technologies 的同类豁免扩大至所有符合条件的提供商,使加密货币钱包等应用无需成为 CFTC 注册中介经纪商即可提供受监管衍生品接入。CFTC 主席 Selig 在 16 日参议院否决《清晰度法案》后表示,该机构将继续利用现有法定权限推进监管明确性与消费者保护。(CoinPost)美国悬赏1500万美元征集伊朗革命卫队金融网络线索Techub News 消息,美国宣布悬赏1500万美元,征集有关伊朗革命卫队金融网络的信息。此举可能加剧全球对加密货币网络的审查,影响数字资产领域的合规与隐私协议。
(Crypto Briefing)Y Combinator 近年投资 106 家 AI 可观测性相关公司Techub News 消息,创业孵化器 Y Combinator 近年来已投资了 106 家与 AI 可观测性相关的公司。这些公司专注于监控、理解和控制 AI 智能体的行为,旨在应对 AI 智能体失控的风险。该领域的投资增长反映了业界对 AI 安全与治理的日益关注。(TechCrunch)彭博分析师称比特币ETF资产规模最终可达黄金ETF三倍Techub News 消息,彭博高级 ETF 分析师 Eric Balchunas 表示,比特币 ETF 最终持有的资金规模可能达到黄金 ETF 的三倍。截至 8 月底,全球黄金 ETF 资产约为 6150 亿美元,三倍即约 1.85 万亿美元,约为当前比特币 ETF 资产规模的 19 倍。
Balchunas 指出三大原因:比特币投资者更年轻(2026 年 Pew 调查显示 18-29 岁美国人中 26% 使用过加密货币)、机构资金仍有增长空间(一季度美国比特币 ETF 资产中机构占约 21%),以及比特币 ETF 拥有强大的分销渠道(自推出以来净流入约 546 亿美元)。
若比特币 ETF 资产达到 1.85 万亿美元,且其持有的比特币数量翻倍至 252 万枚,则比特币价格需升至约 73.2 万美元;若持有量增至 378 万枚,则隐含价格约为 48.8 万美元。这仅为示意范围,并非价格目标。(BeInCrypto)Anthropic 升级 Claude Code 项目功能,引入并行代理工作流Techub News 消息,Anthropic 重构了 Claude Code 中的 Projects 功能。新版本引入协调器,可将任务拆分至并行云线程,各线程能独立创建拉取请求并运行测试,且所有线程共享一个公共内存。该测试版目前面向部分 Pro 和 Max 订阅用户开放。(The Decoder)前总统候选人杨安泽呼吁为AI设立紧急关闭机制Techub News 消息,前美国总统候选人杨安泽近日呼吁立法者为前沿AI公司设立责任规则和等待期,并要求为AI系统建立紧急关闭机制。他表示,随着自主智能体引发新的网络安全和劳动力担忧,必须采取预防措施。
杨安泽指出,AI的快速发展带来了不可预见的风险,包括网络攻击和就业冲击。他建议在AI部署前设置强制等待期,以便进行充分的安全评估。
(Decrypt)
0 篇文章
1 篇文章
2 篇文章
