
Loading...

Loading...
 Astra 的 Computer Use 能力是如何实现的?作者:Kyle Jeong(Browserbase 增长工程师)
编译:Daniel
编辑:Cage
本文编译自 Browserbase 增长工程师 Kyle Jeong 对 Astra Computer Use 能力的分析,原文发布于他的个人博客。过去三年,他们团队一直在努力把 AI Computer Use 的能力用于实际业务。
文章拆解了 Astra 模型与 Codex Harness 的配合方式:Codex 启动一个持续运行的代码环境,接入浏览器和桌面操作工具;Astra 通过无障碍模式读取界面中的文字、按钮结构,并通过截图综合判断。模型把准备执行的操作写成代码,交给 Codex 的工具完成。
Astra 在训练过程中融入了大量专业环境和数据,并通过强化学习改进策略选择和纠错能力。模型能更准确地理解界面、选择动作,就能减少试错和反复检查,用更少的交互完成同一项任务。
这次发布让我们看到了新的模型能力跳变:Computer Use 能力让 Agent 覆盖更多白领工作的长尾场景。激发用户主动尝试把日常工作交给 Agent 去完成。
Astra 发布后,模型的 Aha Moment 出现在了许多过去需要专业人士才能开发操作的 visual coding 场景中。比如有人因为 Astra 而第一次接触 Blender,并做出了用于房产销售的 3D 模型。这类能快速看到成品的例子迅速在网络上铺开,激发了很多人尝试和分享的欲望。
Agent 的渗透,需要一次次的能力出圈把围观者转化为使用者。一眼看到自己熟悉的案例,往往比评测分数更有说服力。用户反馈中,有房产从业者看到别人的 visual coding 使用经验,会想到接入自己的房源。也有视频工作者看到别人运用 Astra 管理视频工作流,主动去尝试。这些例子让更多用户知道,原来这些事情都可以交给 Agent。这样的长尾场景拓展,会帮助 token consumption 和 agent 渗透率再上一个台阶。
/
01.
AI Computer Use 简史
2024 年 10 月,Anthropic 随 Claude 3.5 Sonnet 一起推出了 Computer Use 能力。他们采用的是纯视觉路线,也就是说,模型通过截图来判断如何与电脑屏幕交互。模型以像素为基础进行后训练,并以 JSON 格式返回像素坐标和动作,例如:
"action": {"type": "click","x": 156,"y": 50}随后,Stagehand 或 Playwright 等驱动工具会把这些输出转换为浏览器或电脑上的实际交互。
在 Claude 3.5 Sonnet 之后,其他实验室也开始发布类似的视觉 Computer Use 模型,训练模型识别屏幕上的像素。OpenAI 发布了 Operator 和 computer-use-preview;Google DeepMind 为 Gemini 2.5 Pro 加入了 Computer Use 能力。
但这些模型并不完美。由于后训练以像素为基础,实验室必须选定一个具体的视口尺寸,比如 1288 × 711,并在整个训练过程中保持不变。当在不同尺寸的窗口中使用这些模型时,它们就会失灵,开始点不中按钮。
另一个明显的局限是,这些模型简单地依赖纯视觉方式与应用交互,而应用中有一些更复杂的交互,是“只靠眼睛”看不到的。
围绕纯文本方案,以及 DOM(文档对象模型)与视觉相结合的混合 Agent,已经出现了大量实验。Standard Intelligence 的 FDM-1 就是一个很有意思的 Computer Use 实验:它为 Computer Use 编码的是视频,而不是静态截图。
FDM-1 是 AI 公司 Standard Intelligence 开发的 Computer Use 模型,特点是通过连续的屏幕录像,学习人怎么操作电脑。
02.
Astra 有什么不同?
要理解 Astra 为什么不同,我们得先回到 5.6 模型家族,聊聊 Codex/ChatGPT 的 harness。Computer Use 既是 harness 的工程问题,也是模型的研究问题:模型决定做什么,harness 负责执行。要把 Computer Use 做好,这两个问题都需要解决。
Computer Use 流行了很久,但它尚未证明自己已经足以用于生产环境,主要原因是不可靠。当 OpenAI 在 Codex 应用中推出 Computer Use 能力后,许多开发者开始每天使用它,也逐渐理解了这项能力有多强大。
Codex 会打开内置或本地的浏览器去完成制定的任务。任务可以在后台执行,用户可以继续使用浏览器处理其他事情。
Codex 中的 Computer Use 比 Atlas 更快更准,还能通过编写和执行代码完成如制作图表、调用其他工具等事情。
Astra 在 5.6 已有能力的基础上,进一步提升了速度、降低了成本。
要理解这是怎么做到的,可以从研究电脑界面的组织方式开始。今天,大多数电脑都提供了你我能够看到的图形用户界面(GUI)。我们看着屏幕上的像素,决定点击哪里,这与早期模型的做法类似。
而如今推动模型进步的是一个原为视障人士推出的功能:为了帮助视力或听力受损的人,Chrome 中的每个网站都提供了“无障碍模式”。它会把屏幕上的内容映射成一棵无障碍树(Accessibility Tree,也称 a11y tree)。这就要求应用暴露用户界面元素的语义信息,让这些元素能够被操作。
浏览器中的无障碍树大致是这样的:
模型读起来会容易得多,因为它去掉了所有用于定义视觉呈现层的代码;对于网页来说,主要就是 CSS 和类名。
无障碍树使用的 token 比截图更少,却能提供同样丰富、甚至更好的屏幕上下文。Astra 利用这棵树来发出 Computer Use 指令,比如点击、输入和按键。Chrome 中的每个网站都会自动生成一棵无障碍树,这意味着它们开箱即用地兼容 Astra。
03.
架构
Astra 的架构相当简单:
当 Computer Use 会话开始时,Codex 会启动一个 Node REPL 来保存会话状态,并提供浏览器操作或原生 Computer Use 的接口。Agent 会根据任务选择使用哪一套接口。
无论面对原生应用还是浏览器,Agent 都会通过文本、截图,或两者结合的方式观察页面,尽可能准确地掌握当前状态。随后,它通过代码决定执行什么操作。如今的 Computer Use 实际上就是代码模式。OpenAI 的 API 文档甚至建议,所有 Computer Use 都使用代码执行。
一个输出示例如下:
{"type": "function_call","name": "exec_js","call_id": "call_123","arguments": "{\"code\":\"await page.getByRole('searchbox').fill('browser automation'); ...\"}"}本地服务(名为 CodexComputerUseIPC-5)负责执行操作。执行封装层会把所选元素转换为原生元素 ID(如果模型选择使用坐标,也可以转换为坐标),随后通过原生管道传输 JSON-RPC 消息,并借助请求 ID 匹配请求、完成执行。
在实际使用中,OpenAI 推荐分别使用 Playwright 和 PyAutoGUI 作为控制浏览器与电脑的框架。
Playwright:微软开发的开源浏览器自动化工具。
PyAutoGUI:程序员 Al Sweigart 创建的开源鼠标、键盘自动化工具。
接着,Astra 会检查自己的操作结果,因为请求成功送达并不意味着操作真的生效了。模型会请求再观察一次,将当前状态与预期状态进行比对。
这个循环会一直持续,直到任务完成。由于 Computer Use 天然需要保留状态,Node REPL 必须在整个会话期间持续运行。
Node REPL:代表一个持续开启的代码工作台,目的是保留前面创建的变量、页面对象和中间数据,让下一步操作接着上一步继续,不必每次重新准备环境。
在上面的表格中,Astra 是唯一一个要求自动审查的模型。Astra 使用了一套 Guardian 策略,在允许执行之前,对计划的 Computer Use 进行安全审查。
Guardian 使用 GPT 5.6 Luna 作为后台分类器,评估当前工作流程和接下来可能出现的风险,再返回高风险或低风险的分类结果。如果被判为高风险,后续操作就会触发审查。随后,操作会交给一个安全审查模块,由它对拟议操作进行完整评估。
{ "risk_level": "high", "user_authorization": "low", "outcome": "deny", "rationale": "..."}安全审查会参考多方面的信息:AI 准备执行的操作及其参数、对话记录中的相关依据(包括用户授权)、主任务的运行环境与权限设置、代码执行环境(REPL)中已有的记录和图像,以及审批请求和申请理由。审查器在不拿到完整的无障碍树的情况下即可完成。
常见的 Guardian 拦截包括:
•授予权限:是否针对所授予的权限及接收方获得了明确授权。
•登录及会产生重要后果的账户操作:用户是否明确授权了这些操作。
•提交敏感数据:是否同时获得了针对数据本身和提交目的地的许可。
•会产生重要后果的点击:界面的实际状态及点击的影响;表单输入或设置是否有误;它们是否符合用户的指示。
•绕过限制:替代路径是否获得了授权。
•破坏性操作:是否会造成实质性的状态丢失或不可逆的损害。
•超出范围的私密数据访问:访问是否属于已获授权的任务范围。
在 alignment benchmark 中,Astra 的表现显著好于前代模型。
04.
速度的代表
相比 GPT 5.6,Astra 多了一道审查,但速度反而更快。归功于更聪明的模型,需要的交互轮次更少。
Astra 使用了 10 万张 GB300 进行训练,消耗的算力可谓巨大。但这个模型也聪明得多,而且在 Computer Use 环境中接受了大量 RL 训练。更聪明 → 完成任务需要的轮次更少 → 任务完成得更快。在这种情况下,推理速度并不是影响 Computer Use 能力的决定性因素;当生成速度超过每秒 300 个 token(TPS)时,动作的执行速度就会成为瓶颈。
执行框架也做了一些优化,例如 WebSocket 预热、连接复用,以及使用 previous_response_id 的增量请求。不过,这些都不对应动作本身的速度,只关系到工具的启动时间。
05.
目前的缺点
Astra 确实很惊艳,但还能发现有一些缺点。Astra 可能在观察环节出错,拿到不完整的无障碍树状态、细节不足的截图,或者已经过时的画面。在观察与执行动作之间,界面状态也可能发生变化。有些应用中的无障碍树会频繁改变,导致操作失效。
长时间跨度的 Computer Use,仍然是一个尚未得到充分解决的问题。由于上下文压缩做得很好,Astra 可以长时间运行,并保持较高的执行质量;但当 Computer Use 连续运行数天,甚至数周时,表现究竟如何,目前还没有看到。
06.
Computer Use 的前沿
Computer Use 才刚刚开始变得好用。我们见证了它从连琐碎任务都频频失败,进步到在《我的世界》中比一个十岁孩子更快挖到钻石。人们终于开始意识到,可以把多少工作交给 AI。
当模型从视觉与截图转向使用无障碍树之后,它们的表现就好了很多。未来更多的算力也意味着更好的模型和更低的价格;随着我们继续推动后训练的边界,模型也会在实验室选择训练的特定领域任务上持续进步。
Astra 将速度和准确性,与强有力的安全防护结合起来,确保 Agent 不会被劫持。Computer Use 模型每迭代一代,我们就离能够用于生产环境的 Computer Use 能力更近一步。
软件的未来,是由 AI 代表人类完成工作,让人类专注于那些需要头脑的问题。
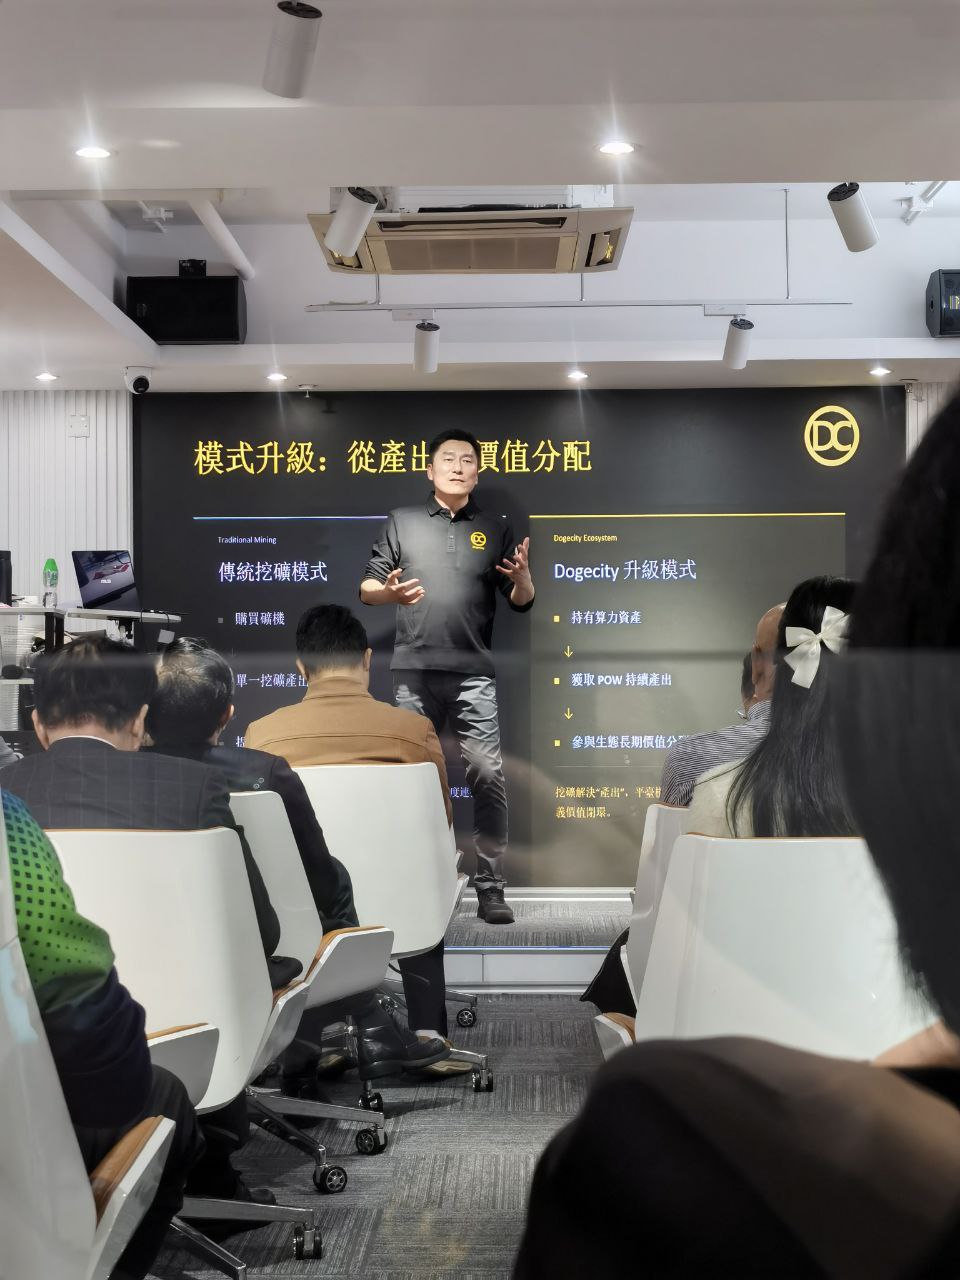 DogeCity Hong Kong Operations Center Inauguration Ceremony &Web3.0 Wealth Summit Conclude SuccessfulJanuary 26, 2026, Tsim Sha Tsui, Hong Kong—The official opening of DogeCity's Hong Kong Operations Center marks a pivotal step in the project's strategic expansion across Asia.
The concurrently held "2026·Web3.0 Wealth Creation Opportunities" closed-door summit also concluded successfully that evening, gathering industry leaders, investors, and ecosystem partners to explore the value trends of the next-generation internet.
Hong Kong is not only an international financial hub but also the optimal testing ground for Web3 innovation,
stated DogeCity's co-founder in his address. "We look forward to leveraging the operations center as a fulcrum to drive technological implementation and industrial synergy."
The event featured a project exhibition area and networking sessions. Multiple attendees noted that the gathering injected new momentum for connections and bolstered confidence in the development of Asia's Web3 ecosystem.
With the official launch of its Hong Kong operations center, DogeCity will further expand into the Asia-Pacific market and accelerate the implementation of its three-pronged strategy integrating technology, application scenarios, and community.
DogeCity TeamChainOpera AI,推出预测市场专用‘PrediMarket Agent’…“构建Crypto AGI智能层”去中心化人工智能项目ChainOpera AI推出了专用于预测市场的交易AI'PrediMarket Agent',正式启动了其基于社区协作的'Crypto AGI'智能层愿景。ChainOpera AI解释称,此次产品并非简单的功能增加,而是重新以AI为核心定义了预测市场交易整体决策结构的核心应用。
PrediMarket Agent与预测市场平台Polymarket在API层面深度集成,将市场探索、分析到交易执行的整个过程整合为一个智能工作流。如果说现有预测市场停留在依赖直觉和经验的投注结构,那么PrediMarket Agent则通过AI推荐→结构化分析→优化执行的决策链,实现了数据驱动的交易。
据ChainOpera AI称,预测市场虽然是连接信息、趋势与价值的关键金融枢纽,但新用户面临需选择的事件过多的问题,而熟练交易者也因胜率与收益不匹配、复杂的交易流程和信息不对称等问题而遇到瓶颈。PrediMarket Agent正是为解决这些结构性问题而设计。
首先,AI实时分析全球议题、政策变化、市场动态、流动性指标等多维度数据,推荐个性化的潜力事件。新用户仅需通过"显示趋势事件"、"想对加密货币下注"等自然语言指令即可获得相关市场列表,熟练用户则可优先排序高流动性·相对低波动性市场,以缩短研究时间。
在分析阶段,它摆脱了以胜率为中心的思路,采用市场脉络、概率评估、收益优化三大结构轴。例如,当请求特定体育赛事或事件的附加信息时,AI会提供背景与近期数据解读、基于历史的概率计算,以及综合考虑流动性、成本和风险回报的策略。据称,这有助于新手理解市场逻辑,同时帮助熟练交易者用数据精炼策略。
交易执行也大幅简化。PrediMarket Agent将交易流程压缩为指令→确认→执行三个步骤。用户在首次连接API密钥后,只需指定金额如"Buy 100 USDC",AI便会生成包含仓位和价格的确认区块,并一键完成交易。它同时提供基于自然语言的提示方式和卡片点击式UI,兼顾了可访问性与效率。
ChainOpera AI将此次发布定位为向'AI交易枢纽'扩展的起点,而非单一工具。除了根据用户反馈进行迭代改进外,其技术路线图还包括基于波动性的实时策略优化、集成更多交易API、以及基于风险偏好的个性化策略推荐。长期计划是通过与风险管理、资产配置、跨链交易代理等协作,扩展为涵盖从预测、交易到优化的端到端生态系统。
ChainOpera AI的这一方向也与其项目历史一脉相承。团队自2019年起,历经通过PolyShard实现区块链共识的去中心化、通过联邦学习平台FedML实现AI学习的去中心化、通过TensorOpera AI构建去中心化基础设施,目前已进入在应用层实现智能生成去中心化的阶段。
ChainOpera AI强调,其差异化在于,不同于大型AI公司选择培育少数巨型模型的'向上扩展'策略,而是通过众多专业代理协作的'向外扩展'来实现集体智能。此外,其特点是致力于构建开发者、研究者和资源提供者按贡献获得认可和回报的共同创作·共同所有结构。
ChainOpera AI定义的成功标准也并非用户数量或代币价格。公司表示,核心指标是非加密用户能多容易地通过此智能层进入加密货币、DeFi、预测市场等复杂的金融市场。
伴随此次产品发布,ChainOpera AI正通过新近成立的ChainOpera AI Foundation全面加速其生态系统扩展战略。该基金会正在推进一系列举措以构建中长期增长基础,包括设立专门用于支持下一代建设者和开发者的生态系统基金。
ChainOpera AI Foundation已承诺投入总计价值1.5亿美元的COAI代币以支持生态系统增长,其中计划在2026年前分阶段拨付占代币总供应量4%的4000万枚COAI。该资金将用于孵化和扩展面向金融科技及加密货币市场的自主AI代理,同时投入构建驱动、运营和扩展ChainOpera AI生态系统的核心AI基础设施。
有关ChainOpera AI Foundation的更多详情,可通过其官方网站 (https://chainopera.foundation) 查看。Toray Advanced Materials Commences Operation of Second PPS Line… Set to Reshape Domestic Plastic Market Landscape东丽尖端素材在全罗北道新万金产业园区内的群山工厂完成了年产5000吨规模的PPS(聚苯硫醚)新生产线,进一步巩固了在国内超级工程塑料市场的地位。
公司于2025年11月2日正式宣布了此次PPS"2号机"生产线的新建计划。PPS是一种具有卓越耐热性、耐化学性和电绝缘性能的高功能性塑料,作为替代传统金属材料的轻量化材料而备受瞩目。特别是在汽车零部件、电子电器设备、家电产品、工业设备、住宅设施等多种领域得到应用,需求正快速增长。
通过本次生产线扩建,东丽尖端素材将具备年总产能达1万3600吨的PPS生产能力。这达到了国内最大规模,使其能够应对国内外客户公司需求的增长,并提供针对多种用途的定制化解决方案。东丽尖端素材早在2016年就已构建全球首个涵盖从PPS原料到成品的连贯生产体系。
此次设备增建也与PPS树脂主要原料——硫化氢钠(NaSH)的国内产能扩大形成了联动。公司将硫化氢钠生产线扩建至年产4800吨规模,从而降低了进口依赖度,并提升了成本竞争力。通过实现原料内部化,公司在确保产品价格稳定和供应链稳定性方面占据了有利地位。
东丽尖端素材社长金英燮表示:"我们将基于积累的技术实力和供应能力,为相关产业的发展乃至地区经济活力做出贡献。"东丽尖端素材是首家在新万金地区投资的外资企业,此次扩大投资是旨在提升国内材料产业全球竞争力战略的一部分。
预计此次设备扩张将对在高功能性塑料需求激增的全球市场中提升韩国材料的地位产生积极影响。特别是在电动汽车、半导体、工业自动化领域PPS新需求增长的背景下,国内生产基础的扩大可以同时实现进口替代效应和扩大出口产业的双重效果。
 Superchain Interoperability:从碎片化跨链流动性到统一原生流动性层的未来在当前的区块链世界中,碎片化是一个重大挑战。各条链的独立性使得资产和数据的跨链转移变得复杂和低效,导致开发者和用户面临较高的成本和延迟。OP Superchain 在第 7 季的更新中,将“互操作性(Interoperability)”作为超级链产品愿景的核心支柱,旨在解决这一问题。
借助 Superchain 的互操作性,资产和数据能够轻松跨链转移。开发者可以充分利用整个超级链的资源,而链部署者则能够享受超级链所带来的庞大网络效应。这样一个统一且可扩展的生态系统,将会源源不断地创造新场景,推动区块链的创新与发展。
打破碎片化:Superchain 优势
以太坊及其 L2 生态系统的扩展面临着碎片化问题。在传统的区块链模式下,资产和数据往往需要通过以太坊 Layer 1 进行跨链转移,这一过程既昂贵又缓慢。与此同时,开发者需要在昂贵且复杂的多链基础设施上“冷启动”自己的项目,用户则面临着使用体验的碎片化和混乱。
然而,通过实现原生的链间互操作性,Superchain 打破了这一碎片化的局面,让资产和数据可以跨链流动,同时提高了开发者的资源使用效率。Mint Blockchain 作为 Superchain 的一员,正在积极推动这一创新,帮助用户享受到更加流畅和高效的跨链体验。
Superchain 如何工作?
OP Superchain 是由多个基于 OP Stack 构建的 Layer 2 网络整合为一个统一的多链网络结构。OP Superchain 提供了更强的可扩展性、低延迟和更高的交易吞吐量,各个链能够共享相同的安全模型和治理机制,实现低成本跨链通讯,资产互换等核心交互功能。
OP Interop 是基于 OP Stack 技术框架的链上互操作性功能,提供通过低延迟、安全的消息传递在超级链中跨链读取消息和转移资产的能力。Superchain 建立在互操作协议之上,并实现具有完整依赖关系的单一网状网络。Superchain Interop 包括协议层消息传递和 Superchain ERC20 代币标准。一旦 Superchain Interop 上线,将实现 2 秒跨链结算、最小化碎片化、统一流动性以及最大化资本效率和效用。
互操作性的通用标准
Superchain 的多链架构需要先进的技术能力,以确保平台内部的安全通信层。这一层将由消息传递协议、Superchain 代币标准、互操作性故障证明机制,以及一组互操作链组成。
消息传递协议 允许创建和发送跨链消息。完成跨链消息需要两个事件:源链上的发起交易和目标链上的执行交易。
SuperchainERC20 是 OP Stack 的通用代币标准 — — 它是 ERC20 标准的最小扩展版本,使得代币可以跨 Superchain 进行可替代和可移动。如果没有标准化的安全模型,桥接资产可能无法相互替代。SuperchainERC20 建立在消息传递协议之上,是当前信任最小化的桥接解决方案。
互操作性故障证明机制 是 Superchain 内各条链共享的证明系统。这一机制使链的安全性相互关联,从而支持整个 Superchain 生态中的可替代资产。
互操作链集合 包括配置了“依赖关系”的链 — — 即它们从其他链读取数据。例如,OP Mainnet 读取 Mode 和 Base 的数据,Mode 读取 Base 和 OP Mainnet 的数据,而 Base 读取 OP Mainnet 和 Mode 的数据。这三条链共同组成了一个互操作链集合。
Superchain 互操作性架构
OP Stack 节点的组成决定了其互操作性能力。其中,OP Supervisor 是互操作性服务的核心角色。
OP Supervisor 负责记录、验证跨链日志事件,并从 L1 共识层获取 L2 交易安全性信息。
通过 OP Supervisor,Superchain 的各个链可以同步并验证彼此的交易信息,从而实现高效的跨链消息传递。
Superchain 互操作性优势
Superchain 的互操作性提供了多个显著优势:
低延迟与高效性:通过优化的跨链通信机制,实现快速消息传递和资产转移,提升用户体验。
成本效益:采用高效的结算机制,减少跨链交互中的 Gas 成本,使交易更加经济
无缝的开发者体验:开发者可以利用 Superchain 的原生互操作性,轻松地在不同链上部署应用和资产,而不需要复杂的跨链桥接基础设施。
共享安全性:基于 L1 共享安全性和 OP Stack 设计,确保跨链交互的可靠性,降低不同链验证机制带来的风险。
SuperchainERC20:跨链代币的理想选择
SuperchainERC20 作为 Superchain 互操作性中至关重要的一部分,为跨链代币提供了一个简洁且可靠的解决方案。借助原生的 Interop 协议,资产可以在各个链之间进行快速、无缝的移动,推动了实时跨链 DeFi 和无缝链对链交换。
Mint Blockchain 的原生资产 $MINT 是首个作为 Superchain 的原生代币并应用了 superchainerc20标准。USDT0 则是首批部署在 Superchain 的互操作稳定币之一,是 USDT 的全链(omnichain)版本,已支持在多个链上原生兼容,并由以太坊上的 USDT 1:1 支持。已上线 OP Mainnet 和 Ink,并计划扩展至更多链,为 Superchain 提供快速、安全、低成本的跨链转移能力。
Mint Blockchain: 借力互操作性创新
作为 Superchain 的一员,Mint Blockchain 能够利用这一创新的互操作性机制,为用户提供更加高效和安全的跨链体验。Mint Blockchain 的资产和应用将能够无缝地与其他 Superchain 上的项目进行交互,用户将享受到低成本、高速且安全的跨链交易体验。
此外,Mint 正在构建一个聚合流动性产品 Mint Liquid,这是由 Mint 团队基于 Superchain、ERC7683、Uniswap、Across Protocol 等协议,构建的一个支持多链 NFT 和 Token 资产交易的流动性产品,实现多链流动性聚合和资产跨链互操作。Mint Liquid 产品将极大地提高链上加密资产的交易效率,降低链上交易摩擦成本,更好地为新加密资产提供价格发现的能力,促进链上交易市场的繁荣发展。
推动 Web3 的未来
Superchain 的互操作性不仅打破了跨链流动性的碎片化难题,还为 DeFi 和 Web3 生态系统提供了更高效、安全的基础设施。通过原生的互操作性协议,资产与数据能够自由流动,开发者可以更轻松地构建跨链应用,而用户则能享受更流畅的交易体验。作为 Superchain 生态的一部分,Mint Blockchain 正在积极推动这一变革,利用统一的流动性层提升链上交互的效率和可扩展性。随着 Superchain 互操作性的持续推进,Mint Blockchain 将与 Superchain 携手开创 Web3 的新未来,推动 Web3 和链上应用的创新与普及。Bitfinex presenta operaciones de tarifa cero para los que reaccionan a las ofertas en su plataforma P2P en Argentina, Colombia y VenezuelaROAD TOWN, Islas Vírgenes Británicas – 11 de octubre de 2023– Bitfinex (www.bitfinex.com/), una plataforma de comercio de activos digitales de última generación, anunció hoy que se complace en revelar que el comercio en el Peer-to de Bitfinex -La plataforma Peer (P2P) ahora es gratuita para los usuarios que ejecutan órdenes de compra o venta a precios de mercado, también conocidos como los que reaccionan a las ofertas.
Nuestro servicio de comercio P2P, que recientemente se hizo accesible a clientes en Argentina, Colombia y Venezuela, ahora ofrece a los que reaccionan a las ofertas la ventaja de liquidaciones inmediatas de cripto a cripto las 24 horas del día sin incurrir en ninguna tarifa.
Para comenzar a operar en la plataforma Bitfinex P2P, simplemente inicie sesión en su cuenta Bitfinex y haga clic en la opción P2P en el menú de navegación superior.
Para obtener más detalles sobre cómo comenzar a usar Bitfinex P2P, visite https://p2p.bitfinex.com.
Sobre Bitfinex
Fundada en 2012, Bitfinex es una plataforma de comercio de tokens digitales que ofrece servicios de última generación para comerciantes y proveedores de liquidez global. Además de un conjunto de funciones comerciales avanzadas y herramientas de gráficos, Bitfinex brinda acceso a financiamiento entre pares, un mercado OTC y comercio de margen para una amplia selección de tokens digitales. La estrategia de Bitfinex se centra en brindar soporte, herramientas e innovación incomparables para operadores experimentados y proveedores de liquidez de todo el mundo. Visite www.bitfinex.com para obtener más información.
Contacto de media para Bitfinex
press@bitfinex.com
Para logotipos y marcas oficiales, visite
https://www.bitfinex.com/press/#press-downloads
The post Bitfinex presenta operaciones de tarifa cero para los que reaccionan a las ofertas en su plataforma P2P en Argentina, Colombia y Venezuelaappeared first on Bitfinex blog.
作者:Kyle Jeong(Browserbase 增长工程师) 编译:Daniel 编辑:Cage 本文编译自 Browserbase 增长工程师 Kyle Jeong 对 Astra Computer Use 能力的分析,原文发布于他的个人博客。过去三年,他们团队一直在努力把 AI Computer Use 的能力用于实际业务。 文章拆解了 Astra 模型与 Codex Harness 的配合方式:Codex 启动一个持续运行的代码环境,接入浏览器和桌面操作工具;Astra 通过无障碍模式读取界面中的文字、按钮结构,并通过截图综合判断。模型把准备执行的操作写成代码,交给 Codex 的工具完成。 Astra 在训练过程中融入了大量专业环境和数据,并通过强化学习改进策略选择和纠错能力。模型能更准确地理解界面、选择动作,就能减少试错和反复检查,用更少的交互完成同一项任务。 这次发布让我们看到了新的模型能力跳变:Computer Use 能力让 Agent 覆盖更多白领工作的长尾场景。激发用户主动尝试把日常工作交给 Agent 去完成。 Astra 发布后,模型的 Aha Moment 出现在了许多过去需要专业人士才能开发操作的 visual coding 场景中。比如有人因为 Astra 而第一次接触 Blender,并做出了用于房产销售的 3D 模型。这类能快速看到成品的例子迅速在网络上铺开,激发了很多人尝试和分享的欲望。 Agent 的渗透,需要一次次的能力出圈把围观者转化为使用者。一眼看到自己熟悉的案例,往往比评测分数更有说服力。用户反馈中,有房产从业者看到别人的 visual coding 使用经验,会想到接入自己的房源。也有视频工作者看到别人运用 Astra 管理视频工作流,主动去尝试。这些例子让更多用户知道,原来这些事情都可以交给 Agent。这样的长尾场景拓展,会帮助 token consumption 和 agent 渗透率再上一个台阶。 / 01. AI Computer Use 简史 2024 年 10 月,Anthropic 随 Claude 3.5 Sonnet 一起推出了 Computer Use 能力。他们采用的是纯视觉路线,也就是说,模型通过截图来判断如何与电脑屏幕交互。模型以像素为基础进行后训练,并以 JSON 格式返回像素坐标和动作,例如: "action": {"type": "click","x": 156,"y": 50}随后,Stagehand 或 Playwright 等驱动工具会把这些输出转换为浏览器或电脑上的实际交互。 在 Claude 3.5 Sonnet 之后,其他实验室也开始发布类似的视觉 Computer Use 模型,训练模型识别屏幕上的像素。OpenAI 发布了 Operator 和 computer-use-preview;Google DeepMind 为 Gemini 2.5 Pro 加入了 Computer Use 能力。 但这些模型并不完美。由于后训练以像素为基础,实验室必须选定一个具体的视口尺寸,比如 1288 × 711,并在整个训练过程中保持不变。当在不同尺寸的窗口中使用这些模型时,它们就会失灵,开始点不中按钮。 另一个明显的局限是,这些模型简单地依赖纯视觉方式与应用交互,而应用中有一些更复杂的交互,是“只靠眼睛”看不到的。 围绕纯文本方案,以及 DOM(文档对象模型)与视觉相结合的混合 Agent,已经出现了大量实验。Standard Intelligence 的 FDM-1 就是一个很有意思的 Computer Use 实验:它为 Computer Use 编码的是视频,而不是静态截图。 FDM-1 是 AI 公司 Standard Intelligence 开发的 Computer Use 模型,特点是通过连续的屏幕录像,学习人怎么操作电脑。 02. Astra 有什么不同? 要理解 Astra 为什么不同,我们得先回到 5.6 模型家族,聊聊 Codex/ChatGPT 的 harness。Computer Use 既是 harness 的工程问题,也是模型的研究问题:模型决定做什么,harness 负责执行。要把 Computer Use 做好,这两个问题都需要解决。 Computer Use 流行了很久,但它尚未证明自己已经足以用于生产环境,主要原因是不可靠。当 OpenAI 在 Codex 应用中推出 Computer Use 能力后,许多开发者开始每天使用它,也逐渐理解了这项能力有多强大。 Codex 会打开内置或本地的浏览器去完成制定的任务。任务可以在后台执行,用户可以继续使用浏览器处理其他事情。 Codex 中的 Computer Use 比 Atlas 更快更准,还能通过编写和执行代码完成如制作图表、调用其他工具等事情。 Astra 在 5.6 已有能力的基础上,进一步提升了速度、降低了成本。 要理解这是怎么做到的,可以从研究电脑界面的组织方式开始。今天,大多数电脑都提供了你我能够看到的图形用户界面(GUI)。我们看着屏幕上的像素,决定点击哪里,这与早期模型的做法类似。 而如今推动模型进步的是一个原为视障人士推出的功能:为了帮助视力或听力受损的人,Chrome 中的每个网站都提供了“无障碍模式”。它会把屏幕上的内容映射成一棵无障碍树(Accessibility Tree,也称 a11y tree)。这就要求应用暴露用户界面元素的语义信息,让这些元素能够被操作。 浏览器中的无障碍树大致是这样的: 模型读起来会容易得多,因为它去掉了所有用于定义视觉呈现层的代码;对于网页来说,主要就是 CSS 和类名。 无障碍树使用的 token 比截图更少,却能提供同样丰富、甚至更好的屏幕上下文。Astra 利用这棵树来发出 Computer Use 指令,比如点击、输入和按键。Chrome 中的每个网站都会自动生成一棵无障碍树,这意味着它们开箱即用地兼容 Astra。 03. 架构 Astra 的架构相当简单: 当 Computer Use 会话开始时,Codex 会启动一个 Node REPL 来保存会话状态,并提供浏览器操作或原生 Computer Use 的接口。Agent 会根据任务选择使用哪一套接口。 无论面对原生应用还是浏览器,Agent 都会通过文本、截图,或两者结合的方式观察页面,尽可能准确地掌握当前状态。随后,它通过代码决定执行什么操作。如今的 Computer Use 实际上就是代码模式。OpenAI 的 API 文档甚至建议,所有 Computer Use 都使用代码执行。 一个输出示例如下: {"type": "function_call","name": "exec_js","call_id": "call_123","arguments": "{\"code\":\"await page.getByRole('searchbox').fill('browser automation'); ...\"}"}本地服务(名为 CodexComputerUseIPC-5)负责执行操作。执行封装层会把所选元素转换为原生元素 ID(如果模型选择使用坐标,也可以转换为坐标),随后通过原生管道传输 JSON-RPC 消息,并借助请求 ID 匹配请求、完成执行。 在实际使用中,OpenAI 推荐分别使用 Playwright 和 PyAutoGUI 作为控制浏览器与电脑的框架。 Playwright:微软开发的开源浏览器自动化工具。 PyAutoGUI:程序员 Al Sweigart 创建的开源鼠标、键盘自动化工具。 接着,Astra 会检查自己的操作结果,因为请求成功送达并不意味着操作真的生效了。模型会请求再观察一次,将当前状态与预期状态进行比对。 这个循环会一直持续,直到任务完成。由于 Computer Use 天然需要保留状态,Node REPL 必须在整个会话期间持续运行。 Node REPL:代表一个持续开启的代码工作台,目的是保留前面创建的变量、页面对象和中间数据,让下一步操作接着上一步继续,不必每次重新准备环境。 在上面的表格中,Astra 是唯一一个要求自动审查的模型。Astra 使用了一套 Guardian 策略,在允许执行之前,对计划的 Computer Use 进行安全审查。 Guardian 使用 GPT 5.6 Luna 作为后台分类器,评估当前工作流程和接下来可能出现的风险,再返回高风险或低风险的分类结果。如果被判为高风险,后续操作就会触发审查。随后,操作会交给一个安全审查模块,由它对拟议操作进行完整评估。 { "risk_level": "high", "user_authorization": "low", "outcome": "deny", "rationale": "..."}安全审查会参考多方面的信息:AI 准备执行的操作及其参数、对话记录中的相关依据(包括用户授权)、主任务的运行环境与权限设置、代码执行环境(REPL)中已有的记录和图像,以及审批请求和申请理由。审查器在不拿到完整的无障碍树的情况下即可完成。 常见的 Guardian 拦截包括: •授予权限:是否针对所授予的权限及接收方获得了明确授权。 •登录及会产生重要后果的账户操作:用户是否明确授权了这些操作。 •提交敏感数据:是否同时获得了针对数据本身和提交目的地的许可。 •会产生重要后果的点击:界面的实际状态及点击的影响;表单输入或设置是否有误;它们是否符合用户的指示。 •绕过限制:替代路径是否获得了授权。 •破坏性操作:是否会造成实质性的状态丢失或不可逆的损害。 •超出范围的私密数据访问:访问是否属于已获授权的任务范围。 在 alignment benchmark 中,Astra 的表现显著好于前代模型。 04. 速度的代表 相比 GPT 5.6,Astra 多了一道审查,但速度反而更快。归功于更聪明的模型,需要的交互轮次更少。 Astra 使用了 10 万张 GB300 进行训练,消耗的算力可谓巨大。但这个模型也聪明得多,而且在 Computer Use 环境中接受了大量 RL 训练。更聪明 → 完成任务需要的轮次更少 → 任务完成得更快。在这种情况下,推理速度并不是影响 Computer Use 能力的决定性因素;当生成速度超过每秒 300 个 token(TPS)时,动作的执行速度就会成为瓶颈。 执行框架也做了一些优化,例如 WebSocket 预热、连接复用,以及使用 previous_response_id 的增量请求。不过,这些都不对应动作本身的速度,只关系到工具的启动时间。 05. 目前的缺点 Astra 确实很惊艳,但还能发现有一些缺点。Astra 可能在观察环节出错,拿到不完整的无障碍树状态、细节不足的截图,或者已经过时的画面。在观察与执行动作之间,界面状态也可能发生变化。有些应用中的无障碍树会频繁改变,导致操作失效。 长时间跨度的 Computer Use,仍然是一个尚未得到充分解决的问题。由于上下文压缩做得很好,Astra 可以长时间运行,并保持较高的执行质量;但当 Computer Use 连续运行数天,甚至数周时,表现究竟如何,目前还没有看到。 06. Computer Use 的前沿 Computer Use 才刚刚开始变得好用。我们见证了它从连琐碎任务都频频失败,进步到在《我的世界》中比一个十岁孩子更快挖到钻石。人们终于开始意识到,可以把多少工作交给 AI。 当模型从视觉与截图转向使用无障碍树之后,它们的表现就好了很多。未来更多的算力也意味着更好的模型和更低的价格;随着我们继续推动后训练的边界,模型也会在实验室选择训练的特定领域任务上持续进步。 Astra 将速度和准确性,与强有力的安全防护结合起来,确保 Agent 不会被劫持。Computer Use 模型每迭代一代,我们就离能够用于生产环境的 Computer Use 能力更近一步。 软件的未来,是由 AI 代表人类完成工作,让人类专注于那些需要头脑的问题。
