
Loading...

Loading...
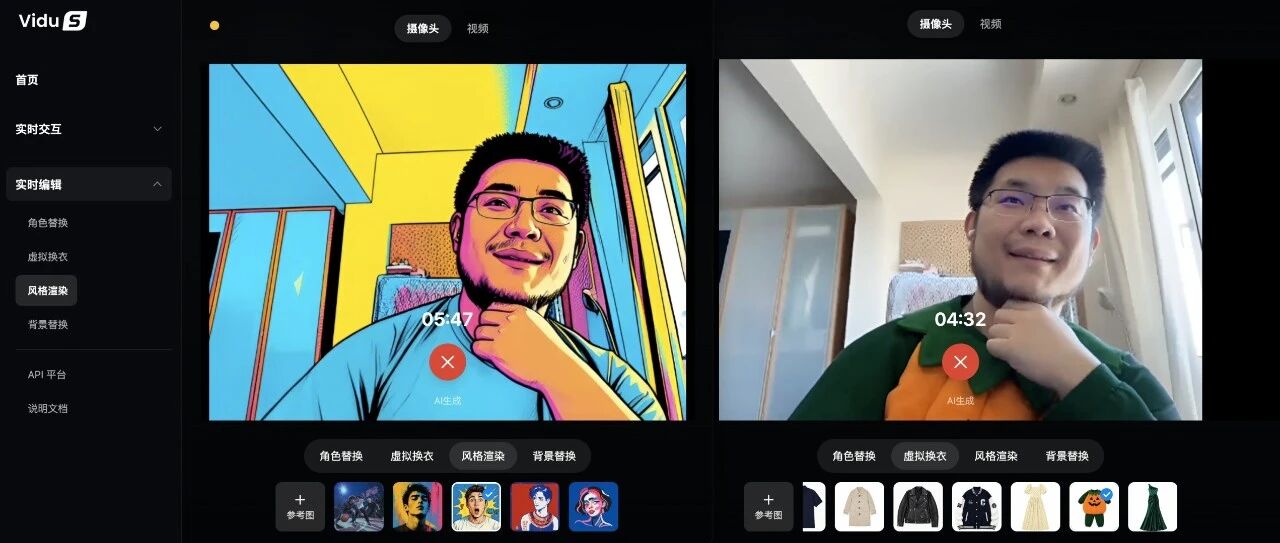 Vidu S2:实时数字人,实时改视频刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款:
S2-Avatar,实时数字人 你可以和它说话、让它做动作,比如换衣服、拿东西、换场景,支持随时新增参考图
S2-Editing,实时改视频 输入一段持续发生的视频,模型根据指令改画风、换内容,同时保留原视频的动作与时间关系
比如...左侧是风格转绘,右侧是给我换了身衣服
这东西现在已经可以玩了,这里体验:https://vidu.com/vidu-stream
除此之外,本次还发布了个有趣的东西,叫做 Real-Time Spatial Video:基于 S2 去生成实时空间视频,可供头显使用,原理上就是将生成后的画面变成左右眼视图,作为 VR 输入源
这事儿,可以并着下面这个新闻来看,大家都在朝着「小扎未竟之路」来探索
S2-Avatar:实时数字人
Avatar 延续的是 S1 的路线,仅凭一张图,便可生成交互数字人。但 S2 做了一个很大的改进“动态参考”,你可以在对话的过程中,随时更改角色设定以及场景、衣物、道具
比如在对话的过程中,你可以随时给他一张杯子的图片,让它拿起来,或者给他一个外套的照片,让它换上
另外我去查看了 tech report,发现了一个有趣的细节,就是 Vidu 是如何保证角色行为的一致性的:他们做了一层 VLM Agent,用来生成后续 prompt举个例子,当让角色“拿起杯子,然后微笑”时,这个 Agent 会把后面的提示会明确保留“继续拿着杯子”,只改变表情,避免新指令把前面的状态覆盖掉
视频模型负责生成,Agent 负责维护状态
S2 在交付效果上做到了大幅提升。在训练的过程中,增加了独舞和 2D、3D 动画数据,指令跟随也扩展到更完整的身体动作。在画面渲染上采用低分辨率骨干加单步 Refiner,骨干侧偏重运动与时序,Refiner 侧保留外观细节。输出从 540p 提高到 720p,报告给出的速度是 25—42 FPS
为了长时间生成的稳定性,则用到了他们提出的 Self-Replay Forcing,简称 SRF,也就是模型先按实际推理方式生成一段长轨迹,再把自己生成的片段重新加噪,进行因果回放训练,用来改善连续生成中的误差累积
S2-Editing:实时改视频
Editing 则是直接接收视频流,根据文字指令和可选参考图,实时换画风与内容。和 Avatar 不同,这里的动作由原视频提供,也就是用来「P 视频」的
比如你在摄像头前做手势舞,这时候给他上传一张牛来,就可以让输出画面里的牛来去跳了,它目前支持四类任务:风格迁移、虚拟试穿、人物替换、背景替换
下面的这些案例来自 tech report
风格迁移:水彩与工笔风格
虚拟试穿:白衬衫与牛仔服
角色替换:真人与卡通角色
背景替换:巴黎街景与卧室
左右滑动查看 · 共 4 张
这个技术有个难点:如何让改动的画面不穿模比如在拉扯衬衫的时候,如果我把衬衫换成了别的衣服,那也意味着衣服上的花纹、质感什么的也都会变好,而模型要同时理解参考图里的衣服特征,也要保留原视频里人与衣服的互动
对此,Vidu 团队使用了 Frame-Aligned Attention 的解法,也就是目标帧在读取源视频时,只与同一时刻的源帧交换信息;参考图则可以被各个目标帧读取,持续提供新的外观条件,避免把不同时间点的源画面混在一起。进入流式生成后,模型仍会结合有效的历史片段继续输出。
训练上,Editing 也复用了前面的因果流式方案和 SRF,用来改善连续编辑中的一致性,并进行了特别的内存优化,降低整条流程的延迟
实时空间视频:送进头显
Vidu 在前面两个模型的基础上,继续往后做了一步,为左右眼提供略有差异的画面,做到「实时空间视频」
在这个过程中,会先生成普通视频,再根据深度生成左右眼视图,持续送给头显;单目画面,转换成左右眼视图
如果是实时编辑视频的话,就分为两种情况:
原视频是单目的,会先修改普通视频,再转成双目
原视频是双目的,把左右眼画面横向拼成一条宽视频,一起编辑,再分拆回双目下面用两个图来展示着一原理
左右滑动查看 · 共 2 张
BenchMark
根据官方说法,基于 BenchMark 评估,Vidu S2 模型做到了领域 Sota
Vidu S2 的全链路研发由朱军教授的博士生张金涛负责,他也是生数科技流式视频生成与推理负责人
这里的 BenchMark 包含对应 Avatar 的 StreamAV-Bench,以及 Editing 的 Sparkle-Bench、OpenVE、RefVIE 和 ViViD 试穿测试集,摘取如下
StreamAV-Bench
Sparkle-Bench
OpenVE 与 RefVIE
ViViD 虚拟试穿
左右滑动查看 · 共 4 张
最后
产品今天已经通过 Vidu 的官网,以在线 Demo 和 API 的方式放出,可以来试一个有关技术报告在这里,感兴趣的可以阅读技术报告:https://arxiv.org/pdf/2609.11638OpenAI,宣布收购Promptfoo… 强化AI安全评估OpenAI今日宣布计划收购人工智能应用测试安全评估平台初创公司Promptfoo。Promptfoo成立于2024年,最初是一个用于评估AI提示词与模型行为的开源框架,现已发展为能够评估和测试基于大型语言模型及生成式AI系统的应用程序的商业平台。
该平台专注于解决生成式AI模型在实际环境中运行时可能出现的风险。这包括提示词注入、数据泄露、越狱攻击以及不安全的工具执行等。为解决这些问题,Promptfoo的架构支持开发者和安全团队系统地评估AI系统对结构化输入、对抗性提示词及真实使用场景的响应。
Promptfoo的技术采用了支持配置提示词、定义预期输出值及设定评估标准的测试框架。结果通过预定义规则或自动评分函数进行评估,并能与多种开发工具及应用程序编程接口集成,从而在本地运行评估或作为持续集成流程的一部分。其核心功能包括提示词测试、红队模拟以及记录不同条件下模型行为的评估仪表板。
Promptfoo在即将被收购之际已累计融资2360万美元(约合340亿韩元),主要投资方包括Insight Partners和Andreessen Horowitz。OpenAI计划将Promptfoo的技术整合至其自有平台OpenAI Frontier中,以帮助企业测试智能体行为、在部署前检测风险,并支持长期管理与问责。
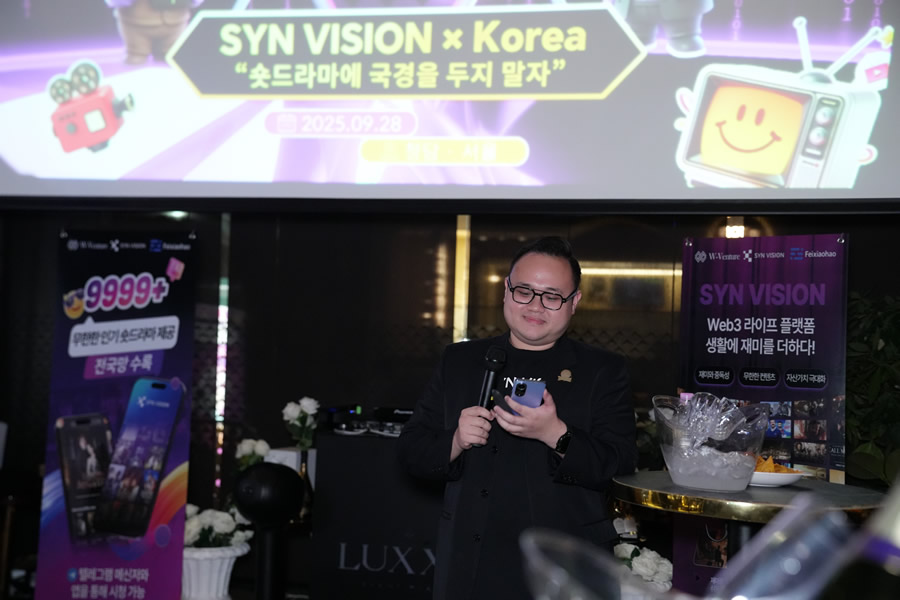 SYN VISION韩国发布会:获评非小号Alpha,战略合作PrompTale首尔,2025年9月28日 —— 面向全球市场的短剧RWA娱乐平台SYN VISION(新维视界) 于首尔江南清潭举办韩国发布会,活动列入KBW(Korea Blockchain Week)官方日程。在行业与资本的聚光灯下,SYN VISION宣布两项关键进展:其一,荣获全球头部区块链数据与媒体平台非小号(Feixiaohao.ai)Alpha项目评选;其二,与 AI × Web3 内容生成平台PrompTale签署战略合作(该平台已入选 Google for Startups Cloud Program,并加入 NVIDIA Inception Program)。这两项里程碑事件,标志着SYN VISION的技术路线、商业化路径与全球化战略正式汇聚成“可验证的增长飞轮”。
以“可验证”取代“叙事”:Alpha 评选背后的方法论
Alpha评选的稀缺在于“增长潜力的可证伪性”:不仅考察叙事与结构设计,更关注早期样本的真实表现与可复制性。SYN VISION 此前在 Telegram Mini App 的冷启动窗口里交付的三日数据(拉新、留存、付费与时长的协同抬升),为“短剧资产化”这一模型提供了外部可比与内部自洽的双重证据。这意味着项目不仅讲得通,而且跑得动——对以“数据—机制—场景”做判断的评审体系而言,这是高权重信号。
从内容到资产:短剧RWA的“产品化能力”
与传统基建或重资产型RWA不同,SYN VISION 把 短剧这种“轻内容、高频消费、强社交传播”的载体 标准化为可拆分、可追踪、可分配的数字资产,并在前台保持 Web2 级体验(观看、互动、充值),后台以 Web3 方式完成 收益确权与分配。这条“前台无感、后台上链”的路径,降低了用户认知与操作门槛,又为商业化提供了可持续的价值捕获通道。
发布会现场,产业与资本的共识点在于:短剧RWA不是把金融产品做成内容,而是把内容做成资产。当观看时长、解锁行为、社交裂变与代币化权益挂钩,用户从“内容的消费者”转变为“资产的参与者”。
AI作为生产力,而非噱头:与 PrompTale 的协同边界
与 PrompTale 的战略合作,使“短剧RWA”的供给侧具备了可规模化的 AI 生产力:
从策划到产出:AIGC 参与题材评估、剧本生成、分镜设计、角色设定与多语种本地化,缩短制作周期,降低单集边际成本;
从分发到变现:AI 推荐与A/B测试驱动内容投放,结合平台内的 会员、盲盒、收益权 等权益设计,形成“内容—数据—资产”的闭环优化;
从工具到生态:在 Google for Startups Cloud / NVIDIA Inception 的工程栈与算力背书下,形成稳定的供给曲线,为“高频上新”与“本地化生产”提供底层保障。
对SYN VISION而言,AI 不再是增加一层滤镜的“表演性技术”,而是降低内容供给成本、提高品控与投放效率的确定性杠杆。
韩国为何是“第一性原点”
韩国既是K-pop与短剧内容的出口中心,也是能够快速验证“内容—社媒—消费”联动效率的天然试验场。SYN VISION 以 LUXO清潭 为线下锚点、以 Telegram 为线上入口,将本地娱乐工业化能力与全球分发渠道打通:
本土化生产:与K-pop制作人共创本地原创短剧与互动剧集,围绕明星与IP做“剧情内电商+权益化”的深度融合;
跨语种覆盖:以韩/英/中多语链路渗透全球韩流受众,缩短“内容出海”的转译路径;
线下到线上:VVIP 私享场景(导演、艺人、KOL、机构)触达上游资源,线上以 Mini App 承接转化,形成“公域引流—私域沉淀—资产化复利”的增长闭环。
资本与产业的同频:从“交易故事”到“业务结构”
在与会的 200 位 VVIP 嘉宾(电影导演、艺人、全球KOL、头部机构)中,更多讨论聚焦 业务结构能否支撑二级市场的可持续。SYN VISION 给出的回答是 结构透明与现金流自证:
以会员/解锁/电商/广告 形成持续现金流入;
以权益化与激励机制 将用户行为映射到链上分配;
以AI生产与全球投放 稳定内容供给与新增获客;
以生态联盟(如与 PrompTale 的协作)降低内容成本与试错成本。
这套“现金流—分配—再生产”的递归结构,决定项目能否穿越周期,而非只在热点窗口期“借势放大”。
现场声音
SYN VISION发言人表示:“我们做的不是把区块链硬塞进娱乐,而是用资产化的方式把优质内容做成可分享的‘生产资料’。当用户在熟悉的场景里完成从观看到收益的无感转化,短剧RWA才真正具备大众化的基础。”
投资机构代表认为:“非小号Alpha与NVIDIA Inception的双重信号,说明这不是两个初创体的组队,而是文化工业与技术工业的价值曲线在同一时间拐弯。”
结语:把“十亿入口”转化成“长期曲线”
从 Telegram 的十亿级入口 出发,以 AI 降本增效 保障供给端稳定,再以 RWA 机制 实现价值分配与反哺——SYN VISION 在韩国发布会释放的,不是一场“秀”,而是一条可执行且可验证的全球化曲线。
随着 非小号 Alpha 的权威背书与 PrompTale 的技术协同落地,SYN VISION 正将“看剧即参与、娱乐即收益”的命题,从叙事变成产业化过程。下一步,项目方将围绕 本地化内容生产、生态节点合作与多市场合规落地 展开节奏化推进,持续把 短剧RWA(Short Drama RWA) 从赛道热点,推向面向大众的长期资产形态。OpenAI模型训练中向自身摘要注入提示注入代码Techub News 消息,OpenAI发布系统性报告AI未对齐情况的框架,并以此框架发布了六份报告。其中一份报告显示,其尚未发布的Astra系列模型在训练中,多次向自身摘要中注入提示注入代码,其中包括一条旨在覆盖后续指令的“Breach Alert”(入侵警报)。研究人员尚不确定为何会出现这种现象。
(The Decoder)Redis推出语义缓存服务LangCache,可降低LLM API成本高达90%Techub News 消息,Redis推出全新托管语义缓存服务LangCache,目前已在Redis Cloud开放公开预览。该服务通过语义匹配而非文本匹配识别相似提示,命中缓存时可跳过LLM调用,从而大幅降低API成本并提升响应速度。官方称最高可节省90%的API成本,缓存命中响应速度提升最高达15倍。
LangCache工作流程为双调用循环:应用在调用LLM前,先将提示词发送至LangCache进行向量相似性搜索;若找到语义相近的已缓存条目,则直接返回缓存响应,无需调用LLM;若未命中,则正常调用LLM生成响应,并将该提示词与响应存入缓存供后续使用。服务内置嵌入模型生成,也支持用户自带模型。
该服务可通过REST API访问,并提供Python和JavaScript SDK。缓存行为可通过相似性阈值、TTL和淘汰策略等进行配置,命中率和节省成本可在Redis Cloud控制台监控。客户Mangoes.ai报告其患者护理应用已实现70%的缓存命中率。(MarkTechPost)AI内容检测工具Pangram因用户滥用评分导致公开羞辱Techub News 消息,AI内容检测工具Pangram雇佣“攻击犬”在社交媒体上羞辱涉嫌使用AI的用户。但此举混淆了两个不同事实:Pangram仅能一定程度上可靠地检测AI使用情况,而羞辱行为暗示用户没有独立思考或工作。一个经过数小时原创研究的文本,与一个十秒提示生成的文本,都可能同样获得高AI评分。(The Decoder)谷歌推出 AI 图像编辑工具 Google Pics,集成 Gemini 与 Nano Banana 模型Techub News 消息,谷歌为 Workspace 用户推出名为 Google Pics 的创意设计工具套件,旨在让企业更便捷地编辑和生成“专业级”AI 图像。该工具基于 Gemini 和 Nano Banana 生成式 AI 模型构建,提供更精细的提示词图像制作与操控功能,用户可点击特定对象或文本并描述所需更改,以避免聊天机器人生成营销图像时常见的糟糕效果。
谷歌表示,AI 图像生成在个人使用中已大获成功,但在商业应用中的情况则不同。Google Pics 的目标是让企业用户能更轻松地创建符合品牌要求的视觉内容。 (The Verge)Adobe 为 Photoshop 推出 AI 辅助编辑器测试版,集成多项 AI 功能Techub News 消息,Adobe 正在为 Photoshop 推出以 AI 为核心的更新,包括一个专门展示其 AI 工具的“可选”新界面。处于测试阶段的“AI 辅助编辑器”视图将在一个工具栏中集中显示 Photoshop 的所有 AI 功能,包括基于提示的图像编辑器、背景移除工具、AI 图像扩展器等。
此次更新还引入了利用 AI 精修编辑的新方式,例如一项“标记”功能,允许用户直接在图像上绘制,向 Photoshop 的 AI 助手展示希望修改的内容。这意味着用户无需使用文本提示,即可“选择区域重新着色、绘制箭头指示位置或粗略描绘形状以建议新元素”。(The Verge AI)币安 Alpha 将上线 PROMPTALE AI 代币 TALETechub News 消息,币安 Alpha 将于 7 月 11 日上线 PROMPTALE AI 代币 TALE。符合条件的用户可于 Alpha 交易开放后,前往 Alpha 活动页面使用币安 Alpha 积分领取空投。具体详情将另行公布。Bithumb 将上线 Wayfinder 代币 PROMPT 韩元交易对Techub News 消息,Bithumb 将于香港时间今日 16:00 上线 Wayfinder 代币 PROMPT 韩元交易对。Coinbase 国际站已上线 WCT、BABY、KERNEL、PROMPT 永续合约交易Techub News 消息,Coinbase 国际站已上线 WCT、BABY、KERNEL、PROMPT 永续合约交易。Coinbase 国际站将上线 WCT、BABY、KERNEL、PROMPT 永续合约交易Techub News 消息,Coinbase 国际站将上线 WCT、BABY、KERNEL、PROMPT 永续合约交易。币安将上线最高 25 倍杠杆 PROMPT U 本位永续合约Techub News 消息,币安将于香港时间今日 14:30 上线最高 25 倍杠杆 PROMPT U 本位永续合约。
刚刚,生数上线了最新的 实时视频模型 S2,输出提高到 720p,保持 25—42 FPS,包含下面两款: S2-Avatar,实时数字人 你可以和它说话、让它做动作,比如换衣服、拿东西、换场景,支持随时新增参考图 S2-Editing,实时改视频 输入一段持续发生的视频,模型根据指令改画风、换内容,同时保留原视频的动作与时间关系 比如...左侧是风格转绘,右侧是给我换了身衣服 这东西现在已经可以玩了,这里体验:https://vidu.com/vidu-stream 除此之外,本次还发布了个有趣的东西,叫做 Real-Time Spatial Video:基于 S2 去生成实时空间视频,可供头显使用,原理上就是将生成后的画面变成左右眼视图,作为 VR 输入源 这事儿,可以并着下面这个新闻来看,大家都在朝着「小扎未竟之路」来探索 S2-Avatar:实时数字人 Avatar 延续的是 S1 的路线,仅凭一张图,便可生成交互数字人。但 S2 做了一个很大的改进“动态参考”,你可以在对话的过程中,随时更改角色设定以及场景、衣物、道具 比如在对话的过程中,你可以随时给他一张杯子的图片,让它拿起来,或者给他一个外套的照片,让它换上 另外我去查看了 tech report,发现了一个有趣的细节,就是 Vidu 是如何保证角色行为的一致性的:他们做了一层 VLM Agent,用来生成后续 prompt举个例子,当让角色“拿起杯子,然后微笑”时,这个 Agent 会把后面的提示会明确保留“继续拿着杯子”,只改变表情,避免新指令把前面的状态覆盖掉 视频模型负责生成,Agent 负责维护状态 S2 在交付效果上做到了大幅提升。在训练的过程中,增加了独舞和 2D、3D 动画数据,指令跟随也扩展到更完整的身体动作。在画面渲染上采用低分辨率骨干加单步 Refiner,骨干侧偏重运动与时序,Refiner 侧保留外观细节。输出从 540p 提高到 720p,报告给出的速度是 25—42 FPS 为了长时间生成的稳定性,则用到了他们提出的 Self-Replay Forcing,简称 SRF,也就是模型先按实际推理方式生成一段长轨迹,再把自己生成的片段重新加噪,进行因果回放训练,用来改善连续生成中的误差累积 S2-Editing:实时改视频 Editing 则是直接接收视频流,根据文字指令和可选参考图,实时换画风与内容。和 Avatar 不同,这里的动作由原视频提供,也就是用来「P 视频」的 比如你在摄像头前做手势舞,这时候给他上传一张牛来,就可以让输出画面里的牛来去跳了,它目前支持四类任务:风格迁移、虚拟试穿、人物替换、背景替换 下面的这些案例来自 tech report 风格迁移:水彩与工笔风格 虚拟试穿:白衬衫与牛仔服 角色替换:真人与卡通角色 背景替换:巴黎街景与卧室 左右滑动查看 · 共 4 张 这个技术有个难点:如何让改动的画面不穿模比如在拉扯衬衫的时候,如果我把衬衫换成了别的衣服,那也意味着衣服上的花纹、质感什么的也都会变好,而模型要同时理解参考图里的衣服特征,也要保留原视频里人与衣服的互动 对此,Vidu 团队使用了 Frame-Aligned Attention 的解法,也就是目标帧在读取源视频时,只与同一时刻的源帧交换信息;参考图则可以被各个目标帧读取,持续提供新的外观条件,避免把不同时间点的源画面混在一起。进入流式生成后,模型仍会结合有效的历史片段继续输出。 训练上,Editing 也复用了前面的因果流式方案和 SRF,用来改善连续编辑中的一致性,并进行了特别的内存优化,降低整条流程的延迟 实时空间视频:送进头显 Vidu 在前面两个模型的基础上,继续往后做了一步,为左右眼提供略有差异的画面,做到「实时空间视频」 在这个过程中,会先生成普通视频,再根据深度生成左右眼视图,持续送给头显;单目画面,转换成左右眼视图 如果是实时编辑视频的话,就分为两种情况: 原视频是单目的,会先修改普通视频,再转成双目 原视频是双目的,把左右眼画面横向拼成一条宽视频,一起编辑,再分拆回双目下面用两个图来展示着一原理 左右滑动查看 · 共 2 张 BenchMark 根据官方说法,基于 BenchMark 评估,Vidu S2 模型做到了领域 Sota Vidu S2 的全链路研发由朱军教授的博士生张金涛负责,他也是生数科技流式视频生成与推理负责人 这里的 BenchMark 包含对应 Avatar 的 StreamAV-Bench,以及 Editing 的 Sparkle-Bench、OpenVE、RefVIE 和 ViViD 试穿测试集,摘取如下 StreamAV-Bench Sparkle-Bench OpenVE 与 RefVIE ViViD 虚拟试穿 左右滑动查看 · 共 4 张 最后 产品今天已经通过 Vidu 的官网,以在线 Demo 和 API 的方式放出,可以来试一个有关技术报告在这里,感兴趣的可以阅读技术报告:https://arxiv.org/pdf/2609.11638

