
Loading...

Loading...
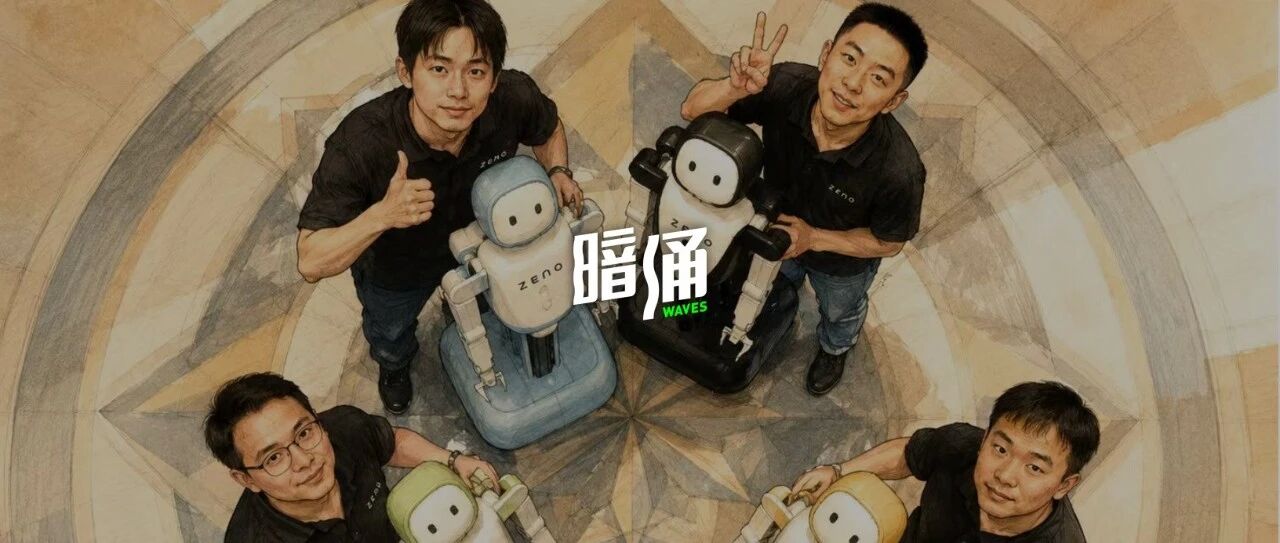 独家|数亿元种子轮背后:光学、GPU龙头押注机器人“团队作战”「单机能力不应该是基础模型的终点。」
文|王诗涵
编辑|巴芮
当下,机器人基础模型的竞争几乎都围绕“单机智能”展开:让一台机器人独立完成更难、更长、更陌生的任务。行业基准线正不断抬高,每向前一步,所需数据、算力和工程成本随之攀升。但天花板还在那。
具身智能初创公司芝诺机器人决定把这道题横向展开,提出另一种解法:多机协作。
当单机遇到瓶颈,难以覆盖一整套工作流,多机可以成为新的选择。
以家庭场景为例,面对一系列复杂任务,两台标准化机器人可能先分头行动,各自清理猫爬架、铲猫砂;在任务需要时又会合,互相协助,比如把叠好的被褥放进压缩袋并抽空空气。
芝诺机器人将这种能力称为“协作物理智能”(Collaborative Physical Intelligence)。
他们训练了一个3B参数的基础模型Zeno-1,可以适配多机器人协作场景,每台自研的机器人Malo都会独立运行这一模型。据称,该模型具备跨场景、跨任务、跨本体的能力。
架构上,他们采用“去中心化(decentralized)”策略:机器人不依赖中央控制器统一规划动作,彼此之间没有显式信息传递,不需要访问伙伴的内部状态或动作计划,而是根据视觉画面、本体状态和交互历史作出决策。
通俗点说,它们需要自己学会“看队友眼色行事”。
「暗涌Waves」独家获悉,芝诺机器人于近期完成总额数亿元人民币的种子轮融资,投资方包括全球光学龙头舜宇光学、国产GPU龙头沐曦股份、浙大系基金网新集团、工业AI龙头赛意产业基金等产业资本与和利资本等一线投资机构。
芝诺机器人于2025年11月正式展业,总部位于杭州,在悉尼和匹兹堡设有研发中心。多名核心成员拥有卡内基梅隆大学机器人研究院(CMU RI)背景。联合创始人、首席科学家植伟铭现任悉尼大学计算机学院终身教职轨道助理教授,LOAM作者张楫担任首席机器人架构师。
今年,多机器人协作有多项研究进展。6月,植伟铭团队发布了SAI(已收录在CoRL 2026),提出面向机器人协作的顺序非对称模仿学习方法。同月,斯坦福大学Jeannette Bohg和Chelsea Finn团队发布相关论文预印本,提出基于VLA的分布式多机器人协作框架。
在“协作”这条路线上,芝诺机器人表现出很强的自信。今年5月,Figure AI曾展示两台搭载Helix 02模型的人形机器人协作整理卧室、铺床的视频。植伟铭说,从公开展示看,Zeno-1覆盖了更丰富的高难度协同操作,协作表现超过了Figure AI。
这种表达带着一家年轻公司的自信,也将它置于更严格的检验之下。
以下是「暗涌Waves」与植伟铭的对话,经编辑。
Part01
必经之路
「暗涌Waves」:为什么要做多机“协作”?这是个真需求吗?
植伟铭:人类社会本来就是一个群体协作的社会,机器人也一定是群体协作的。未来,如果要扩展系统、增加机器人,机器人理应要有协作能力,这是一条必经之路。
过去几年,单台机器人在数据学习、灵巧操作等方面已经有了一条baseline,掌握了识别环境、理解指令、抓取、移动和使用工具等能力。
但两个分别会抓、会搬、会操作的机器人放在一起,仍可能因为时序和接触不匹配而失败。单机能力不应该是基础模型的终点。
相关研究群体很早就开始研究多机器人系统。例如,Amazon已经在仓库中部署了大规模机器人车队。这些系统主要采用传统的调度与规划方法,能让大量移动平台并行完成搬运任务,这已经验证了多机器人并行作业在这类场景中的可行性。
但是,目前覆盖的任务大多集中在移动和物流环节,对于需要复杂物理接触的灵巧操作支持有限。
现在,随着单机能力提升,也到了可以为协作铺路的阶段。机器人可以通过协同,做一些高难度的灵巧操作。
「暗涌Waves」:有哪些场景是需要多机协作的?
植伟铭:真正有价值的场景通常具备多个作用点、多个工作空间或者并行操作。例如处理大面积柔性材料、大型物体搬运、共同装配和物品交接。
比如在酒店或家庭里做布草时,被单横截面积很大,单台机器人很难用两只手完成。还有挂裤子,现在大家看到的更多操作是叠裤子,但没有去挂的,这需要一台机器人固定衣架,另外一台机器人把裤子穿过去,再挂起来。
「暗涌Waves」:这些算是高价值场景吗?能让客户愿意多买一台机器人吗?
植伟铭:我们的核心目标不是要卖多台机器人。客户可以先购买一个机器人完成部分工作,如果完成不了一整套工作流,可以根据实际使用情况,增加机器人数量。
多机协同是一个选择,在以前,大家没有这个选择。
至于要不要增加,最后测算的是ROI,本质是客户的选择问题。
「暗涌Waves」:增加一台机器人的效率增量,能覆盖成本吗?
植伟铭:这是一个边际收益问题。
单台机器人接近能力上限后,如果继续挤压它的最后一点性能,投入的成本可能会越来越高。用多台标准化机器人协作,可以把它想象成一个能够选择增加或减少机器人的系统,会提升这套系统的整体能力。这种系统扩展会更经济。
本质上,大家关心的是能不能把增加机器人变成一种低成本、可渐进扩展的能力扩容方式。
「暗涌Waves」:怎么说服场景方换掉已有的成熟产品,用你们的机器人?
植伟铭:不一定是换掉,可以是一种补充。以公寓场景为例,过去的配送机器人能做的事情比较有限,高灵巧性的协作操作可以进入新的工作环节。
「暗涌Waves」:既然你们的模型能跨本体,为什么还要自研机器人,而不是采购现成的?
植伟铭:早期当然可以使用现成的机器人平台来加速训练和验证。但如果希望长期把模型能力推向真实世界,必须掌握硬件迭代的主动权。
过去的具身行业,更多是“硬件定义模型”,下一代具身应该是“模型定义硬件”。当模型具备更强的灵巧操作、移动操作、多机协作能力之后,它对本体的自由度、负载、工作空间、传感配置和末端执行器都会提出新的要求。硬件成为模型能力的一部分。
长期来看,我们希望成为一家以模型能力为核心的全栈Physical AI公司。
Part02
没有总指挥的机器团队
「暗涌Waves」:两台机器人共同完成一件事,技术难点主要在哪?
植伟铭:机器人之间的耦合会突然增强,主要有四个核心难点——
一是部分可观测性。每台机器人只能从自己的视角观察环境,并据此判断伙伴正在做什么。
二是接触动力学。机器人可能通过同一个刚性物体、柔性物体或工具连接起来,其中一台机器人的动作会立即改变其他机器人的物理状态。
三是伙伴行为的不确定性。机器人伙伴可能慢半秒,也可能抓取失败或临时调整位置,预先规划好的协同轨迹很容易随之失效。
四是误差随时间累积。几十秒的任务可能依靠严格同步完成;当任务持续几分钟,时序偏差、抓取变化和物体状态变化都会不断叠加。
训练Zeno-1时,我们把这些问题视为协作操作的核心挑战,实际上也是把多机器人系统、机器人学习、灵巧操作和长时序决策等过去相对独立的研究方向结合到一起。
「暗涌Waves」:假设在真实场景中,你们的机器人遇到了别的机器人,面对同一个任务,怎么判断谁去做?
植伟铭:这其实是一个调度问题,也是一个人为构造的特殊情形。我们的基础模型会从已采集的数据中学习这些规律。
在去中心化策略下,我们的每个机器人都具备自己的推理能力,计算不集中在一个服务器上。每个机器人会通过自己的视觉画面、本体状态和交互历史作出决策。
所以,它会观察和预测另一台机器人是否行动,再决定自己要不要执行任务。
「暗涌Waves」:“去中心化”的体现是什么?
植伟铭:中心化系统最大的优势是信息完整。
中央控制器理论上可以看到整个团队,更容易做全局任务分配和联合优化。但每一次增加机器人,通常要重新训练,不断扩大一个中央联合策略的输入和输出空间。其中一台机器人出现异常,其他几台可能会随之崩溃。
事实上,很多真实世界系统很难完全中心化。自动驾驶如果能完全中心化,也就做成了。
采用去中心化架构,更容易扩展机器人团队的规模。理论上,我们可以不断添加或减少机器人,架构仍然会保持稳定。
「暗涌Waves」:“去中心化”就没有缺点吗?
植伟铭:代价是部分可观测性(partial observability)。机器人只能根据自己看到的信息判断伙伴意图,随着团队扩张,遮挡、局部冲突和信息缺失等情况会更加严重。
「暗涌Waves」:Zeno-1据称能连续运行超过10分钟、完成8个子任务。这是在什么条件下测的?
植伟铭:测试是在我们自己的真实机器人平台和室内场景中完成,主要验证单策略的持续执行能力。全程使用同一个Zeno-1策略,不同子任务之间没有切换模型,也没有重置环境。
「暗涌Waves」:你们如何训练协作能力?
植伟铭:模型训练分为4个阶段。使用第一视角和第三视角视频数据进行预训练,让模型获得物理行为先验。使用约40小时的独立真机数据进行一轮训练,提升单机操作能力。
在此基础上,我们进行闭环伙伴交互(Closed-loop Partner Interaction)训练:先部署其中一台机器人,让它执行已经学到的策略,同时采集另一台机器人与它实际协作的数据。这一轮数据的信息密度很高,约4小时。
在真实交互过程中,机器人会自然遇到伙伴延迟、动作不一致和需要临时调整等情况。我们将这些交互数据用于下一轮微调,让模型学习如何根据伙伴的实际表现调整动作,提高协作的鲁棒性。
「暗涌Waves」:单机智能和多机协作,哪个更难?
植伟铭:取决于具体任务。如果这个场景是用大量标准化单元并行来扩大系统能力,想要提高效率,一定是多个机器人会更有效,且更容易实现。
Part03
卷入浪潮
「暗涌Waves」:你们首轮融资就都是产业资本,这并不常见。是主动选择吗?
植伟铭:是。我们没有把融资理解为单纯的资金问题。机器人最终要进入真实场景,除了模型能力,还要供应链、算力、机器人硬件和客户资源等等。这些在早期就应该布局完。
舜宇、沐曦这样的产业龙头,本身就位于机器人产业链的关键环节,又了解真实生产环境中的能力边界。他们更清楚什么任务具有付费价值,哪些指标能够进入部署,哪些效果还停留在Demo。
对于一家年轻的具身智能公司,这些判断和资源很重要。
「暗涌Waves」:你们是2025年11月才创业,那时候国内外的具身企业都已经非常多了,你看到的机会是什么?
植伟铭:早期在NVIDIA西雅图机器人实验室、CMU RI,在美国的经历让我看到了很强的机器人研究生态。但是,用基础模型去研究机器人的很多核心问题,已经很难依靠小规模实验室推进。它需要大量的机器人,大量的真实数据,非常快速的硬件—模型迭代,以及模型长期部署后形成的数据闭环。
在职业生涯里,我一步步地感受到这个需求。
去年10月底,我和几位核心创始成员在杭州举行的机器人领域顶会IROS上聊了很久,大家都觉得具身智能还是有很多空间。
我们想做“大脑”。当时市场上专门做预训练的团队并不多,我们判断,基础模型层的生态位有机会“卡位”。
我们一致认为,“协同”这件事会在具身智能的终局存在,那时候北美几家巨头还没正式切入这一方向,因此我们决定快速布局。
「暗涌Waves」:多机协作要从Demo到规模化部署,这条路还有多远?
植伟铭:在特定场景进行多机协作,我认为未来一到两年就有机会看到实质性部署。因为任务边界明确,而且协作产生的经济价值容易衡量。
但如果要实现任意几台通用机器人进入陌生环境后自然组成团队,是一个更长期的问题。
「暗涌Waves」:目前的商业化进展如何?
植伟铭:过去一段时间,我们在澳新及其他海外地区开展了一些PoC测试,预计在2027年上半年正式启动规模化进程,目前关注在服务业。
我们优先选择那些在过去已经被验证过的,机器人能规模化应用、场景方具备好的付费意愿与付费能力、技术边界明确的半结构化场景。一方面是酒店、洗衣、养老和其他服务业,另一方面是精密加工及产业场景。
「暗涌Waves」:为什么敢Day1就做全球化?
植伟铭:我们是CMU RI背景唯一在中国创业的一支师生团队,核心团队大多有海外科研和产业经历,本身就是全球化的。并且在悉尼和匹兹堡设有研发中心,会连接当地的头部场景方、渠道商和人才。通过中国丰富的真实应用场景,低成本、快速地做PoC和迭代。
这样形成一个很清晰的分工:中国负责高效率地把产品做出来,海外帮助我们接触全球最好的场景、人才和市场。
「暗涌Waves」:你认为具身智能行业目前高估了什么,又低估了什么?
植伟铭:行业高估了现有单机智能接近通用智能的程度。很多机器人展示了漂亮的Demo,但进入真实世界长期稳定运行,还要解决环境变化、失败恢复、人机协作和硬件可靠性。
行业也容易高估扩大模型参数量对物理智能的解释力。机器人面对的是连续变化、充满物理约束的世界,模型必须和真实数据、感知、控制及执行形成闭环。
协作和执行层的复杂度仍然被低估。“把桌子收拾干净”看起来只是一句话,实际执行中包含先拿什么、从哪里走、怎样避开人、怎样抓取、物品掉落以后如何恢复等连续决策。
从两台机器人、有限任务开始,逐步增加任务宽度、运行时长、机器人数量和环境复杂度,这是芝诺机器人接下来的路径。
排版|郭栩君
图片来源|Unsplash
 日薪250元的数采员,撑起150亿的独角兽机器人还没学会赚钱,卖数据的先上岸了。
作者 黎曼
本文字数4685
手搓量丨98% AI含量丨2%
淘金热里,最先富起来的总是卖铲子的,这一轮也不意外。
2026年最热的赛道莫过于Physical AI,不少公司也把它当作抬估值的叙事。在这一背景下,行业出现了一种不多见的“倒挂”:本体厂商还在为量产爬坡挣扎,数据服务商的估值已经站上了独角兽线。
这种“倒挂”不是个案。光轮智能2026年6月估值突破150亿元,成为全球首个具身数据独角兽;灵初智能于2026年8月估值迈入百亿元级别。另外,觅蜂科技成立十天就拿到数亿元融资。
一位把国内数采公司的帐翻过一遍的投资人Y曾得出一个结论:数采可能是这条赛道里唯一先跑通商业模式的生意。但这个结论,他几个月后自己推翻了,这是后话。
近期我还听到了两个故事,可以给具身数据赛道添两个注脚:
一家做硬件数采的公司跑通了一条新路线。消息传出去没多久,三五家同行围了上来:挖人的挖人,模仿路线的模仿路线,融资一家比一家快,都想赶在窗口关闭之前把护城河砌起来。
另一家做数据合成的公司,2026年之前无人问津。到了今年,当初那些机构的电话一个个打了回来:接洽,尽调,报价,估值翻了一倍。苦熬多年,被Physical AI这把火一点,忽然成了香饽饽。
一个被围猎,一个被踏破门槛。两条路线,同一种待遇。这大致就是具身数据行业2026年的体感:热,而且是不分路线地热。
钱来得有多急?
先看钱的量级。
2026年到现在,机器人赛道的总融资超过345亿元,其中砸向数据采集领域的超过100亿。如果把仿真合成类的公司也算进来,具身数据这个大盘子在今年上半年就吸走了约170亿元,融资事件25起。
翻开头部数采公司的名单,会发现一个事实:这些头部公司里,大量企业成立于2024年之后,有几家成立还不到一年,但大多数公司融资轮次停留在A轮之前。
轮次早,但不妨碍金额大。与具身数据相关的企业单轮融资超过10亿元的有4家:它石智航、光轮智能、千寻智能、灵初智能。平均算下来,每家的累计融资都在10亿量级。这些数字放在具身赛道早已见怪不怪。在场内下注的也不只是市场化VC,热闹是全维度的:本体在投,国家级基金、地方政府、国资基金也都在投。
与融资同时公布的还包括大订单。比如光轮智能2026年一季度新增订单5.5亿元;灵御智能披露意向订单3亿元、在手订单1亿元,全年预计出货1000台机器。
钱为什么这么急?这来源于一个确定性需求:数据荒。
机器人大模型是否遵循LLM式的Scaling Law,这件事在2026年2月之前还只是信仰。但EgoScale论文已经把它变成了实证:数据规模与任务能力之间,存在可测算的幂律关系。大模型缺数据,机器人更缺数据。互联网上有万亿级token的文本语料,而机器人可用的真实物理交互数据,全球加起来只有约50万小时,缺口99%。
缺口就是市场。这个市场如今挤进了近百个玩家,其中七成在做采集,同一种抓取、分拣、开门的数据,人人都在采,因为最好标注、也最容易商业化,招聘市场还带火了一批“日薪250元”的宝妈数采员。
目前,做数据的服务商大致可以分为三类:
一是本体公司自己下场做数据,典型玩家包括智元、千寻智能、优必选等。其优势在于本体公司可以用硬件反哺数据、绑定生态。
二是独立数据服务商,从零起步、没有机器人包袱,专注做“卖水人”。光轮智能是这一类最出名的玩家。他们采集的同一份高质量数据,可以卖给多家客户,数据资产可反复变现。
三是互联网大厂亲自下场圈数据,动静最大的是京东和百度,大厂的优势在于它的人力成本是固定支出,采集的边际成本接近于零,未来可能会对独立数据服务商的定价权形成长期压制。
也就是说,2026年的具身数据赛道,至少有三路人马在同台竞技,每条路线都有自己的逻辑闭环,都拿着不菲的融资。
单看上面这几组数字,都会认为这是一个完美赛道:产品供不应求,客户排队下单,融资节奏顺滑。既然机器人被普遍认为是下一个iPhone时刻,数据就是这条产业链上最早兑现的现金流,这个推理听起来无懈可击。
数采只有资本在赚钱?
但最近一则新闻也揭开了这条火热赛道的裂缝:
8月28日,南方都市报报道,位于北京石景山区首钢园的北京首个人形机器人数据训练中心已停止运营,原合作方机器人公司睿尔曼智能因数据采集模式调整已从该项目中撤出。该中心于2025年3月揭牌,占地面积3000平方米,曾部署100多台机器人,搭建了家庭康养、特种作业、汽车装配等十大实景场景。
运营方解释停运原因之一在于数据采集模式调整了。因素之一是实验室遥操采集的数据“太干净”,无法覆盖真实世界中光线干扰、物料偏差、场地不平、工况异常等不可预知的物理变量。
“近期,越来越多的实采数据工厂开始停运。原因在于:一,成本太高;二,数据不好用。”Y向我进一步解释:
成本高在于,一套数采工厂的硬投入包括设备、operator薪酬和场地三项,真机遥操数据单有效小时成本在500-1000元区间,无本体数据也要200-400元,加上设备折旧和人员管理费,没有规模化订单摊薄,工厂很难自负盈亏。
数据不好用是因为大量采集集中在抓取、分拣、开门这几类最易标注的场景,结构高度同质;而真机数据又强绑定特定本体,换一台机器人就要重新训练,模型公司买回去常常发现能看不能用。
年初,Y以为数采是目前短期内具身赛道唯一跑通商业模式的生意。但经过几个月的了解,还把国内几家数采公司的账翻出来算了一遍,“被打脸得挺明显”。不过Y同时承认,光轮的高复售率、觅蜂拿到了腾讯和蚂蚁的订单,这也说明头部公司已经跑出了可复制的商业模式,问题更多出在头部以下。
一位数采行业人士F向我透露,行业订单虽然在变多,但也存在一些虚实差距。比如,签约订单对应的真实收入大概在1到2亿元的量级,其余是分批执行的合同额度。一些公司的订单,看起来金额大,但其实是意向订单,有的转化率在一至三成不等。
大额资金涌入头部企业,但细看,头部数采公司里,3家背后站的是同一批机器人本体公司:
智元机器人投了灵初智能的种子轮;智域基石的天使轮来自灵初智能、穹彻智能、浙江人形、智平方4家机器人公司,这四家不仅是投资人,也是它的首批客户;觅蜂科技是智元自己孵化的,从成立之初就带着智元的资源与订单起跑。
翻译过来就是,上下游在互相“投资”自己。机器人本体公司缺数据,然后自己投资或孵化数采公司,让这家数采公司为自己供货。数采公司拿到融资之后,用本体公司的钱去建数采工厂、招operator、买设备,然后把采集出来的数据卖回给本体公司。
“表面上是两家公司都在增长,实际上是同一批钱在两家资产负债表上算了两遍。这种左手投右手的格局,当然有资本腾挪的色彩,但客观上也让一批数采公司在2025年没融到钱的年份里活了下来。订单有了,硬件投入有人分担,数据也有了第一笔买家。换到今天再看,这套打法至少支撑了2026年上半年的产能扩张。”Y观察道。
那么这一圈绕下来,到底谁赚到了钱?
“数下来可能是赚估值倍数的早期股东;套现部分股权的创始人;赚设备、场地、人力生意的配套服务商;本体厂商的投资收益;BD、Pr甚至宝妈数采员都赚到钱了,而数采公司自己,暂时是这条链上干活最重、离钱较远的一环。”F感叹。
但实际上,这条名单里的每一个人都是这场盛宴的实际受益者,但别忘了买单的最终是机器人本体厂商和背后的VC。他们愿意持续买单的前提只有一个:机器人要能学会干活。
“每个篮子里都得有鸡蛋”
了解一圈具身数据现状后,我得到了一个结论:这是一个有确定性需求、但供给不确定、商业模式头部跑通整体未通的赛道。
供给侧的不确定,根源在技术路线还没收敛。打开任何一家具身数据公司的产品手册,能看到的分类至少有四个维度。
按数据来源分有人类第一视角视频、互联网公开视频、真机遥操作、部署日志回采、仿真合成。按采集方式分包括遥操、穿戴式采集、本体自采、众包采集。按硬件形态又分本体采集和无本体采集。按生成方式分包含真机数据和仿真合成数据两类。
这四类在任何一个行业研报里都能拉出长长一列,但落到2026年上半年的融资分布上,钱其实只压在了两个判断上:
一派押真机实采,代表玩家是觅蜂等,估值故事的核心是“机器人要学真本事就得喂真数据”。另一派押仿真合成,代表玩家是云道智能、智澄AI等,估值故事的核心是“真机数据又贵又慢,仿真能指数级放大规模”。两派都拿到了大钱,也都有人在2026年新晋独角兽。
但现在有个新趋势:2025年之前,具身大模型训练数据中仿真合成数据占比高达80%到90%;到2026年,“人类数据”的浓度和认可度明显提升,头部也开始朝双路线布局,比如光轮从仿真起家,现在是双线并行。背后的一大原因是,一个在仿真环境里做到89%成功率的策略,落到真机上只剩12%。
针对行业现状,我询问了一家在仿真赛道扎根12年的企业,云道智能。今年,这家公司向具身数据拓展,目前已和不少本体公司合作。
云道智能方面认为:它揭示的方向是对的。越接近开放环境、越依赖接触和长链路决策,虚实差距就越大。摩擦、间隙、材料形变、末端执行器特性、电机迟滞,再叠加相机角度、光照和现场物料波动,都会影响结果。“我们看到的不是仿真变弱,而是行业从‘先解决规模’,进入‘必须由真实世界锚定规模’的阶段”。
云道智能认为,仿真的核心不是规模大,而是分布广。因此真机和仿真不是替代关系,是分工。“现在真正的瓶颈在跨本体、跨场景的泛化能力,而这个行业至今没有独立可复核的误差基准,仿真数据的质量验证,还没有公共答案。”
投资方云道资本创始人曹稷山认为,“合成数据路线,理想状态下公司很值钱,但业界早期看法并不特别乐观;仍需足够多客户与订单验证可行性。立意可以很高,关键是能否被验证。”他也强调,数据会贬值,会变老,持续生产数据的能力比数据本身值钱;只卖数据、离客户太远的公司,拿不到反馈,数据资产会老化。
“数采平台一定会出现很牛的公司。”曹稷山认为,路径上,软硬件解决方案比纯数据更有机会,硬件有技术壁垒再往上走,往往更容易,可能得掐住6到12个月的窗口。但最终必须有头部客户交付能力,要做Tier 1,不能长期做分包商。
曹稷山看好数采平台的长期价值,他的逻辑锚点是一笔重磅交易:2025年年中,数据标注巨头Scale AI“卖身”Meta,这证明数据公司可以讲出一个独立的资本故事。
但Scale AI这个锚点本身也值得多想一层。一家公司从标注起家,如果最终归宿是被大模型巨头或者本体收编的话,是不是意味着目前的商业模式还没有到能够独立IPO的时刻?
虽然路线还未收敛,但都得到大家一致认同的观点是:堆量不赚钱。
“单纯靠人工采集堆小时数,容易变成重资产、项目制服务;真正有长期价值的是把真实数据、仿真生成、模型评测和部署反馈连成闭环。”云道智能认为,未来,行业接下来至少要过三关:
第一,数据是否标准化:格式、标注、物理参数、质量评价、来源合规和可追溯性,能否形成共同语言;第二,数据是否真正有效:能不能在真实机器人上提升成功率、降低调试周期和试错成本;第三,商业模式是否成立:数据能否跨客户、跨任务、跨本体复用,能否从一次性项目交付变成持续的训练、评测和部署反馈服务。
但另有“算法派”投资人告诉我:具身破局的关键不是数据,也不是传感器,而是世界模型。他认为具身的瓶颈卡在“大脑”,谁能做出好的世界模型谁赢。他认为短期可量化的验证指标只有一个:scaling十倍。现在头部世界模型在70亿到100亿参数,“谁能把它后边加一个零,谁就在短期跑出来”。
行业种种,目前皆在动态演变,未分出绝对胜负。但淘金的“铲子”已经在一级市场卖出了金子的价,这笔账的答案,恐怕要等到2027年来揭晓。
今年,我从不少于2位有真才实学的VC和从业者那里得到一个比较清晰的判断:具身的GPT时刻大概率会在2027年上半年到来。也就是说,在这之前,这个赛道正在迎接前所未有的压力测试。
而2026年至今发生的大额融资数据,与其说是一级市场选出了路线,不如说市场对每一条能讲清稀缺故事的路线都下了注。VC不是在押哪一派对,是在确保自己不缺席可能对的那一派。所有人都记得大模型时代踏空的感觉,所以这一次,每个篮子里都得有鸡蛋。
作者黎曼 编辑王庆武
 「AI 投研精英孵化计划」硅谷深度行:从科技现场到产业于投资判断 —— Todd导语
过去十年,人工智能完成了从技术突破、产品化爆发到基础设施大规模扩张的跨越。如今,行业正在越过“只要加大投入就能获得估值奖励”的阶段,进入更严肃的经营考验:模型是否能稳定变现?数据中心能否提升利用率?巨额资本开支何时回收?而当 GPU 供给逐步改善,电力、并网、冷却和工程能力又如何成为新的稀缺资源?
这篇文章基于一场关于 AI 产业投资逻辑与硅谷见闻的课程分享整理,尝试从产业周期、价值链、存储价格、模型竞争、能源约束与 Physical AI 等维度,梳理 AI 下半场最值得关注的变化。
核心摘要
AI 产业可概括为三段演进:2016—2021 年的技术突破与视觉 AI 落地、2022 年的估值出清与 GPT-3.5 产品化拐点,以及 2022 年末以来的 AI 基础设施建设周期。
2025 年末前后成为重要分水岭:市场从奖励“敢于大举资本开支”,转向要求企业证明收入、现金流、利用率和回报周期。
AI 产业链可分为下游模型与应用、中游云与算力服务、上游半导体与能源。模型层的定价权,决定了成本和利润能否向上游传导。
存储涨价周期表明,价格上涨并不自动等于长期机会;当终端承受力达到上限,需求收缩、替代方案和新增供给都会反过来压制价格与估值。
算力瓶颈正由芯片供给向能源基础设施迁移。未来数据中心的扩张不仅取决于 GPU,还取决于电力接入、输配电、冷却、并网和建设能力。
大模型竞争正在分化为极致性能、极致性价比和垂直场景三条路线;真正的胜负手是能否形成可持续的单位经济模型。
人形机器人和 Physical AI 仍面临三维世界数据不足与泛化能力有限的问题,短期更适合在标准化、可控场景落地;自动驾驶则更接近规模化商业运营。
从 AlphaGo 到大模型:AI 的三次断代
回看近十年的 AI 产业发展,可以大致分为三个阶段。
第一阶段:技术突破与视觉智能落地
2016 年,AlphaGo 战胜李世石,让公众第一次直观感受到人工智能在复杂任务上超越人类的可能性。随后,AI 产业的关注度迅速升温,但在相当长时间内,商业化落地主要集中于计算机视觉领域。
这一时期,商汤、旷视等视觉 AI 公司成为典型代表。市场认可 AI 的技术价值,却仍在寻找更广泛的产品形态与商业场景。可以说,当时的 AI 已经“足够聪明”,但离大规模、低门槛地服务普通用户仍有距离。
2020 年前后,GPT-3 等模型已让研究人员意识到生成式 AI 的潜力,但普通用户尚未真正感知其变化。原因并不复杂:技术能力已有雏形,产品交互却尚未成熟。
第二阶段:估值出清与 GPT 时刻
2022 年,全球流动性收紧、风险资产估值回落,市场经历了广泛的“去泡沫”过程。对于 AI 产业而言,这一轮调整并非只是资本市场的降温,也为下一轮产业周期释放了空间。
真正的转折出现在 2022 年末。GPT-3.5 以更易用的聊天交互方式进入公众视野,生成式 AI 第一次从研究成果变成了可被大规模体验的产品。技术突破、产品成熟度提升与宏观环境变化在这一时间点叠加,构成了新一轮 AI 周期的重要起点。
第三阶段:AI 基础设施扩张与 ROI 考验
从 2022 年末开始,AI 进入基础设施建设周期。数据中心、GPU、CPU、存储、网络连接、机柜与配套电力系统,都成为产业链的关键投入方向。
在这一阶段的前半段,市场更关注企业是否足够积极地扩大资本开支:建更多数据中心、采购更多芯片、部署更多算力,往往被视为抢占未来的必要动作。
但到 2025 年末前后,市场的评价标准开始发生变化。企业不再仅仅因为“投入更多”而获得认可,投资者开始追问更具体的问题:
资本开支能否转化为收入?
数据中心的利用率是否足够高?
设备折旧、融资成本和电力成本能否覆盖?
算力租赁的价格是否能够维持?
模型服务是否拥有持续提价能力?
AI 由此进入“算账”的下半场。增长仍然重要,但增长的质量、回报周期和现金流能力变得更加重要。
重新理解 AI 产业链:模型、云与能源
理解 AI 投资逻辑,需要先统一产业链视角。
产业环节
典型参与者
核心职责
关键问题
下游
模型厂商、AI 应用公司
面向企业和消费者提供模型能力、应用服务
能否形成用户价值与持续付费
中游
云厂商、算力服务商
建设并运营数据中心,提供计算资源
利用率、租赁价格、回本周期
上游
半导体、存储、网络、能源厂商
提供芯片、设备、材料、电力等基础能力
供需关系、价格、产能与基础设施约束
在这个框架中,模型厂商是直接面向用户的一端,包括通用大模型、行业模型和 AI 应用服务商。它们决定了 AI 能力能否转化为真实收入。
云厂商则更像“数字时代的商业地产开发商”:先投入资金建设数据中心,再把算力以云服务或租赁的方式提供给客户。其商业模型并不神秘,核心是投入、利用率、租赁价格、折旧与回本周期之间的平衡。一个健康的云业务,需要能够在相对明确的周期内收回资本投入。
而半导体与能源构成了产业链的上游基础。过去数年,GPU、存储、服务器、网络设备等硬件成为最受关注的环节;但随着数据中心规模迅速扩大,新的约束已经逐渐显现:芯片未必是唯一稀缺资源,稳定、可接入、可扩容的电力正在成为更重要的瓶颈。
“全产业链通胀”正在被打破
AI 基础设施周期之所以能带来显著的产业机会,本质上依赖于一种类似“全产业链通胀”的机制。
以传统地产周期为例:当下游房价和土地价格持续上涨时,开发商可以承受更高的水泥、钢材、设备和人工成本。下游能够涨价,就会将利润和价格空间逐步传导至中游与上游,最终形成整条产业链的盈利扩张。
AI 产业同样如此。
如果模型厂商可以持续提高服务价格,或者通过更高价值的产品和更大的调用量扩大收入,那么云厂商能够承受更高的算力建设成本,上游的 GPU、存储、服务器和能源供应商也更容易获得更高的价格与利润。
但问题在于:模型服务是否真的具备长期提价能力?
随着中国模型厂商加速追赶、开源模型能力提升,以及全球大模型竞争持续加剧,模型层的价格战正在削弱这一前提。若模型能力逐步趋同,服务价格持续下降,产业链就可能从“量价齐升”转向“量增价不涨”。
这将直接改变投资判断:需求增长依然存在,但估值扩张和利润率提升未必能够同步发生。
存储周期的启示:涨价并不等于长期机会
存储行业是理解周期波动的一个典型样本。
在周期底部,市场常常表现为价格低迷、交易冷清、投资者缺乏兴趣;而当需求改善、库存下降和供给扩张不足同时出现时,价格会迅速上行。涨价初期,市场通常会给予更高的预期和估值。
但价格并不可能无限上涨。
课程中以消费级内存为例指出,当终端产品价格涨到用户难以承受的水平时,需求会明显收缩。对于消费者而言,硬件价格过高并不会自动带来更多购买,反而可能让用户延迟换机、减少配置,甚至放弃相关消费。
这背后反映的是一个朴素的经济规律:供给端的涨价,最终可能引发需求端的崩塌。
对于企业级市场,情况可能有所不同。大型云厂商和数据中心客户对高性能存储有更强的刚性需求,短期内仍可能接受更高价格。但一旦价格过高,也会激励客户寻找替代供应商、优化软件架构、调整采购节奏或推动新产能进入市场。
因此,判断周期品不能只看“是否涨价”,更要看三个问题:
涨价来自真实需求增长,还是短期供给扰动?
下游是否有能力把成本继续转嫁出去?
高价格是否会损害终端需求,或吸引新的供给进入?
从这一角度看,存储行业未来更可能进入需求稳健、价格趋于理性、回报更依赖分红与回购的阶段,而非持续依靠估值抬升实现高弹性增长。
算力瓶颈正在从“卡”转向“电”
过去两年,市场讨论 AI 时,最常见的问题是“GPU 够不够”。而从硅谷一线观察来看,真正的约束正在发生迁移:越来越多情况下,问题不再是有没有芯片,而是有没有足够的电力、变电设施和并网能力让这些芯片真正运行起来。
一座大型 AI 数据中心的建设,远不只是采购服务器。它还需要:
稳定且规模足够的电力供应。
输电、变电和配电基础设施。
冷却系统与机房工程能力。
土地、审批、并网和建设周期。
长期可预测的能源成本。
也就是说,GPU 即使已经到位,如果数据中心无法及时接入电网,算力资产就无法转化为收入。
这也是为什么 AI 基础设施投资的重点正在从单纯的半导体扩展到能源与电力设备:发电能力、电网改造、变压器、输配电设备、备用电源、冷却系统和数据中心工程能力,可能都将成为影响产业扩张速度的重要变量。
对于投资者和产业参与者而言,这意味着一个重要变化:未来 AI 产业链的超额收益,未必只来自“卖算力”,也可能来自“让算力真正插上电”。
大模型竞争:性能、价格与工程能力的分化
大模型行业正在走向明显分化。
一类公司仍然坚持追求最强模型能力,通过更大的训练规模、更高的推理成本和更激进的技术路线来维持领先优势。这类路径需要持续投入巨额资本,也需要依靠更强的性能建立品牌、用户与定价权。
另一类公司则更注重工程效率和性价比:不一定每一次都追求参数规模或排行榜第一,而是关注模型是否足够好用、推理成本是否足够低、开发者是否愿意接入、企业是否愿意采购。
这两种路线并不存在绝对优劣,关键在于商业模式能否闭环:
极致性能路线需要证明,用户愿意为领先能力支付溢价。
极致性价比路线需要证明,成本优势可以转化为规模与利润。
垂直应用路线需要证明,行业场景能够形成更高的切换成本和付费意愿。
真正值得关注的,并不是模型发布时的热度,而是模型能力能否带来可持续收入、留存率和单位经济效益。
Physical AI 仍在早期,自动驾驶更接近商业化
“物理 AI”与人形机器人是当前最受关注的前沿方向之一,但其难点远比训练一个语言模型复杂。
语言模型主要处理文本、图片、代码和视频等互联网数据;而机器人需要在真实三维世界中完成感知、理解、规划和执行。这意味着它不仅要“看见”物体,还要理解距离、方向、力度、摩擦、重力、触感、空间关系以及操作后果。
例如,一个机器人学会开门,并不代表它就能顺利关门;学会拿起一个杯子,也不代表它能在不同材质、不同重量、不同桌面环境下稳定完成操作。核心挑战在于泛化能力不足,以及高质量三维、多模态、具身交互数据的缺失。
因此,机器人短期内更可能先在高度标准化、重复性强、环境相对可控的场景中落地,如工厂、仓储、物流、清洁和特定服务流程,而不是立刻成为可以适应任何家庭环境的通用助手。
相比之下,自动驾驶在特定区域、特定天气与特定运营条件下,已经更接近规模化商业落地。其本质同样是 Physical AI,但它拥有更明确的任务边界、更密集的数据来源和更直接的商业化路径。未来,自动驾驶的发展仍将取决于安全性、成本、监管和运营效率,而非单一技术指标。
结语:AI 的机会没有结束,只是评价体系变了
AI 基础设施建设尚未结束,但“只要扩张就有价值”的阶段正在过去。
接下来的产业机会,更可能集中在能够解决实际约束、创造真实现金流的环节:更高效的模型、更可控的推理成本、更高利用率的数据中心、更稳定的能源供给,以及能够在真实物理世界中长期运行的智能系统。
对于产业参与者而言,最重要的能力不再只是讲述技术故事,而是回答一个更现实的问题:这项技术最终如何创造收入、降低成本,并在持续竞争中保持回报?
当 AI 进入“算账时代”,真正的分水岭不在于谁拥有更多概念,而在于谁能把概念变成可复制、可交付、可持续的商业结果。
说明:本文依据课程录音转写与会议摘要整理,涉及的市场判断、行业观点与案例仅代表分享者的分析框架,不构成投资建议。
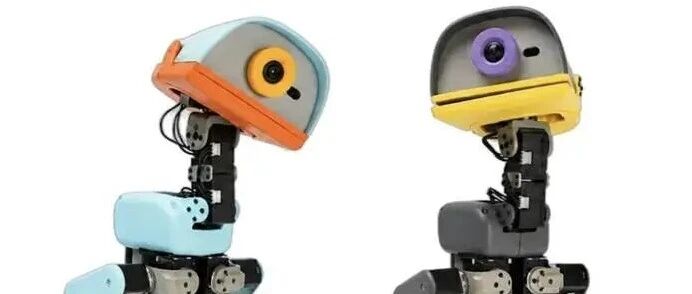 一只鸭子前几天英伟达不是花了129亿美元收购了 Hugging Face 吗? 这不刚收购完,一个星期不到,Hugging Face就交了第一份作业: Microduck。
Microduck 是一只售价 399美元、25 厘米高的开源 AI双足小鸭机器人,8月27号推出的,已经卖疯了,24小时销售额260万美元,首批交付时间已经推迟到圣诞节后了。外型长这样:
它不仅仅是一个玩具鸭,更是一个面向开发者、AI/机器人爱好者和教育用途的 Physical AI 平台。
官方定位其实非常明确: 一个你可以自己教它新技能的小型双足机器人。
官方说预装 7 套已训练动作:
摇摆走路,可用手柄控制速度
坐下、蹲下、自己站起来
用喙捡地上的东西(演示里有袜子、马克笔)
踢球
装上轮子后轮滑
摔倒后自己翻身站起
追激光笔、对环境做出反应,也可用 NFC 标签触发动作
每只鸭子第一次开机时会生成自己的声音身份,偏怪叫而不是语音助手。多只Microduck 还可以互相互动。
Microduck 最值得关注的不是它能不能卖萌,而是它背后的路线:AI 模型 → 仿真环境 → 强化学习 → 真机。
比如你想让 Microduck 学会一个新动作:在电脑里的模拟器中训练 → 得到 RL policy → 部署到真实 Microduck → 机器人执行 → 收集数据 → 再训练。
Hugging Face 已经把SDK、模拟环境和强化学习训练工具链开放出来了。也就是说,它希望把机器人变成类似 Hugging Face 上的 AI 模型一样:
别人训练出来一个机器人技能,我可以下载;
我自己训练出来一个技能,也可以上传给别人。
这实际上就是 Hugging Face 想做Physical AI 的开放生态模式。官方也明确说了,希望让物理行为像模型一样能够被分享、复现和二次开发。
为了缩小仿真和现实之间的差距,训练环境还专门模拟了电机摩擦、电池电压变化、控制延迟,甚至连舵机齿轮的 Backlash 齿隙都考虑进去了。
说白了,Microduck本质上是一台迷你具身智能开发平台,比春晚上跳舞的机器人高到不知道哪里去了。
这里其实也有机会,比如芯片是由瑞芯微提供的,当然也会有其它的机会,大家可以挖掘挖掘,说不定就是具身智能的chatgpt时刻。
 AxBlade 將於 AWS Summit 香港期間舉辦「From Agentic AI to Physical AI」Side Event香港,2026 年 6 月 18 日 —— AxBlade 將於 6 月 18 日 AWS Summit Hong Kong 期間,舉辦一場邀請制閉門活動「From Agentic AI to Physical AI」。活動將邀請約 150 位創辦人、工程師、合規負責人及投資人,聚焦一個正在被業界迴避的問題:當 AI 從生成文字走向物理世界執行動作,驗證、追溯與問責的基礎設施已明顯滯後於能力的躍升。
什麼是 Physical AI?為何問責問題比想像中更迫切?
所謂 Physical AI,是指不只在螢幕上生成文字或圖像,而是能在現實世界執行實體動作的人工智能系統——涵蓋工廠機械臂、自動駕駛車輛、手術輔助機器人等場景。這些系統一旦出錯,責任歸屬的複雜程度遠超傳統軟件故障。
今日的 AI 競爭重心已經轉移。問題不再是某個模型能否通過某項基準測試,而是自主系統能否被部署進工廠、車輛或醫院,同時不製造無法追責的風險。
以下三個真實可能發生的場景,清楚說明問題所在:
凌晨三點,AI 交易機器人執行了一筆未獲授權的槓桿訂單;斷網災區環境下,手術機器人完成了一次切割動作;生產線上,人形機器人做出接觸決策導致工人受傷。這三個場景指向同一種制度性失敗——沒有可信記錄能夠證明「誰」在何時做出了「什麼」決策,也沒有任何證據能夠驗證該決策是否在既定的授權邊界之內。
現有審計工具為何無法解決這個問題?
現有的審計工具,設計初衷是為人類操作的軟件系統服務,無法還原自主 AI 代理的完整決策鏈。這並非工具的技術限制,而是根本的架構問題。
更深層的挑戰在於:任何依賴單一公司服務器的問責系統,都會繼承該公司本身的利益與風險。日誌可能因系統故障而丟失,可能因版本更新而被改寫,也可能在法律壓力下消失。當保險公司、監管機構與機器人製造商就同一事故各執一詞,沒有任何一方有足夠的理由信任對方的服務器記錄作為中立裁決依據。
AxBlade 嘗試以公鏈形態回應這一問題:一個開放、無需許可的執行環境,其中的行為證明以密碼學終局性(cryptographic finality)作為錨定,而非依賴任何組織層面的承諾或自我申報。
關於本次活動:這是一場工作會議,不是發布會
AxBlade 對本次活動的定位,是工作會議(Working Session),而非產品發布會、代幣活動或泛談「AI 將改變一切」的舞台。
議程設計的核心目的,是讓已在生產環境中部署自主系統的從業者,能夠展示並討論真實的技術選型與商業決策——包括部署時遇到的實際問題、合規層面的未解難題,以及基礎設施建設的優先順序判斷。
預期出席機構涵蓋 AWS、NVIDIA、Y Combinator、Crypto.com、Roche 及 Pfizer 等,代表雲端基礎設施、機器人技術、醫療及機構金融等多個領域。參與名額設有上限,採申請審核制。
活動議程
13:30–14:30 嘉賓簽到 & 歡迎咖啡
14:30–15:00 AxBlade 主題演講:協議現況、測試網即時數據與 Physical AI 存證基準
15:00–15:30 AWS 主題演講:面向可驗證 AI 執行的雲端基礎設施
15:30–17:00 三場專題討論:AI 基礎設施融資趨勢、真實世界部署、從 Demo 到規模化生產
17:00–18:00 定向交流 / Demo 角:PoB 即時驗證、機器人邊緣存證、EU AI Act 合規映射
18:00–21:30 閉門私享晚宴(僅限邀請)
AxBlade 在做什麼?
AxBlade 並不製造 AI 模型。該項目構建的,是位於模型層與應用層之間的可溯源層(Accountability Layer)——透過鏈上身份識別(DID)、行為存證(PoB,即 Proof of Behavior)、決策溯源(PoD,即 Proof of Decision)與零知識證明,讓自主 AI 系統的行為能夠被獨立審計與追責。
這一基礎設施需要一種特定的形態:公鏈,而非私有數據庫。只有當帳本是無需許可、以密碼學保護的,才能為多方之間的爭議提供中立的裁決基礎。
AxBlade 的設計目標是:高吞吐行為存證、以太坊級終局性、以 AI 治理為核心建構的 Layer 2 公鏈——而非以金融投機為導向的基礎設施。每一份行為證明都發布在鏈上,每一項聲明均可由任何第三方獨立驗證,無需信任 AxBlade 或 AI 運營方本身。
如何申請參與?
本次活動為邀請制或審核制,剩餘少量名額對以下人士開放申請:在受監管或物理環境中部署 AI 的技術創辦人、負責 AI 治理的企業決策者,以及關注基礎設施賽道的投資人。
申請參與:https://luma.com/9byrohqe
關於 AxBlade
AxBlade 是一條專為 AI 問責而構建的 Layer 2 公鏈。透過鏈上身份、行為存證(PoB)、決策溯源(PoD)與零知識驗證,AxBlade 為自主 AI 系統提供可驗證、可審計、可追責的信任基礎設施,覆蓋從數字代理到物理機器人的全場景。
活動資訊
日期:2026 年 6 月 18 日(週三)
時間:13:30–21:30(香港時間)
地點:香港灣仔 Kennedy Road 15 號 21F
形式:AWS Summit Hong Kong 期間邀請制閉門活動
 COMPUTEX 2026:AI从算力竞赛走向实体部署,机器人产业链开始进入量产叙事 —— 从台北展会现场到资本市场热议,Physical AI如何重塑产业关注焦点导语
6 月的台北,COMPUTEX 2026 把“AI Together”写在了最醒目的位置。与去年还在讨论“AI NEXT”、更多强调下一阶段技术突破不同,今年展会传递出的关键信号已经明显变化:人工智能不再只是围绕大模型、服务器和算力芯片展开叙事,而是开始进入机器人、自动化、边缘运算、智能空间与真实业务流程之中。
对于产业观察者而言,这意味着 AI 的讨论中心,正在从“谁的模型更强”转向“谁能把 AI 真正部署进机器、系统和组织,并形成规模化交付”。
就在同一天,市场另一端也出现了呼应这一趋势的信号。6 月 5 日,市场关注度较高的投资人 Serenity 公开发文称,绿的谐波(688017)是其在人形机器人赛道布局中最看好的中国上市公司之一,并围绕谐波减速器、旋转关节减速器、直线执行器、电机、关节以及行星滚柱丝杠等核心部件,展开了其对“实体 AI”量产逻辑的判断。该观点迅速在市场发酵,绿的谐波股价当日出现显著波动。展会现场与资本市场的两条线索,在同一天形成了一次颇具代表性的交汇:当 AI 开始被放入机器人和自动化系统中,行业讨论的重点,也开始从模型能力本身,外溢到整机制造、供应链协同和关键零部件价值分配。
摘要
COMPUTEX 2026 在“AI Together”主题下,进一步强化了 AI 基础设施、边缘计算、机器人与智慧移动、下一代技术应用等多个方向,展会规模达到 1500 家厂商、6000 个展位,创下新高。
多家参展企业的展示重点,不再停留于生成式 AI 演示,而是进一步延伸到智能空间、智能制造、协作机器人、智慧停车、边缘推理、端侧 AI 设备以及企业场景部署。
与 2025 年相比,COMPUTEX 2026 最显著的变化,是展会叙事从“AI 的下一步”转向“AI 如何被协同交付并进入产业系统”。
与此同时,围绕绿的谐波的市场讨论,则折射出资本市场对机器人产业链的关注正在上移。根据公开流传的 Serenity 发文内容,其核心观点并非停留在单一公司情绪判断,而是围绕“若人形机器人进入规模化量产,哪些能够稳定切入单机 BOM 并具备多个核心部件布局能力的公司,将在产业放量中受益”这一逻辑展开。无论这一判断最终能否完全兑现,它都对应了当前机器人赛道最受关注的问题:Physical AI 如果从概念验证走向量产落地,产业价值究竟会沉淀到哪里。
AI Together
从展会层面看,COMPUTEX 2026 由台北国际电脑展延续升级而来,官方将本届主题定为“AI Together”,并明确提出聚焦 AI 运算与机器人、次世代科技、未来移动等方向。公开资料显示,本届展会吸引来自 33 个国家和地区的 1500 家厂商,使用约 6000 个展位,规模高于上一届。除了延续 AI 运算的高热度之外,展会今年新增 AI 机器人专区、科技应用与体验馆等内容,显示主办方正试图把 AI 从芯片与整机层的展示,扩展到更丰富的产业应用和体验式场景之中。
从企业展示内容看,今年不少参展方都在弱化单纯“秀模型”或“秀参数”的表达方式,转而强调落地能力、场景部署和系统协同。例如,联发科在本届展会上展示了从边缘到云端的 AI 布局,并将机器人、交通、智慧家庭、个人设备和数据中心连接进同一叙事框架;InnoVEX 2026 则将“AI 商业化”列为重点方向之一,主办方公开描述中也多次提到制造、机器人、企业自动化与下一代计算等场景。换句话说,今年 COMPUTEX 最值得注意的变化,不是 AI 标签更多了,而是 AI 终于被更明确地放入可交付、可部署、可量产的工业与商业系统中。
从市场层面看,6 月 5 日围绕绿的谐波的讨论同样引发关注。多家加密和财经资讯平台转载了 Serenity 对该公司的判断,相关内容提到,绿的谐波业务覆盖谐波减速器、人形机器人旋转关节减速器、直线执行器、电机、关节及多类核心零部件,并正进入行星滚柱丝杠领域。公开转载内容还提到,其对绿的谐波的看法建立在一个鲜明假设之上:一旦人形机器人走向规模量产,具备关键零部件切入能力、能够在单机价值量中占据一定比例的公司,将有望持续受益。
需要指出的是,关于“国内市场份额超过 60%”“全球客户超过 1800 家”等说法,当前广泛流传的来源主要来自 Serenity 相关发文及其二次转载。在公开研究资料与不同时间点的行业报告中,关于绿的谐波市占率、客户覆盖口径及其可持续性,存在不同统计口径与阶段性变化。因此,对于正规新闻写作而言,更稳妥的处理方式,是将这些数字明确归于“据 Serenity 发文表述”或“据公开流传信息”,并同时提醒读者,相关行业数据仍需结合公司定期报告、券商研究和后续订单验证交叉判断。
产业扩散
如果把 COMPUTEX 2026 与当下资本市场对机器人链条的关注放在一起看,可以发现一个非常清晰的共振:AI 产业正在从以“计算”为中心的上游竞赛,逐渐转入以“部署”为中心的中游和下游扩散。过去两年,资本市场和媒体报道中的焦点主要集中在 GPU、HBM、高速互连、服务器整机和大型模型厂商上;而到了 2026 年,随着边缘 AI、Agentic AI、机器人与自动化应用在展会上被集中展示,市场开始更认真地讨论,哪些硬件、系统和零部件会在下一阶段真正受益。
这也是为什么机器人赛道在今年的讨论中显得格外特殊。与生成式 AI 软件不同,人形机器人若要真正进入规模化部署,不仅需要感知、决策和控制层面的算法进步,还需要整机设计、执行器、减速器、丝杠、电机、关节、传感器、电池、线束、连接器以及制造良率的协同突破。换句话说,Physical AI 并不是一个单点的软件升级,它更像是一场跨越算法、工程、制造和供应链的系统战。而这种系统性,恰恰与 COMPUTEX 2026“AI Together”的展会主题形成了某种呼应。
从这个角度看,今年展会最重要的产业意义,或许不是再次证明 AI 很热,而是提示市场:AI 正在开始“长出身体”。当 AI 进入机器人、工业控制、智能空间和运营系统,它所对应的价值创造方式也会发生变化。模型和芯片仍然重要,但它们不再是价值链上唯一的焦点;谁能将这些能力封装进真实可运行的机器与系统,谁就更有可能在产业化进程中占据位置。
对于投资者而言,这种变化带来的一个直接结果,是观察框架需要同步迁移。过去关注 AI 产业,可能更多是看算力需求、芯片迭代和云厂商资本开支;而在机器人及自动化叙事升温后,市场会开始向下拆解单机 BOM、零部件壁垒、量产可行性、成本下降路径以及客户认证周期。Serenity 关于绿的谐波的公开表述之所以迅速引发讨论,也正是因为它触碰了这一新的估值问题:如果未来的人形机器人不只是实验室样机,而是逐步迈向成规模出货,那么那些能够稳定进入核心环节的零部件企业,是否会在市场重估中占据更高权重。
不过,展会热度和市场情绪并不能自动转化为产业兑现。无论是机器人整机厂、核心部件供应商,还是提供算法与操作系统能力的 AI 公司,真正决定行业节奏的,仍然是订单、成本、良率、稳定性与客户采用速度。尤其在人形机器人领域,从样机展示到规模商用之间,往往横亘着极长的工程化与商业化距离。COMPUTEX 2026 让外界看见了这条路径正在被加速铺设,但这并不意味着所有叙事都将在短期内被验证。
结语
回看今年的 COMPUTEX,一个最值得记住的变化在于,AI 展会的重心已经发生位移。它不再只是一个展示芯片性能、模型能力和笔电终端升级的舞台,而越来越像一个观察未来工业系统如何重组的窗口。从 AI 基础设施、边缘计算到机器人与自动化系统,台湾在全球供应链中的角色,也因此显得更加关键。
而 6 月 5 日围绕绿的谐波引发的市场讨论,则进一步说明,当 Physical AI 开始成为更高频的行业关键词,资本市场已经在尝试提前寻找那些可能嵌入量产链条的关键环节。展会现场提供的是产业方向,市场波动折射的是资本预期,两者共同勾勒出的,是一个比“生成式 AI 继续升温”更具体的命题:AI 正在从数字世界走向物理世界,真正的竞争,正从模型能力延伸到谁能完成交付、制造与规模化落地。
 Physical AI 元年:一场关于「世界怎么运转」的万亿美元豪赌撰文:硅兔君
2026 年 3 月,由图灵奖得主、曾任 Meta 首席 AI 科学家的 Yann LeCun 牵头创立的 AMI Labs 宣布完成 10.3 亿美元种子轮融资。
几乎在同一时间:
Fei-Fei Li 创立的 World Labs 完成新一轮约 10 亿美元融资
Google DeepMind 发布 Genie 3 世界模型
Tesla 持续推进 Optimus 人形机器人在工厂中的部署
这些事件并非孤立发生,而是共同指向一个更加清晰的趋势:AI 正在从「理解数字世界」走向「理解并作用于物理世界」。
如果说 2024 年是大语言模型的扩张期,2025 年是 Agent 的落地探索期,那么 2026 年,硅谷的核心叙事正在转向一个更底层的问题:AI 能否真正理解「世界如何运转」,并在现实中完成任务?
这并不只是一个技术方向的变化,更意味着产业价值链正在被重新改写。过去两年,AI 竞争的主战场主要集中在模型、算力与数据中心等少数几个高门槛环节;而当 AI 开始真正进入物理世界,竞争就不再只发生在模型层,而是同步扩展到硬件本体、系统集成、数据采集、仿真环境、供应链协同与真实场景落地。换句话说,Physical AI 带来的不是单点突破,而是一整套基础设施体系的重构。
也正因为如此,这一轮变化对中文世界,尤其是华人创业者、工程师与投资人而言,可能不仅是一波新的技术热潮,更是一个少见的结构性机会窗口。与上一轮主要由大模型训练资源和超级资本主导的竞赛不同,Physical AI 天然更依赖复合能力:既要理解算法,也要懂工程;既要能做系统协同,也要能进入制造、供应链和产业场景深处。那些兼具技术深度、硬件协同能力与中美产业视野的团队,反而更有机会在这场新周期中占据关键位置。
换句话说,Physical AI 不只是硅谷在讲的新故事,它也可能是华人在下一轮全球技术基础设施变局中,最值得重视的一张入场券。
01┃ 两条路线的世纪之争:LLM 派 vs. 世界模型派
过去三年,大语言模型(LLM)几乎主导了 AI 的发展路径,其核心范式是基于海量文本数据进行 next-token prediction(下一个词预测)。但这一范式的边界也在逐渐显现:它可以「描述」物理世界,却不具备可执行的理解;缺乏对因果关系与物理约束的建模能力;在连续决策和长期任务中也表现有限。
因此,以 Yann LeCun 为代表的一派开始推动另一条路径:World Model(世界模型)——预测「状态」,而非「文本」。两者的核心差异在于,LLM 以文本为学习对象、以语言为输出形式,本质停留在「认知与表达」;而世界模型则以物理世界状态为建模对象,直接指向「感知—决策—执行」的能力闭环。
这并非 LeCun 一个人的判断。2026 年 Q1,世界模型方向几乎在同一时间迎来几项关键进展:AMI Labs 以 JEPA 为核心架构,明确押注「先研究、后产品」的长期路线;World Labs 从「空间智能」切入,试图让 AI 真正理解三维世界中的关系、遮挡与物理约束;Google DeepMind 则通过 Genie 3 推动可实时交互的动态环境生成,并将其用于智能体训练。
三家公司路径不同,但指向的是同一个趋势:AI 的下一次跃迁,不只是生成更好的文本,而是更准确地建模世界,并在其中完成行动。
02┃ 硬件战争:谁在造「身体」?
世界模型解决的是「大脑」问题——AI 如何理解物理世界。但 Physical AI 的另一半战场同样激烈:谁来造「身体」?
2026 年的人形机器人赛道,已经从「实验室 demo」全面进入「工厂量产」阶段。几个关键数字:
Tesla Optimus Gen 3:超过 1000 台已部署在 Gigafactory Texas 和 Fremont 工厂,执行零件处理和装配任务。这是人类历史上规模最大的人形机器人工厂部署。Tesla 正在 Giga Texas 建设年产能 1000 万台的专用工厂,目标单台成本压至 2 万美元——两年前行业均价还在 5-25 万美元。
Boston Dynamics Atlas:CES 2026 上的产品版 Atlas,身高 6.2 英尺,56 个自由度,可举起 110 磅重物。更值得关注的是它的「灵魂」——Boston Dynamics 宣布与 Google DeepMind 合作,将前沿基础模型集成到 Atlas 中。2026 年全年产能已被 Hyundai 和 Google DeepMind 预定,30000 台/年的工厂正在规划中。
Figure 03:Figure AI 以 390 亿美元估值融了 10 亿美元,其 Figure 02 在 BMW Spartanburg 工厂的 11 个月试运行中,参与了超过 30000 辆 BMW X3 的生产,移动了 9 万多个零件,累计运行 1250 小时。Figure 03 在此基础上全面升级,配备 48+ 自由度和专有 Helix AI 平台。
Mind Robotics:3 月刚宣布 5 亿美元融资,专注工业规模的 AI 机器人部署。
但在这场硬件竞赛中,一个被低估的环节正在浮出水面:灵巧手(Dexterous Hand)。
人形机器人的腿解决了移动问题,躯干解决了承载问题,但真正决定机器人能否在复杂环境中干活的,是手。以 Tesla Optimus 为例,手部成本占整机的 17%,约 9500 美元——是最昂贵的单一组件。
灵巧手之所以难,在于一个根本性矛盾:手指空间太小,放不下大电机;小电机力矩不够,就需要高减速比齿轮箱来放大力量;而高减速比齿轮箱会带来惯性失真、力反馈丧失和机械磨损——这三个问题会从物理层面「毒化」AI 的学习过程。
一批新公司正在尝试突破这个瓶颈。有的采用轴向磁通电机架构将减速比从 288:1 压缩至 15:1,实现完全可反向驱动的灵巧手;有的通过同步设计数据采集手套,让人类操作数据可以零损耗迁移到机器人硬件上。这些看似小的硬件创新,可能是整个 Physical AI 生态中最关键的基础设施之一。
03┃ NVIDIA:Physical AI 时代的「卖铲人」
每一次技术浪潮,都会出现一个「卖铲人」。
在大模型时代,NVIDIA 凭借 GPU 与 CUDA 生态成为最大受益者;而在 Physical AI 时代,其角色正在进一步升级——不只是提供算力,而是试图构建一整套机器人时代的基础设施。
在 2026 年 3 月的 GTC 大会上,NVIDIA 发布了一整套围绕 Physical AI 的平台能力:包括面向人形机器人的视觉-语言-动作模型 Isaac GR00T、用于生成大规模合成数据的 Cosmos 系列,以及覆盖训练、评估与部署的工具链(如 Isaac Lab 与 OSMO)。这些能力并非单点工具,而是逐步形成一套完整的开发与运行体系。
包括 Boston Dynamics、Caterpillar、Franka Robotics、LG、NEURA Robotics 等在内的多家机器人公司,已经在 NVIDIA 平台上构建下一代系统。
其策略也非常清晰:
不直接参与终端产品,而是成为整个行业的底层标准。
如果说 Physical AI 是一座正在建造的城市,那么 NVIDIA 正在同时提供水泥、钢筋与电网。
04┃ 数据:Physical AI 最稀缺的「石油」
在大语言模型的世界里,互联网提供了几乎无限的文本数据。但在 Physical AI 中,一个更根本的问题浮现出来:
真实世界的操控数据极其稀缺。
这使得数据,成为整个产业链中最关键、也是最稀缺的资源之一。
目前,行业主要探索三条路径。
真实数据路线。以 Physical Intelligence 为代表,其 π0 模型基于超过 1 万小时的真实机器人操作数据训练,覆盖多种机器人形态与任务类型,能够完成复杂操作(如叠衣服、组装纸箱等)。其开源行为,本质上为行业提供了一套「操控预训练基座」。
合成数据路线。Google DeepMind 的 Genie 3 与 NVIDIA 的 Cosmos,尝试通过世界模型生成大量模拟环境,在虚拟世界中完成训练,再迁移到真实世界。这一路径的核心挑战在于 sim-to-real gap,但随着模拟精度的提升,这一差距正在逐步缩小。
人类遥操作路线。通过数据采集手套等设备,将人类操作直接映射到机器人系统中。这种方式数据质量最高,但在成本与规模化能力上仍存在限制。
Tesla 则在尝试一条混合路径:通过工厂视频持续采集人类操作行为,并用于训练 Optimus 的动作能力。
长期来看,Physical AI 的竞争格局,很可能不取决于谁的模型最优,而取决于谁拥有最多、最高质量的物理世界交互数据。一旦数据飞轮开始运转,其壁垒将呈指数级增强。
05┃ 钱在说什么:一张 2026 Q1 Physical AI 融资全景图
数字不会骗人。以下是 2026 年第一季度 Physical AI 领域的关键融资事件:
【世界模型层】
· AMI Labs(LeCun)— $10.3 亿种子轮,估值 $35 亿
· World Labs(李飞飞)— $10 亿新一轮,Autodesk 投 $2 亿
【基础模型层】
· Physical Intelligence — 正在谈判 $10 亿新一轮,估值将超 $110 亿
· RLWRLD — $4100 万种子轮扩展
【人形机器人整机】
· Figure AI — 此前以 $390 亿估值融 $10 亿(2025)
· Mind Robotics — $5 亿,工业规模部署
· Galaxea — $4.34 亿,Series B 独角兽
· Humanoid — $2.9 亿种子轮,直接独角兽
· Generative Bionics — €7000 万种子轮
【基础设施与工具】
· NVIDIA — 持续投入 Isaac GR00T / Cosmos 平台
· RoboForce — $5200 万,Physical AI 劳动力平台
仅上述公开数据,Q1 已超过 64 亿美元。而这还不包括 Tesla、Hyundai/Boston Dynamics、Google DeepMind 等大厂的内部投入。
资本的流向说明一件事:Physical AI 已经越过了「概念验证」的阶段,进入了「基础设施建设」的阶段。投资人不再问「机器人能不能用」,而是在问「谁的基础设施能让机器人最快规模化」。
06┃ 冷思考:泡沫还是拐点?
当然,硅谷从不缺泡沫。面对 Physical AI 的狂热,几个冷静的问题值得思考:
Demo ≠ 部署。正如业内人士在达沃斯 2026 上的共识:一个精彩的 demo 和一个能连续运行 10000 次不出错的系统之间的鸿沟,比宣传暗示的要大得多。Figure 02 在 BMW 工厂确实参与了 30000 辆车的生产,但它执行的是相对标准化的零件搬运,而非灵巧装配。
Sim-to-real 依然是硬骨头。世界模型的保真度在提升,但物理世界的长尾复杂性——光照变化、材料差异、非预期碰撞——仍然是合成数据路线的最大挑战。
商业模式尚未跑通。LeCun 自己说 AMI Labs 第一年只做研究。World Labs 在尝试免费+付费模式。Physical Intelligence 开源了核心模型。目前这些公司的收入几乎为零,资本赌的是 3-5 年后的范式垄断。
安全与监管的灰犀牛。当成千上万台具备自主决策能力的机器人进入工厂甚至家庭,谁为事故负责?目前全球对 Physical AI 的监管框架几乎一片空白。
但恰恰这些问题正说明,我们正处于技术拐点的早期,而非泡沫的顶部。每一项真正的范式转换——互联网、智能手机、云计算——在早期都伴随着「Demo 远好于产品」的阶段。关键的区别在于:底层技术是否在真正进步,而不只是 PPT 在进步。
从 LeCun 的 JEPA 架构、到 Genie 3 的实时世界生成、到 π0 的 68 任务泛化能力、到 Optimus 1000 台级别的工厂部署——2026 年 Q1 的进展是实打实的工程突破,不是空中楼阁。
07┃ Physical AI 不是一个独立赛道,它是 AI 的最终形态。
Physical AI 不是一个新赛道,它更像是 AI 的终局形态之一。
当 AI 从「理解世界」走向「进入世界」,真正被重写的不只是模型能力边界,也是产业分工与价值分配方式。未来的竞争,不会只发生在模型参数和算力集群里,也会发生在机器人本体、灵巧手、数据采集、仿真系统、产业场景和供应链组织能力上。
这也是为什么,这一轮对华人尤其重要。
因为华人在过去二十年里,最深的积累之一,从来不是单一维度的技术标签,而是把前沿技术、工程执行、硬件制造和跨区域产业协同真正串起来的能力。无论是创业者、工程师,还是投资人与产业资源组织者,只要能够抓住这一轮从数字智能走向物理智能的迁移,就有机会不只是参与趋势,而是在某些关键层上,成为趋势本身的一部分。
2026 年,Physical AI 也许还远未成熟;但正因为它还在早期,窗口才刚刚打开。对华人来说,这可能不是又一轮「跟随式参与」的周期,而是一轮更有机会向基础设施层、平台层和关键组件层深度切入的新起点。
 读懂黄仁勋的 Physical AI:为什么说 Crypto 的机会也藏在「犄角旮旯」里?撰文:Haotian
在达沃斯论坛上,黄仁勋到底说了什么?
表面看,他在推销机器人,实际上,他其实在进行一场大胆的「自我革命」。他用一席话终结了「堆显卡」的旧时代,却意外地给 Crypto 赛道预设了一个千载难逢的入场券?
昨天,在达沃斯论坛上,老黄指出 AI 应用层正在爆发,算力需求将从「训练侧」全面转向「推理侧」和「Physical AI(物理 AI)侧」。
这就很有意思了。
英伟达作为 AI 1.0 时代「算力军备竞赛」的最大赢家,现在主动喊出「推理侧」和「Physical AI」的转向,其实传递了一个非常直白的信号:过去靠堆卡训练大模型的「大力出奇迹」时代过去了,以后 AI 竞争会围绕应用场景落地的「应用为王」来角逐。
换句话说,Physical AI 是 Generative AI 的下半程。
因为 LLM 已经读完了人类几十年在互联网上沉淀的所有数据,但它依然不懂如何像人一样拧开一个瓶盖。Physical AI 就是要解决 AI 智力之外的「知行合一」问题。
因为,物理 AI 不可能依赖远端云服务器的「长反射弧」,逻辑很简单,让 ChatGPT 生成文字慢一秒你只是会觉得卡,可一个双足机器人如果因为网络延迟慢了一秒,它可能就会从楼梯上摔下去。
不过,Physical AI 看似是生成式 AI 的延续,实则面临着完全不同的三大新课题:
1)空间智能:让 AI 拥有三维世界的理解力。
李飞飞教授曾提出,空间智能是 AI 进化的下一个北极星。机器人要动,首先得「看懂」环境。这不仅仅是识别出「这是一把椅子」,而是要理解「这把椅子在三维空间的位置、结构以及我该用多大的力气去搬动它」。
这需要的是海量的、实时的、覆盖室内室外每一个角落的 3 D 环境数据;
2)虚拟训练场:让 AI 在模拟世界里试错训练。
黄仁勋提到的 Omniverse 其实就是一种「虚拟训练场」。机器人在进入真实物理世界前,需要在虚拟环境里训练「摔倒一万次」才能学会走路,这个过程叫 Sim-to-Real 即从模拟到现实。如果直接让机器人在现实中试错,硬件损耗成本将会是可怕的天文数字。
这个过程,对物理引擎模拟和渲染算力的吞吐量要求,是指数级的;
3)电子皮肤:「触觉数据」一个待挖的数据金矿。
Physical AI 要想具备「手感」,需要电子皮肤来感知温度、压力、质感。这些「触觉数据」是以前从未被规模化采集过的全新资产。这可能需要大规模的传感器采集,CES 上 Ensuring 公司展示的「量产皮肤」一只密密麻麻手上就集成了 1,956 个传感器,所以才能有机器人拨鸡蛋的神奇效果。
这些「触觉数据」是以前从未被规模化采集过的全新资产。
看完这些,你一定会感觉,Physical AI 论调的出现给了很多可穿戴设备以及人形机器人等硬件设备很大的冒头机会,要知道,这些在几年前都基本被诟病为「大号玩具」的存在。
其实我想说,在 Physical AI 的全新版图里,Crypto 赛道其实也有绝佳的生态补位机会。我随便举几个例子:
1、AI 巨头们可以派街景车扫描世界的每一个主街道,但是却没法采集到街头、小区内部、地下室的犄角旮旯,而利用 DePIN 网络设备提供的 Token 激励,发动全球用户用随身设备去补齐这些数据,就有可能完成补位;
2、前边说了,机器人不能依赖云端算力,但要短期大规模的利用边缘计算和分布式渲染能力,尤其是完成很多模拟到现实的数据。利用分布式算力网络,把闲置的消费级硬件集结起来,进行分发和调度,不就可以派上用场了;
3、「触觉数据」,除了规模化的传感器应用外,一听名字就知道会极其隐私,如何调度大众把这些涉及隐私的数据共享给 AI 巨头呢,可行的路径就是让贡献数据的人能得到数据确权和分红。
总结一下:
Physical AI 这是老黄喊出的 web 2 AI 赛道的下半场,对于 web 3 AI +Crypto 赛道诸如 DePIN、DeAI、DeData 等板块又何尝不是?你觉得呢?Tether向意大利AI机器人初创公司投资1190亿韩元……正式进军“Physical AI”全球最大稳定币发行商Tether参与了意大利人工智能初创公司"Generative Bionics"约1.19万亿韩元(8100万美元)规模的投资轮。Generative Bionics是一家旨在开发能够像人一样运动的先进人形机器人的企业,Tether计划通过此次投资来支持物理人工智能和边缘AI技术。
本轮投资由CDP风险投资公司的AI基金主导,除Tether外,AMD Ventures、Duferco、Eni Next、RoboIT等也参与了投资。共筹集了7000万欧元(约1.19万亿韩元),资金将主要用于Generative Bionics的首个生产设施建设以及在工业现场验证机器人平台。
Generative Bionics是从意大利技术研究院分拆出来的初创公司,正在开发可在现实世界中应用的AI机器人。该公司正在研究着眼于工厂生产线等工业应用的人形机器人技术。Tether表示:"我们将继续引领人工智能领域的创新,同时朝着降低对以大型科技公司为中心的现有集中式系统依赖的方向进行技术投资。"
作为一家起步于加密货币的企业,Tether近年来已将投资领域扩展至可再生能源、比特币挖矿、通信技术等。此次投资可被解读为公司"技术多元化战略"的一部分。Tether强调:"机器人学和人工智能是在未来产业的生产力和以人为中心的互动方面具有巨大潜力的领域。"
文章摘要 by TokenPost.ai
🔎 市场解读
Tether正式投资人工智能和机器人领域,显示出其意图超越原有稳定币业务,向技术平台扩张的动向。这也与其扩大去中心化和替代技术生态系统的战略相一致。
💡 战略要点
- Tether正持续投资于大型科技替代技术
- 人形机器人与边缘AI反映了新的产业需求
- 需关注其扩大对实物技术投资的可能性,而非仅限于代币经济
📘 术语解释
- 人形机器人:实现与人类相似形态和动作的机器人
- 物理人工智能:为使机器人能在实际环境中进行物理操作而设计的人工智能
- 边缘AI:在设备端而非云端服务器进行实时AI运算的技术
TP AI 注意事项
本文使用基于TokenPost.ai的语言模型对文章进行了摘要。正文的主要内容可能被省略或与事实存在出入。Anchorage Digital 为 Etherlink 及铀代币 xU3O8 等资产提供托管服务Techub News 消息,Anchorage Digital Bank 已将其机构托管服务扩展至 Etherlink 及多种基于 Etherlink 的资产。新增的托管资产包括 xU3O8,这是一种代表实物铀的代币。此举意味着该联邦特许加密银行能够为更多种类的代币化实物资产提供安全的托管解决方案。
(Cointelegraph)Clichmont CEO 称自建数据中心比租用 GPU 更具战略优势Techub News 消息,AI 基础设施公司 Clichmont CEO Alexis Cathalifaud 在接受采访时阐述了公司自建数据中心而非租用 GPU 的战略。他认为,GPU 迭代迅速且贬值快,而具备电力、土地、冷却和网络连接的实体基础设施是更持久的战略性资产,能提供对计算经济性的控制权。
Cathalifaud 表示,当需求激增时,租用 GPU 的访问可能变得昂贵或受限。而拥有基础设施则让公司能自主决定部署何种 GPU、升级时间、安装密度以及商业化方式,且同一设施可适配多代 GPU。他强调,稀缺资源正逐渐从 GPU 本身转向大规模为数千 GPU 供电的能力。
Clichmont 的 $CLAI 代币在其更广泛的生态系统中扮演角色。该公司认为,与 CoreWeave、Crusoe 和 Lambda 等专注于 GPU 租赁的竞争对手不同,控制和拥有物理基础设施将是更关键的长期瓶颈。 (NewsBTC)AI数据中心重塑物理风险保险规则,推动行业创新需求Techub News 消息,AI数据中心的兴起正在重塑保险行业,推动该行业对创新风险管理和金融解决方案的需求。AI数据中心对电力、冷却和物理安全的要求,正促使保险公司开发新的承保模型和产品,以应对其独特的风险特征。(Crypto Briefing)英伟达称全球无人驾驶出租车市场2035年将达4000亿美元Techub News 消息,英伟达表示,全球无人驾驶出租车市场预计到2035年将达到4000亿美元,届时将有超过600万辆商用无人驾驶车辆投入运营。目前,无人驾驶车队已在全球部分最繁忙、最复杂的街道上运送乘客。
英伟达指出,部署单辆无人驾驶汽车是一大挑战,而规模化运营车队则更为复杂。该公司正通过其全栈开放平台,为行业领导者提供构建和扩展服务所需的技术。(NVIDIA Newsroom)Ripple CEO 以荷兰央行转移 86 吨黄金为例,论证加密网络跨境转移价值更快Techub News 消息,Ripple CEO Brad Garlinghouse 援引荷兰央行转移 86 吨黄金储备的案例,论证加密网络在跨境转移价值方面比实物储备体系更快。荷兰央行此前宣布调整其黄金储备的存放地点。
Garlinghouse 在 X 平台发文表示,此类实物资产转移凸显了传统系统的低效,而加密网络能够实现近乎即时的全球价值转移。(Crypto.news)Physical Superintelligence 完成 5800 万美元融资,将建设 AI 物理研究实验室Techub News 消息,AI 研究公司 Physical Superintelligence(PSI)宣布完成 5800 万美元融资,资金将用于建设一个由人工智能驱动的物理研究实验室。该实验室旨在利用 AI 加速物理学领域的突破性研究,其成果可能对能源效率和太空探索等领域产生变革性影响。
(Crypto Briefing)Renaiss 平台总收入突破 3000 万美元Techub News 消息,BNB Chain 发文祝贺 Renaiss 平台总收入突破 3000 万美元。该平台通过公平证明、托管验证和透明定价等方式,致力于将实体收藏品推向更可验证、可访问且更具流动性的链上市场。
(@BNBCHAIN)Meta 测试数据中心机器人,可插拔线缆与重启服务器Techub News 消息,Meta 正在测试用于数据中心的机器人,能够执行插拔线缆、重启服务器等任务。该项目此前未公开报道,旨在通过自动化控制人力成本,应对 AI 基础设施开支的快速增长。
Meta 使用了来自 Watney Robotics、Kinova 和 ABB 等供应商的机器人硬件进行测试,其中 Kinova Gen3 机械臂被评估用于服务器电源循环,另一款机器人则尝试更换网络线缆。有员工估计,若成功应用,机器人可替代部分人员高达 80% 的工作量。 (Ars Technica AI)MirroS 发布 Code-as-World 框架,可将视频转换为可执行的物理模拟程序Techub News 消息,AI 研究机构 MirroS 发布 Code-as-World 框架,这是一种将物理世界表示为可执行世界表征的新范式。该框架将视频场景转换为可由 MuJoCo 物理引擎运行的代码,形成一个包含物体组成、物理演化和视觉外观的三元组,从而实现对物理机制的精确表征。
该框架采用一个智能体循环,通过提出假设、实例化、执行、渲染和验证等步骤,最多经过五轮迭代,从真实视频素材中恢复出可执行程序。这些经过验证的世界程序可作为带有精确物理标签的训练数据,用于训练视觉语言模型。
基于此监督训练得到的 Code-as-World-VL-9B 模型在 QuantiPhy 验证集上取得了 55.4 MRA 的分数,超过了 Gemini 3.1 Flash 的 54.8 分。MirroS 已在 GitHub 上开源了相关代码库和模型检查点。 (MarkTechPost)Accelerated Understanding 推出独立 AI 模型,曾拒绝 Project Prometheus 提案Techub News 消息,研究团队 Accelerated Understanding 推出了一款独立的 AI 模型,旨在挑战行业规范,并可能重塑企业 AI 在物理世界交互中的角色。该团队此前拒绝了名为 Project Prometheus 的项目提案,转而选择独立开发。
(Crypto Briefing)
「单机能力不应该是基础模型的终点。」 文|王诗涵 编辑|巴芮 当下,机器人基础模型的竞争几乎都围绕“单机智能”展开:让一台机器人独立完成更难、更长、更陌生的任务。行业基准线正不断抬高,每向前一步,所需数据、算力和工程成本随之攀升。但天花板还在那。 具身智能初创公司芝诺机器人决定把这道题横向展开,提出另一种解法:多机协作。 当单机遇到瓶颈,难以覆盖一整套工作流,多机可以成为新的选择。 以家庭场景为例,面对一系列复杂任务,两台标准化机器人可能先分头行动,各自清理猫爬架、铲猫砂;在任务需要时又会合,互相协助,比如把叠好的被褥放进压缩袋并抽空空气。 芝诺机器人将这种能力称为“协作物理智能”(Collaborative Physical Intelligence)。 他们训练了一个3B参数的基础模型Zeno-1,可以适配多机器人协作场景,每台自研的机器人Malo都会独立运行这一模型。据称,该模型具备跨场景、跨任务、跨本体的能力。 架构上,他们采用“去中心化(decentralized)”策略:机器人不依赖中央控制器统一规划动作,彼此之间没有显式信息传递,不需要访问伙伴的内部状态或动作计划,而是根据视觉画面、本体状态和交互历史作出决策。 通俗点说,它们需要自己学会“看队友眼色行事”。 「暗涌Waves」独家获悉,芝诺机器人于近期完成总额数亿元人民币的种子轮融资,投资方包括全球光学龙头舜宇光学、国产GPU龙头沐曦股份、浙大系基金网新集团、工业AI龙头赛意产业基金等产业资本与和利资本等一线投资机构。 芝诺机器人于2025年11月正式展业,总部位于杭州,在悉尼和匹兹堡设有研发中心。多名核心成员拥有卡内基梅隆大学机器人研究院(CMU RI)背景。联合创始人、首席科学家植伟铭现任悉尼大学计算机学院终身教职轨道助理教授,LOAM作者张楫担任首席机器人架构师。 今年,多机器人协作有多项研究进展。6月,植伟铭团队发布了SAI(已收录在CoRL 2026),提出面向机器人协作的顺序非对称模仿学习方法。同月,斯坦福大学Jeannette Bohg和Chelsea Finn团队发布相关论文预印本,提出基于VLA的分布式多机器人协作框架。 在“协作”这条路线上,芝诺机器人表现出很强的自信。今年5月,Figure AI曾展示两台搭载Helix 02模型的人形机器人协作整理卧室、铺床的视频。植伟铭说,从公开展示看,Zeno-1覆盖了更丰富的高难度协同操作,协作表现超过了Figure AI。 这种表达带着一家年轻公司的自信,也将它置于更严格的检验之下。 以下是「暗涌Waves」与植伟铭的对话,经编辑。 Part01 必经之路 「暗涌Waves」:为什么要做多机“协作”?这是个真需求吗? 植伟铭:人类社会本来就是一个群体协作的社会,机器人也一定是群体协作的。未来,如果要扩展系统、增加机器人,机器人理应要有协作能力,这是一条必经之路。 过去几年,单台机器人在数据学习、灵巧操作等方面已经有了一条baseline,掌握了识别环境、理解指令、抓取、移动和使用工具等能力。 但两个分别会抓、会搬、会操作的机器人放在一起,仍可能因为时序和接触不匹配而失败。单机能力不应该是基础模型的终点。 相关研究群体很早就开始研究多机器人系统。例如,Amazon已经在仓库中部署了大规模机器人车队。这些系统主要采用传统的调度与规划方法,能让大量移动平台并行完成搬运任务,这已经验证了多机器人并行作业在这类场景中的可行性。 但是,目前覆盖的任务大多集中在移动和物流环节,对于需要复杂物理接触的灵巧操作支持有限。 现在,随着单机能力提升,也到了可以为协作铺路的阶段。机器人可以通过协同,做一些高难度的灵巧操作。 「暗涌Waves」:有哪些场景是需要多机协作的? 植伟铭:真正有价值的场景通常具备多个作用点、多个工作空间或者并行操作。例如处理大面积柔性材料、大型物体搬运、共同装配和物品交接。 比如在酒店或家庭里做布草时,被单横截面积很大,单台机器人很难用两只手完成。还有挂裤子,现在大家看到的更多操作是叠裤子,但没有去挂的,这需要一台机器人固定衣架,另外一台机器人把裤子穿过去,再挂起来。 「暗涌Waves」:这些算是高价值场景吗?能让客户愿意多买一台机器人吗? 植伟铭:我们的核心目标不是要卖多台机器人。客户可以先购买一个机器人完成部分工作,如果完成不了一整套工作流,可以根据实际使用情况,增加机器人数量。 多机协同是一个选择,在以前,大家没有这个选择。 至于要不要增加,最后测算的是ROI,本质是客户的选择问题。 「暗涌Waves」:增加一台机器人的效率增量,能覆盖成本吗? 植伟铭:这是一个边际收益问题。 单台机器人接近能力上限后,如果继续挤压它的最后一点性能,投入的成本可能会越来越高。用多台标准化机器人协作,可以把它想象成一个能够选择增加或减少机器人的系统,会提升这套系统的整体能力。这种系统扩展会更经济。 本质上,大家关心的是能不能把增加机器人变成一种低成本、可渐进扩展的能力扩容方式。 「暗涌Waves」:怎么说服场景方换掉已有的成熟产品,用你们的机器人? 植伟铭:不一定是换掉,可以是一种补充。以公寓场景为例,过去的配送机器人能做的事情比较有限,高灵巧性的协作操作可以进入新的工作环节。 「暗涌Waves」:既然你们的模型能跨本体,为什么还要自研机器人,而不是采购现成的? 植伟铭:早期当然可以使用现成的机器人平台来加速训练和验证。但如果希望长期把模型能力推向真实世界,必须掌握硬件迭代的主动权。 过去的具身行业,更多是“硬件定义模型”,下一代具身应该是“模型定义硬件”。当模型具备更强的灵巧操作、移动操作、多机协作能力之后,它对本体的自由度、负载、工作空间、传感配置和末端执行器都会提出新的要求。硬件成为模型能力的一部分。 长期来看,我们希望成为一家以模型能力为核心的全栈Physical AI公司。 Part02 没有总指挥的机器团队 「暗涌Waves」:两台机器人共同完成一件事,技术难点主要在哪? 植伟铭:机器人之间的耦合会突然增强,主要有四个核心难点—— 一是部分可观测性。每台机器人只能从自己的视角观察环境,并据此判断伙伴正在做什么。 二是接触动力学。机器人可能通过同一个刚性物体、柔性物体或工具连接起来,其中一台机器人的动作会立即改变其他机器人的物理状态。 三是伙伴行为的不确定性。机器人伙伴可能慢半秒,也可能抓取失败或临时调整位置,预先规划好的协同轨迹很容易随之失效。 四是误差随时间累积。几十秒的任务可能依靠严格同步完成;当任务持续几分钟,时序偏差、抓取变化和物体状态变化都会不断叠加。 训练Zeno-1时,我们把这些问题视为协作操作的核心挑战,实际上也是把多机器人系统、机器人学习、灵巧操作和长时序决策等过去相对独立的研究方向结合到一起。 「暗涌Waves」:假设在真实场景中,你们的机器人遇到了别的机器人,面对同一个任务,怎么判断谁去做? 植伟铭:这其实是一个调度问题,也是一个人为构造的特殊情形。我们的基础模型会从已采集的数据中学习这些规律。 在去中心化策略下,我们的每个机器人都具备自己的推理能力,计算不集中在一个服务器上。每个机器人会通过自己的视觉画面、本体状态和交互历史作出决策。 所以,它会观察和预测另一台机器人是否行动,再决定自己要不要执行任务。 「暗涌Waves」:“去中心化”的体现是什么? 植伟铭:中心化系统最大的优势是信息完整。 中央控制器理论上可以看到整个团队,更容易做全局任务分配和联合优化。但每一次增加机器人,通常要重新训练,不断扩大一个中央联合策略的输入和输出空间。其中一台机器人出现异常,其他几台可能会随之崩溃。 事实上,很多真实世界系统很难完全中心化。自动驾驶如果能完全中心化,也就做成了。 采用去中心化架构,更容易扩展机器人团队的规模。理论上,我们可以不断添加或减少机器人,架构仍然会保持稳定。 「暗涌Waves」:“去中心化”就没有缺点吗? 植伟铭:代价是部分可观测性(partial observability)。机器人只能根据自己看到的信息判断伙伴意图,随着团队扩张,遮挡、局部冲突和信息缺失等情况会更加严重。 「暗涌Waves」:Zeno-1据称能连续运行超过10分钟、完成8个子任务。这是在什么条件下测的? 植伟铭:测试是在我们自己的真实机器人平台和室内场景中完成,主要验证单策略的持续执行能力。全程使用同一个Zeno-1策略,不同子任务之间没有切换模型,也没有重置环境。 「暗涌Waves」:你们如何训练协作能力? 植伟铭:模型训练分为4个阶段。使用第一视角和第三视角视频数据进行预训练,让模型获得物理行为先验。使用约40小时的独立真机数据进行一轮训练,提升单机操作能力。 在此基础上,我们进行闭环伙伴交互(Closed-loop Partner Interaction)训练:先部署其中一台机器人,让它执行已经学到的策略,同时采集另一台机器人与它实际协作的数据。这一轮数据的信息密度很高,约4小时。 在真实交互过程中,机器人会自然遇到伙伴延迟、动作不一致和需要临时调整等情况。我们将这些交互数据用于下一轮微调,让模型学习如何根据伙伴的实际表现调整动作,提高协作的鲁棒性。 「暗涌Waves」:单机智能和多机协作,哪个更难? 植伟铭:取决于具体任务。如果这个场景是用大量标准化单元并行来扩大系统能力,想要提高效率,一定是多个机器人会更有效,且更容易实现。 Part03 卷入浪潮 「暗涌Waves」:你们首轮融资就都是产业资本,这并不常见。是主动选择吗? 植伟铭:是。我们没有把融资理解为单纯的资金问题。机器人最终要进入真实场景,除了模型能力,还要供应链、算力、机器人硬件和客户资源等等。这些在早期就应该布局完。 舜宇、沐曦这样的产业龙头,本身就位于机器人产业链的关键环节,又了解真实生产环境中的能力边界。他们更清楚什么任务具有付费价值,哪些指标能够进入部署,哪些效果还停留在Demo。 对于一家年轻的具身智能公司,这些判断和资源很重要。 「暗涌Waves」:你们是2025年11月才创业,那时候国内外的具身企业都已经非常多了,你看到的机会是什么? 植伟铭:早期在NVIDIA西雅图机器人实验室、CMU RI,在美国的经历让我看到了很强的机器人研究生态。但是,用基础模型去研究机器人的很多核心问题,已经很难依靠小规模实验室推进。它需要大量的机器人,大量的真实数据,非常快速的硬件—模型迭代,以及模型长期部署后形成的数据闭环。 在职业生涯里,我一步步地感受到这个需求。 去年10月底,我和几位核心创始成员在杭州举行的机器人领域顶会IROS上聊了很久,大家都觉得具身智能还是有很多空间。 我们想做“大脑”。当时市场上专门做预训练的团队并不多,我们判断,基础模型层的生态位有机会“卡位”。 我们一致认为,“协同”这件事会在具身智能的终局存在,那时候北美几家巨头还没正式切入这一方向,因此我们决定快速布局。 「暗涌Waves」:多机协作要从Demo到规模化部署,这条路还有多远? 植伟铭:在特定场景进行多机协作,我认为未来一到两年就有机会看到实质性部署。因为任务边界明确,而且协作产生的经济价值容易衡量。 但如果要实现任意几台通用机器人进入陌生环境后自然组成团队,是一个更长期的问题。 「暗涌Waves」:目前的商业化进展如何? 植伟铭:过去一段时间,我们在澳新及其他海外地区开展了一些PoC测试,预计在2027年上半年正式启动规模化进程,目前关注在服务业。 我们优先选择那些在过去已经被验证过的,机器人能规模化应用、场景方具备好的付费意愿与付费能力、技术边界明确的半结构化场景。一方面是酒店、洗衣、养老和其他服务业,另一方面是精密加工及产业场景。 「暗涌Waves」:为什么敢Day1就做全球化? 植伟铭:我们是CMU RI背景唯一在中国创业的一支师生团队,核心团队大多有海外科研和产业经历,本身就是全球化的。并且在悉尼和匹兹堡设有研发中心,会连接当地的头部场景方、渠道商和人才。通过中国丰富的真实应用场景,低成本、快速地做PoC和迭代。 这样形成一个很清晰的分工:中国负责高效率地把产品做出来,海外帮助我们接触全球最好的场景、人才和市场。 「暗涌Waves」:你认为具身智能行业目前高估了什么,又低估了什么? 植伟铭:行业高估了现有单机智能接近通用智能的程度。很多机器人展示了漂亮的Demo,但进入真实世界长期稳定运行,还要解决环境变化、失败恢复、人机协作和硬件可靠性。 行业也容易高估扩大模型参数量对物理智能的解释力。机器人面对的是连续变化、充满物理约束的世界,模型必须和真实数据、感知、控制及执行形成闭环。 协作和执行层的复杂度仍然被低估。“把桌子收拾干净”看起来只是一句话,实际执行中包含先拿什么、从哪里走、怎样避开人、怎样抓取、物品掉落以后如何恢复等连续决策。 从两台机器人、有限任务开始,逐步增加任务宽度、运行时长、机器人数量和环境复杂度,这是芝诺机器人接下来的路径。 排版|郭栩君 图片来源|Unsplash

