
Loading...

Loading...
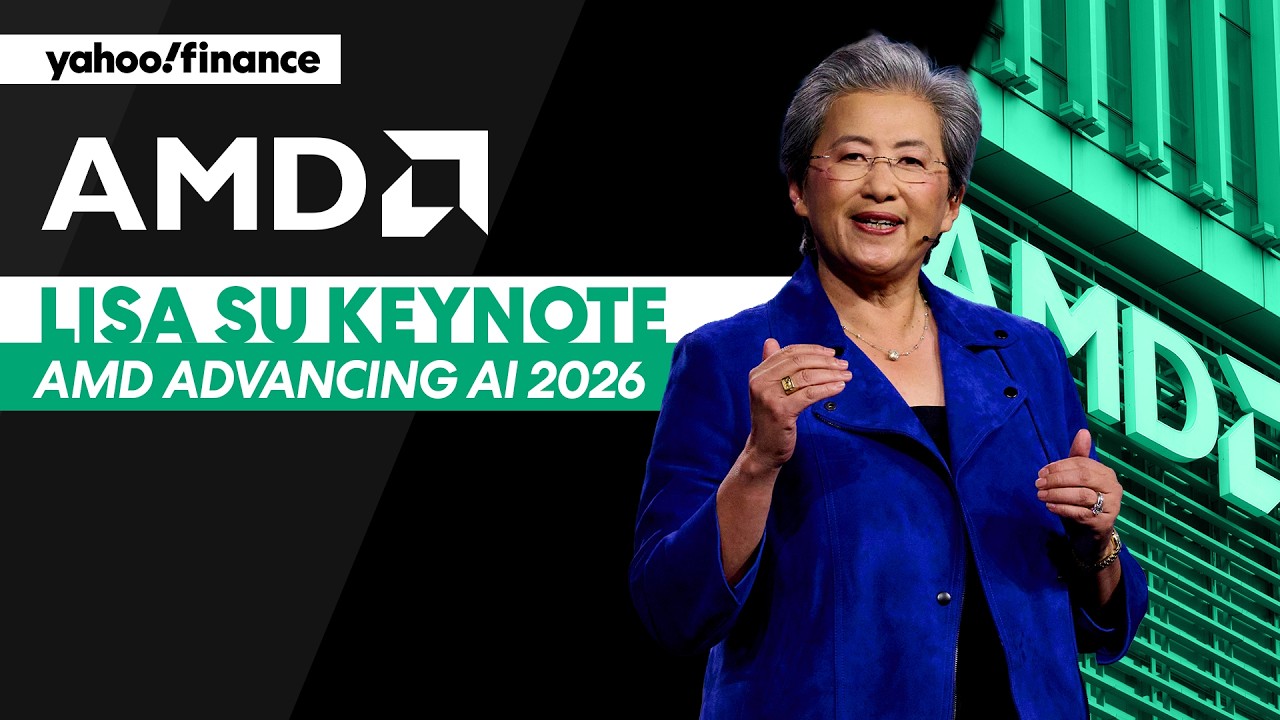 AMD CEO Lisa Su(苏姿丰):AI 加速器市场将达 1.4 万亿美元,并发布新一代 Helios 系统撰文:Techub News 整理
导语
在旧金山举行的 AMD Advancing AI 2026 年度大会上,AMD 董事长兼 CEO Lisa Su(苏姿丰)发表了重磅主题演讲。作为半导体行业的领军人物,苏姿丰此次演讲不仅是对 AMD 过去一年 AI 战略的总结,更是对未来几年 AI 计算格局的前瞻性布局。在长达两个多小时的分享中,她系统阐述了 AI 从训练到推理、从云端到边缘的范式转变,并联合众多顶级 AI 公司与合作伙伴,发布了一系列足以重塑行业竞争格局的新产品与技术路线图。
摘要
AI 推理计算需求首次超越训练,预计 2026 年全球 60% 的 AI 算力将用于推理,智能体(Agentic AI)是核心驱动力。
大幅上调市场预测:AI 加速器市场规模预计在 2030 年达到 1.4 万亿美元,服务器 CPU 市场因智能体 AI 将增长超 50%,达到 2000 亿美元以上。
发布全新 AI 机架系统 Helios,集成 MI455 GPU、Venice CPU 与 Pensando DPU,宣称是“全球性能最高的 AI 机架”,现已投入量产。
推出基于 Zen6 核心的 Venice CPU 家族,针对智能体 AI 工作负载优化,提供从高频率到高密度的不同产品线,已全面投产。
深化生态合作:Anthropic 将部署高达 2 吉瓦的 Helios 系统;OpenAI 确认扩大 AMD 基础设施部署至 6 吉瓦;Meta 强调与 AMD 在 CPU/GPU 协同设计上的深度合作。
软件层面推出 ROCm.ai 平台,利用 AI 辅助 GPU 编程,降低开发门槛;并与 Hugging Face、Cisco 等合作,推动 AI 在企业和边缘的部署与管理。
拓展 AI 边界:推出 Ryzen AI Halo 等个人 AI 计算平台,以及 Kore.ai 机器人开发平台,布局物理 AI 与边缘智能。
AI 范式转移:从训练到推理,智能体驱动的万亿市场
Lisa Su(苏姿丰)开篇即指出,AI 是过去 50 年来最重要的技术,其发展速度远超想象。她通过数据揭示了行业正在发生的根本性转变:当前全球每月消耗的 AI token 数量高达 35 quadrillion(千万亿),两年内增长了 160 倍。更关键的是,AI 计算的重心正从模型训练快速转向模型推理。
“我们预计,在 2026 年,全球用于运行(推理)AI 模型的计算量将首次超过用于训练的计算量。”苏姿丰表示,“今年,大约 60% 的全球 AI 计算容量将用于推理。”这一转变的核心驱动力,是数十亿用户每日使用 AI,以及智能体 AI(Agentic AI)的崛起。智能体不再是简单回答问题的聊天机器人,而是能够理解目标、调用工具、访问数据并持续工作直至解决问题的“虚拟员工”。这种工作模式对计算产生了指数级的需求,不仅需要大量 GPU 进行推理,还需要海量 CPU 来协调每一步操作。
基于这一洞察,AMD 大幅修正了市场预测。去年,AMD 预测 AI 加速器市场在 2028 年将达到 5000 亿美元,如今这个数字被认为“过于保守”。苏姿丰宣布,预计到 2030 年,AI 加速器市场规模将达到约 1.4 万亿美元,接近当前整个半导体市场的规模。其中,GPU 将占据绝大部分市场份额,因其可编程性能够适应快速演进的算法和工作负载。
与此同时,智能体 AI 为服务器 CPU 市场开辟了全新的增长曲线。苏姿丰透露,基于与超大规模客户的交流,AMD 预计服务器 CPU 市场到 2030 年将增长超过 50%,规模超过 2000 亿美元。这源于智能体从百万级向数十亿级扩展,需要庞大的 CPU 基础设施来支撑。
苏姿丰强调,AMD 的战略眼光不仅局限于数据中心。随着 AI 融入日常生活,计算必须发生在工作产生的地方——云端、边缘设备以及自主机器中。因此,AMD 致力于打造“无处不在的 AI”计算基础,预计其高性能和自适应计算产品市场将在未来几年以约 40% 的年复合增长率增长,到 2030 年接近 2 万亿美元。
硬件革新:Helios AI 机架与 Venice CPU 家族亮相
面对巨大的市场机遇和复杂的工作负载,苏姿丰发布了 AMD 的答案:Helios——业界最高性能的 AI 机架系统。Helios 专为大规模训练和运行最前沿的 AI 模型而设计,其核心理念是将整个机架作为一个完整的系统进行设计。
Helios 的核心组件包括:
MI455 加速器:采用台积电 2nm/3nm 工艺,拥有 3200 亿个晶体管,集成 12 个计算与 I/O 小芯片,配备 432 GB HBM4 内存。苏姿丰称其为“业界性能最高的 AI 加速器”。
Venice CPU:基于新一代 Zen6 核心,用于驱动 GPU 和协调工作负载。
Pensando DPU:提供领先的可编程性和横向扩展带宽的网络连接。
苏姿丰展示了将 75 块 GPU 通过高速互联整合在一个机架内的 Helios 系统。她公布的数据显示,与竞争对手相比,Helios 可提供高出 15% 的计算性能、50% 的 HBM4 内存容量与带宽,以及 50% 的横向扩展带宽。在固定机架功耗下,Helios 在主流推理工作负载上的平均性能领先竞争对手 10-15%,同时每美元 token 处理能力高出 30%。
她兴奋地宣布,Helios 已进入全面量产阶段,预计第三季度末开始发货,第四季度及下半年加速爬坡,客户需求“极其强劲”。
在 CPU 方面,苏姿丰重点介绍了为“智能体时代”量身定制的 Epic Venice CPU 家族。她指出,智能体 AI 导致服务器工作负载分化:GPU 服务器需要高频率核心快速喂饱 GPU;智能体沙盒服务器需要高密度核心以同时运行数千个智能体;传统通用服务器则追求能效。
Venice 家族基于 Zen6 核心,采用 chiplet(小芯片)设计,灵活应对不同需求:
Venice HF:高频率版本,用于 AI 主机节点,驱动 Helios 中的 GPU。
Venice 256 核:高密度版本,专为智能体沙盒设计,提供业界最高的计算密度。
Venice 128 核:优化版本,面向企业和通用服务器,提供最佳性价比。
性能方面,Venice 相比前代 Turin 性能提升高达 1.8 倍。在智能体沙盒场景下,Venice 的每瓦特 agent 处理能力是对手领先 ARM 处理器的 2.8 倍;在机架层面,每瓦特性能领先 3.3 倍。苏姿丰同样宣布,Venice 已全面投产,客户需求是 Epic 系列有史以来最强劲的,所有主要服务器 OEM 和云提供商都将在第四季度开始推出。
生态共荣:携手顶级 AI 公司构建开放未来
苏姿丰的演讲并非独角戏,她邀请了多位重量级合作伙伴上台,共同印证 AMD 平台的实力与开放生态的价值。
Anthropic 联合创始人兼首席计算官 Tom Brown 登台,宣布将部署高达 2 吉瓦的 Helios 系统。他分享了一个趣闻:Anthropic 的一位工程师曾尝试自行部署 MI355 系统,在周末通过 Claude 智能体的协助,成功让模型性能曲线一路上扬,这证明了 AMD 开放平台的易用性。双方还将合作,利用 Claude 优化 AMD 的芯片设计与软件内核开发。
OpenAI 基础设施负责人 Sachin Katti 随后登场,重申了与 AMD 的深度合作。他确认 OpenAI 正在向之前承诺的 6 吉瓦 AMD 基础设施部署迈进,并且是首批获得 MI455 机架的用户之一。双方工程师正并肩优化软件栈,以便在 Helios 上运行 GPT 级别的工作负载。Katti 特别强调了利用 AI 递归改进系统本身的重要性,以及 AMD 开放软件生态让此类创新能够惠及整个行业。
Meta 基础设施负责人 Santosh Janardhan 强调了在 AI 时代“协同设计”的至关重要性。他指出,AI 不仅是 GPU 的竞赛,CPU 变得至少同等重要甚至更重要。Meta 正在从优化单个服务器转向将整个数据中心视为一个集成系统进行设计,这需要与像 AMD 这样的伙伴早期、深度合作。他透露,Meta 与 AMD 的合作已历经多代 CPU(Milan, Bergamo, Turin, Venice)和 GPU(MI300, MI350, MI450),未来将继续共同设计面向 2027、2028 年的系统。
此外,AMD 还宣布与 AI 芯片公司 Cerebras 合作,将 Cerebras 的晶圆级引擎与 Helios 机架结合,打造面向超低延迟推理场景的解决方案。Cerebras CEO Andrew Feldman 表示,该方案能在保持极速的同时,提供五倍的吞吐量,预计今年晚些时候上市。
软件与边缘:让 AI 触手可及,无处不在
硬件是基础,软件是关键。AMD 高级副总裁 Vamsi Boppana 登台介绍了 ROCm 软件栈的最新进展。他宣布推出 ROCm.ai,这是一个智能体 AI 平台,旨在利用 AI 辅助 GPU 编程,自动化内核生成、代码优化和调试,大幅降低开发门槛,让开发者无需深厚的 ROCm 专业知识也能高效利用 AMD 硬件。
同时,AMD 正将 AI 能力从云端推向边缘和个人设备。苏姿丰和另一位高管展示了 Ryzen AI Halo 等个人 AI 计算平台,支持高达 3000 亿参数模型在本地运行,为开发者提供了从本地实验到大规模部署的无缝路径。AMD 宣布与 Hugging Face 扩大合作,为 Ryzen AI Halo 提供优化模型和工具,并将为每台 Halo 设备赠送一年 Hugging Face Pro 服务。
为了管理边缘 AI 的规模化部署,AMD 与 Cisco 合作推出整合解决方案。Cisco 首席产品官 G2 Patel 阐述了企业 CIO 对成本和安全性的关切,并展示了与 AMD Halo 设备集成的 Cisco 云控制平台,该平台能统一管理从边缘到云端的 AI 推理基础设施,监控智能体行为与 token 成本,并实施安全策略。
最后,AMD 将 AI 的边界拓展至物理世界,发布了面向机器人领域的 Kore.ai 系统级模块和机器人开发者平台。该平台集成了 CPU、GPU、NPU 和统一内存,旨在为自主机器人提供实时感知、推理和行动控制一体化的大脑。苏姿丰称,在第三方测试中,Kore 平台在实时性能、并发智能体数量和 CPU 容量上均优于竞争对手方案。
未来蓝图:持续迭代,引领下一个 AI 十年
在演讲尾声,苏姿丰展望了 AMD 的未来技术路线图,展示了其长期承诺:
CPU:2028 年推出基于 Zen7 核心的 Florence Epic 家族;2030 年计划推出基于 Zen8 的 Ravenna 家族。
GPU:保持每年一代的迭代节奏。MI500 将采用新一代 HBM 和铜/光互连,预计带来 Instinct 史上最大的代际性能飞跃。MI600(基于 CDNA Next 架构)已在开发中,目标 2028 年。
系统:客户可以期待 AMD 每年推出新一代 Helios 机架系统,持续提升性能、容量和能效。
苏姿丰总结道,AI 正在从探讨可能性阶段进入产生真实、重大影响的阶段。AMD 致力于构建技术、路线图和合作伙伴关系,为 AI 提供所需的全部工具和能力,以在从数据中心到个人设备再到物理世界的每一个角落产生有意义的现实影响。“我从未像2026 年 7 月这样,坚信高性能计算能让世界变得更美好。”她以此作结,彰显了 AMD 引领下一个 AI 计算时代的雄心。
 OpenClaw 力挺 Venice.ai,代币 VVV 一月暴涨超 500%撰文:叮当(@XiaMiPP)
上周,Openclaw 创始人劝年轻人「不要在加密货币上浪费时间」的发言刺痛加密行业。这周,事情却出现了微妙的反转。OpenClaw 官方文档中,悄然将一个带有原生 Token 的加密项目 Venice.ai 列为推荐模型提供商。而在过去一个月内,Venice 原生代币 VVV 价格也从低点的 1.5 美元附近上涨最高至 8.4 美元附近,最大涨幅超 500%。
一边是劝退,一边是接入,OpenClaw 为什么偏偏把一个带有加密代币经济结构的项目推到了台前?
Venice 的出身:加密 OG 做 AI,会做成什么样?
要理解 Venice,必须先理解 OpenClaw 的定位。它是一个开源自托管的 AI 代理平台,可以接入聊天软件,成为用户 24 小时运转的私人助理,帮助其收发邮件、管理日历等,但 OpenClaw 本身不提供 AI 大模型(LLM)能力,而只是一个「执行与路由层」。真正的智能(思考、规划、生成回复)必须来自外部的模型提供商。
Venice 就是一个主打隐私+无审查的生成式 AI 平台,定位是去中心化版 ChatGPT。该项目在 2024 年 5 月份启动,但是没有进行过融资,没有 VC 轮次,完全由创始人 Erik Voorhees 个人独资启动。
Erik Voorhees 本人是加密老 OG,在 2011 年涉足加密行业。2014 年 Mt. Gox 崩盘后,他创办了最早一批强调非托管与隐私优先的交易平台 ShapeShift。2021 年,他又选择将 ShapeShift 交由 DAO 治理,完成去中心化转型。他的职业轨迹也似乎在围绕「减少对中心化结构的信任依赖」而进行着。
团队中的另一位核心人物是 Teana Baker-Taylor,履历豪华,曾任 HSBC、Circle、Binance、Crypto.com 高管,负责运营和合规。其它成员则大多匿名或低调。从目前的公开数据显示,Venice 团队成员大约 20 名左右。
OpenClaw 当前选择的模型提供商达 22 家,其中包括 Amazon、Anthropic、Cloudflare 等大型科技公司。从体量和品牌来看,Venice 显然不是最显眼的那一个,甚至可以说是最不起眼的。但它却曾在官方文档中被高亮推荐且带有原生 Token 经济的模型提供商。不过,也有可能是文档合并误操作,目前该高亮已经移除,但它却在更早时间便已进入 OpenClaw 的模型提供商名单。
虽然但是,OpenClaw 为什么会选择一家不起眼的小公司?答案很简单:隐私。
毕竟,在 AI 大获成功的同时,围绕 AI 相关的数据泄露与模型训练争议也在持续累积。用户开始意识到,真正的风险并非模型「聪不聪明」,而是数据或信息「会不会被泄漏」。
那么,Venice 的隐私到底是怎么做到的呢?它的核心哲学是「You don’t have to protect what you do not have」(你不必保护你根本没有的东西)。简单来说,Venice 把用户的所有内容——prompt、回复、生成的图片、上传的文档——完全不存储在任何 Venice 的服务器上。这些数据只加密保存在用户自己的本地浏览器(或设备)中,一旦你清空浏览器数据或手动删除聊天记录,这些内容就永久消失了。
Venice 也明确不把用户数据用于模型训练、不日志、不分析行为,这和主流平台(如 OpenAI、Anthropic)形成了鲜明对比,后者往往会长期存储对话用于改进模型或合规审查。
而且,Venice 还区分了 Private 和 Anonymized 两种不同强度的隐私模式。前者为最高隐私,使用开源模型,这些模型运行在去中心化 GPU 上,处理时不带任何身份关联信息。底层计算节点就算短暂看到明文 prompt,但 Venice 本身看不到、也拿不到用户的历史。后者是底层厂商能看到 prompt 内容,但 Venice 会剥离所有元数据(IP、账号指纹、历史关联),让他们无法追踪到用户信息。
所以,尽管 Venice 在提供商列表里不算最显眼,但它的隐私架构让它成了 OpenClaw 文档里那个被特别高亮的「隐私首选」。现在 OpenClaw 的默认模型是 Llama 3.3,但是 Erik 自己在回复里建议用户换成更聪明的 GLM 4.6。
这对于 Venice 本身又意味着什么呢?
OpenClaw 现在正呈现病毒式扩散,其调用量正进入指数级增长阶段。有了 OpenClaw 的官方背书,也可能会把 Venice 的推理容量需求拉到新量级。这意味着,Venice 正在进入质变。它将不再只是「一个加密背景的 AI 项目」,而是在尝试成为主流开源 Agent 生态的默认隐私后端。
从 Erik 在 3 月 1 日公布的最新数据来看,进入 2026 年以来,Venice 的 API 用户数开始出现迅猛增长,目前用户已超过 25000 名。
代币模型:一次性投入,终身算力
作为加密项目,它的代币经济,是否能够承接这种流量级别的增长?
在 Venice 生态里,有两个核心 Token:VVV 和 DIEM。它们正通过「单向铸造 + 可逆赎回」机制紧密绑定,形成一个双层经济结构。
VVV 是整个生态的资本资产,可以直接持有或者进行质押。质押 VVV 可以持续产生质押收益,目前年化在 19% 左右。VVV 的另一个关键作用就是铸造 IDEM,且是 DIEM 唯一生成方式。
铸造后,DIEM 可以被拿到二级市场进行交易,比如在 Aerodrome 、Uniswap 等 DEX 上。或者被质押,用来激活消费信用。DIEM 代表的是可拥有的永久 AI 计算资产,1 DIEM = 每天 1 美元 的 Venice API 信用,用于调用 Venice 的所有模型(文本生成、图像/视频生成、代码等),包括 Private 模式下的最高隐私无审查模型,而且这个信用在你的质押期内是永久有效、每天自动更新的,相当于永久 AI 订阅券。
1 美元信用比较抽象,在 Venice 生态里,因为它不是固定「多少 tokens」,而是可消费 1 美元价值的推理资源。模型越贵,生成内容越少;模型越便宜,生成内容越多。这种抽象化定价,使 DIEM 成为一种「算力份额凭证」。我让 Venice 的 AI 帮我将 1 美元信用进行了量化:
因为传统 AI API 是按需付费,对高频、长期、自动化任务(如 AI Agent 每天几百上千次调用)来说,成本会指数级爆炸,但是 Venice 通过 DIEM 把这彻底颠覆成一次性投入换取长期固定额度。当前 1 DIEM 价值约 670 美元,质押后每天自动获得价值 1 美元 API 信用,为了方便对比是购买 IDEM 更划算,还是传统按需付费更划算,我用 Grok 生成了一份粗略的表格:
从上面数据显示来看,对于低频用户来说,完全不需要购买 DIEM,如果是中高频用户,需要每天跑 Agent、生成大量内容,长期使用边际成本则会持续降低,IDEM 就具备了明显优势。
有用户已经出来现身说法,其称质押了 56 个 DIEM 可以全天使用 Claude opus 4.6 模型,本金则不到 1 万美元。
而且,已经有社区用户开发出了信用租赁市场,免费闲置的信用也可以放到上面出售:cheaptokens.ai 。围绕 Venice 的算力生态市场正在萌芽。
综合来看,Venice 的经济模型核心在于将「增长逻辑」与「使用逻辑」分离开来。VVV 作为纯增长型资产,承载平台整体估值叙事,直接受益于用户增长、网络效应、生态扩张等正向飞轮;DIEM 作为永久订阅型功能资产,真正服务于产品使用与价值消耗,承担日常交互、任务执行的消费逻辑。
从当前数据表现来看,DIEM 在长期、高频、连续性任务场景下展现出明显优势,与当下 Agent 驱动的密集型使用模式高度契合。而这种强真实需求反过来又能有效刺激用户对 VVV 的质押意愿,形成使用端到增长端的正向闭环。
供应与通缩:价格起涨的真正背景
从 Venice 官网提供的数据来看,当前代币总供应量为 7884 万枚,其中锁定了 789 万枚,质押量则为 3060 万枚,质押率高达 38.8%,流通供应量仅为 4434 万枚。在最初的经济模型中,VVV 代币总量为 1 亿枚,其中 50% 用于社区空投,面向早期 Venice 用户、AI 项目方等。空投领取窗口持续约 45 天,最终有超过 4 万人领取了 1740 万枚 VVV,约占社区分配的 35%,剩余未领取的部分约为 3268 万枚,当时价值约 1 亿美元,最终经团队决定永久销毁,以减少流通供应、增强稀缺性。
自 2025 年 10 月开始,Venice 宣布将原排放计划 1 千万枚 VVV/年削减至 800 万枚/年,同时启动了月度营收回购+销毁机制,当前月度销毁能力在3万~5万枚,价值约6万~9万美元。当前,42.71%的代币供应已经被销毁。而在 2026 年 2 月初,官方再一次宣布排放削减计划,将 800 万枚 VVV/年削减至 600 万枚/年,这一系列调整,直接改变了供应预期。从代币价格表现来看,这也是 VVV 的起涨点。
所以,VVV 的上涨并非单纯叙事驱动,而是供给结构改变与需求增长的叠加。
结语
当 AI 成为时代叙事中心,Crypto 是否真的在退场?Venice 正在尝试给出自己的答案。如果未来的智能代理系统需要隐私后端,如果 Agent 需要长期稳定算力结构,那么加密逻辑或许并没有消失。AI 模型 Venice 推出学习页面,提供超 50 个长文与视频教程Techub News 消息,AI 模型 Venice 推出新的学习页面,提供超过 50 个长文与视频教程,内容涵盖如何为任何模型设置带有私有推理功能的 Hermes Agent,以及如何使用自定义视频工具链自动化 AI 电影制作等。
该学习页面旨在帮助用户更全面地了解和利用 Venice 模型内的各种工具与功能。(@ErikVoorhees)AI 模型 Venice 日处理量达 2500 亿代币Techub News 消息,AI 模型 Venice 日处理量已达 2500 亿代币。该数据由项目方公布,显示其处理能力显著提升。
(@ErikVoorhees)Erik Voorhees 阐述 AskVenice 如何确保 AI 模型调用私密性Techub News 消息,在采访中,ShapeShift 首席执行官 Erik Voorhees 向媒体人 Kain 介绍了其公司产品 AskVenice 的 AI 模型私密调用机制。Erik Voorhees 强调,该机制旨在保障用户隐私,不进行训练、不保留数据且不易成为法律传票(subpoena)的目标。AskVenice 通过评估模型的隐私政策与技术特性来选择调用对象,以提供无需用户担心数据被滥用的私密 AI 服务。
(@laurashin)ShapeShift 创始人分享周末 AI 项目,涉及钱包代理与文档数据提取Techub News 消息,ShapeShift 创始人 Erik Voorhees 在 X 平台分享其周末在 Venice API 上进行的 AI 项目,包括为 AI 代理配置钱包与预算、会议笔记语音转文本、从文档中提取结构化数据以及构建工具使用代理。相关项目链接已附在推文中。
(@ErikVoorhees)Erik Voorhees 透露 Venice 拟推奖励计划回购 VVV 代币Techub News 消息,Erik Voorhees 透露,Venice 正准备一项奖励计划,将使用用户支付的部分费用在公开市场购买 VVV 代币,并分发给忠实客户。
该计划目前尚未正式部署。通过将用户支付与代币回购机制结合,项目方旨在建立 VVV 的市场需求,同时以代币形式奖励忠实用户群体。(Laura Shin)前沿模型 stealth-ox-alpha 免费开放,开发者可通过 API 调用Techub News 消息,Venice.ai 发布名为 stealth-ox-alpha 的前沿模型,目前该模型可免费使用。开发者可通过 API 进行调用。
该模型详情与具体功能尚未完全披露,但 Venice.ai 在 X 平台提供了访问指南和示例代码。(@ErikVoorhees)Stripe 收购 AI 模型聚合平台 OpenRouterTechub News 消息,支付巨头 Stripe 已收购 AI 模型聚合平台 OpenRouter。Erik Voorhees 在 X 平台发文表示,此次收购引发了关于谁将主导 AI 技术栈的讨论。此外,他还提及了威尼斯(Venice)项目选择股权融资而非出售代币,以及能确保数据不存储在中国服务器上的私有 AI 技术。(@laurashin)Venice 集成字节跳动 Seedance 2.5 视频生成模型Techub News 消息,去中心化 AI 平台 Venice 宣布集成字节跳动 Seed 团队开发的 Seedance 2.5 音视频生成模型,用户可在 Venice Studio 直接生成最长 30 秒视频,无需单独注册字节账户。
该模型支持单次生成 20-30 秒连续场景,允许上传最多 30 张图片、10 个视频及 10 个音频作为多模态参考,实现角色一致性锁定与音画同步生成。平台强调用户输入数据不会用于模型训练,并通过匿名路由保障隐私安全。AMD:代理式 AI 需重构数据中心架构Techub News 消息,AMD 称代理式 AI 需重构数据中心架构,应将 CPU 与 GPU 配置比例从传统的 1:4 或 1:8 调整为 1:1 甚至以 CPU 为主,以支持自主推理和行动的 AI 系统。
该公司发布 EPYC 9005 系列处理器(最高 192 核 384 线程),预计下一代 Venice 架构将升级至 256 核 512 线程。其全栈方案还包括 Instinct 加速器和 Pensando 网络技术,面向消费者的 Ryzen AI Max+ 395 已于 7 月上市。(CryptoBriefing)去中心化 AI 平台 Venice API 已被多个应用采用Techub News 消息,去中心化 AI 平台 Venice 宣布其 API 正被越来越多的 AI 应用集成。该平台创始人 Erik Voorhees 在社交媒体上表示,开发者若希望构建不会危害用户隐私的应用,可尝试使用 Venice API 进行开发。
Venice 是一个注重隐私保护的去中心化 AI 平台,由加密货币行业资深人士 Erik Voorhees 创立。该平台致力于提供无需许可、抗审查的 AI 推理服务,允许用户在完全保护数据隐私的前提下使用开源 AI 模型,确保用户交互数据不会被中心化机构收集或存储。
撰文:Techub News 整理 导语 在旧金山举行的 AMD Advancing AI 2026 年度大会上,AMD 董事长兼 CEO Lisa Su(苏姿丰)发表了重磅主题演讲。作为半导体行业的领军人物,苏姿丰此次演讲不仅是对 AMD 过去一年 AI 战略的总结,更是对未来几年 AI 计算格局的前瞻性布局。在长达两个多小时的分享中,她系统阐述了 AI 从训练到推理、从云端到边缘的范式转变,并联合众多顶级 AI 公司与合作伙伴,发布了一系列足以重塑行业竞争格局的新产品与技术路线图。 摘要 AI 推理计算需求首次超越训练,预计 2026 年全球 60% 的 AI 算力将用于推理,智能体(Agentic AI)是核心驱动力。 大幅上调市场预测:AI 加速器市场规模预计在 2030 年达到 1.4 万亿美元,服务器 CPU 市场因智能体 AI 将增长超 50%,达到 2000 亿美元以上。 发布全新 AI 机架系统 Helios,集成 MI455 GPU、Venice CPU 与 Pensando DPU,宣称是“全球性能最高的 AI 机架”,现已投入量产。 推出基于 Zen6 核心的 Venice CPU 家族,针对智能体 AI 工作负载优化,提供从高频率到高密度的不同产品线,已全面投产。 深化生态合作:Anthropic 将部署高达 2 吉瓦的 Helios 系统;OpenAI 确认扩大 AMD 基础设施部署至 6 吉瓦;Meta 强调与 AMD 在 CPU/GPU 协同设计上的深度合作。 软件层面推出 ROCm.ai 平台,利用 AI 辅助 GPU 编程,降低开发门槛;并与 Hugging Face、Cisco 等合作,推动 AI 在企业和边缘的部署与管理。 拓展 AI 边界:推出 Ryzen AI Halo 等个人 AI 计算平台,以及 Kore.ai 机器人开发平台,布局物理 AI 与边缘智能。 AI 范式转移:从训练到推理,智能体驱动的万亿市场 Lisa Su(苏姿丰)开篇即指出,AI 是过去 50 年来最重要的技术,其发展速度远超想象。她通过数据揭示了行业正在发生的根本性转变:当前全球每月消耗的 AI token 数量高达 35 quadrillion(千万亿),两年内增长了 160 倍。更关键的是,AI 计算的重心正从模型训练快速转向模型推理。 “我们预计,在 2026 年,全球用于运行(推理)AI 模型的计算量将首次超过用于训练的计算量。”苏姿丰表示,“今年,大约 60% 的全球 AI 计算容量将用于推理。”这一转变的核心驱动力,是数十亿用户每日使用 AI,以及智能体 AI(Agentic AI)的崛起。智能体不再是简单回答问题的聊天机器人,而是能够理解目标、调用工具、访问数据并持续工作直至解决问题的“虚拟员工”。这种工作模式对计算产生了指数级的需求,不仅需要大量 GPU 进行推理,还需要海量 CPU 来协调每一步操作。 基于这一洞察,AMD 大幅修正了市场预测。去年,AMD 预测 AI 加速器市场在 2028 年将达到 5000 亿美元,如今这个数字被认为“过于保守”。苏姿丰宣布,预计到 2030 年,AI 加速器市场规模将达到约 1.4 万亿美元,接近当前整个半导体市场的规模。其中,GPU 将占据绝大部分市场份额,因其可编程性能够适应快速演进的算法和工作负载。 与此同时,智能体 AI 为服务器 CPU 市场开辟了全新的增长曲线。苏姿丰透露,基于与超大规模客户的交流,AMD 预计服务器 CPU 市场到 2030 年将增长超过 50%,规模超过 2000 亿美元。这源于智能体从百万级向数十亿级扩展,需要庞大的 CPU 基础设施来支撑。 苏姿丰强调,AMD 的战略眼光不仅局限于数据中心。随着 AI 融入日常生活,计算必须发生在工作产生的地方——云端、边缘设备以及自主机器中。因此,AMD 致力于打造“无处不在的 AI”计算基础,预计其高性能和自适应计算产品市场将在未来几年以约 40% 的年复合增长率增长,到 2030 年接近 2 万亿美元。 硬件革新:Helios AI 机架与 Venice CPU 家族亮相 面对巨大的市场机遇和复杂的工作负载,苏姿丰发布了 AMD 的答案:Helios——业界最高性能的 AI 机架系统。Helios 专为大规模训练和运行最前沿的 AI 模型而设计,其核心理念是将整个机架作为一个完整的系统进行设计。 Helios 的核心组件包括: MI455 加速器:采用台积电 2nm/3nm 工艺,拥有 3200 亿个晶体管,集成 12 个计算与 I/O 小芯片,配备 432 GB HBM4 内存。苏姿丰称其为“业界性能最高的 AI 加速器”。 Venice CPU:基于新一代 Zen6 核心,用于驱动 GPU 和协调工作负载。 Pensando DPU:提供领先的可编程性和横向扩展带宽的网络连接。 苏姿丰展示了将 75 块 GPU 通过高速互联整合在一个机架内的 Helios 系统。她公布的数据显示,与竞争对手相比,Helios 可提供高出 15% 的计算性能、50% 的 HBM4 内存容量与带宽,以及 50% 的横向扩展带宽。在固定机架功耗下,Helios 在主流推理工作负载上的平均性能领先竞争对手 10-15%,同时每美元 token 处理能力高出 30%。 她兴奋地宣布,Helios 已进入全面量产阶段,预计第三季度末开始发货,第四季度及下半年加速爬坡,客户需求“极其强劲”。 在 CPU 方面,苏姿丰重点介绍了为“智能体时代”量身定制的 Epic Venice CPU 家族。她指出,智能体 AI 导致服务器工作负载分化:GPU 服务器需要高频率核心快速喂饱 GPU;智能体沙盒服务器需要高密度核心以同时运行数千个智能体;传统通用服务器则追求能效。 Venice 家族基于 Zen6 核心,采用 chiplet(小芯片)设计,灵活应对不同需求: Venice HF:高频率版本,用于 AI 主机节点,驱动 Helios 中的 GPU。 Venice 256 核:高密度版本,专为智能体沙盒设计,提供业界最高的计算密度。 Venice 128 核:优化版本,面向企业和通用服务器,提供最佳性价比。 性能方面,Venice 相比前代 Turin 性能提升高达 1.8 倍。在智能体沙盒场景下,Venice 的每瓦特 agent 处理能力是对手领先 ARM 处理器的 2.8 倍;在机架层面,每瓦特性能领先 3.3 倍。苏姿丰同样宣布,Venice 已全面投产,客户需求是 Epic 系列有史以来最强劲的,所有主要服务器 OEM 和云提供商都将在第四季度开始推出。 生态共荣:携手顶级 AI 公司构建开放未来 苏姿丰的演讲并非独角戏,她邀请了多位重量级合作伙伴上台,共同印证 AMD 平台的实力与开放生态的价值。 Anthropic 联合创始人兼首席计算官 Tom Brown 登台,宣布将部署高达 2 吉瓦的 Helios 系统。他分享了一个趣闻:Anthropic 的一位工程师曾尝试自行部署 MI355 系统,在周末通过 Claude 智能体的协助,成功让模型性能曲线一路上扬,这证明了 AMD 开放平台的易用性。双方还将合作,利用 Claude 优化 AMD 的芯片设计与软件内核开发。 OpenAI 基础设施负责人 Sachin Katti 随后登场,重申了与 AMD 的深度合作。他确认 OpenAI 正在向之前承诺的 6 吉瓦 AMD 基础设施部署迈进,并且是首批获得 MI455 机架的用户之一。双方工程师正并肩优化软件栈,以便在 Helios 上运行 GPT 级别的工作负载。Katti 特别强调了利用 AI 递归改进系统本身的重要性,以及 AMD 开放软件生态让此类创新能够惠及整个行业。 Meta 基础设施负责人 Santosh Janardhan 强调了在 AI 时代“协同设计”的至关重要性。他指出,AI 不仅是 GPU 的竞赛,CPU 变得至少同等重要甚至更重要。Meta 正在从优化单个服务器转向将整个数据中心视为一个集成系统进行设计,这需要与像 AMD 这样的伙伴早期、深度合作。他透露,Meta 与 AMD 的合作已历经多代 CPU(Milan, Bergamo, Turin, Venice)和 GPU(MI300, MI350, MI450),未来将继续共同设计面向 2027、2028 年的系统。 此外,AMD 还宣布与 AI 芯片公司 Cerebras 合作,将 Cerebras 的晶圆级引擎与 Helios 机架结合,打造面向超低延迟推理场景的解决方案。Cerebras CEO Andrew Feldman 表示,该方案能在保持极速的同时,提供五倍的吞吐量,预计今年晚些时候上市。 软件与边缘:让 AI 触手可及,无处不在 硬件是基础,软件是关键。AMD 高级副总裁 Vamsi Boppana 登台介绍了 ROCm 软件栈的最新进展。他宣布推出 ROCm.ai,这是一个智能体 AI 平台,旨在利用 AI 辅助 GPU 编程,自动化内核生成、代码优化和调试,大幅降低开发门槛,让开发者无需深厚的 ROCm 专业知识也能高效利用 AMD 硬件。 同时,AMD 正将 AI 能力从云端推向边缘和个人设备。苏姿丰和另一位高管展示了 Ryzen AI Halo 等个人 AI 计算平台,支持高达 3000 亿参数模型在本地运行,为开发者提供了从本地实验到大规模部署的无缝路径。AMD 宣布与 Hugging Face 扩大合作,为 Ryzen AI Halo 提供优化模型和工具,并将为每台 Halo 设备赠送一年 Hugging Face Pro 服务。 为了管理边缘 AI 的规模化部署,AMD 与 Cisco 合作推出整合解决方案。Cisco 首席产品官 G2 Patel 阐述了企业 CIO 对成本和安全性的关切,并展示了与 AMD Halo 设备集成的 Cisco 云控制平台,该平台能统一管理从边缘到云端的 AI 推理基础设施,监控智能体行为与 token 成本,并实施安全策略。 最后,AMD 将 AI 的边界拓展至物理世界,发布了面向机器人领域的 Kore.ai 系统级模块和机器人开发者平台。该平台集成了 CPU、GPU、NPU 和统一内存,旨在为自主机器人提供实时感知、推理和行动控制一体化的大脑。苏姿丰称,在第三方测试中,Kore 平台在实时性能、并发智能体数量和 CPU 容量上均优于竞争对手方案。 未来蓝图:持续迭代,引领下一个 AI 十年 在演讲尾声,苏姿丰展望了 AMD 的未来技术路线图,展示了其长期承诺: CPU:2028 年推出基于 Zen7 核心的 Florence Epic 家族;2030 年计划推出基于 Zen8 的 Ravenna 家族。 GPU:保持每年一代的迭代节奏。MI500 将采用新一代 HBM 和铜/光互连,预计带来 Instinct 史上最大的代际性能飞跃。MI600(基于 CDNA Next 架构)已在开发中,目标 2028 年。 系统:客户可以期待 AMD 每年推出新一代 Helios 机架系统,持续提升性能、容量和能效。 苏姿丰总结道,AI 正在从探讨可能性阶段进入产生真实、重大影响的阶段。AMD 致力于构建技术、路线图和合作伙伴关系,为 AI 提供所需的全部工具和能力,以在从数据中心到个人设备再到物理世界的每一个角落产生有意义的现实影响。“我从未像2026 年 7 月这样,坚信高性能计算能让世界变得更美好。”她以此作结,彰显了 AMD 引领下一个 AI 计算时代的雄心。
